
그리고 OpenAI 오디오 음성 API 다음 기능을 통해 텍스트를 음성 오디오로 변환합니다. 게시물 https://api.openai.com/v1/audio/speech. 모델, 입력 텍스트, 음성을 전송하면 응답을 MP3 또는 기타 지원되는 오디오 형식으로 저장할 수 있습니다. 어조와 발음에 대한 지침이 필요한 새로운 통합 기능을 시작하려면 다음부터 시작하세요. gpt-4o-mini-tts.
작업 의뢰는 단지 첫 단계일 뿐입니다. 적절한 과금 단위, 재생 가능한 출력 파일, 그리고 분량이 긴 대본에 대한 계획도 필요합니다. OpenAI의 최신 TTS 모델은 가격 산정에 텍스트 및 오디오 토큰을 사용하는 반면, 구형 TTS 모델은 문자를 기준으로 합니다. 한 달 분량의 나레이션 비용을 산정할 때 이러한 차이는 중요한 의미를 갖습니다.
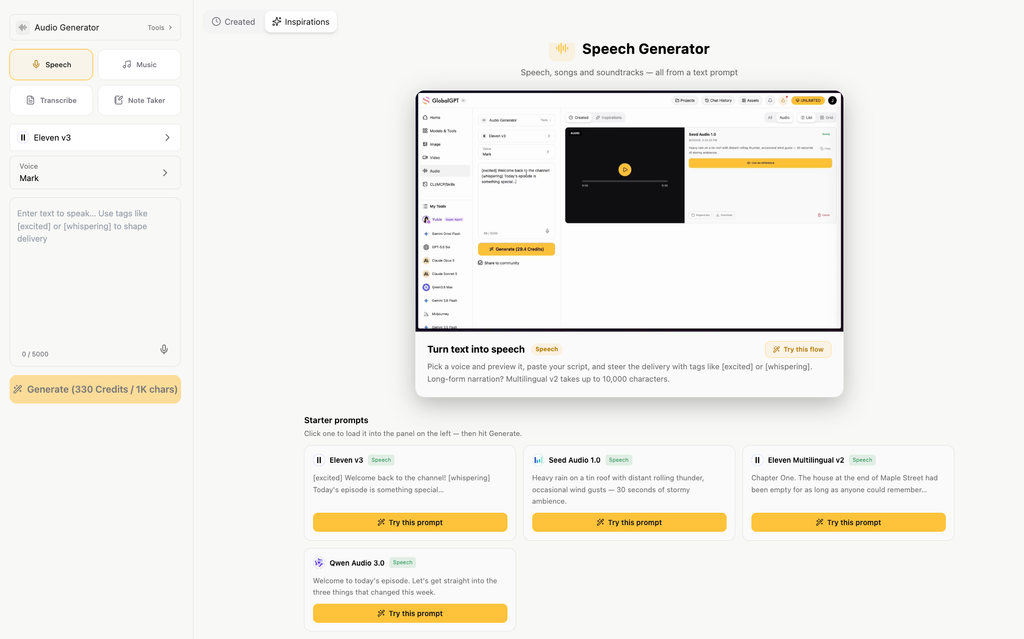
만약 여러분의 업무에 대본 작성, 영상 제작, 영상 편집까지 포함된다면, GlobalGPT의 오디오 작업 공간 음성 생성 기능을 합리적인 가격의 멀티모델 구독 플랫폼에 도입했습니다. 단일 대시보드에서 텍스트, 음성, 이미지, 동영상을 아우르는 작업을 수행할 수 있으며, API와 CLI를 활용해 반복 가능한 제작 작업을 진행할 수 있습니다. 이 플랫폼의 공개 TTS API는 별도의 작업 워크플로를 사용하며, 이에 대해서는 아래에서 설명합니다.
OpenAI 오디오 음성 API는 어떤 기능을 하나요?
Speech API는 텍스트 음성 변환(TTS) 엔드포인트입니다. 애플리케이션에서 텍스트를 입력하면 생성된 음성을 출력받게 됩니다. 대표적인 사용 사례로는 제품 사용법 안내, 접근성 나레이션, 학습 자료, 짧은 음성 해설 등이 있습니다. 음성이 출력되기 전에 텍스트를 직접 확인할 수 있으므로, 승인된 대본에 따라 문구를 구성해야 할 때 유용합니다.
음성 텍스트 변환의 경우, 그 과정이 반대로 진행됩니다. 녹음된 오디오가 입력되면 텍스트가 출력되는 방식입니다. 실시간 음성 비서의 경우, 대화를 통해 듣고 응답해야 한다는 또 다른 요구 사항이 추가됩니다. OpenAI의 오디오 기록 이러한 워크플로를 구분합니다. 음성으로 읽어주기를 원하는 텍스트가 이미 준비되어 있는 경우 ‘음성’ 엔드포인트를 선택하세요.
음성 생성 기능은 스트리밍을 지원하므로, 애플리케이션은 오디오를 청크 단위로 수신할 수 있습니다. 해당 스트림을 파일에 저장한다고 해서 브라우저에서 자동으로 재생되거나 대화형 에이전트가 생성되는 것은 아니며, 재생 및 모든 대화 로직은 여전히 애플리케이션에서 처리해야 합니다. 또한 OpenAI 규정에 따라 청취자에게 해당 음성이 AI로 생성된 것임을 명확히 고지해야 합니다.
OpenAI 음성 API를 사용하여 첫 번째 오디오 파일을 생성해 보세요
서버나 개발용 컴퓨터에서, OpenAI API 키를 OPENAI_API_KEY 환경 변수. 이 키는 브라우저 자바스크립트 내에서 사용하지 마십시오. 다음 예제에서는 동일한 짧은 제품 투어 스크립트를 사용하며, 그 결과를 openai-product-tour.mp3.
옵션 1: curl 요청 보내기
OpenAI Speech API · curl
#!/bin/sh
# 먼저 서버 환경에서 OPENAI_API_KEY를 설정하십시오.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Acorn Studio 제품 투어에 오신 것을 환영합니다. 세 단계만 거치면 짧은 대본을 오디오 가이드로 만들 수 있습니다. 먼저 메시지를 작성하세요. 다음으로 음성을 선택하세요. 마지막으로 오디오 파일을 저장하고 휴대폰에서 재생해 보세요.",
    "voice": "coral",
    "instructions": "따뜻하고 대화하는 듯한 어조로 명확하게 말해 주세요.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
응답에 오디오 바이트가 포함되어 있으므로, 이를 JSON으로 파싱하려고 시도하기보다는 파일로 저장하십시오. 이 --본문 포함 오류 이 옵션은 HTTP 오류가 발생했을 때 curl에 실패한 종료 상태를 반환합니다. 파일을 열기 전에 해당 상태를 확인하세요. 오류 응답이 발생하더라도 지정된 이름의 파일에 JSON 데이터가 남아 있을 수 있습니다. .mp3.
옵션 2: Python SDK 사용
다음 명령을 사용하여 OpenAI 패키지를 설치하십시오. python -m pip install openai. SDK는 환경에서 API 키를 읽어옵니다. 이 예제에서는 응답이 도착하는 대로 바로 기록하므로, 오디오 응답 전체를 사용자의 Python 버퍼에 불러올 필요가 없습니다.
OpenAI Speech API · Python
"""설치: python -m pip install openai. 서버에서 OPENAI_API_KEY를 설정하세요."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Acorn Studio 제품 투어에 오신 것을 환영합니다. 세 단계만 거치면 "
    "짧은 대본을 오디오 가이드로 만들 수 있습니다. 먼저, 메시지를 작성하세요. 다음으로, "
    "음성을 선택하세요. 마지막으로, 오디오 파일을 저장하고 휴대폰에서 재생해 보세요."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="따뜻하고 대화하는 듯한 어조로 명확하게 말해 주세요.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("openai-product-tour.mp3 저장됨")
세 가지 필수 분야는 다음과 같습니다. 모델, 입력, 및 음성. 여기, 사용 방법 따뜻하고 대화체적인 발음을 요구하며, 대본에 단어를 추가하기보다는 목소리의 뉘앙스를 이끌어냅니다. 이 필드는 GPT-4o Mini TTS와 호환되지만, 다음에서는 지원되지 않습니다. tts-1 그리고 tts-1-hd.
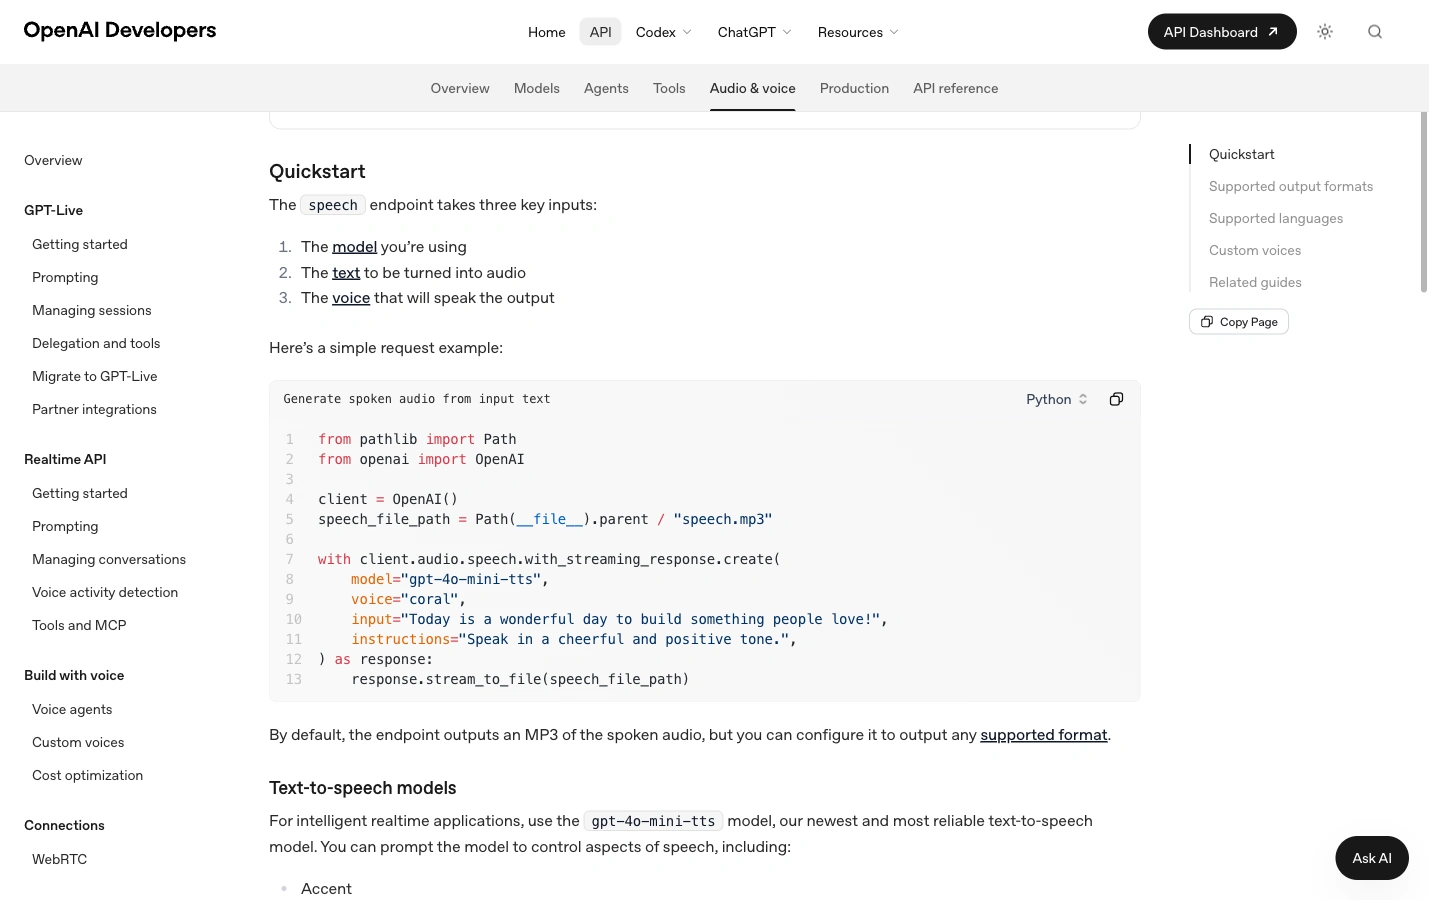
문서의 분량이 길 경우, 문장이나 단락 경계를 기준으로 텍스트를 분할하고, 각 부분에 번호를 매긴 뒤 해당 번호로 각각 저장하세요. 모든 부분에서 일관된 어조와 지침을 유지해야 합니다. 자연스러운 표현이 가능하도록 충분한 맥락을 남겨두고, 편집된 녹음 파일을 배포하기 전에 연결 부위의 음성을 꼼꼼히 들어보세요.
모델, 음성, 출력 형식을 선택하세요
| 모델 | 선택 방법 | 배송 안내 |
|---|---|---|
gpt-4o-mini-tts | 조절 가능한 내레이션과 말하기 표현을 위한 출발점. | 지원 사용 방법 어조, 문체, 그리고 진행 속도 면에서. |
tts-1 | OpenAI는 이 모델을 저지연 음성 생성에 적합하게 만듭니다. | 지원되는 음성 및 속도 제어 기능을 사용하고, 생략 사용 방법. |
tts-1-hd | OpenAI는 이 모델이 TTS-1보다 더 높은 품질의 음성을 구현할 수 있도록 합니다. | 지원되는 음성 및 속도 제어 기능을 사용하고, 생략 사용 방법. |
그리고 GPT-4o 미니 TTS 모델 페이지 모델 별칭을 다음으로 매핑합니다. gpt-4o-mini-tts-2025-12-15 스냅샷. 애플리케이션에서 재현 가능한 동작이 중요하다면, 문서화된 스냅샷을 신중하게 선택하고, 저장한 스크립트와 함께 기록해 두십시오.
내장 음성 및 입력 제한
Speech API 참조 문서에는 GPT-4o Mini TTS용으로 13가지 내장 음성이 나열되어 있습니다: 합금, 재, 발라드, 산호, 메아리, 우화, 오닉스, 노바, 세이지, 반짝임, 시구, 마린, 그리고 삼나무. OpenAI는 다음과 같이 권장합니다 마린 또는 삼나무 최상의 품질을 위해. 이것이 OpenAI의 권장 사항입니다. 자신의 이름, 숫자, 문장 패턴을 직접 들어보며 제작에 사용할 목소리를 선택하세요.
이전 TTS 모델들은 더 제한된 색상 세트(alloy, ash, coral, echo, fable, onyx, nova, sage, shimmer)를 지원합니다. 모든 음성이 모든 모델에서 작동한다고 가정하지 마십시오. 이 Speech API 참조 또한 다음 범위 내의 속도를 허용합니다. 0.25 및 4.0, 와 함께 1.0 기본값으로.
고려해야 할 두 가지 입력 한계치가 있습니다: 종점 기준 한계치 입력 에 4,096자, 그리고 Mini TTS 모델 페이지에는 최대치가 2,000개의 입력 토큰. 문자와 토큰은 서로 다른 측정 단위입니다. Mini TTS의 경우, 특히 다국어 텍스트를 사용할 때는 두 가지 제약 조건을 모두 확인하고, 대용량 스크립트는 제출하기 전에 분할해 주세요.
저장할 파일 형식을 선택하십시오.
| 형식 | 실용적인 활용 |
|---|---|
| MP3 | 기본 출력: 공유 및 웹 재생에 편리한 압축 파일입니다. |
| 오푸스 | 이 코덱을 지원하는 스트리밍 및 통신 애플리케이션에 유용합니다. |
| AAC | 재생 환경이나 미디어 워크플로우상 AAC가 필요한 경우를 고려해 보세요. |
| FLAC | 오디오 신호를 유지해야 하는 워크플로우를 위한 무손실 압축. |
| WAV | 편집 및 처리를 위해 익숙한 컨테이너 형식으로 저장된 비압축 오디오. |
| PCM | 파일 헤더가 없는 24kHz, 16비트 부호 있는 리틀 엔디안 원시 샘플입니다. 플레이어에서는 해당 설정이 필요합니다. |
다운로드 링크나 간단한 오디오 플레이어를 만들려면 MP3로 시작하세요. 다음 단계에서 편집할 예정이라면 WAV를 선택하세요. 애플리케이션이 원시 PCM 파일을 해석할 수 있는 경우에만 원시 PCM을 선택하세요. 파일 이름을 .pcm 에 .wav WAV 헤더를 생성하지 않습니다.
OpenAI Speech API의 요금은 얼마인가요?
2026년 9월 28일 확인한 바에 따르면, OpenAI에는 GPT-4o Mini TTS가 텍스트 입력 토큰 100만 개당 $0.60 플러스 오디오 출력 토큰 100만 개당 $12. TTS-1의 가격은 $15 (100만 자당), 그리고 TTS-1 HD의 가격은 $30 (100만 자당). 각 모델을 해당 단위로 계산하십시오.
Speech API 요금: 단위를 별도로 유지하세요
OpenAI는 최신 TTS 모델의 요금을 토큰 단위로, 이전 두 가지 TTS 모델의 요금은 문자 단위로 책정합니다. GlobalGPT는 TTS 작업 요금을 크레딧 단위로 표시합니다.
| 노선 및 모델 | 요율 | 예 |
|---|---|---|
| OpenAI · GPT-4o 미니 TTS | $0.60 / 1M 텍스트 입력 토큰 $12 / 1M 오디오 출력 토큰 | 텍스트 입력 토큰 1,000개 + 오디오 출력 토큰 5,000개에 대해 $0.0606 |
| OpenAI · TTS-1 | $15 / 1M 문자 | 1,000자당 $0.015 |
| OpenAI · TTS-1 HD | $30 / 1M 자 | 1,000자당 $0.030 |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 또는 Qwen Audio 3.0 TTS Flash | 330 크레딧 / 1,000 자 | 나열된 1,000자 기준 요율로 330크레딧; 제출 전에 견적을 요청해 주세요 |
이 내용은 가격 예시일 뿐, 아래 오디오 샘플에 대한 실제 요금이 아닙니다. 토큰, 문자, 분, 크레딧은 서로 다른 단위입니다. GlobalGPT 작업 견적에는 해당 크레딧 금액이 명시되어 있으며, 표에는 크레딧을 달러로 환산한 금액이 표시되어 있지 않습니다.
2026년 9월 28일 기준 요금 확인. 출처: OpenAI API 가격 그리고 GlobalGPT API 문서.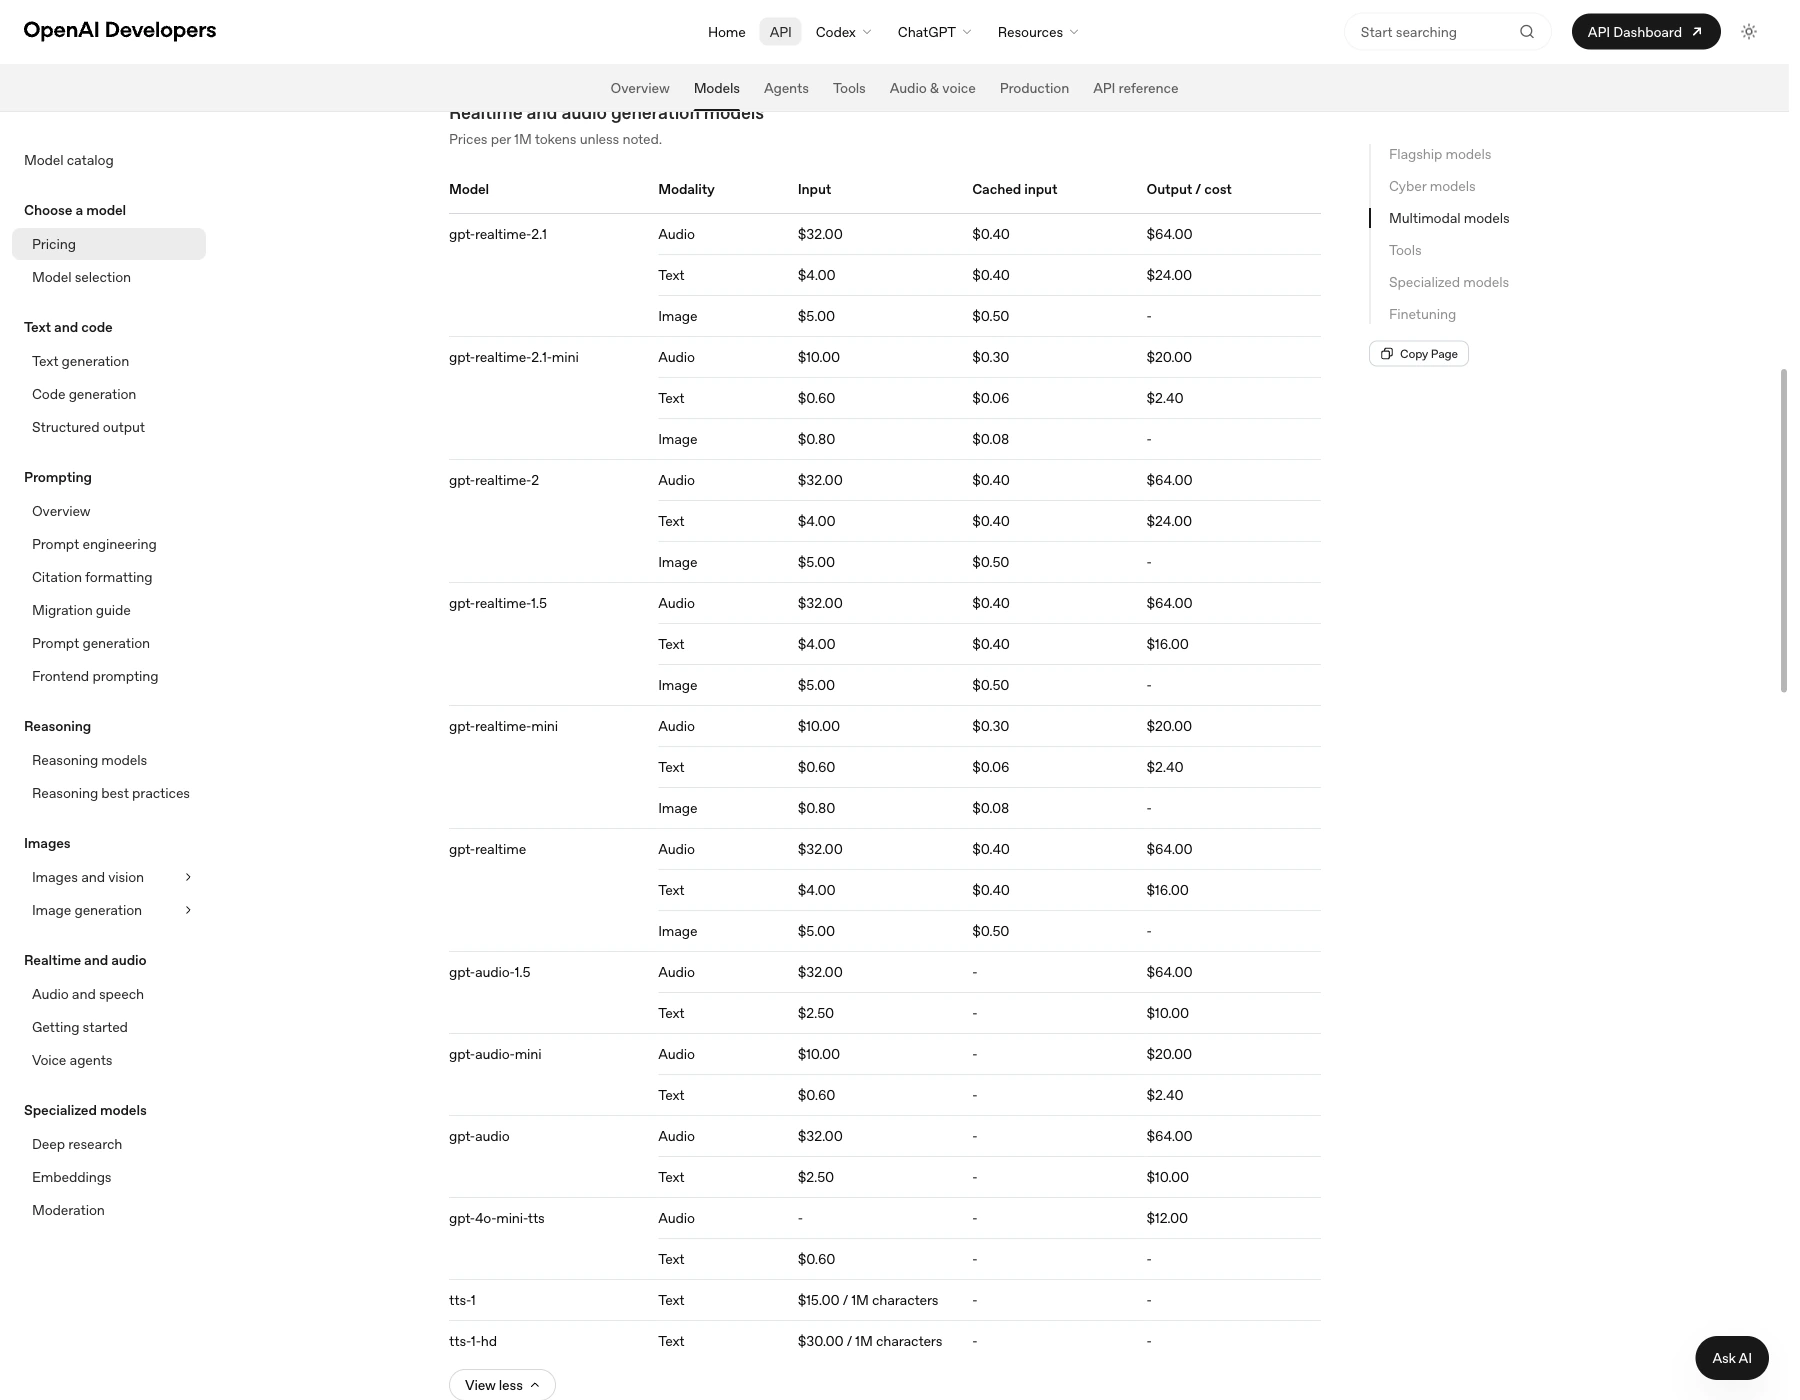
예를 들어, 각 1,000자씩인 스크립트 100개는 총 100,000자가 됩니다. 명시된 요율에 따르면, 이는 $1.50 (TTS-1 포함) 또는 TTS-1 HD가 탑재된 $3.00, 다른 애플리케이션 비용이 발생하기 전에. 동일한 문자 수만으로는 Mini TTS를 정확하게 계산하기에 불충분합니다. 텍스트 입력 및 오디오 출력 토큰의 수량이 필요합니다.
음성 생성 비용 추정하기
선택한 경로의 요금 산정 단위를 입력하세요. 문자당 토큰 또는 분당 토큰으로의 자동 변환 기능은 제공되지 않습니다.
계산식: 문자 수 × $15 ÷ 1,000,000. 텍스트 총량은 여러 API 요청에 걸쳐 있을 수 있습니다.
2026년 9월 28일 기준 요금: OpenAI · GlobalGPT. 스토리지, 호스팅, 세금 및 애플리케이션의 기타 구성 요소는 제외됩니다.
계획 수립을 위해 계산기에 실제 사용 횟수나 명확한 가정을 입력하십시오. 실제 사용량을 측정할 때까지는 ‘Mini TTS 오디오 토큰’ 필드를 예산 입력값으로 간주하십시오. 분당 대략적인 수치를 모든 음성, 말하기 속도 또는 언어에 대해 확정된 가격으로 간주해서는 안 됩니다.
GlobalGPT 모델 카탈로그는 TTS 가격을 크레딧 단위로 표시하며, 해당 모델의 예상 결과 값은 사용자가 전송하려는 요청에 대한 견적을 제공합니다. API 크레딧 사용량은 일상적인 글쓰기 및 미디어 작업을 위한 다중 모델 워크스페이스 구독과 별도로 관리해야 합니다. 이렇게 하면 두 제품이 하나의 청구 한도를 공유한다고 가정하지 않고도 예산을 더 쉽게 관리할 수 있습니다.
GlobalGPT API를 사용하여 TTS 워크플로우 구축하기
반복 가능한 스크립트-음성-영상 워크플로우를 위해서는, GlobalGPT에서 음성 생성 나머지 프로젝트는 같은 작업 공간에 보관합니다. 이 GlobalGPT API 미디어 생성을 단순한 과제로 드러내는 반면, GlobalGPT CLI 사용자의 터미널 및 개발 도구와 연동되는 연결 기능입니다.
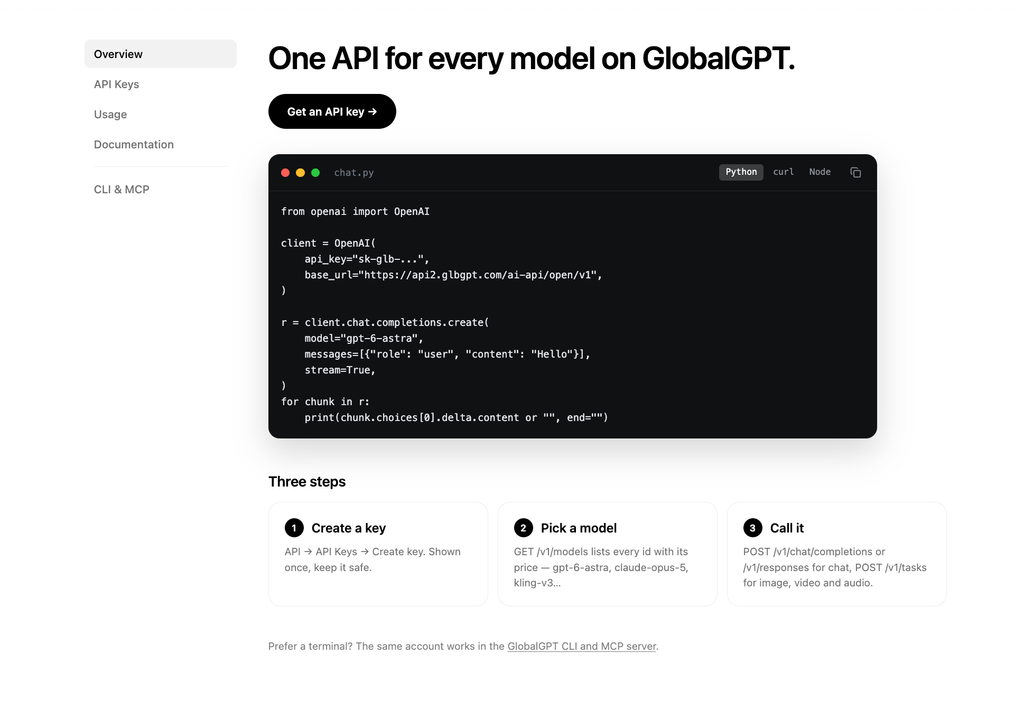
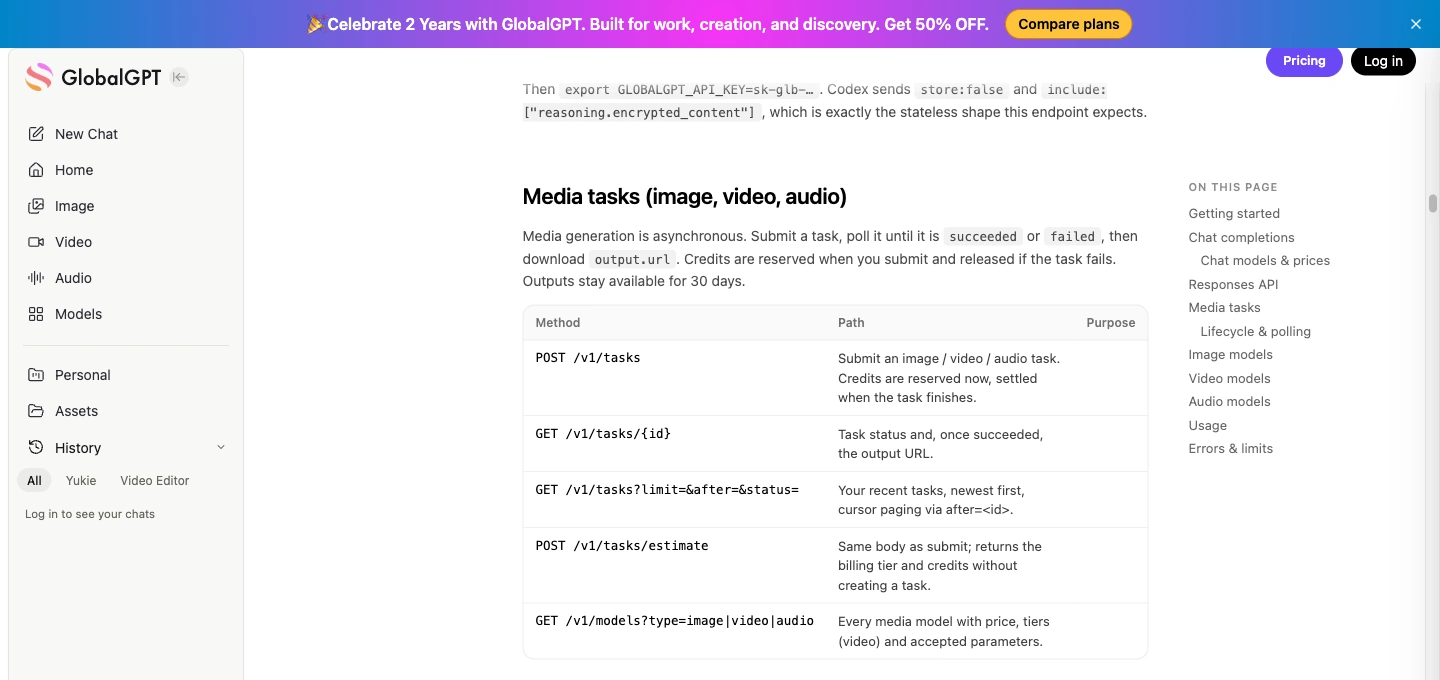
공개 기본 URL을 사용하세요 https://api2.glbgpt.com/ai-api/open/v1. TTS 요청을 다음 주소로 보내주세요 POST /tasks, 쿼리 GET /tasks/{id}, 그리고 다운로드 output.url 작업이 성공적으로 완료된 후. 텍스트 필드는 프롬프트. 이 작업 계약을 직접 구현하십시오. 이는 OpenAI의 즉각적인 오디오 응답과는 다릅니다.
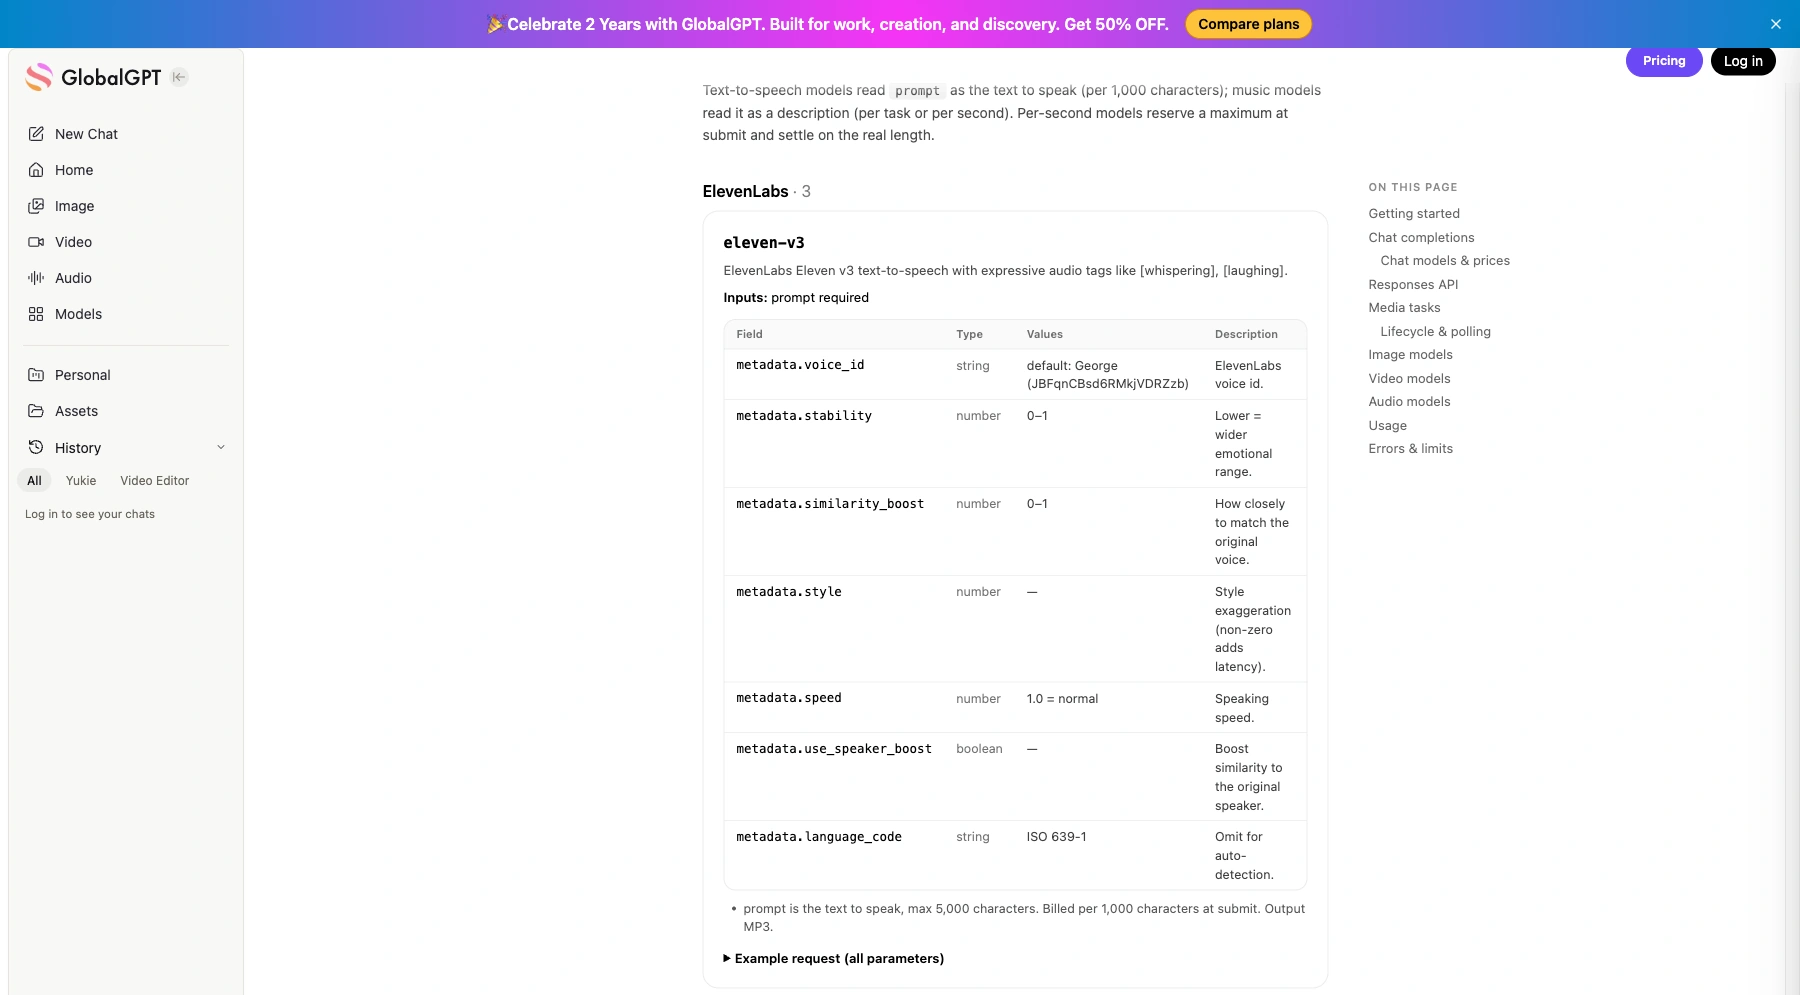
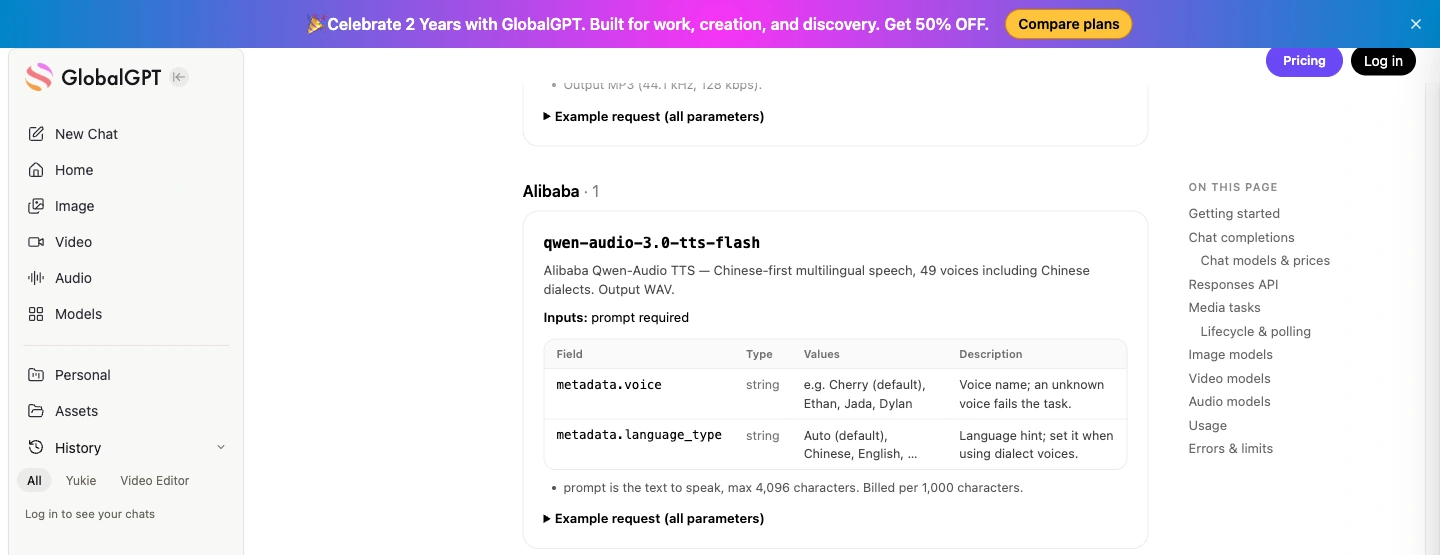
문서화된 GlobalGPT TTS 모델을 하나 선택하세요
| 모델 ID | 입력 및 출력 | 유용한 구분 |
|---|---|---|
eleven-v3 | 최대 5,000자; MP3 | 표현력 있는 오디오 태그를 지원합니다. |
eleven-다국어-v2 | 최대 10,000자; MP3 | 29개 언어; 오디오 태그는 텍스트로 읽힙니다. |
qwen-audio-3.0-tts-flash | 최대 4,096자; WAV | 49개의 음성; 음성 및 언어 제어에는 Qwen 전용 필드가 사용됩니다. |
세 항목 모두 나열 1,000자당 330 크레딧. 사용 POST /tasks/estimate 해당 견적에 대한 요청 본문을 포함해야 합니다. 문서에 따르면 이 경우 작업이 생성되지 않으며 크레딧도 예약되지 않습니다. 공개 API 이용 시 유료 크레딧이 사용됩니다.
더 광범위한 제작 워크플로에 대해서는 다음을 참조하십시오. GlobalGPT의 텍스트 음성 변환 워크플로우. 별도로 명명된 오픈소스 Qwen3-TTS 제품군에 대해 조사하고 계신다면, 다음을 읽어보시기 바랍니다. Qwen3-TTS 모델 및 API 옵션; 위의 Qwen-Audio 모델 ID를 Qwen3-TTS 배포와 상호 교환 가능한 것으로 간주하지 마십시오.
예산을 산정하고, 한 번 제출한 다음, 저장된 작업을 조회합니다.
설치 요청 와 함께 python -m pip install requests 그리고 설정 GLOBALGPT_API_KEY 서버에서. 아래 예제는 Eleven v3를 사용하고, 문서화된 공개 음성 ID를 선택하며, 설명을 위해 크레딧 한도를 500으로 설정합니다. 실행하기 전에 이 한도를 본인의 예산에 맞게 변경하십시오.
GlobalGPT 공개 TTS 작업 API · Python
"""requests 모듈을 설치하고 GLOBALGPT_API_KEY를 설정합니다. GlobalGPT의 공개 태스크 API를 사용합니다."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # 작업당 최대 크레딧 수량입니다. 실행 전에 수정하세요.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Acorn Studio 제품 투어에 오신 것을 환영합니다. 세 단계만 거치면 "
 "짧은 대본을 오디오 가이드로 만들 수 있습니다. 먼저, 메시지를 작성하세요. 다음으로, "
 "음성을 선택하세요. 마지막으로, 오디오 파일을 저장하고 휴대폰에서 재생 테스트를 해보세요."
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("이 작업은 다른 입력에 해당합니다. 새로운 상태 파일 이름을 사용하십시오.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("예상 크레딧:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("견적 크레딧이 작업당 상한선을 초과합니다.")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # 영구 저장된 키는 이 정확한 요청과 연결된 전송 재시도 정보를 유지합니다.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("무시된 매개변수:", task["ignored_parameters"])

print("작업:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
 print("무시된 매개변수:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("생성 실패: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # 새로운 요청을 사용합니다: 미디어 호스트에 API 키를 전송하지 마십시오.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("저장됨:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("작업이 아직 처리 중입니다. 저장된 작업 ID를 확인하려면 다시 실행하십시오.")
작업 파일에는 정확한 요청 내용, 항등성 키 및 작업 ID가 저장됩니다. 연결이 끊어진 경우, 동일한 작업을 다시 실행하면 코드가 기존 작업을 재개할 수 있습니다. 의도적으로 다른 오디오를 생성하려면 새로운 작업 파일 이름을 사용하십시오. 스크립트에 기밀 정보가 포함되어 있다면 작업 파일을 비공개로 유지하십시오.
확인 무시된 매개변수 따라서 지원되지 않는 설정이 사용자에게 알리지 않은 채 기본 구성으로 설정되지는 않습니다. ElevenLabs의 다음과 같은 제어 항목들, 예를 들어 voice_id Qwen의 것과 다르다 음성 그리고 언어 유형 필드. 5~10초마다 폴링을 수행하고, 실패함 상태를 확인하고, 정상적으로 저장된 파일은 즉시 저장하십시오. 문서화된 결과 보존 기간은 30일.
두 가지 제품 소개 예시를 들어보세요
이 두 가지 AI 생성 샘플은 Eleven v3와 Qwen Audio 3.0 TTS Flash를 사용하여 동일한 216자 분량의 제품 소개 대본을 기반으로 합니다. 각 샘플은 기본 음성 설정을 적용한 상태에서 한 번의 요청으로 생성된 첫 번째 결과물입니다. 이 샘플들은 검토 및 청취를 위한 두 개의 짧은 파일일 뿐이며, 일치하는 음성을 대상으로 한 체계적인 비교나 OpenAI 음성 벤치마크가 아닙니다.
Eleven v3: 제품 소개 오디오
eleven-v3 · 제품 둘러보기 예시
- 출력
- MP3 · 모노 · 44.1 kHz
- 길이
- 약 15.6초
- 세대
- 첫 번째 출력 · 1건의 요청
설정: 아래의 정확한 텍스트, 기본 음성 및 기타 설정; 음성 변경이나 발화 지침 없음. 기본 음성 정체성은 녹음되지 않았습니다.
현황 및 일정: 생성이 성공했습니다. 작업의 서버 타임스탬프를 보면 제출부터 완료까지 13초가 소요된 것으로 나타납니다. 이는 단일 요청에 대한 결과일 뿐, 지연 시간 벤치마크 결과가 아닙니다.
파일 관찰: 이 MP3 파일은 44.1 kHz의 모노 스트림을 포함하고 있으며, 크기는 약 251 kB입니다. 파일 끝까지 프레임을 읽을 수 있습니다.
비용 참고: 공개 카탈로그 요금은 1,000자당 330크레딧입니다. 새로운 요청의 경우 작업 견적을 활용하시기 바랍니다. 이 요금은 샘플에 대한 청구 금액이 아닙니다.
실용적인 용도: 짧은 제품 소개 영상을 미리 들어볼 수 있는 소형 MP3 파일입니다. 정식 출시 전에 대상 기기에서 전체 대사와 재생 상태를 확인해 주세요.
정확한 입력 내용 보기 · 216자
Acorn Studio 제품 소개에 오신 것을 환영합니다. 단 세 단계만 거치면 짧은 대본을 오디오 가이드로 만들 수 있습니다. 먼저, 메시지를 작성하세요. 다음으로, 음성을 선택하세요. 마지막으로, 오디오 파일을 저장하고 휴대폰에서 재생해 보세요.
Qwen 오디오 3.0 TTS 플래시: 제품 소개 오디오
qwen-audio-3.0-tts-flash · 제품 소개 예시
- 출력
- WAV · 모노 · 24 kHz
- 길이
- 15.52초 분량의 PCM 데이터
- 세대
- 첫 번째 출력 · 1건의 요청
설정: 아래의 정확한 텍스트, 기본 음성 및 기타 설정; 음성 변경이나 발화 지침 없음. 기본 음성 정체성은 녹음되지 않았습니다.
현황 및 일정: 생성이 성공했습니다. 해당 작업의 서버 타임스탬프를 보면 제출부터 완료까지 17초가 소요된 것으로 나타납니다. 이는 단일 요청에 대한 결과일 뿐, 지연 시간 벤치마크는 아닙니다.
파일 관찰: 이 WAV 파일은 24 kHz의 16비트 모노 PCM을 포함하고 있으며, 크기는 약 745 kB입니다. 헤더에는 파일에 포함된 데이터보다 더 많은 데이터가 선언되어 있으나, 여기서는 원본 출력 데이터를 그대로 보존했습니다.
비용 참고: 공개 카탈로그 요금은 1,000자당 330크레딧입니다. 새로운 요청의 경우 작업 견적을 활용하시기 바랍니다. 이 요금은 샘플에 대한 청구 금액이 아닙니다.
실용적인 용도: 내레이션 워크플로우를 평가하기 위한 WAV 샘플입니다. 제작 파이프라인에서 헤더 길이의 불일치를 해결하고, 배포 전에 전체 재생 상태를 확인하십시오.
정확한 입력 내용 보기 · 216자
Acorn Studio 제품 소개에 오신 것을 환영합니다. 단 세 단계만 거치면 짧은 대본을 오디오 가이드로 만들 수 있습니다. 먼저, 메시지를 작성하세요. 다음으로, 음성을 선택하세요. 마지막으로, 오디오 파일을 저장하고 휴대폰에서 재생해 보세요.
Qwen 샘플은 비슷한 재생 시간 기준 Eleven 샘플보다 크기가 약 3배 정도 더 큰데, 이는 WAV와 MP3 형식의 차이를 반영한 것입니다. 또한 이 파일의 WAV 헤더에는 파일에 실제로 포함된 데이터보다 더 많은 양의 데이터가 선언되어 있습니다. 이는 대상 플레이어에서 확인해 볼 가치가 있는 파일 패키징 문제일 뿐이며, 그 자체만으로는 음성 품질에 대해 어떤 것도 입증하지 못합니다.
흔히 발생하는 음성 생성 문제 해결
| 증상 | 가장 먼저 확인해야 할 사항 |
|---|---|
| 저장된 MP3 파일이 재생되지 않습니다 | HTTP 상태 및 응답 유형을 확인하세요. API 오류가 오디오 확장자로 저장되었을 수 있습니다. |
| 이 요청은 음성 또는 명령을 거부합니다. | 선택한 모델에 음성 및 선택 필드를 매칭하십시오. 구형 OpenAI TTS 모델은 명령어를 지원하지 않습니다. |
| 길이가 긴 대본은 기각됩니다. | 경로의 글자 수 제한과 미니 TTS 토큰 제한을 확인한 후, 자연스러운 구분 지점에서 분할하십시오. |
| 401 또는 429 응답이 나타납니다 | 401 오류의 경우 키/계정을 확인하십시오. 429 오류의 경우, 재시도하기 전에 속도 제한과 할당량 부족을 구분하십시오. |
| GlobalGPT 요청이 아직 처리 대기 중입니다. | 저장된 작업 ID를 조회하여 상태를 확인하십시오. 타임아웃이 발생했다고 해서 중복 작업을 제출해서는 안 됩니다. |
| 음성이 요청된 설정과 일치하지 않습니다. | 설정이 적용되었다고 가정하기 전에 모델별 메타데이터와 ignored_parameters를 확인하십시오. |
| 오디오 재생 시간 표시줄이나 탐색 막대가 제대로 표시되지 않습니다. | 파일 메타데이터를 실제 미디어 페이로드와 비교하고, 대상 플레이어에서 전체 파일을 테스트하십시오. |
OpenAI 오류의 경우, 먼저 다음부터 시작하십시오. 오류 코드 안내. GlobalGPT 작업의 경우, 작업 ID와 반환된 오류 세부 정보를 저장하십시오. 개발 과정에서 전송 오류, 청구 오류, 그리고 불량한 음성 녹음은 별도로 구분하여 관리하십시오. 각각에 대해 서로 다른 해결 방법이 필요하기 때문입니다.
나레이션을 전달하기 전에, 청중이 사용할 기기에서 녹음본 전체를 들어보세요. 서두, 이름과 숫자, 전환 부분, 마지막 문장을 확인하세요. 재생 시작 부분에 AI 음성 사용 안내를 포함하고, 수정된 대본을 의도대로 다시 생성할 수 있도록 정확한 원문과 모델 설정 정보를 보관해 두세요.
자주 묻는 질문
OpenAI 오디오 음성 API 엔드포인트란 무엇입니까?
https://api.openai.com/v1/audio/speech로 POST 요청을 보내세요. 필수 입력 항목은 model, input, voice입니다. 응답은 생성된 오디오 파일이며, 기본 형식은 MP3입니다.
OpenAI Speech API는 무료인가요?
Speech API는 사용량 기반 과금 방식을 적용합니다. 무료 할당량을 가정하지 말고 현재 API 요율을 기준으로 예산을 책정하십시오. GPT-4o Mini TTS는 텍스트 입력 및 오디오 출력 토큰 단위로 과금되는 반면, TTS-1 및 TTS-1 HD는 문자 단위로 과금됩니다.
음성과 말투를 조절할 수 있나요?
사용 중인 모델에서 지원하는 음성을 선택하세요. GPT-4o Mini TTS는 ‘따뜻한 어조’나 ‘차분한 어조’와 같은 발음 방식에 대한 지시도 받아들입니다. 단, TTS-1 또는 TTS-1 HD의 경우 지시 입력란이 작동하지 않습니다.
Speech API는 스트리밍을 지원하나요?
네. 생성된 오디오를 청크 단위로 스트리밍할 수 있습니다. 하지만 재생 처리는 여전히 애플리케이션에서 담당해야 합니다. 텍스트 음성 변환(TTS) 스트리밍만으로는 완전한 실시간 음성 대화를 구현할 수 없습니다.
OpenAI의 기본 URL을 변경해서 GlobalGPT를 사용할 수 있나요?
TTS의 경우 GlobalGPT의 문서화된 미디어 작업 워크플로를 사용하십시오: POST /tasks로 요청을 전송하고, GET /tasks/{id}로 상태를 확인한 뒤, 성공 시 output.url에서 결과를 다운로드하십시오. 문서화된 TTS 카탈로그에는 고유한 모델 ID와 매개변수를 가진 ElevenLabs 및 Qwen 모델이 포함되어 있습니다.
어떤 오디오 형식으로 시작하는 게 좋을까요?
간단한 다운로드나 웹 플레이어를 사용하려면 MP3로 시작하세요. WAV는 다음 단계로 편집을 할 때 유용합니다. 원시 PCM은 파일 헤더가 없기 때문에, 해당 샘플 레이트와 비트 심도에 맞춰 설정된 플레이어가 필요합니다.
짧은 스크립트 하나, 음성 하나, 저장된 파일 하나로 시작하세요. 재생 및 비용이 예측 가능해지면 청크 분할, 재시도 및 나머지 미디어 워크플로를 추가하세요. 구현 시 선택한 API의 요청 형식, 과금 단위 및 출력 처리를 일관되게 유지하세요.
다음 대본에 목소리를 불어넣어 보세요
간단한 제품 투어 초안을 작성하고, ElevenLabs 또는 Qwen를 사용하여 음성 해설을 제작한 다음, GlobalGPT의 멀티 모델 작업 공간에서 이미지 및 동영상 작업을 계속 진행하세요.
GlobalGPT를 사용하여 음성 오디오 생성하기








