
L'attuale pagina dedicata all'API di OpenAI riporta che, per un contesto breve, GPT-5.6 Sol corrisponde a $4 per milione di token in ingresso e a $20 per milione di token in uscita. Le frequenze a contesto lungo sono $8/M in ingresso e $30/M in uscita. L'input nella cache è pari a $0,40/M per il contesto breve o a $0,80/M per il contesto lungo, mentre le scritture nella cache sono rispettivamente pari a $5/M o $10/M.
La stessa pagina riporta, per una breve panoramica, che GPT-5.6 Cyber ha un input di $12,50/M e un output di $75/M. OpenAI indica che il prezzo promozionale di GPT-5.6 Sol è disponibile almeno fino al 21 novembre 2026. Si tratta di tariffe API; un piano ChatGPT o un credito Codex costituiscono un acquisto diverso.
Per lavorare in modo interattivo tra modelli, programmazione e funzioni creative, GlobalGPT ti offre uno spazio di lavoro in abbonamento dedicato all'attività. La domanda fondamentale è se hai bisogno di una chiamata di produzione a consumo, di un flusso di lavoro per sviluppatori o di uno spazio a basso costo in cui confrontare e portare a termine il lavoro prima di impegnare il budget destinato alle API.
- Panoramica sui prezzi GPT-5.6
- Tariffe GPT-5.6 per Sol e Cyber API
- Stime relative al token GPT-5.6 elaborate
- Dati di input memorizzati nella cache e contesto esteso
- I piani ChatGPT e i crediti Codex hanno prezzi diversi rispetto a quelli dell'API
- Scelta di un'API, una CLI o un'area di lavoro multimodello
- L'accesso al piano ChatGPT è un budget a sé stante
- Scegli il percorso modello per svolgere l'attività
- Un test ripetibile sull'utilizzo dei token
- Quando un aggiornamento giustifica la spesa aggiuntiva per l'API
- Dalla chiamata API a un flusso di lavoro completo per gli sviluppatori
- FAQ
Panoramica sui prezzi GPT-5.6
| Modello / modalità | Inserimento breve | Output breve | Testo lungo | Output lungo |
|---|---|---|---|---|
| GPT-5.6 Sol | $4.00/M | $20,00/M | $8.00/M | $30,00/M |
| GPT-5.6 Cyber | $12,50/M | $75,00/M | - | - |
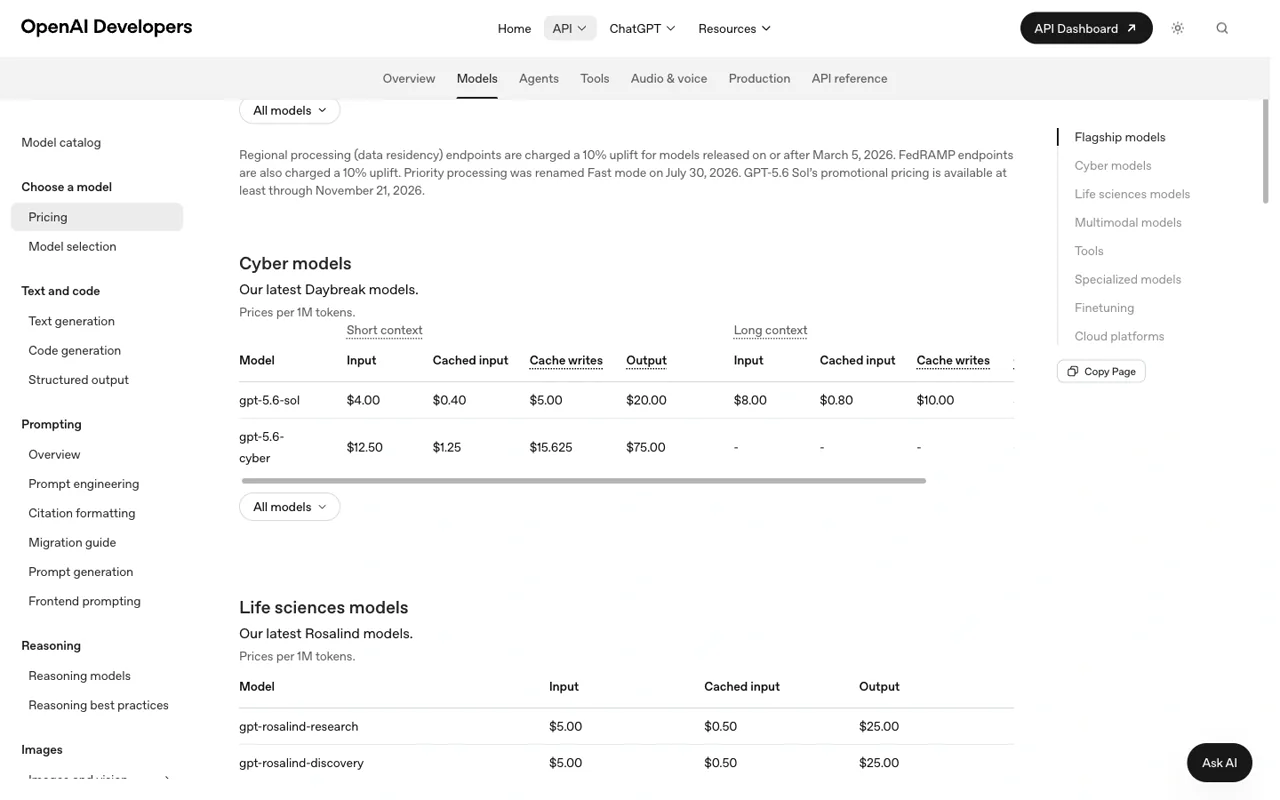
Leggi il listino prezzi per unità di fatturazione: input, input in cache, scritture in cache e output sono righe separate, mentre le richieste a contesto lungo utilizzano una fascia tariffaria diversa.
Gli input in cache e le scritture in cache hanno velocità diverse. La pagina dell'API di OpenAI distingue inoltre le colonne Standard, Batch e Flex; scegli una modalità che la tua applicazione possa effettivamente utilizzare prima di applicare uno sconto a una previsione.
Tariffe GPT-5.6 per Sol e Cyber API
| Tasso per 1 milione di token | GPT-5.6 Posizione corta su Sol | GPT-5.6 Posizione lunga su Sol | GPT-5.6 Cyber corto |
|---|---|---|---|
| Ingresso | $4.00 | $8.00 | $12.50 |
| Input memorizzato nella cache | $0.40 | $0.80 | $1.25 |
| Scritture nella cache | $5.00 | $10.00 | $15.625 |
| Uscita | $20.00 | $30.00 | $75.00 |
GPT-5.6 Cyber è concepito come un modello specifico per la sicurezza informatica, piuttosto che come un sostituto generico di Sol. Utilizzatelo quando l’attività trae vantaggio specifico da tale approccio; non limitatevi a confrontare il prezzo finale e a definirlo un aggiornamento universale.
Stime relative al token GPT-5.6 elaborate
Utilizzare i token ÷ 1.000.000 × il tasso applicabile. Questi esempi si basano sul contesto breve GPT-5.6 Sol ed escludono tasse, costi per gli strumenti, differenze Batch/Flex e commissioni del piano.
| Scenario | Ingresso | Uscita | Stima |
|---|---|---|---|
| Piccola modifica | 20.000 × $4/M = $0,08 | 3.000 × $20/M = $0,06 | $0.14 |
| Revisione del codice | 250.000 × $8/M = $2,00 (lungo) | 20.000 × $30/M = $0,60 | $2.60 |
| Lotto di grandi dimensioni con contesto breve | 1M × $4/M = $4,00 | 100k × $20/M = $2,00 | $6.00 |
costo stimato dell'API = token in ingresso / 1.000.000 × tariffa di ingresso + input memorizzati nella cache / 1.000.000 × tariffa della cache + token in uscita / 1.000.000 × tariffa di uscita + costi degli strumenti
Dati di input memorizzati nella cache e contesto esteso
L'input memorizzato nella cache è utile quando un prefisso ricorrente — come un codice di riferimento del sistema o un contesto di repository — soddisfa i requisiti per la memorizzazione nella cache. Tuttavia, ciò non rende economico ogni prompt ricorrente. Utilizza i dati di utilizzo relativi alla fatturazione per verificare i risultati positivi della cache e aggiungere i costi di scrittura nella cache o di archiviazione laddove il fornitore li indichi.
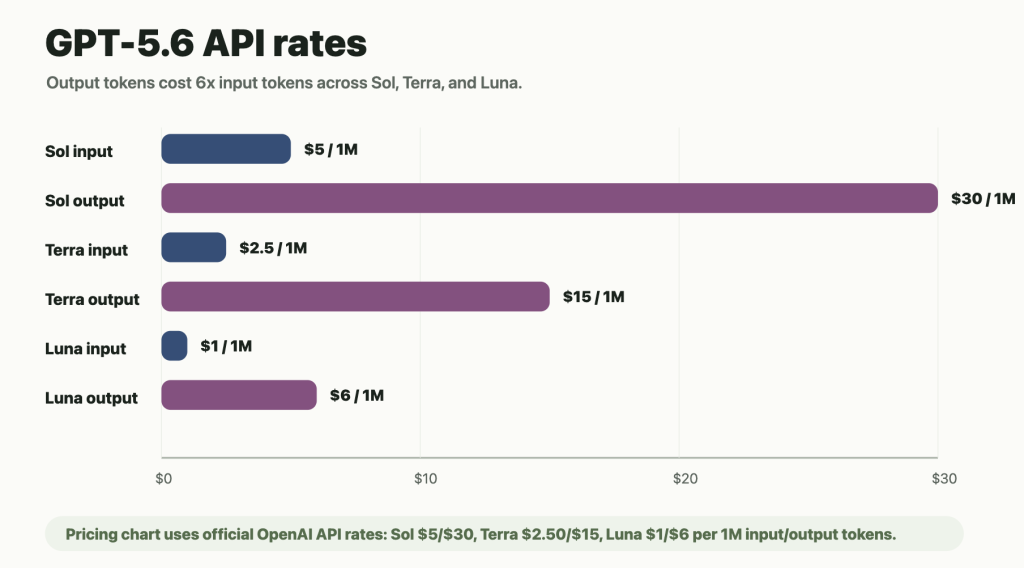
Anche il contesto lungo modifica la fascia tariffaria. Se la richiesta supera il limite del contesto lungo del fornitore, utilizzare i prezzi di input e output del contesto lungo per quella richiesta, anziché applicare la tariffa del contesto breve all’intera fattura.
I piani ChatGPT e i crediti Codex hanno prezzi diversi rispetto a quelli dell'API
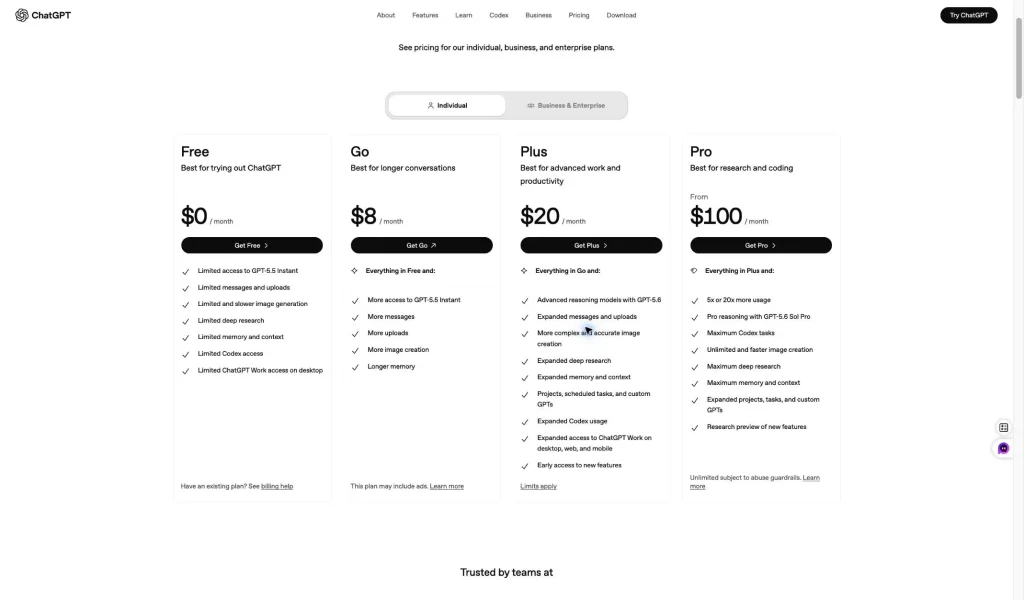
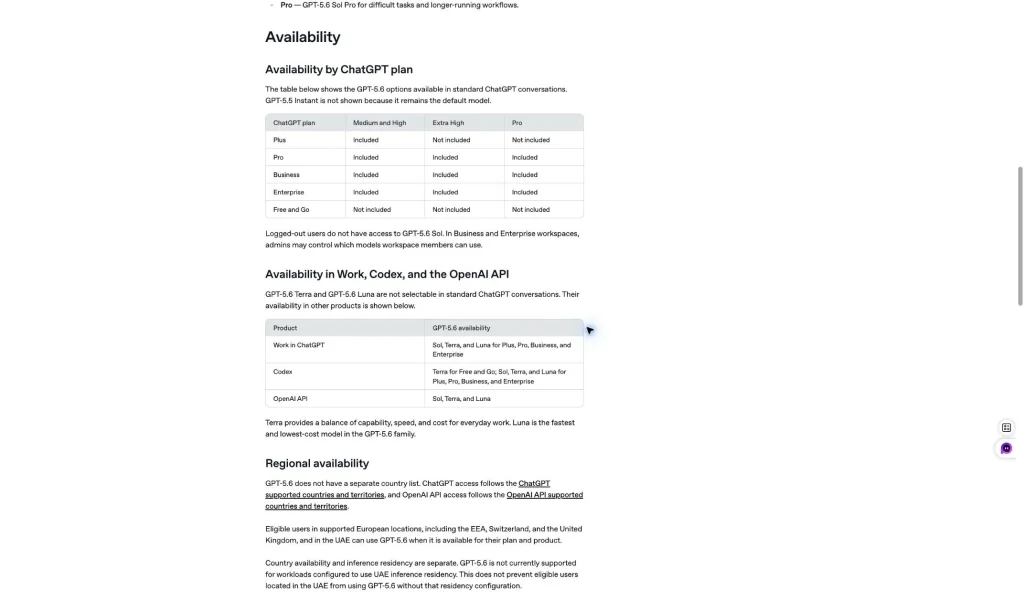
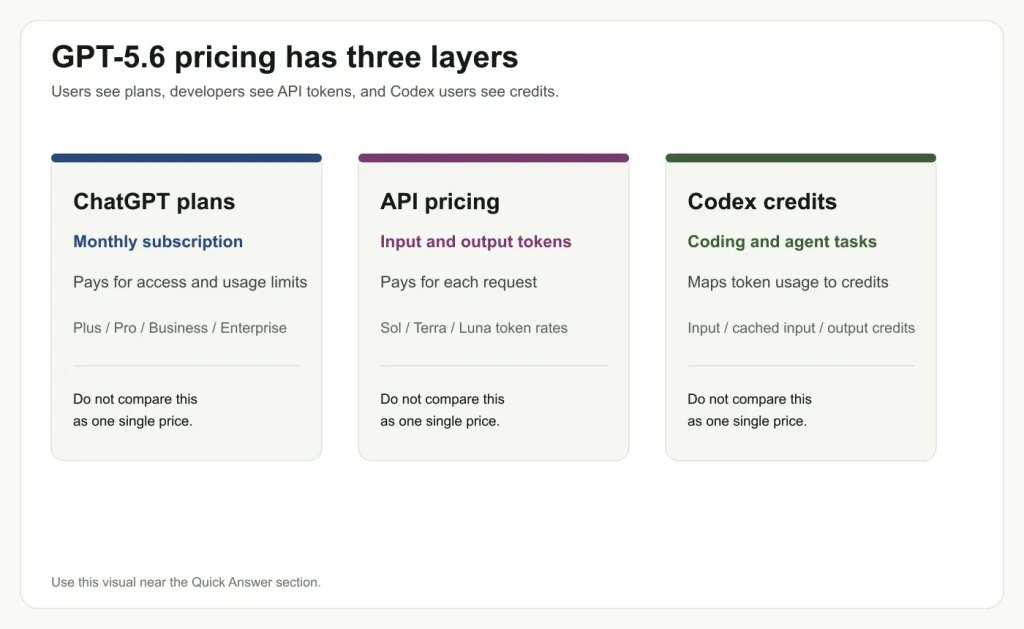
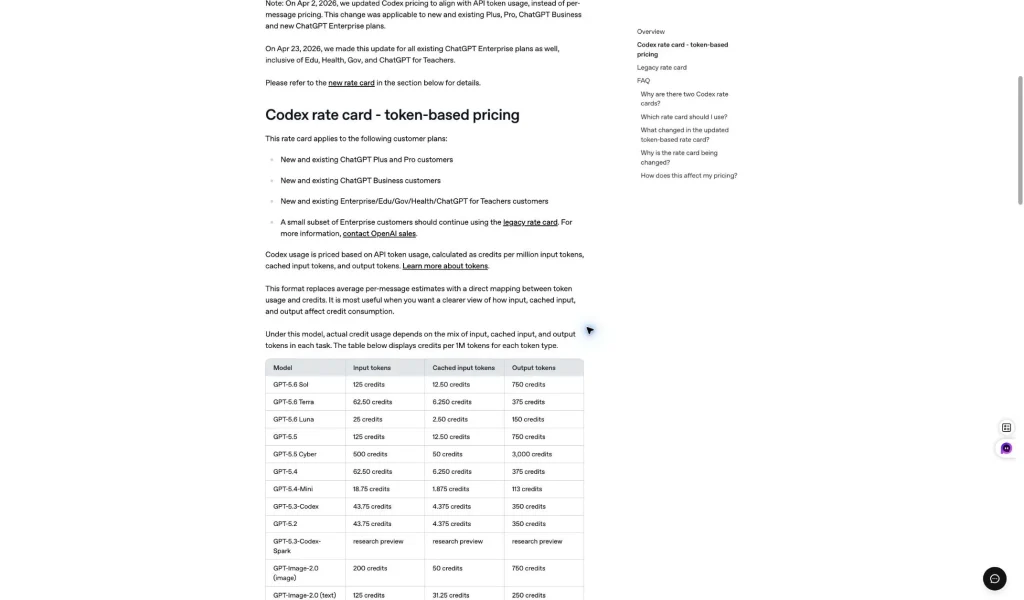
Gli abbonamenti ChatGPT includono l'accesso alle app e alle funzionalità. I crediti Codex rappresentano l'utilizzo all'interno di un'interfaccia di prodotto. Le chiamate API vengono conteggiate in base a un progetto di sviluppo. È importante tenere separati questi tre budget quando si confrontano i “prezzi GPT-5.6”.”
Scelta di un'API, una CLI o un'area di lavoro multimodello

Utilizza l'API per gestire il traffico di produzione in modo programmabile e per la contabilità a livello di token. Utilizza la CLI quando il modello deve essere integrato con un terminale e un repository. Utilizza MCP quando il flusso di lavoro dipende da strumenti approvati. Utilizza un agente Yukie quando l'attività comprende la pianificazione, l'uso degli strumenti e i passaggi di consegne.
GlobalGPT si adatta al livello di confronto interattivo e di erogazione: è possibile provare diversi modelli, passare alla fase di codifica o ad altre funzioni di IA e mantenere la decisione relativa all’abbonamento separata dalla fattura API di OpenAI. Il suo costo complessivo del flusso di lavoro più contenuto rappresenta un valore aggiunto, non un’affermazione secondo cui modificherebbe le tariffe di OpenAI.
L'accesso al piano ChatGPT è un budget a sé stante
Un abbonamento ChatGPT consente l'accesso a un'interfaccia di prodotto. L'API addebita un progetto di sviluppo in base al token, mentre i crediti Codex rappresentano l'utilizzo all'interno del flusso di lavoro di un prodotto. Questi registri possono essere correlati alla stessa famiglia di modelli pur rappresentando acquisti distinti.
| Percorso | Cosa si paga | La domanda migliore da porre |
|---|---|---|
| Piano ChatGPT | Accesso all'app interattiva e funzionalità del piano | Il piano mette a disposizione il modello e gli strumenti di cui ho bisogno? |
| API OpenAI | Input, input memorizzato nella cache, scritture nella cache, output e costi degli strumenti | Quanto costerà questo carico di lavoro in base al volume effettivo di token? |
| Crediti del Codex | Utilizzo all’interno della superficie del prodotto Codex | Quanto lavoro relativo al repository o alla programmazione è coperto dal budget a credito? |
| Area di lavoro GlobalGPT | Un flusso di lavoro di sottoscrizione più ampio che abbraccia diversi modelli e strumenti | Posso portare a termine l'attività senza dover acquistare diversi prodotti separati? |
Non utilizzare il prezzo del piano ChatGPT come previsione API, né utilizzare una tariffa API per descrivere l'accesso in abbonamento. Per effettuare un confronto corretto, occorre innanzitutto indicare il percorso che consentirà effettivamente di portare a termine il proprio lavoro.
Scegli il percorso modello per svolgere l'attività
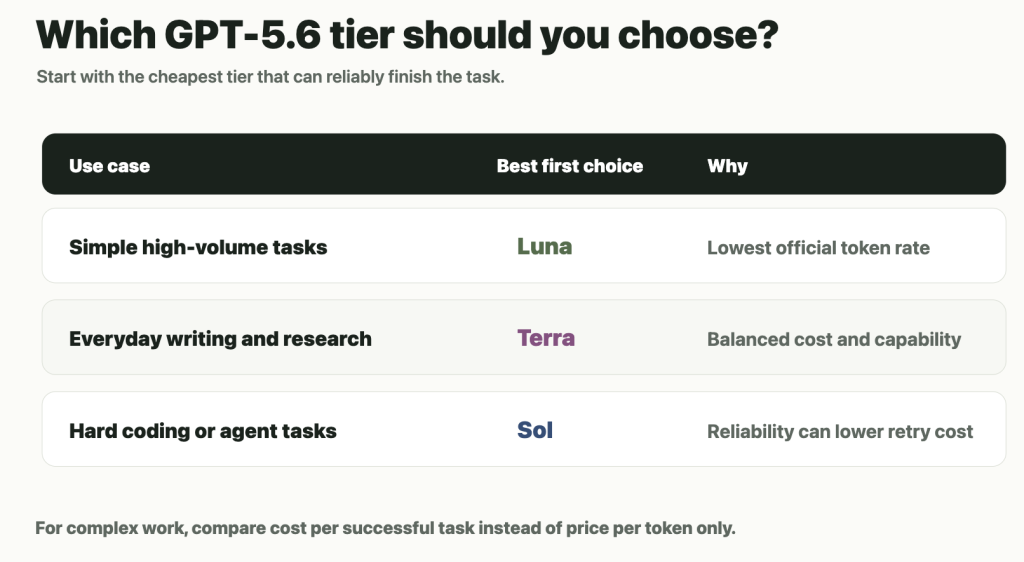
La riga più economica non corrisponde automaticamente all'operazione completata più economica. Una modifica breve può risultare poco costosa in un modello generico, mentre un contesto di repository esteso può far sì che il livello di contesto e la lunghezza dell'output assumano maggiore rilevanza. Per una chiamata in produzione, registrare separatamente i token di input, l'input memorizzato nella cache, i token di output ed eventuali chiamate agli strumenti.
| Modalità di lavoro | Segnale di bilancio | Buone abitudini operative |
|---|---|---|
| Trasformazione di testi brevi | La produzione rimane spesso modesta | Definire un formato di output chiaro e una condizione di arresto. |
| Revisione di codici o documenti di lunga durata | Potrebbe essere applicato il livello "contesto lungo" | Misura le dimensioni del prompt prima di inviare l'intero repository. |
| Contesto di sistema o repository ripetuto | I dati memorizzati nella cache possono essere importanti | Verificare il numero effettivo di accessi alla cache nei dati di utilizzo. |
| Flusso di lavoro autonomo degli strumenti | Le chiamate alle funzioni aggiungono l'utilizzo | Registra insieme il modello, lo strumento e il costo di produzione. |
Utilizza il selettore dei modelli e il listino prezzi attuali per conoscere i nomi esatti dei modelli e le condizioni di accesso. Se l'etichetta di un modello cambia, il metodo di calcolo rimane lo stesso: abbina l'attività al percorso, quindi moltiplica le unità effettive.
Un test ripetibile sull'utilizzo dei token
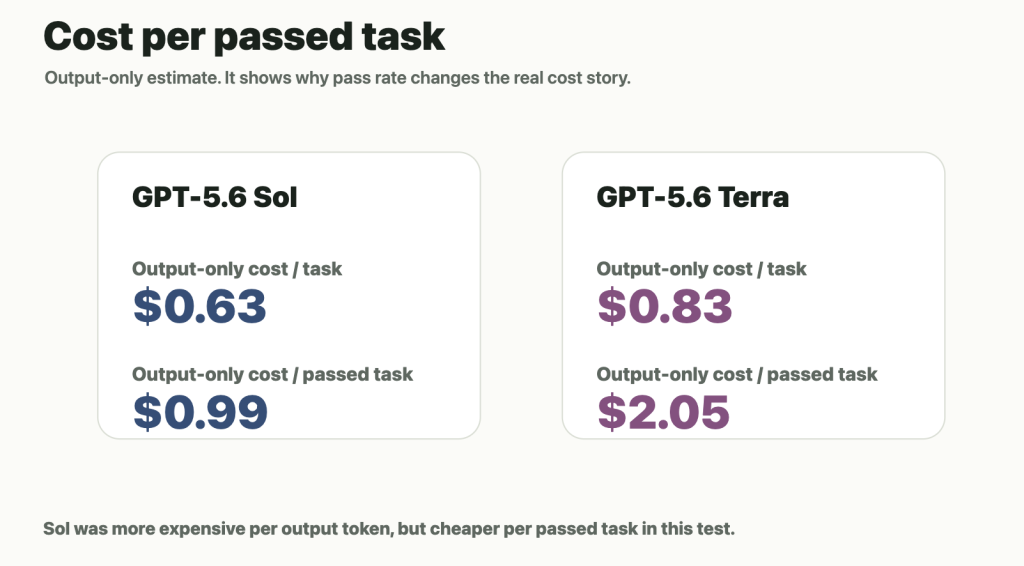
Per valutare un'attività reale, utilizzare lo stesso prompt, lo stesso input e lo stesso output atteso in due esecuzioni. Registrare i token di input, i token di output, lo stato della cache e se è stata effettuata una chiamata a uno strumento. Quindi confrontare il costo di un risultato positivo, anziché limitarsi a confrontare isolatamente il prezzo di listino.
- Utilizza un breve esercizio di programmazione o di scrittura che sia rappresentativo.
- Mantieni il formato di output invariato, in modo che il confronto sia equo.
- Annotare il primo risultato e il risultato finale dopo ogni nuovo tentativo.
- Separare gli errori dei fornitori, i limiti di tariffa e la qualità del modello dal calcolo del prezzo.
- Ti consigliamo di prendere nota della data, poiché i prezzi promozionali e la disponibilità dei modelli possono variare.
Questo trasforma la domanda “quale modello è più economico?” in un’utile domanda operativa: quale percorso consente di portare a termine il compito con la minima spesa prevedibile e il minimo lavoro di rifinitura?
Quando un aggiornamento giustifica la spesa aggiuntiva per l'API
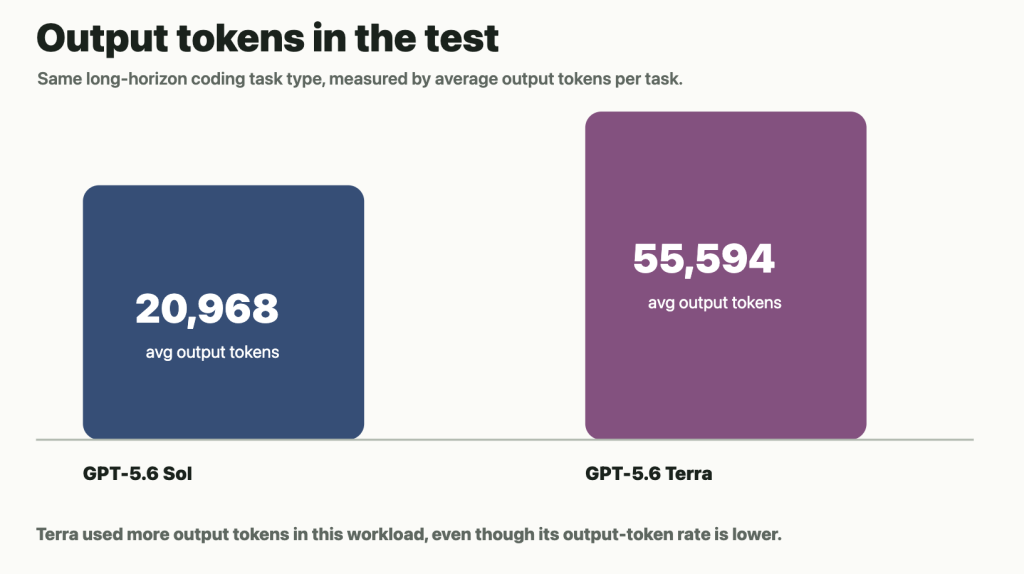
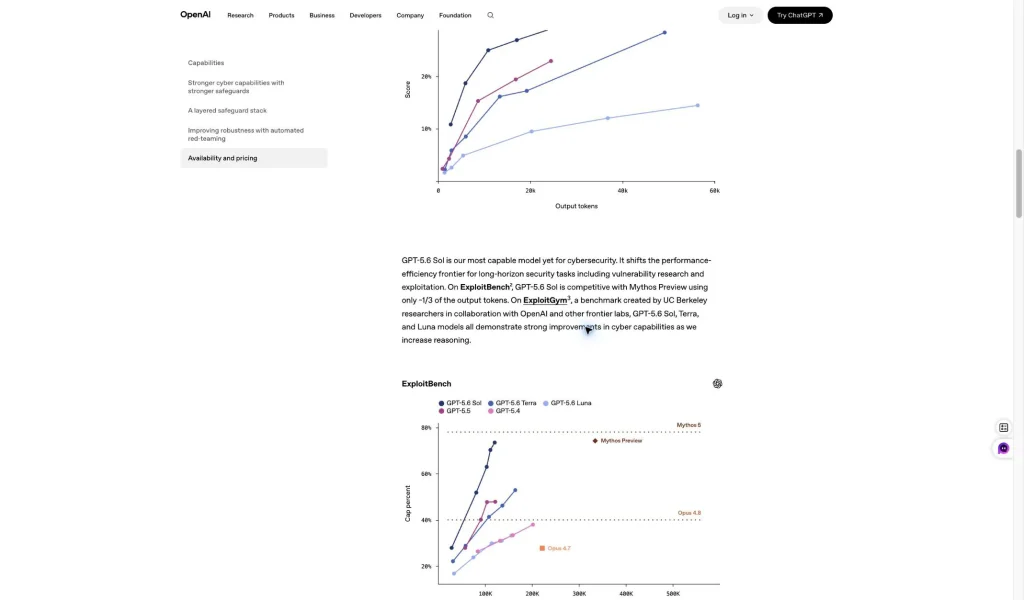
Un modello più recente giustifica il suo costo più elevato quando riduce una vera e propria causa di errore: correzioni ripetute, chiamate agli strumenti mancanti, codice fragile o un prompt lungo che la soluzione più economica non è in grado di gestire in modo affidabile. Se l'output è già corretto e conciso, un modello più costoso può rivelarsi uno spreco.
Per un team, confronta tre dati relativi allo stesso insieme di compiti: completamenti riusciti, numero medio di token generati e tempo impiegato per la correzione umana. Il modello con il prezzo per token più basso non sempre comporta il costo totale del progetto più basso.
Dalla chiamata API a un flusso di lavoro completo per gli sviluppatori
Utilizza il Percorso API GlobalGPT per le chiamate programmabili, CLI quando il modello deve essere affiancato da un terminale e da un repository, e MCP quando il flusso di lavoro dipende da strumenti approvati. Un agente Yukie può coordinare la pianificazione, l'uso degli strumenti e i passaggi di consegne. Per il lavoro interattivo, Accesso all'area di lavoro GlobalGPT e GPT-5.6 consente di testare l'attività prima di passare a un percorso di produzione a consumo.
Il vantaggio pratico sta nella sequenza: definire chiaramente il compito, individuare un modello adeguato, eseguire il test minimo necessario, quindi trasferire il prompt funzionante nell’API, nella CLI o nell’MCP. In questo modo si mantengono separati i costi legati alla fase di sperimentazione da quelli legati alla produzione.
FAQ
Qual è il prezzo dell'API GPT-5.6 Sol?
OpenAI indica $4/M in ingresso e $20/M in uscita per il contesto breve, e $8/M in ingresso e $30/M in uscita per il contesto lungo. L'ingresso nella cache e le scritture nella cache utilizzano velocità distinte.
Il modello GPT-5.6 Cyber è più costoso?
Le sue velocità di contesto breve pubblicate sono $12,50/M in ingresso e $75/M in uscita; si tratta quindi di una scelta di budget diversa e dovrebbe essere selezionato per un’attività che richiede il suo percorso specifico.
ChatGPT Plus include crediti API?
Non dare nulla per scontato. Gli abbonamenti ChatGPT e i progetti API sono entità di fatturazione distinte.
Cosa sono i crediti Codex?
Si tratta di crediti relativi all'utilizzo del prodotto, il cui consumo effettivo dipende dal modello e dall'utilizzo dei token. È opportuno tenerli distinti dalle previsioni relative a un progetto API.
Qual è il modo più economico per utilizzare GPT-5.6?
Per il lavoro interattivo con più modelli, confronta il piano attuale dell'area di lavoro. Per il software di produzione, confronta le stime dei token, gli accessi alla cache, il livello di contesto e il tasso di completamento del modello scelto.
Inizia dall'unità di fatturazione: Le tariffe dei token rispondono alla domanda relativa all'API; l'accesso al piano, i crediti e il valore del flusso di lavoro rispondono alla domanda relativa al prodotto.





