Sì, Grok 4.6 è un modello xAI ufficiale, rilasciato il 12 agosto 2026, e merita di essere preso seriamente in considerazione se il vostro lavoro prevede lunghe sessioni di ricerca, programmazione, analisi in più fasi o attività basate sulle immagini. La sua finestra di contesto da 500.000 token e il ragionamento configurabile gli conferiscono la capacità di affrontare progetti impegnativi, anche se non è automaticamente la scelta più veloce o migliore per ogni prompt. La vera domanda non è più se Grok 4.6 esista, ma se i suoi punti di forza siano in linea con il lavoro che devi effettivamente portare a termine.
Se vuoi rispondere a questa domanda senza legare l'intero flusso di lavoro a un unico fornitore, GlobalGPT è un ottimo punto di partenza. La sua area di lavoro nel browser ti permette di utilizzare Grok 4.6 insieme ad altri modelli di punta, eseguire lo stesso prompt di ricerca, scrittura, analisi o programmazione e confrontare i risultati in un unico posto. Si tratta di un modo pratico e piacevolmente semplice per capire in quali ambiti Grok 4.6 si distingue davvero — e in quali invece un altro modello si adatta meglio alle tue esigenze — prima di scegliere la configurazione o l’abbonamento più adatto a te.
Che cos’è esattamente Grok 4.6?
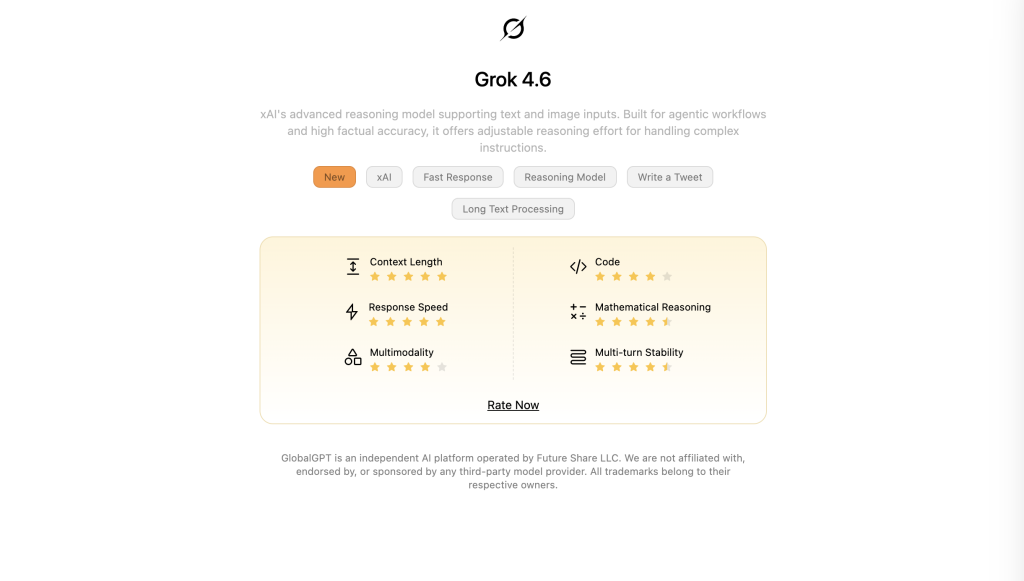
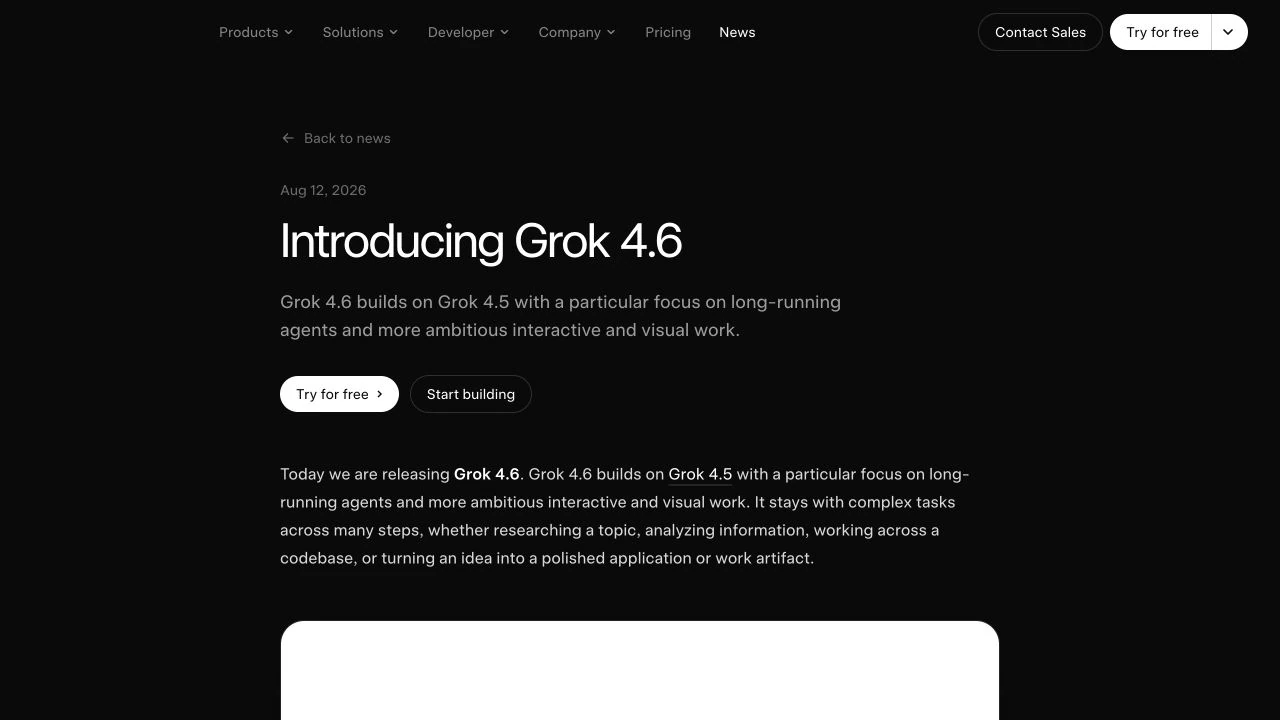
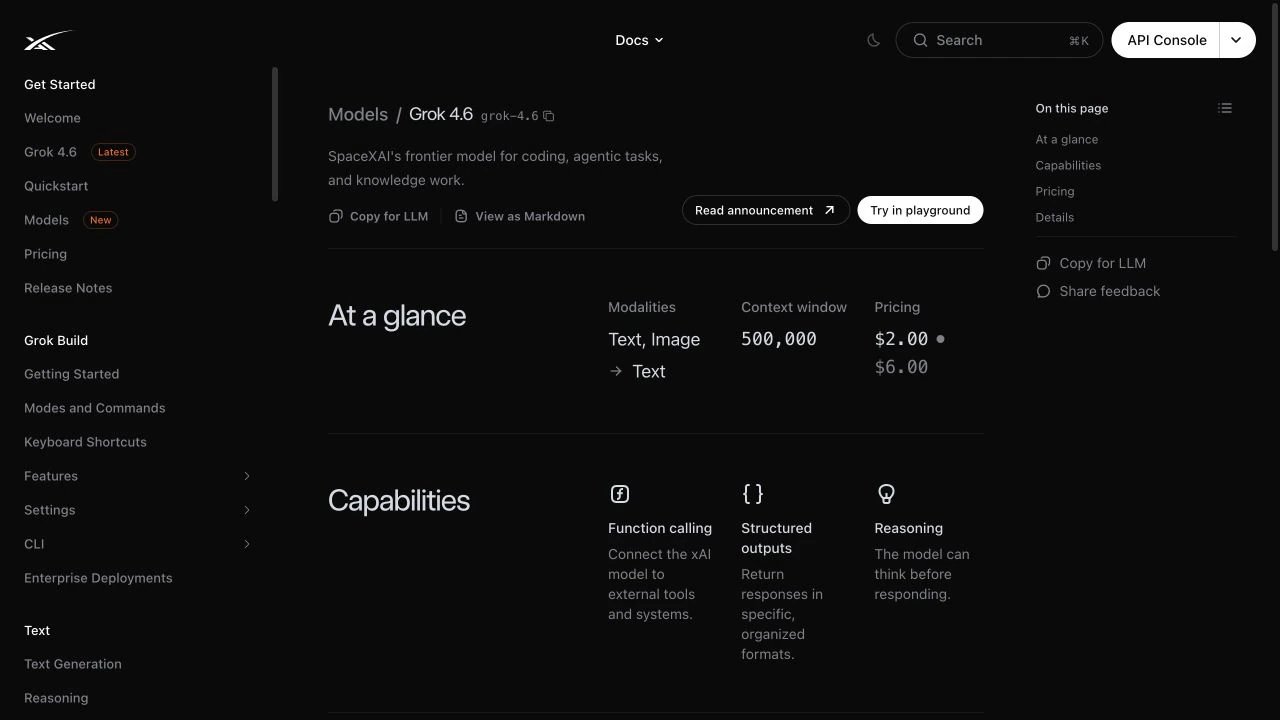
Grok 4.6 è il modello di punta di xAI per il 2026 nella linea Grok. La pagina ufficiale del modello descrive l'input di testo e immagini, l'output di testo, il ragionamento configurabile e una finestra di contesto da 500.000 token. L'identificatore dell'API è grok-4.6; questo è il valore che gli sviluppatori dovrebbero utilizzare nella richiesta.
Il linguaggio utilizzato da xAI per annunciare il rilascio è ben preciso: la versione Grok 4.6 si concentra su agenti attivi da molto tempo e progetti interattivi e visivi più ambiziosi. La documentazione ufficiale lo presenta come uno strumento adatto alla programmazione, alle attività di tipo "agentico" e al lavoro intellettuale, con la possibilità di richiamare funzioni e generare output strutturati per flussi di lavoro che richiedono strumenti o formati di risposta prevedibili.
La scheda del modello indica come data limite per il pre-addestramento gennaio 2026. Questa distinzione è importante. Una finestra di contesto da 500.000 caratteri consente di fornire un pacchetto di dati di origine molto ampio, ma non rende automaticamente il modello un motore di ricerca in tempo reale. Per i prezzi attuali, le notizie o le modifiche alle politiche sui prodotti, è necessario attingere a fonti attendibili e verificare la risposta.
Quali sono le specifiche ufficiali del modello Grok 4.6?
| Specifiche | Valore documentato ufficialmente | Perché è importante |
|---|---|---|
| Data di uscita | 12 agosto 2026 | Conferma che si tratta di una versione ufficiale di xAI. |
| ID modello API | grok-4.6 | Utilizza proprio questo slug nelle richieste API. |
| Finestra contestuale | 500.000 token | Utile per relazioni lunghe, codici sorgente e ricerche che richiedono un'analisi approfondita del codice. |
| Entrata / uscita | Inserimento di testo e immagini; output di testo | Supporta i prompt multimodali, ma non la generazione di immagini. |
| Ragionamento | Configurabile | Consente a un flusso di lavoro di bilanciare la velocità con un’analisi più approfondita. |
| Chiamata di funzioni | Supportato | Collega il modello a strumenti e sistemi esterni. |
| Risultati strutturati | Supportato | Utile per JSON, l'estrazione dei dati e le pipeline prevedibili. |
| Soglia di pre-allenamento | Gennaio 2026 | Non dare per scontato che il modello base sia automaticamente aggiornato. |
Fonte: comunicato stampa di xAI, documentazione del modello e scheda tecnica Grok 4.6. Le specifiche ufficiali non corrispondono ai risultati prestazionali ottenuti da fonti indipendenti.
Cosa può fare il modello Grok 4.6?
Ragionamento e analisi strutturata
Il ragionamento configurabile rende Grok 4.6 adatto a compiti che traggono vantaggio da una risposta ponderata: confrontare prove, generare tabelle decisionali, pianificare un'implementazione o verificare un calcolo soggetto a vincoli. Un maggiore livello di ragionamento non è automaticamente migliore per ogni richiesta, pertanto l'estrazione e la riscrittura di routine dovrebbero avvalersi di un'impostazione adeguata.
Ricerca e lavoro che richiede un ampio ricorso alle fonti
La finestra di contesto da 500K offre al modello lo spazio necessario per gestire report di grandi dimensioni, trascrizioni, documenti normativi e raccolte di fonti. Il flusso di lavoro più efficace consiste nel recupero tramite indicatori di posizione espliciti e regole di citazione, seguito dall’apertura della fonte originale a scopo di verifica.
Codifica e debug
Le valutazioni pubblicate in materia di ingegneria del software e il nostro piccolo test di debug ne avvalorano l'utilizzo per la revisione del codice, la correzione dei bug e le attività strutturate degli agenti. Gli sviluppatori dovrebbero comunque eseguire i test localmente e verificare le patch prima della distribuzione.
Comprensione dell'immagine
xAI elabora input testuali e immagini producendo output testuali. Ciò consente l'interpretazione degli screenshot, l'analisi di documenti e immagini e la risposta visiva alle domande, ma non va confuso con la generazione di immagini.
Agenti a lungo termine e utilizzo degli strumenti
Questa è la funzionalità più strettamente legata al posizionamento di xAI al momento del lancio. La chiamata di funzioni consente a Grok 4.6 di connettersi a strumenti esterni, mentre gli output strutturati rendono più facile il passaggio del risultato a una fase successiva. Questa combinazione è adatta agli agenti che raccolgono il contesto, elaborano un codice sorgente, richiamano uno strumento, verificano un risultato e restituiscono un artefatto finito. Il modello necessita comunque di un runtime esterno, autorizzazioni e verifiche degli obiettivi; “agentic” non significa che il modello di base agisca in modo indipendente.
Lavoro interattivo e visivo
xAI mette in evidenza anche lavori interattivi e visivi più ambiziosi. Un test significativo consiste in una scheda di prodotto ricca di screenshot o in un rapporto corredato di grafici, in cui il modello deve collegare le prove visive a una raccomandazione scritta. Verificate le etichette, gli assi, le unità di misura e i dettagli omessi prima di considerare il risultato definitivo.
Cosa è cambiato nella versione Grok 4.6 rispetto ai modelli precedenti della serie Grok?
Il posizionamento di xAI pone l’accento su un ragionamento più solido, sul lavoro con agenti di codifica e sulle prestazioni in contesti estesi. L’aggiornamento pratico non consiste in una singola funzionalità di grande impatto, ma nella combinazione di un ambito operativo più ampio, un ragionamento personalizzabile e un modello ottimizzato per compiti complessi articolati in più fasi.
È comunque necessario testarlo nel flusso di lavoro. Un modello può ottenere un buon punteggio in un benchmark e risultare poco adatto al proprio stile di scrittura, ai requisiti di citazione o al codice. Il modello Grok 4.6 va valutato soprattutto in base alle attività che si ripetono ogni settimana, non in base a un singolo dato della classifica.
Come si posiziona il modello Grok 4.6 nei benchmark di riferimento?
La tabella che segue distingue i risultati delle schede dei modelli forniti da xAI da quelli delle misurazioni indipendenti. Ciò è fondamentale poiché i due dati relativi al Terminal-Bench si riferiscono a versioni diverse e non devono essere presentati come un confronto diretto.
| Valutatore | Attività / indicatore | Risultato riportato | Categoria delle prove e limitazioni |
|---|---|---|---|
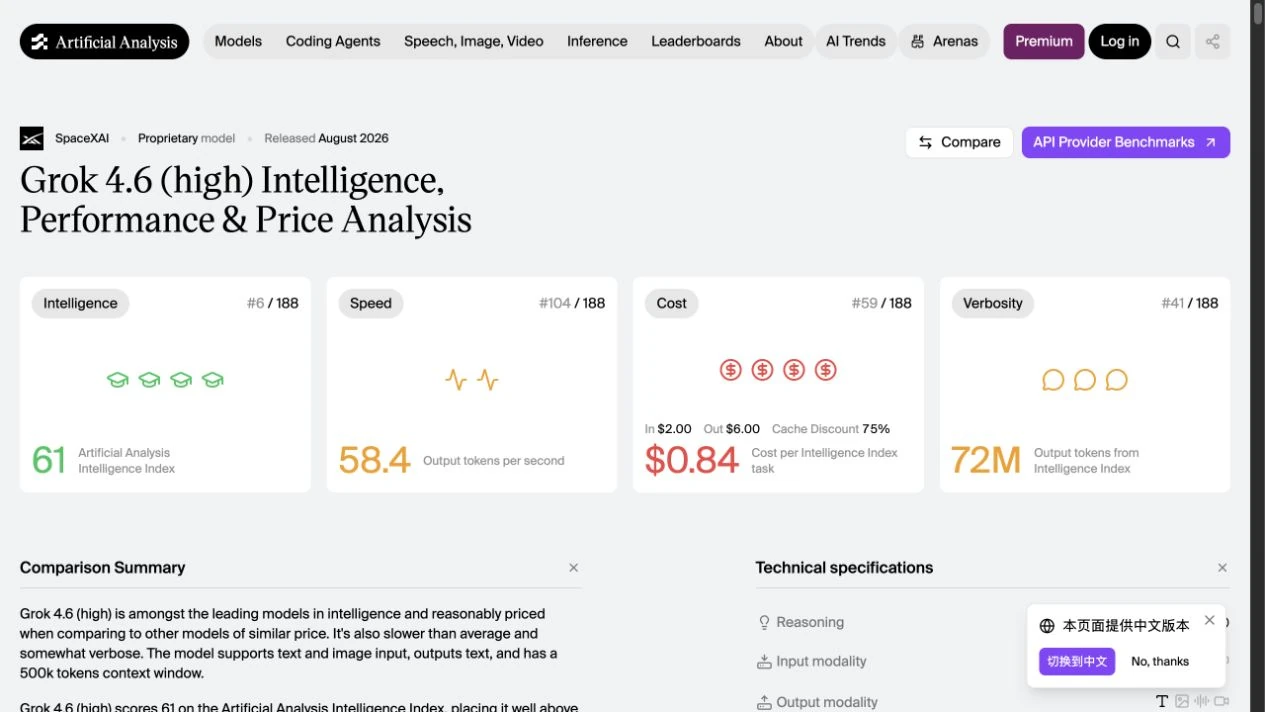
| Analisi artificiale | Indice di intelligenza | 61 (#6 / 188 al momento della cattura) | Composito indipendente; utilizzare la metodologia e la data di AA. |
| Analisi artificiale | Velocità di uscita | 58,4 token al secondo | Misurazione indipendente della velocità; il percorso e l'hardware influiscono sulla latenza. |
| Analisi artificiale | Costo per attività di intelligence | $0.84 | Stima di AA basata sul proprio mix di attività; non si tratta di una fattura xAI. |
| Analisi artificiale | GDPval-AA v2 | 1753 | Valutazione indipendente dei risultati del lavoro. |
| Analisi artificiale | AA-Cartella | 1577 | Valutazione indipendente dello stile di lavoro intellettuale. |
| Analisi artificiale | Terminal-Bench v2.1 | 88.4% | Risultato di Independent v2.1; non comparabile con Terminal-Bench 3.0. |
| Scheda del modello xAI | Terminal-Bench 3.0 | 26% | Risultato ufficiale della scheda del modello su una versione diversa. |
| Mercor APEX-SWE | Ingegneria del software | 56,41 TP40T ± 6,21 TP40T | 200 attività; occorre mantenere l'intervallo di incertezza. |
| Agenti Mercor APEX | Compiti degli agenti | 57,51 TP40T ± 3,51 TP40T | 33 mondi / 480 compiti; una valutazione specifica dell'agente. |
| Scheda del modello xAI | DeepSearchQA | 81.6% | Condizioni di controllo qualità della ricerca segnalate dal fornitore. |
| Scheda del modello xAI | Tasso di allucinazioni relative alla realtà oggettiva | 1.7% | Condizione di prova della scheda modello, non un tasso di errore universale. |
Fonti: Artificial Analysis, classifiche Mercor APEX e scheda del modello xAI. Non sommare i punteggi relativi a set di dati, versioni, impostazioni di sforzo o valutatori diversi.
Il modello Grok 4.6 è migliore del modello Grok 4.5?
La scheda tecnica ufficiale fornisce una risposta ambigua piuttosto che un semplice “sì”. Il modello Grok 4.6 registra un punteggio DeepSearchQA molto più elevato, mentre la stessa scheda riporta un tasso di allucinazioni fattuali più alto rispetto al modello Grok 4.5. Una revisione seria non dovrebbe trasformare un unico benchmark significativo in un'affermazione di affidabilità universale.
| Valutazione ufficiale | Grok 4,6 | Grok 4,5 | Come interpretarlo |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | In questa valutazione incentrata sulla ricerca si è registrato un notevole miglioramento. |
| Tasso di allucinazioni relative alla realtà oggettiva | 1.7% | 0.98% | Più basso è meglio; Grok 4,5 è più indicato in questa situazione. |
Fonte: Scheda tecnica del modello xAI Grok 4.6. Queste valutazioni rispondono a domande diverse e non individuano un vincitore assoluto.
Quanto è veloce, affidabile e performante il modello Grok 4.6 nell'uso pratico?
I dati pubblicati suggeriscono un modello ad alte prestazioni, ma la “prestazione” comprende diversi aspetti: qualità delle risposte, latenza, conservazione del contesto, rispetto delle istruzioni e recupero in caso di errore. Nel nostro percorso diretto, la richiesta di verifica della disponibilità ha restituito un codice HTTP 200 e PRONTO. I primi risultati validi relativi alle altre attività sono stati restituiti con successo, mentre una richiesta di modifica soggetta a vincoli ha causato un errore nell'infrastruttura lato client.
Artificial Analysis offre un’utile verifica della realtà che va oltre le semplici prestazioni dichiarate: la pagina acquisita mostra un Indice di Intelligenza pari a 61, una velocità di output di 58,4 token al secondo e un costo stimato di $0,84 per ogni attività di intelligenza. Questa combinazione indica un modello capace ma non ultraveloce, più adatto a svolgere un lavoro significativo che a fornire risposte di una sola riga senza valore.
Questo risultato misto è utile. Grok 4.6 può essere efficace nei processi strutturati, ma gli utenti in produzione dovrebbero mantenere regole di riprova, timeout e un modello di fallback, invece di dare per scontato che ogni percorso si comporti in modo identico.
In quali contesti il modello Grok 4.6 risulta più utile?
Attività di programmazione e sviluppo prodotti a lungo termine
L'esempio di lancio di xAI spazia dalla ricerca su un argomento, all'analisi delle informazioni, al lavoro su un codice sorgente, fino alla trasformazione di un'idea in un'applicazione o un prodotto finito. Ciò rende un lavoro delle dimensioni di una funzionalità uno strumento di valutazione migliore rispetto a un semplice prompt "giocattolo" con una sola funzione. Fornite al modello un obiettivo ben definito, file pertinenti, test e una definizione di "completamento".
Sintesi della ricerca e attività di elaborazione delle conoscenze
La finestra da 500K, gli output strutturati e l'ottimo risultato di DeepSearchQA rendono Grok 4.6 un candidato ideale per trasformare un pacchetto di fonti in una sintesi, individuare le discrepanze o estrarre una tabella decisionale. Il test di verifica delle fonti conferma tale utilizzo quando le regole di citazione sono esplicite.
Report di grandi dimensioni e analisi di più documenti
Utilizza la finestra di contesto per i rapporti annuali, le trascrizioni, i fascicoli normativi e le cronologie dei progetti che altrimenti richiederebbero una suddivisione in parti molto dettagliata. Richiedi i riferimenti alle pagine o alle sezioni, quindi verifica i dati più rilevanti nei documenti originali.
Analisi basata sulle immagini
L'inserimento di testo e immagini è utile per screenshot, grafici e diagrammi. Ciò risulta particolarmente utile quando l'elemento visivo fa parte di un'attività di ragionamento più ampia, come l'analisi di un dashboard insieme al contesto aziendale descritto per iscritto.
Flussi di lavoro orientati all’azione con obiettivi ben definiti
La chiamata di funzioni e gli output strutturati supportano flussi di lavoro quali l'analisi di un problema, l'avvio di uno strumento, l'aggiornamento di un piano e la restituzione di un risultato leggibile da un sistema informatico. Il punto di partenza più sicuro è un'attività con autorizzazioni limitate, una chiara condizione di interruzione e un sistema di verifica degli obiettivi.
| Flusso di lavoro | Perché il modello Grok 4.6 è l'ideale | Il miglior compito iniziale |
|---|---|---|
| Codifica | Posizionamento xAI, oltre alle prove fornite da APEX-SWE e CursorBench | Una modifica sostanziale, che possa essere considerata un bug o una funzionalità, corredata di test |
| Ricerca | Contesto da 500K, output strutturato e DeepSearchQA | Un briefing supportato da fonti con riferimenti alle pagine |
| Documenti lunghi | Finestra di contesto ufficiale di grandi dimensioni | Una relazione annuale o una raccolta di documenti relativi alle politiche |
| Analisi visiva | Input immagine più posizionamento visivo del lavoro con xAI | Un rapporto ricco di grafici e corredato di spiegazioni scritte |
| Agenti | Chiamata di funzioni e output strutturati | Un'indagine circoscritta con un verificatore chiaro |
Il modello Grok 4.6 è in grado di svolgere attività di ricerca e verifica dei fatti?
Il test sui pacchetti sorgente ha chiesto a Grok 4.6 di classificare sei affermazioni, citare solo URL approvati e respingere due deduzioni allettanti.
(1) confermato — L’annuncio di xAI è datato 12 agosto 2026 e indica che quel giorno verrà rilasciata la versione Grok 4.6.
(2) confermato — La documentazione ufficiale di xAI indica che l’ID del modello è grok-4.6.
(3) confermato — La documentazione ufficiale indica una finestra di contesto di 500k.
(5) contraddetto — Si tratta di versioni diverse di Terminal-Bench e non della stessa metrica.
(6) contraddetto — La pagina mostra solo una voce relativa all’area di lavoro, non l’inclusione in tutti i piani.
Mostra i risultati completi per Grok 4.6
| Affermazione | Verdetto | Risposta in una frase | URL delle fonti | Limitazione esatta |
|---|---|---|---|---|
| (1) xAI ha annunciato Grok 4.6 il 12 agosto 2026 | confermato | L'annuncio di xAI è datato 12 agosto 2026 e afferma che quel giorno verrà rilasciata la versione Grok 4.6. | https://x.ai/news/grok-4-6 | Il pacchetto riporta solo la data e la frase relativa al rilascio, non il post completo. |
| (2) l’ID ufficiale del modello API è grok-4.6 | confermato | La documentazione ufficiale dei modelli di xAI indica come ID del modello grok-4.6. | https://docs.x.ai/developers/models/grok-4.6 | Il riepilogo di Packet non elenca alias o altri ID. |
| (3) la finestra di contesto ufficiale è di 500k token | supportato | La documentazione ufficiale indica una finestra di contesto di 500k. | https://docs.x.ai/developers/models/grok-4.6 | Il pacchetto riporta “500k context”, senza menzionare esplicitamente il termine “tokens”. |
| (4) Artificial Analysis ha misurato in modo indipendente un indice di intelligenza pari a 61 | supportato | AA pubblica un indice di intelligenza pari a 61 per Grok 4.6. | https://artificialanalysis.ai/models/grok-4-6 | Packet riporta il punteggio di AA, non una verifica separata del metodo di AA. |
| (5) Terminal-Bench 3.0 26% e v2.1 88,4% sono direttamente comparabili | contraddetto | Si tratta di versioni diverse di Terminal-Bench e non utilizzano la stessa metrica. | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | Packet fornisce entrambi i punteggi, ma non indica alcuna equivalenza o corrispondenza. |
| (6) Una pagina GlobalGPT Grok 4.6 dimostra che ogni piano include il modello | contraddetto | La pagina mostra solo una voce nell’area di lavoro, non l’inclusione in ogni piano. | https://www.glbgpt.com/home/grok-4-6 | Lo stesso Packet afferma che si tratta di una voce di interfaccia, non di ogni piano. |
Conclusione della recensione: rispettava bene i confini delle prove quando il formato del pacchetto sorgente e quello della risposta erano espliciti. Ciò è utile per i flussi di lavoro di ricerca, ma la risposta del modello rimane uno strumento di supporto alla ricerca, non la prova esterna in sé.
Mostra il testo esatto della domanda d'esame
Utilizzare esclusivamente il pacchetto di fonti allegato. Per ciascuna delle sei affermazioni, fornire una risposta di una sola frase indicando se l’affermazione è supportata, contraddetta o non dimostrata, indicando gli URL delle fonti e la limitazione esatta.
Il modello Grok 4.6 è adatto alla programmazione e al debug?
Il compito in JavaScript richiedeva un confronto minimale (diff), l'ordinamento numerico, la corretta gestione della mediana per i numeri pari e dispari, l'immutabilità e due condizioni di errore precise.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}Mostra la spiegazione fornita da Grok 4.6
L'originale modificava il proprio argomento e utilizzava l'ordinamento lessicografico predefinito (sort()), quindi viene creata una copia con slice() e ordinata numericamente tramite (a, b) => a - b. Dopo aver scartato gli elementi non appartenenti ad array con TypeError e gli array vuoti con Error("input vuoto"), nel caso di una lunghezza dispari il risultato è l’unico elemento centrale, mentre nel caso di una lunghezza pari il risultato è la media dei due valori centrali, che corrisponde alla mediana convenzionale.Uso consigliato: debug su progetti di piccole e medie dimensioni, scrittura di test, revisione del codice e spiegazione di una funzione sconosciuta. Per un repository di grandi dimensioni, abbina il modello al tuo test runner e controlla il diff prima di eseguire il merge.
Mostra l'ambito del test
Calcola la mediana di (valori) senza modificarne la firma. Non modificare i valori in ingresso; genera un TypeError se i valori non sono array e un Error("input vuoto") se gli array sono vuoti; restituisce un diff unificato minimo.La finestra di contesto da 500K è utile con i documenti lunghi?
Un sistema di recupero di oltre 220.000 token richiedeva sette campi, indicatori di sezione/pagina e una spiegazione delle due versioni di Terminal-Bench.
{
  "release_date": {"value": "12 agosto 2026", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "context_window": {"value": "500k token", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 per milione di token (prompt superiori a 200.000 token)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88,4%"]
}Mostra l'output JSON completo di Grok 4.6
{
  "release_date": {"value": "12 agosto 2026", "section": "versione xAI", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "Modello API", "locator": "p.2"},
  "context_window": {"value": "500k token", "section": "Modello API", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 per milione di token (prompt superiori a 200.000 token)", "section": "pricing", "locator": "p.3"},
  "versione_terminal_bench": [{"valore": "3.0", "section": "scheda di benchmark", "locator": "p.4"},{"value": "v2.1", "section": "benchmark indipendente", "locator": "p.5"}],
  "punteggio_benchmark_terminale": [{"valore": "26%", "sezione": "scheda di benchmark", "riferimento": "p.4"},{"value": "88,4%", "section": "benchmark indipendente", "locator": "p.5"}],
  "evidence_limits": {"value": "I due risultati del Terminal-Bench non possono essere messi a confronto poiché si tratta di versioni diverse del benchmark. La disponibilità in tempo reale non è specificata.", "section": "benchmark indipendente", "locator": "p.5"}
}
Ciò dimostra che: Il modello è in grado di estrarre e strutturare le informazioni contenute in un pacchetto di grandi dimensioni e rumoroso secondo uno schema rigoroso. Cosa non dimostra: che ogni richiesta di 500.000 token risulti altrettanto veloce, economica o accurata su un documento cliente qualsiasi.
Il modello Grok 4.6 è in grado di seguire istruzioni precise e di ragionare in modo trasparente?
Per un problema di allocazione con vincoli, ha restituito l’unica soluzione possibile: 7 ore di ricerca, 9 ore di programmazione e 8 ore di controllo qualità.
{"R":7,"C":9,"Q":8,"total":24,"check":"I valori soddisfano la condizione R+C+Q=24, con C=R+2 e Q=R+1."}Mostra il prompt esatto
Ripartire 24 ore tra Ricerca (R), Programmazione (C) e Controllo qualità (Q). Restituisci solo JSON con chiavi intere R, C, Q, total e una frase di verifica. Vincoli: R + C + Q = 24; C = R + 2; Q = R + 1. Non fornire il ragionamento nascosto.
L'operazione di riscrittura vincolata separata non ha restituito una risposta API in occasione di due tentativi da parte del cliente. Ciò è stato registrato come anomalia dell'infrastruttura, non come punteggio di qualità. La lezione pratica da trarne è quella di prevedere un percorso alternativo per la produzione editoriale.
Quanto costa il modello Grok 4.6?
| Opzione | Prezzo attuale pubblicato | Il migliore per | Confine importante |
|---|---|---|---|
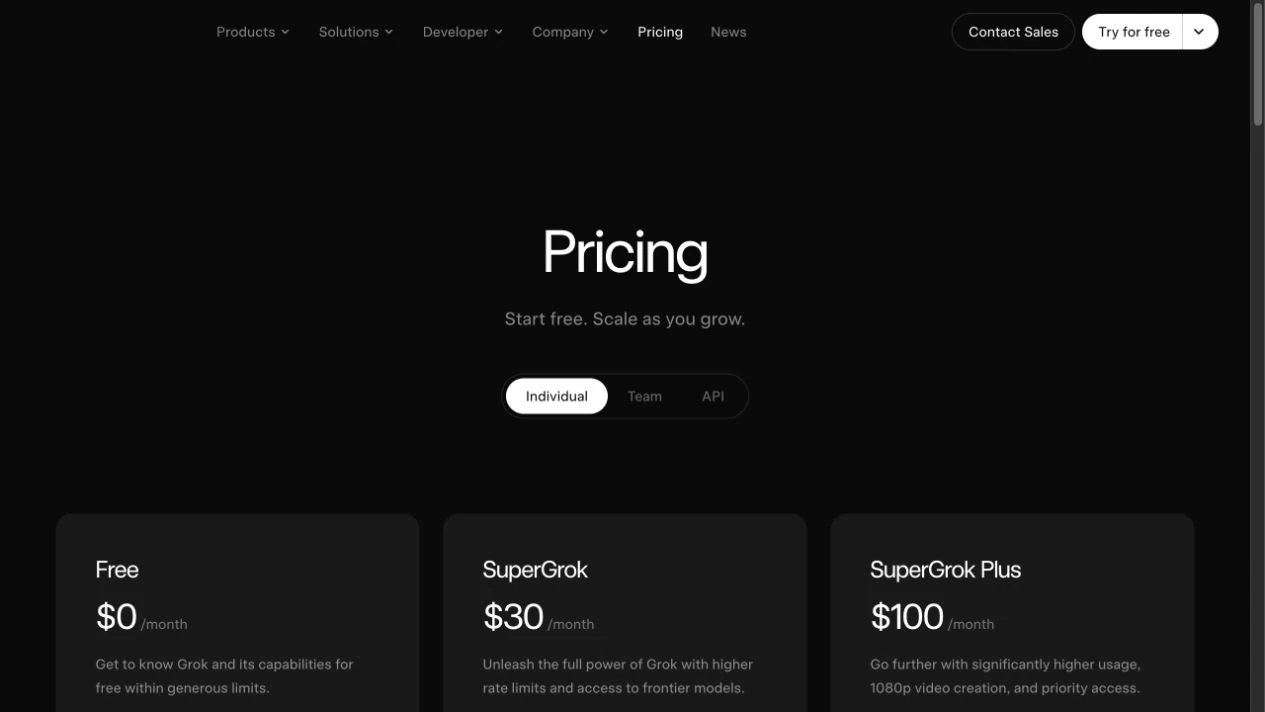
| xAI per i consumatori - Gratuito | $0/mese | Provare l'esperienza utente nativa. | L'accesso al modello Free-tier e i relativi limiti possono subire variazioni. |
| SuperGrok | $30/mese | Uso normale da parte dei consumatori; la pagina corrente riporta il codice Grok 4.6. | Verificare i diritti attuali prima della pubblicazione. |
| SuperGrok Plus | $100/mese | Utilizzo intensivo da parte degli utenti; la pagina corrente riporta Grok 4.6. | Non dedurre l'accesso per altri piani. |
| Piano base dell'API xAI | $2/M in ingresso; $6/M in uscita; $0.50/M in ingresso con cache | Sviluppatori che realizzano integrazioni basate sull'utilizzo. | Gli strumenti vengono fatturati separatamente, ove applicabile. |
| Livello "long-context" dell'API xAI | Oltre 200K: ingresso $4/M; $1/M in cache; uscita $12/M | Prompt e documenti di dimensioni molto grandi. | Non utilizzare il prezzo base per una richiesta superiore a 200K. |
| GlobalGPT | Consulta i piani GlobalGPT attuali | Confronto tra il modello Grok e diversi modelli di punta in un unico spazio di lavoro. | Non dare per scontato che ogni piano includa Grok 4.6; controlla la pagina del piano. |
Quanto costerebbe una richiesta API Grok 4.6?
| Esempio di richiesta | Calcolo | Costo stimato per token del modello |
|---|---|---|
| 50K in ingresso + 5K in uscita | 50.000 × $2/M + 5.000 × $6/M | $0.13 |
| 100K in ingresso + 10K in uscita | 100.000 × $2/M + 10.000 × $6/M | $0.26 |
| 250K in ingresso + 10K in uscita | 250.000 × $4/M + 10.000 × $12/M | $1.12 |
| 400K in ingresso + 20K in uscita | 400.000 × $4/M + 20.000 × $12/M | $1.84 |
Esempi di calcolo basati sui prezzi di listino di xAI. Sono esclusi gli sconti sugli input memorizzati nella cache, le imposte, i costi per l’utilizzo degli strumenti e i ricarichi dei fornitori terzi.
GlobalGPT è la soluzione ideale quando la domanda è “quale modello funziona meglio per questa attività?”, piuttosto che “come posso affidare ogni attività a un’unica API?”. È possibile confrontare prompt relativi alla scrittura, alla ricerca, alla programmazione e all’analisi in un unico spazio di lavoro, per poi utilizzare il Pagina dei prezzi di GlobalGPT per selezionare l'abbonamento più adatto alle tue esigenze di utilizzo. Si tratta di un suggerimento relativo a diversi modelli di abbonamento, non di una conversione dei crediti GlobalGPT in prezzi espressi in token xAI.
Come si può accedere a Grok 4.6?
I consumatori possono iniziare con le attuali opzioni di abbonamento Grok di xAI. Gli sviluppatori dovrebbero fare riferimento alla documentazione ufficiale dell'API di xAI e all'ID esatto del modello grok-4.6. I lettori che desiderano confrontare i modelli senza dover creare più account API possono utilizzare la voce verificata relativa all’area di lavoro Grok 4.6 in GlobalGPT; l'accesso all'interfaccia utente della piattaforma non va confuso con tutte le funzionalità native di xAI.
Quali sono i principali limiti del modello Grok 4.6?
- Le informazioni attuali devono ancora essere comprovate: La scadenza per la formazione preliminare fissata a gennaio 2026 non garantisce l'acquisizione di conoscenze pratiche.
- I titoli dei benchmark possono essere fuorvianti: La versione, il valutatore, lo sforzo di ragionamento e il set di dati devono essere associati a ogni punteggio.
- Un contesto più lungo costa di più: I prompt con più di 200.000 token utilizzano il livello API con contesto esteso.
- L'affidabilità delle tratte varia: La nostra richiesta di modifica con vincoli ha riscontrato un errore di infrastruttura, sebbene le altre operazioni siano andate a buon fine.
- L'accesso alla piattaforma non è identico: Una voce nell'area di lavoro GlobalGPT non implica la disponibilità di tutte le funzionalità native di xAI né di tutti i diritti di abbonamento.
È meglio scegliere il modello Grok 4.6 o un altro modello di IA?
Scegli Grok 4.6 quando il contesto esteso, la codifica e il ragionamento strutturato sono elementi centrali del lavoro. Scegliete un modello diverso quando la vostra priorità principale è un ecosistema di strumenti specifico, un costo prevedibile più contenuto, un output multimodale particolare o un flusso di lavoro che il vostro team è già in grado di gestire bene. Il confronto più equo si ottiene utilizzando lo stesso prompt, lo stesso pacchetto sorgente e lo stesso strumento di verifica per tutti i modelli: un'operazione che GlobalGPT rende facile da organizzare.
A chi è destinato il modello Grok 4.6?
- Ricercatori e analisti: pacchetti sorgente, tabelle probatorie e memorie di grande lunghezza.
- Sviluppatori: debugging, revisione del codice e piani di implementazione strutturati.
- Autori e redattori: la redazione di testi lunghi, quando si forniscono indicazioni chiare e una guida stilistica.
- Squadre che mettono a confronto i modelli: valutazioni ripetibili con lo stesso prompt in un unico spazio di lavoro.
Quali sono le domande più frequenti dei lettori riguardo al modello Grok 4.6?
La versione Grok 4.6 è stata rilasciata ufficialmente?
Sì. L'annuncio del lancio di xAI è datato 12 agosto 2026.
Qual è l'ID ufficiale del modello API?
grok-4.6.
Che cos’è la finestra di contesto?
xAI supporta una finestra di contesto di 500.000 token.
Il modello Grok 4.6 supporta le immagini?
Sì. La documentazione ufficiale del modello indica l'input di immagini e l'output di testo.
Quanto costa un Grok 4.6?
La pagina attuale dedicata ai consumatori mostra il piano Free a $0 al mese, il piano SuperGrok a $30 al mese e il piano SuperGrok Plus a $100 al mese. I prezzi delle API sono basati sull’utilizzo e prevedono una fascia separata per i contesti lunghi oltre i 200.000 token.
Il modello Grok 4.6 è migliore del modello Grok 4.5?
È più recente e offre ottime prestazioni in diverse valutazioni citate, ma i compiti e le versioni dei benchmark differiscono. Verificate il vostro flusso di lavoro ricorrente.
Posso utilizzare il modello Grok 4.6 nel modello GlobalGPT?
GlobalGPT presenta una voce relativa all'area di lavoro Grok 4.6. Verificare i diritti attuali relativi al piano nella pagina dei prezzi.
Il modello Grok 4.6 è affidabile ai fini della ricerca?
Ha ottenuto buoni risultati nel test sui pacchetti di origine limitati, ma le affermazioni rilevanti dovrebbero sempre essere verificate confrontandole con la fonte citata.
Vale la pena usare l’Grok 4.6 nel 2026?
Grok 4.6 è un modello affidabile e rilasciato ufficialmente, dotato di un'utile finestra di contesto da 500K, un ragionamento configurabile, solide prove provenienti dai benchmark pubblicati e buoni risultati iniziali nelle attività di ricerca strutturata e nell'analisi di documenti lunghi. I suoi punti deboli sono altrettanto concreti: i dati dei benchmark richiedono un'attenta indicazione delle versioni, i fatti in tempo reale necessitano ancora di fonti e l'affidabilità dei percorsi può variare.
Per l'accesso nativo da parte degli utenti o lo sviluppo di API, si consiglia di consultare la documentazione attuale di xAI. Per un flusso di lavoro basato sul confronto, prova Grok 4,6 in GlobalGPT insieme ad altri modelli di punta, scegli quindi il piano più adatto alle tue esigenze in termini di scrittura, ricerca, analisi o programmazione.
Fonti primarie: Comunicato stampa xAI, Documentazione sui modelli xAI, Prezzi dell'API xAI, Prezzi al consumo di xAI, Analisi artificiale, Mercor APEX-SWE e il Scheda del modello xAI.