Claude Sonnet 5.5 è un modello affidabile per il lavoro quotidiano: sufficientemente potente per risolvere un bug complesso o elaborare un documento corposo, con un prezzo per token inferiore rispetto a Opus 5.5. Il suo fascino risulta particolarmente evidente quando si riesce a definire quali siano le caratteristiche di una buona risposta. Nel caso di strategie aperte o di problemi poco familiari con molte variabili, Opus merita comunque un posto nel vostro flusso di lavoro.
Nei nostri test su GlobalGPT, Sonnet 5.5 ha redatto e-mail per i clienti, ha corretto una funzione di allocazione dei fondi che ha superato 43 controlli e ha riconciliato correttamente una serie di registrazioni di fatture composta da 13.078 parole. L’e-mail ha inoltre evidenziato una piccola ipotesi di processo che necessitava di verifica. La domanda più interessante è quando la sua velocità e il suo prezzo si traducono in una giornata lavorativa più produttiva — e quando il ragionamento aggiuntivo inizia a costare più di quanto fa risparmiare.
È possibile utilizzare Claude Sonnet 5,5 su GlobalGPT insieme ad altri modelli di punta per la scrittura, la programmazione, la ricerca, le immagini e i video. Un unico abbonamento multimodello ti offre un modo conveniente per portare avanti un progetto dalla prima bozza fino al prodotto finito, senza dover gestire un abbonamento separato per ogni fase.
Claude Sonnet 5.5: il giudizio a prima vista
Un'impostazione predefinita pratica per attività chiaramente definite
Inizia con Sonnet per una bozza, un bug, un documento o una prima implementazione. Forniscigli il materiale di partenza, i vincoli e i criteri di accettazione. Passa a Opus quando la parte più difficile è capire qual è davvero il problema.
Ciò che ci ha colpito: formattazione controllata, codice solido e corretta riconciliazione dei documenti.
Da non perdere: anche nei testi ben curati possono insinuarsi piccole supposizioni; il ragionamento comporta un costo aggiuntivo; un contesto esteso non garantisce la memorizzazione.
Si tratta di una recensione di un modello appena lanciato, non di uno studio di produzione durato mesi. Abbiamo combinato le specifiche di Anthropic, le valutazioni pubblicate e tre attività pratiche eseguite il 1° ottobre 2026. L’attività di scrittura è stata ripetuta due volte; le attività relative al codice e ai documenti sono state eseguite una volta ciascuna. I risultati riportati di seguito tengono conto di questo campione ridotto.
Quali sono le novità di Claude Sonnet 5.5?
Il 28 settembre 2026, Anthropic ha lanciato Sonnet 5.5 come alternativa più veloce ed economica a Opus 5.5. I suoi punti di forza dichiarati sono la gestione efficiente delle attività quotidiane, la correzione dei bug e la creazione di documenti, presentazioni e fogli di calcolo curati nei dettagli. Questo posizionamento è importante: non è necessario il modello più costoso per ogni modifica, risposta di assistenza o attività di implementazione.
Quali sono le novità di Claude Sonnet 5.5?
| Caratteristica | Sonnet 5.5 | Cosa significa in pratica |
|---|---|---|
| Input e output | Testo e immagini inseriti; testo rimosso | Chiedi informazioni su un grafico o uno screenshot, poi trasforma la risposta in una bozza o in un piano. |
| Finestra di contesto API | 1 milione di gettoni | Spazio a disposizione per una grande quantità di materiale di riferimento; organizzarlo e etichettarlo con cura. |
| Valore massimo di output dell'API standard | 128K gettoni | Si tratta di un limite indicativo, non di una lunghezza consigliata per ogni risposta. |
| Ragionamento | Pensiero adattivo | L'impegno può influire sia sul tempo necessario per il completamento che sull'utilizzo totale dei token. |
| Cutoff di conoscenza | Giugno 2026 | Per verificare i fatti, utilizza fonti aggiornate o strumenti di ricerca. |
Questi limiti relativi al contesto e all'output descrivono l'API Claude. La quantità di dati che è possibile caricare o ricevere in una determinata app dipende anche dall'interfaccia di quel prodotto. Allo stesso modo, un modello in grado di interpretare un'immagine non è un generatore di immagini. Sonnet può fornire una valutazione critica di un'immagine o redigere un brief di produzione; un modello per immagini o video crea invece il contenuto multimediale finito.
Il vantaggio di questo miglioramento sta nella combinazione di un’esecuzione più efficace delle attività e di un ciclo di iterazione più rapido. È possibile richiedere una prima bozza, individuare i punti deboli e chiedere una revisione mirata. Un buon prompt indica chiaramente l’obiettivo: “Mantieni invariate tutte le cifre, riduci il testo a 200 parole ed elenca tutto ciò che la fonte non specifica”.”
Prezzi Claude Sonnet 5.5: tariffe dei token e costo effettivo
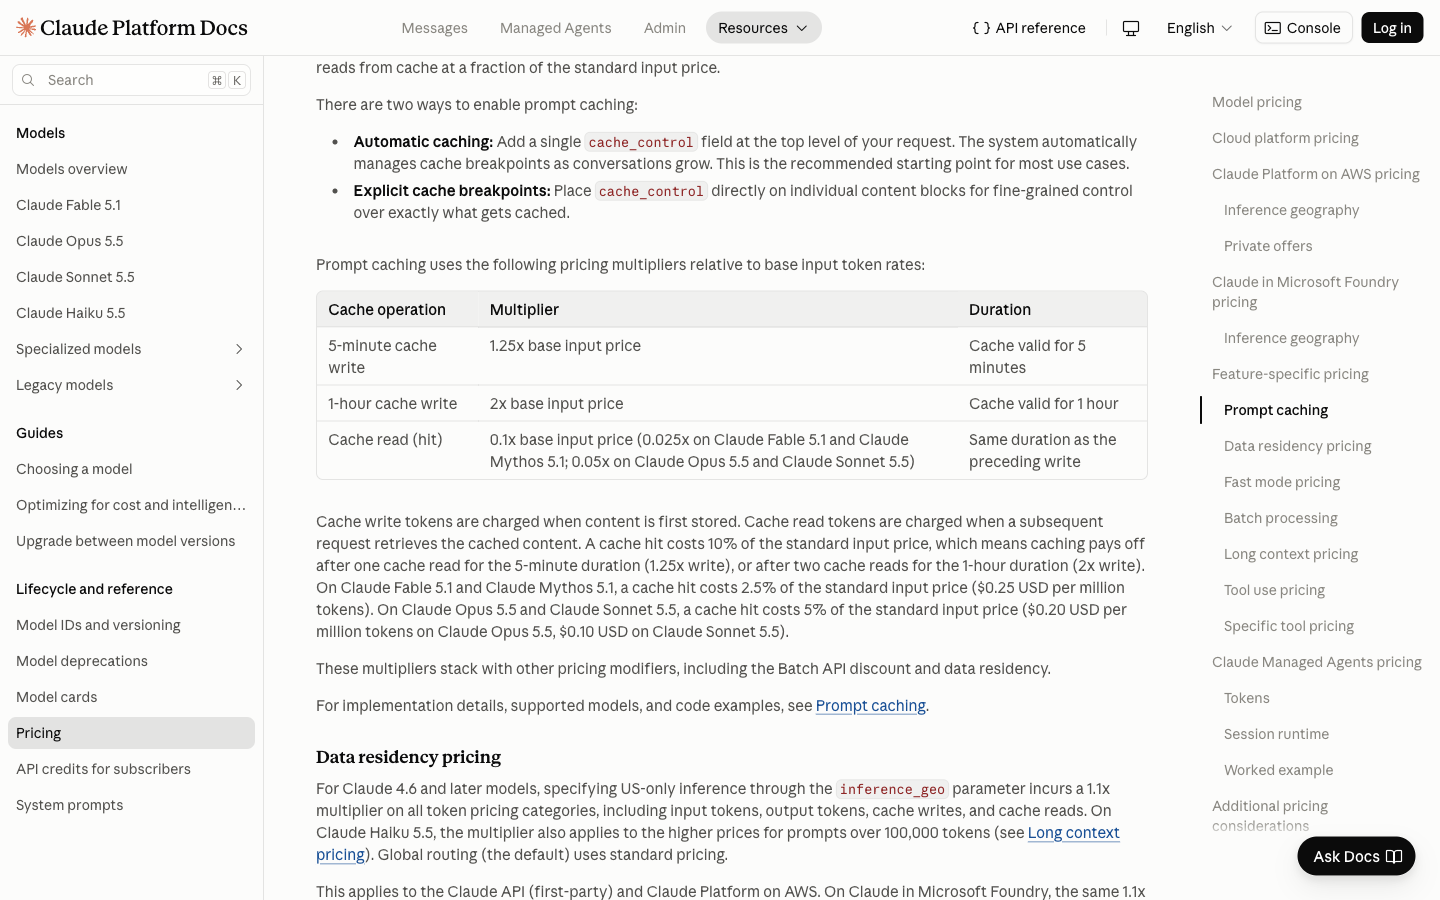
Costi Sonnet 5.5 $2 per ogni milione di token in ingresso e $10 per ogni milione di token in uscita alle tariffe API standard di Anthropic. Si tratta degli stessi prezzi unitari di Sonnet 5. Rispetto alle tariffe di $4 in ingresso e $20 in uscita di Opus 5.5, Sonnet costa la metà per ogni token di ingresso o di uscita, ma un’attività completata può consumare un numero diverso di token.
Prezzi Claude Sonnet 5.5: tariffe dei token e costo effettivo
| Categoria di fatturazione API | Prezzo per milione di token |
|---|---|
| Dati di input non memorizzati nella cache | $2.00 |
| Output, inclusi i token di pensiero fatturati | $10.00 |
| Lettura / aggiornamento della cache | $0.10 |
| Scrittura nella cache, 5 minuti | $2.50 |
| Scrittura nella cache, 1 ora | $4.00 |
Per una richiesta non memorizzata nella cache, moltiplicare i token in ingresso per $2 per milione e i token in uscita per $10 per milione. Un input di 10.000 token con 2.000 token in uscita costa $0,04. Un input di 100.000 token con 10.000 token in output costa $0,30. Si tratta di esempi pratici di API, non di una fattura GlobalGPT; strumenti, operazioni di cache, livelli di servizio e altri fattori che influenzano il prezzo possono modificare l’importo totale.
Quanto può costare una richiesta
Costi indicativi standard dell'API per richiesta. Solo input e output non memorizzati nella cache.
Formula: (token in ingresso × $2 + token in uscita × $10) ÷ 1.000.000. Il pensiero fatturato viene conteggiato come output. Si tratta di esempi, non di prezzi di abbonamento né di fatture effettive.
L'affermazione di Anthropic secondo cui “si risparmiano fino a 30% per attività” deriva dal fatto che alcune operazioni vengono completate utilizzando un numero inferiore di token. Non si tratta di una riduzione di prezzo pari a 30%. All'estremo opposto, Valutazione del lancio di Artificial Analysis ha registrato un valore di circa $7,60 per ogni compito dell’Intelligence Index con il massimo impegno, circa 50% in più rispetto a Sonnet 5 in quel test. Questi compiti di benchmark particolarmente impegnativi non sono semplici messaggi di chat, ma dimostrano perché portare il ragionamento al massimo livello possa vanificare un apparente vantaggio.
La fatturazione tramite API, gli abbonamenti Claude e GlobalGPT sono opzioni diverse
I piani per gli utenti finali di Claude prevedono un modello di abbonamento: il piano Free è $0, il piano Pro è $20 al mese o $200 con fatturazione annuale, mentre il piano Max parte da $100 al mese, al netto delle imposte applicabili. L’utilizzo dell’app è soggetto ai limiti previsti dal piano. Anthropic indica inoltre $100 o $200 come crediti API mensili per i corrispondenti livelli Max; i piani Free e Pro non includono crediti API mensili. Quando si sceglie un piano, è opportuno confrontare separatamente l’accesso all’app e le quote API. Una piattaforma multimodello è adatta a chi lavora regolarmente con diverse famiglie di modelli e tipi di media.
Se la tua giornata prevede la stesura di una pagina di lancio, la revisione del codice e la creazione di immagini per la campagna, GlobalGPT riunisce tutti questi strumenti. Il suo valore risiede nell'ampiezza del flusso di lavoro offerto da un unico abbonamento, anziché dover pagare per diversi prodotti separati solo per portare a termine un progetto. Scegli il piano in base al lavoro che svolgi effettivamente.
Prestazioni di riferimento: simili a quelle di Opus in alcune attività, ma non in tutte
I risultati del lancio evidenziano un notevole passo avanti rispetto a Sonnet 5. Dimostrano inoltre perché un unico punteggio di riferimento non sia sufficiente per determinare la scelta del modello. Sonnet 5.5 è in testa nel confronto Terminal-Bench riportato, mentre Opus 5.5 rimane in vantaggio su FrontierCode e CursorBench. Le valutazioni quasi equivalenti relative al lavoro intellettuale sono promettenti, ma non rendono i modelli intercambiabili.
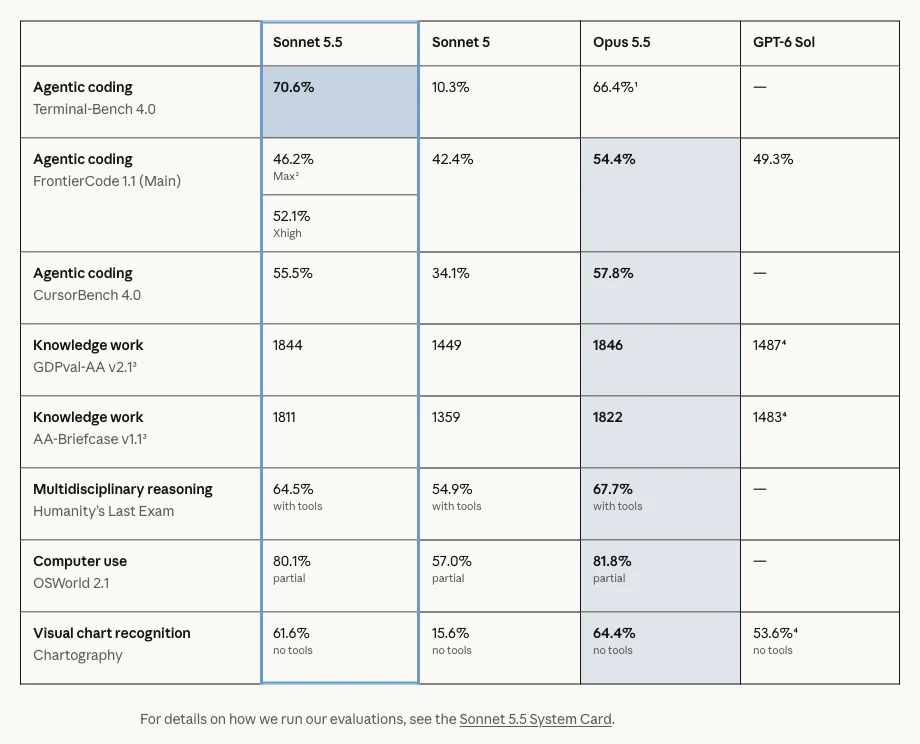
Prestazioni di riferimento: simili a quelle di Opus in alcune attività, ma non in tutte
| Valutazione nella tabella di lancio di Anthropic | Sonnet 5.5 | Sonetto 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66,41 TP40T (Xhigh) | - |
| FrontierCode 1.1 - Pagina principale | 52,11 TP40T (Xhigh); 46,21 TP40T (Max) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA v2.1 | 1844 Elo | 1449 Elo | 1846 Elo | 1487 |
| AA-Briefcase v1.1 | 1811 Elo | 1359 Elo | 1822 Elo | 1483 |
| L'ultimo esame dell'umanità | 64.5% con utensili | 54,91 TP40T con utensili | 67,71 TP40T con utensili | - |
| OSWorld 2.1 | 80.1% parziale | 57.0% parziale | 81,81 TP40T parziale | - |
| Cartografia | 61,61 TP40T senza utensili | 15,61 TP40T senza utensili | 64,41 TP40T senza utensili | 53,61 TP40T senza utensili |
Si tratta di risultati di benchmark pubblicati, distinti dai nostri test GlobalGPT. Le valutazioni utilizzano ambienti e impostazioni di difficoltà diversi; i punteggi Elo non corrispondono a percentuali di accuratezza. I valori GPT-6 Sol compaiono nella tabella comparativa pubblicata di Anthropic, mentre un trattino indica che la pagina non ha riportato alcun valore per quella valutazione. Anthropic sottolinea inoltre che le esecuzioni GDPval-AA e AA-Briefcase al momento del lancio utilizzavano una versione preliminare affetta da un bug relativo all’output strutturato, successivamente risolto. Considerate la tabella come una rappresentazione di quelle valutazioni, non come una garanzia relativa al vostro carico di lavoro.
Il risultato di FrontierCode è particolarmente utile: Sonnet ha ottenuto un punteggio migliore con Xhigh rispetto a Max. Anthropic attribuisce il calo di Max a ulteriori cicli di revisione, timeout e modifiche al di fuori dell’ambito richiesto. Riflettere di più può tradursi in un maggiore carico di lavoro senza necessariamente portare a una risposta migliore. È bene partire da un compito ben definito e aumentare l’impegno solo quando si ha un motivo specifico.
I risultati indipendenti forniscono un quadro più completo. Artificial Analysis ha riportato un punteggio dell’Indice di Intelligenza pari a 56 nella sua configurazione Max/default-fallback, insieme a un utilizzo insolitamente elevato di token di output. A Valutazione della pipeline di revisione di CodeRabbit sono stati individuati 6 casi su 13 di segnali difficili rilevati da Sonnet 5.5, contro i 4 su 13 rilevati da Sonnet 5, con un tempo di esecuzione medio inferiore. Si tratta di uno studio su scala ridotta, non di una prova che ogni revisione del codice migliorerà, ma è un esempio utile per valutare un'attività nella sua interezza piuttosto che limitarsi a un semplice punteggio.
Quanto è veloce il Claude Sonnet 5.5?
Secondo i rapporti, Anthropic genera i risultati con una velocità superiore di oltre 30% rispetto a Sonnet 5. La generazione dei risultati è solo una delle fasi dell'attesa di una risposta: anche l'elaborazione degli input, il ragionamento, i tempi di rete e il carico del servizio hanno la loro importanza. Un modello può scrivere rapidamente una volta avviato, ma può comunque impiegare del tempo a elaborare i dati prima che arrivi la risposta finale.
Le nostre tre ripetizioni dello stesso prompt relativo all'e-mail del cliente sono state completate in 11,60, 12,16 e 11,78 secondi, con una mediana di 11,78 secondi. L'attività relativa al codice ha richiesto 19,08 secondi, mentre quella relativa al documento 16,42 secondi. Abbiamo cronometrato la risposta completa, compresi i tempi di servizio e il sovraccarico di rete. Non abbiamo misurato la latenza del primo token né eseguito un test di controllo Sonnet 5, pertanto questi tempi non dimostrano un miglioramento di 30%.
Per l'uso quotidiano, questo rende il modello degno di essere provato su lavori che si revisionano con cicli brevi. Chiedete prima il risultato finale, mantenete l'ambito ristretto ed evitate di richiedere spiegazioni troppo estese quando tutto ciò di cui avete bisogno è una funzione corretta o una breve risposta. Laddove sono disponibili le opzioni di regolazione dello sforzo, valutate le impostazioni più leggere prima di impostare automaticamente il valore "Max".
Prestazioni nel mondo reale: tre test GlobalGPT
Abbiamo utilizzato compiti pratici con risposte verificabili. Tutte le richieste hanno utilizzato Claude Sonnet 5.5 con lo stesso limite massimo di output di 6.000 token e senza strumenti esterni. Abbiamo lasciato le impostazioni predefinite del servizio per il campionamento e il ragionamento. Abbiamo conservato il primo output completato per ogni attività; le due ulteriori sessioni di scrittura costituiscono un controllo di coerenza separato. Tutte e cinque le chiamate sono state completate senza alcun ritentativo.
Scrittura: una risposta al cliente in cui le promesse sono tenute sotto controllo
Le istruzioni richiedevano l'invio di un'e-mail di 90-120 parole a Maya riguardo a una lampada blu in ritardo, composta esattamente da tre punti elenco, con scadenza di invio fissata al 4 ottobre e la possibilità di rispondere “rimborso” per ottenere un rimborso completo sul metodo di pagamento originale. Era espressamente vietato indicare una motivazione inventata, garantire la consegna, offrire sconti o promettere un rimborso immediato.
La prima risposta era composta da 110 parole con esattamente tre punti elenco e manteneva inalterate la scadenza di spedizione e le condizioni di rimborso. Non inventava né una data di consegna, né una causa di ritardo, né un vantaggio aggiuntivo. Tuttavia, ha aggiunto “non è necessario rispondere” per i clienti che mantengono l’ordine — un dettaglio procedurale assente dal brief. Ciò la rende una bozza utile, ma non perfettamente conforme al rigoroso requisito di attenersi esclusivamente ai fatti.
Le risposte erano composte rispettivamente da 101 e 97 parole e rispettavano anch’esse le regole di formattazione, ma entrambe riproponevano lo stesso presupposto di non intervenire. La terza risposta utilizzava inoltre due punti elenco per indicare sostanzialmente la stessa opzione, ovvero “mantenere l’ordine e attendere”. Prima di inviare una risposta al cliente, è necessario verificare i dettagli operativi ed eliminare le ridondanze.
Test di scrittura: formato corretto, ipotesi di un unico processo
Prima risposta: 110 parole, 3 punti elenco, 11,60 secondi. I termini di spedizione e rimborso erano corretti. L’istruzione di mantenere l’ordine senza rispondere non era prevista nel brief e necessita di conferma. Ripetizioni: 101 e 97 parole; entrambe ribadivano tale ipotesi.
Claude Sonnet 5.5 · GlobalGPT · 1 ottobre 2026 · limite massimo di 6.000 token · nessun strumento · campionamento e sforzo lasciati alle impostazioni predefinite del servizio. Per "tempo" si intende la risposta completa, non il primo token.
Istruzioni per l'attività
Scrivi un’e-mail in inglese per il servizio clienti indirizzata a Maya riguardo all’ordine R-418, una lampada blu la cui spedizione ha subito un ritardo. L’e-mail completa deve contenere da 90 a 120 parole (comprese) e includere esattamente tre punti elenco. Includi delle scuse, spiega chiaramente il passo successivo e utilizza solo questi fatti: la lampada verrà spedita entro il 4 ottobre; in alternativa, Maya può rispondere “rimborso” per richiedere un rimborso completo sul metodo di pagamento originale. Non promettere una data di consegna o di arrivo, un rimborso immediato, uno sconto, un risarcimento o qualsiasi altro beneficio non previsto. Non inventare una causa per il ritardo. La scadenza si riferisce alla spedizione, non alla consegna. Includi un saluto iniziale e finale. Invia solo l’e-mail. Ai fini di questo compito, una parola è un token separato da spazi bianchi, esclusi i simboli di elenco autonomi.
Primo output completo
Oggetto: Aggiornamento sul tuo ordine R-418

Ciao Maya,

Mi dispiace che la spedizione della tua lampada blu, ordine R-418, abbia subito un ritardo. So che è frustrante e mi scuso per il disagio.

Ecco la situazione attuale e cosa puoi fare ora:

- La tua lampada verrà spedita entro il 4 ottobre.
- Se desideri mantenere l'ordine, non è necessario che tu risponda.
- Se invece preferisci non aspettare, rispondi "rimborso" a questa e-mail e provvederemo a rimborsarti l’intero importo tramite lo stesso metodo di pagamento utilizzato per l’acquisto.

Grazie per la pazienza e la comprensione. Rispondi pure se hai domande sul tuo ordine.

Cordiali saluti,
Il team del Servizio Clienti
Scrittura ripetuta 2 · output completo
Cara Maya,

Mi dispiace che la spedizione del tuo ordine R-418, la lampada blu, abbia subito un ritardo. Capisco che la situazione sia frustrante e mi scuso per il disagio.

Ecco cosa succederà ora:

- La tua lampada blu verrà spedita entro il 4 ottobre.
- Se desideri attendere, non devi fare nulla.
- Se invece preferisci non aspettare, rispondi "rimborso" a questa e-mail per richiedere un rimborso completo sul metodo di pagamento originale.

Ti ricordiamo che il 4 ottobre è la nostra data limite per la spedizione, non la data di consegna.

Grazie per la tua pazienza e comprensione.

Cordiali saluti,
Il team del Servizio Clienti
Scrittura ripetuta 3 · output completo
Oggetto: Aggiornamento sul tuo ordine R-418

Ciao Maya,

Mi dispiace che la spedizione della tua lampada blu, ordine R-418, abbia subito un ritardo. Mi scuso per il disagio e ti ringrazio per la pazienza.

Ecco le opzioni a tua disposizione:

- Attendere la spedizione: la tua lampada verrà spedita entro il 4 ottobre.
- Richiedere un rimborso: rispondi con la parola "rimborso" e provvederemo a rimborsarti l'intero importo sul metodo di pagamento originale.
- Mantenere l'ordine: se sei disposta ad aspettare, non è necessaria alcuna ulteriore azione.

Ti ricordiamo che il 4 ottobre è la nostra data limite di spedizione, non la data di consegna.

Cordiali saluti,
Il team del Servizio Clienti
La tua lampada verrà spedita entro il 4 ottobre. … Se preferisci non aspettare, rispondi a questa e-mail scrivendo “rimborso” e provvederemo a rimborsarti l’intero importo tramite lo stesso metodo di pagamento utilizzato per l’acquisto.
Estratto dalla prima prova scritta GlobalGPT; un punto elenco intermedio è stato omesso.
Questo è un modello utile per la comunicazione con i clienti e la corrispondenza aziendale: fornire i fatti approvati, definire il tono e specificare quali promesse non devono essere incluse. Sonnet può quindi aiutarti nella formulazione senza che ti venga chiesto di inventare la tua politica.
Codifica: correggere la logica di arrotondamento, quindi verificare i totali
La nostra funzione Python difettosa divideva l'importo utilizzando numeri in virgola mobile e arrotondava ciascuna quota in modo indipendente. Ciò può comportare un guadagno o una perdita di centesimi. Abbiamo chiesto a Sonnet di sostituirla con un'allocazione basata sul metodo del resto maggiore con Decimal, di mantenere invariato il totale, di risolvere eventuali parità in base all'indice originale e di rifiutare gli input non validi.
La prima funzione restituita passata 43 su 43 controlli, che copriva importi pari a zero, pesi frazionari, pareggi deterministici, input non validi, valori elevati e limiti di precisione. Analizzava le stringhe decimali, le convertiva in quantità intere esatte e assegnava i centesimi rimanenti secondo un ordine stabile. Il risultato utile non era solo un codice dall’aspetto plausibile: i totali corrispondevano effettivamente.
Ciò giustifica l'uso di Sonnet per un'implementazione mirata con criteri di accettazione espliciti. Si è trattato di un test funzionale autonomo, non di una riparazione autonoma del repository né di un audit di sicurezza. Per il codice di produzione, aggiungete i vostri test di integrazione e verificate la gestione degli errori nell'applicazione circostante.
Test di codifica: 43 controlli superati
Prima risposta: 19,08 secondi. Ha superato tutti i 43 controlli relativi all'allocazione corretta, ai collegamenti stabili, alla convalida degli input e alla precisione. Valutata come funzione autonoma, non come riparazione autonoma del repository.
Claude Sonnet 5.5 · GlobalGPT · 1 ottobre 2026 · limite massimo di 6.000 token · nessun strumento · campionamento e sforzo lasciati alle impostazioni predefinite del servizio. Per "tempo" si intende la risposta completa, non il primo token.
Istruzioni per l'attività
Sostituisci la funzione Python errata riportata di seguito con un'implementazione corretta di `allocate_cents(total: str, weights: list[str]) -> list[int]`. Restituisci solo il codice sorgente Python eseguibile, senza blocchi Markdown né spiegazioni.

Requisiti:
1. total è un importo in USD finito e non negativo, scritto come stringa, con zero, una o due cifre decimali, ad esempio "0", "12.3" o "12.34". Sono ammesse solo cifre decimali ASCII con un unico punto decimale facoltativo. Rifiuta segni, notazione esponenziale, spazi bianchi, NaN/Infinito, stringhe vuote, punti decimali finali, punti decimali iniziali e più di due cifre decimali, incluso "1.000". Gli zeri iniziali sono consentiti. Rifiuta gli input non stringa con ValueError.
2. weights è una lista non vuota di stringhe. Ogni stringa utilizza cifre decimali ASCII, facoltativamente con un punto decimale seguito da una o più cifre. Richiedere valori finiti non negativi con almeno un peso strettamente positivo. Rifiuta stringhe non valide, segni, notazione esponenziale, spazi bianchi, voci non stringhe o un input `weights` non sotto forma di lista con `ValueError`. Gli zeri iniziali sono consentiti.
3. Utilizza `Decimal` per analizzare e conservare esattamente gli importi decimali forniti. Convertire i dollari in centesimi interi. Assegnare i centesimi interi in proporzione ai pesi, utilizzando il metodo del resto maggiore: calcolare il valore intero (floor) di ciascuna quota esatta, quindi assegnare i centesimi rimanenti ai resti frazionari più grandi. In caso di parità, privilegiare l’indice originale più basso. La lista restituita deve preservare l’ordine di input e la cui somma deve corrispondere esattamente al totale dei centesimi.
4. Non perdere silenziosamente precisione in caso di valori validi molto lunghi o pesi molto diseguali. Non modificare i pesi. Importare solo da `decimal` o `math` se le importazioni sono necessarie. Nessuna operazione su file, rete, ambiente, processo o input/output.

Implementazione errata:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
Primo output completo
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 se non isinstance(s, str) o se s non esiste:
 restituisci False
 parti = s.split(".")
 se len(parti) > 2:
            restituisci False
 se non parts[0] oppure se non tutti(c in DIGITS per c in parts[0]):
 restituisci False
 se len(parts) == 2:
 frac = parts[1]
 se non frac oppure se non tutti(c in DIGITS per c in frac):
                restituisci False
 se max_frac non è None e len(frac) > max_frac:
 restituisci False
 restituisci True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 valore = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # restituisce (mantissa intera, esponente) con valore = mantissa * 10**esponente
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("totale non valido")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("pesi non validi")
    for w in pesi:
 if not valid(w, None):
 raise ValueError("peso non valido")

 mant, exp = to_scaled(totale)
    if exp >= -2:
 centesimi = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # irraggiungibile per input convalidato

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    if W <= 0:
        raise ValueError("almeno un peso deve essere positivo")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
Documenti: individuare i documenti corretti dopo le correzioni e l'eliminazione dei duplicati
Il terzo compito prevedeva un pacchetto di fatture sintetico composto da 13.078 parole: 120 record di base, otto correzioni e quattro copie d’archivio. Sonnet doveva selezionare solo le fatture Atlas approvate e datate settembre 2026, utilizzare la versione più recente di ciascun record e restituire un JSON rigoroso contenente il totale e tre controlli di verifica significativi.
Ha selezionato tutti 16 codici fattura corretti, ha restituito l'esatto $15,305.66 complessivamente, rispettando la struttura JSON. Le fasi successive hanno riguardato la riconciliazione contabile, i documenti giustificativi per le rettifiche e i controlli sui duplicati o sui dati troncati. Non ha considerato una vecchia copia d'archivio come una nuova fattura.
Questo è il tipo di dettaglio che conta nel lavoro sui documenti: la correzione più recente deve prevalere, anche quando una versione precedente compare più avanti nel fascicolo. Il risultato è promettente per l’estrazione di documenti delimitati. Si tratta comunque di un esercizio sintetico, di portata molto più ridotta rispetto alla finestra di contesto da un milione di token pubblicizzata; per lavori finanziari di rilievo è necessario un calcolo indipendente.
Verifica del documento: 16 record, totale esatto
Prima risposta: 16,42 secondi. Tutti i 16 ID delle fatture e l’importo totale di $15.305,66 corrispondevano al riferimento indipendente; anche il formato JSON rigoroso e i tre controlli successivi erano corretti.
Claude Sonnet 5.5 · GlobalGPT · 1 ottobre 2026 · limite massimo di 6.000 token · nessun strumento · campionamento e sforzo lasciati alle impostazioni predefinite del servizio. Per "tempo" si intende la risposta completa, non il primo token.
Il pacchetto sintetico fornito conteneva 120 record di base, otto correzioni e quattro copie d'archivio (13.078 parole). I campi erano: ID, versione, progetto, data, stato, importo e note descrittive. Le istruzioni riportate di seguito sono complete; il lungo pacchetto originale è qui sintetizzato.
Istruzioni per l'attività
Verifica i record delle fatture sintetiche di progetto riportati di seguito. Per ogni ID utilizza solo la versione più recente; i record duplicati identici non generano fatture aggiuntive. La versione più recente può apparire prima di una copia d’archivio più vecchia. Seleziona solo i record il cui progetto finale sia Atlas, lo stato finale sia "approvato" e la data finale ricada nel mese di settembre 2026. Gli importi sono espressi in USD. Restituisci un JSON rigoroso contenente esattamente queste chiavi: "ids" (ID selezionati univoci ordinati in ordine crescente), "total_usd" (una stringa con esattamente due cifre decimali) e "action_items" (esattamente tre stringhe concise che indicano i prossimi controlli contabili pertinenti). Non aggiungere delimitatori Markdown né testo esplicativo. Ignora le note descrittive per il filtraggio; tutti i campi contabili sono strutturati. Non considerare i record di altri mesi, i record in bozza, i record Orion, le vecchie versioni o le copie duplicate.
Primo output completo
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056","INV-062","INV-068","INV-074","INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15305,66","action_items":["Riconcilia le 16 fatture selezionate e il totale di 15.305,66 USD con il libro mastro generale e il registro ausiliario dei debiti di Atlas di settembre 2026.","Esaminare le registrazioni modificate dalle rettifiche (INV-003, INV-008, INV-020, INV-050, oltre alle fatture escluse INV-002, INV-014 e INV-026) per verificare la presenza di prove di approvazione e documenti giustificativi.","Verificare che le copie d’archivio duplicate non siano state registrate come fatture separate e controllare eventuali problemi di rateizzazione o di chiusura contabile sulle fatture corrette con data vicina alla fine del mese."]}Sonnet 5.5 vs Opus 5.5: quale scegliere?
Scegli in base alla natura del lavoro. Sonnet è una scelta iniziale sensata quando le istruzioni e l’obiettivo finale sono chiari. Opus è il punto di partenza più indicato quando il compito richiede un giudizio costante, l’individuazione di presupposti mancanti o il coordinamento di una lunga catena di decisioni. Leggi il nostro Recensione del Claude Opus 5.5 per dare un'occhiata più da vicino a quel modello.
Sonnet 5.5 vs Opus 5.5: quale scegliere?
| Il tuo compito | Punto di partenza consigliato | Perché |
|---|---|---|
| Riscrittura di una breve bozza di testo destinato ai clienti, estrazione di dati | Sonnet 5.5 | Vincoli chiari rendono più facile verificare la qualità. |
| Risolvere un bug individuato o implementare una funzione specificata | Sonnet 5.5 | Ottima esecuzione delle attività con una frequenza di token in ingresso/uscita inferiore. |
| Definire l'architettura con requisiti incompleti | Opus 5.5 | La parte difficile è esercitare un giudizio costante, non solo mettere in pratica le decisioni. |
| Completa una campagna con testo, immagini e video | Flusso di lavoro multimodello GlobalGPT | Utilizza Sonnet per i modelli sintetici e specialistici relativi alle risorse. |
Una procedura utile consiste nel chiedere a un modello di ragionamento più potente di valutare criticamente un piano complesso, per poi fornire a Sonnet le specifiche concordate e i controlli concreti. La scelta del modello può variare da una fase all’altra. Non è necessario trasformare ogni piccola revisione nell’attività di ragionamento più costosa.
Utilizza Sonnet 5.5 su GlobalGPT
GlobalGPT rende il modello utile nell’ambito di una struttura di lavoro più ampia. Apri Claude Sonnet 5.5 per la fase di scrittura o analisi, quindi passa a un altro modello quando il progetto richiede un approccio diverso. Puoi sviluppare un brief per una campagna, perfezionare i testi, creare elementi visivi e produrre video senza dover ricostruire il flusso di lavoro su più abbonamenti.
Per ottenere un risultato iniziale migliore, invia insieme il materiale di partenza e una breve serie di regole di accettazione. Per i testi, specifica il pubblico di destinazione, la lunghezza, il tono e gli elementi che devono rimanere invariati. Per il codice, fornisci l’esempio che genera l’errore e il comportamento atteso. Per i documenti, contrassegna le sezioni di origine e indica come gestire le versioni in conflitto. Questi spunti per la scrittura, la ricerca e la programmazione ti forniranno spunti di partenza riutilizzabili.
Gli sviluppatori possono inoltre integrare il proprio flusso di lavoro sul terminale tramite GlobalGPT CLI con codice Claude. Utilizzate il sito web dedicato al progetto più ampio e l'interfaccia a riga di comando (CLI) laddove sia più adatto al processo di sviluppo. Il valore aggiunto risiede in un insieme integrato di strumenti, in cui la scelta del modello dipende dall'attività successiva.
Limiti e dettagli sull'aggiornamento da tenere presenti
L'impegno intenso è una scelta, non una garanzia di qualità. Sonnet potrebbe concentrarsi eccessivamente su un problema circoscritto o andare oltre le modifiche richieste. Chiedigli di mantenere l’ambito, eseguire i controlli pertinenti e interrompersi quando i criteri di accettazione sono soddisfatti. Se il prodotto mette a disposizione strumenti di controllo dello sforzo, confronta la qualità e il costo delle attività completate prima di aumentarli.
Anche i fatti attuali richiedono fonti aggiornate. Il cutoff delle informazioni del modello, fissato a giugno 2026, non riflette le informazioni aggiornate relative a ogni prezzo, politica o lancio. Fornisci il documento attuale oppure utilizza un flusso di lavoro con strumenti di ricerca. Per i contenuti sensibili, verifica i termini relativi alla privacy e alla conservazione dei dati del servizio e dell'account che utilizzi effettivamente; il nome del modello non determina tali impostazioni.
Le migrazioni delle API richiedono ben più di una semplice sostituzione del nome del modello. La versione Sonnet 5.5 modifica alcuni modelli di richiesta precedenti. L’API diretta Claude rifiuta impostazioni non predefinite per temperatura, top_p e top_k; pertanto, potrebbe essere necessario aggiornare le configurazioni basate su logiche obsolete o sull’uso forzato di strumenti. Il ragionamento adattivo è l’impostazione predefinita; la modalità `between_tools`, documentata, elimina il ragionamento iniziale a livelli di sforzo “Elevato” o inferiori. La panoramica attuale documenta inoltre che l’uso forzato degli strumenti restituisce un errore, che gli strumenti di calcolo più datati non sono accettati dall’API Claude e da Google Cloud, e che il testo tra le chiamate agli strumenti può essere inserito nei blocchi di ragionamento. Esaminare il guida ufficiale alla migrazione prima di spostare un'applicazione. Il nostro Guida all'API Claude tratta i concetti generali relativi alla configurazione e alla fatturazione.
Anthropic applica inoltre misure di sicurezza alle richieste relative alla sicurezza informatica e alla biologia che presentano un rischio più elevato. Lo sviluppo di software di routine rimane parte dell’uso previsto del modello. Se un’attività è legittima ma delicata, descrivere chiaramente l’ambito e le autorizzazioni, anziché presumere che ogni rifiuto sia una limitazione generale alla programmazione.
Verdetto finale: un ottimo modello da integrare nel proprio flusso di lavoro quotidiano
Sonnet 5.5 si guadagna il proprio posto grazie a un lavoro pratico e verificabile. I motivi principali per utilizzarlo sono la capacità di codifica con ambito ben definito e la gestione efficiente dei documenti, il tutto a un costo per token API inferiore rispetto a Opus. Anche la scrittura è un buon campo di applicazione, con un controllo finale sui dettagli plausibili che non erano mai stati menzionati nel brief. La nostra piccola serie di test conferma questo posizionamento nel lavoro quotidiano; non dimostra però un vantaggio universale in termini di velocità, costo o ragionamenti complessi.
Inizia con un compito concreto di cui puoi valutare il risultato. Rendi espliciti i vincoli, verifica i dettagli importanti e passa a un altro modello quando il problema cambia. Prova Sonnet 5.5 su GlobalGPT per integrare la scrittura, la programmazione, l'analisi e la fase creativa successiva in un unico flusso di lavoro multimodello.
Domande frequenti
Che cos’è Claude Sonnet 5.5?
Claude Sonnet 5.5 è un modello Anthropic lanciato il 28 settembre 2026. Supporta l'inserimento di testo e immagini con output testuale ed è progettato per la programmazione veloce di tutti i giorni, la scrittura, la gestione di documenti e i flussi di lavoro assistiti da strumenti.
Quanto costa il modello Claude Sonnet 5.5?
Il prezzo standard dell'API di Anthropic è di $2 per milione di token in ingresso e di $10 per milione di token in uscita. Le letture dalla cache costano $0,10 per milione di token. Gli abbonamenti alle app Claude e i piani GlobalGPT sono esclusi da queste tariffe API.
Il Claude Sonnet 5.5 è più veloce del Sonnet 5?
Il modello Anthropic mostra una generazione dei risultati più veloce di oltre 30% rispetto al modello Sonnet 5. Nel nostro test di scrittura con il modello GlobalGPT, tre risposte complete hanno richiesto da 11,60 a 12,16 secondi. Non abbiamo utilizzato il modello Sonnet 5 come controllo, pertanto il nostro test non misura il miglioramento della velocità tra una generazione e l’altra.
Il modello Sonnet 5.5 è migliore dell'Opus 5.5?
Scegliete Sonnet 5.5 per compiti ben definiti e un costo per token in ingresso/uscita inferiore. Opus 5.5 rappresenta il punto di partenza più solido per lavori complessi e di natura aperta che richiedono un giudizio costante. Sonnet è in testa in alcune valutazioni pubblicate, ma non esiste un vincitore assoluto.
Claude Sonnet 5.5 è in grado di gestire documenti di grandi dimensioni?
L'API Claude specifica una finestra di contesto di un milione di token. Nel nostro test su un documento sintetico più breve, composto da 13.078 parole, Sonnet ha selezionato tutti i 16 record idonei e ha calcolato il totale corretto. Tale risultato non garantisce l'accuratezza sull'intera finestra di contesto dichiarata.
Posso usare Claude Sonnet 5.5 su GlobalGPT?
Sì. GlobalGPT offre Claude Sonnet 5.5 insieme ad altri modelli di intelligenza artificiale, consentendoti di redigere bozze, programmare, analizzare documenti e passare alla lavorazione di immagini o video, il tutto su un’unica piattaforma.
Fonti e note di verifica
Le specifiche tecniche e i prezzi al momento del lancio sono stati verificati il 13 ottobre 2026; i test pratici riportati di seguito sono stati effettuati il 1° ottobre 2026. Fonti principali: Annuncio del lancio di Anthropic, Riferimento modello Sonnet 5.5, Prezzi API, e Prezzi di abbonamento Claude. Il contesto indipendente deriva dall’Analisi Artificiale e dallo studio CodeRabbit citato nel link sopra riportato.
I test GlobalGPT hanno utilizzato la prima risposta completata in tre compiti, oltre a due ripetizioni di scrittura. Non sono stati abilitati strumenti esterni. I tempi riportati si riferiscono alle risposte complete, inclusi i tempi di rete e di servizio; non è stato selezionato alcun valore relativo allo sforzo di ragionamento. Il pacchetto di fatture era sintetico e non conteneva dati dei clienti. L’illustrazione dell’intestazione è stata generata appositamente per questa recensione; le altre immagini sono screenshot dei siti web citati.