I migliori prompt per Claude rendono il compito facile da comprendere: indica a Claude un obiettivo, il materiale che deve utilizzare, i vincoli rilevanti e un modo per verificare il risultato. Per la scrittura, proteggi i fatti e l’azione successiva del lettore. Per la ricerca, collega le affermazioni alle fonti. Per la programmazione, definisci il comportamento corretto ed esegui dei test.
Inizia con l’attività che ti serve tra quelle riportate di seguito: redigere una bozza di e-mail, interpretare un pacchetto di materiale di riferimento o correggere una funzione Python. Scegli tra 12 modelli personalizzabili, quindi esplora tre esempi risolti e testati con Claude in GlobalGPT. Ogni esempio include il prompt completo e la risposta, così potrai vedere cosa copiare, cosa modificare e cosa controllare nel tuo lavoro.
Se il tuo lavoro passa dalla ricerca alla stesura e poi alla programmazione, GlobalGPT riunisce Claude e altri modelli di punta, insieme a numerosi strumenti di intelligenza artificiale, in un unico abbonamento conveniente e in un’unica dashboard. È possibile mantenere un unico flusso di lavoro complessivo e scegliere il modello o la funzione più adatta alla fase successiva.
In questa pagina
I migliori prompt Claude in sintesi
Scegli il modello in base alla decisione o al risultato finale che ti serve. Sostituisci i campi tra parentesi prima di inviarlo. I modelli per la scrittura e la ricerca funzionano con il testo incollato; i prompt di programmazione che richiedono l’accesso a file o l’esecuzione necessitano invece di uno strumento in grado di eseguire effettivamente tali azioni.
Per molti lavori è sufficiente un formato di partenza riutilizzabile. Panoramica sulla progettazione rapida di Anthropic Si parte dai criteri di successo e da un metodo per verificarli. Non occorre ricorrere a un profilo di esperto particolarmente articolato per definire cosa debba contenere una risposta utile.
Un breve modello di partenza
Aiutami con [COMPITO] per [DESTINATARI O SCOPO].
Utilizza questo materiale: [INCOLLA MATERIALE].
Rispetta questi vincoli: [FATTI, AMBITO, LUNGHEZZA O REGOLE].
Restituisci [FORMATO DI OUTPUT].
Un risultato corretto deve [REQUISITI VERIFICABILI].
Se manca un dettaglio necessario, poni la domanda specifica che impedisce il completamento dell'attività.
Utilizza titoli o tag quando questi consentono di suddividere più facilmente un brief complesso. Linee guida attuali di Anthropic relative ai suggerimenti raccomanda istruzioni chiare, esempi utili e tag XML descrittivi per i materiali misti. I tag servono a organizzare il testo; non costituiscono prove, non garantiscono l’accesso agli strumenti né rendono corretta una risposta.
Claude: spunti per la scrittura
Quando si scrive, la difficoltà sta spesso nel mantenere l’essenziale pur modificando l’espressione. Indica al lettore cosa deve fare e quali dettagli sono fissi. Una frase scorrevole non è d’aiuto se aggiunge implicitamente una promessa.
1. Scrivere un’e-mail sulla base di una sintesi fattuale
Un invito chiaro, un aggiornamento o un’e-mail al cliente contenente dettagli che devono essere precisi. Da portare: Una sintesi dei fatti, il pubblico di riferimento, la risposta richiesta e il limite di parole.
W1 · Esercizio rappresentativo illustrato di seguito
Scrivi l'e-mail richiesta nel brief. Considera i fatti confermati come definitivi. Distingui chiaramente le richieste dalle conferme. Rispetta il formato e la lunghezza indicati. Utilizza solo i dettagli forniti.


Destinatari: [CHI LEGGERÀ QUESTA E-MAIL]
Scopo: [COSA DOVREBBE OTTENERE L'E-MAIL]
Fatti confermati: [DATE, ORARI, PREZZI, LIMITI E ALTRI DETTAGLI]
Dettagli sconosciuti o non approvati: [CIÒ CHE NON PUOI PROMETTERE]
Azione richiesta al lettore: [IL PROSSIMO PASSO ESATTO]
Tono: [TONO]
Risultato finale: un oggetto e un corpo del testo di [NUMERO DI PAROLE] parole.
Controlla il risultato: Verifica ogni data, numero, promessa e azione successiva rispetto al brief. Anche una semplice frase in più, detta in tono amichevole, può comunque comportare un obbligo.
2. Adatta lo stile al tuo modo di scrivere
Una breve bozza che sembra in linea con il tuo lavoro precedente. Da portare: Due o tre esempi che hai scritto e le informazioni relative al nuovo articolo.
W2 · Modello personalizzabile
Utilizza i miei esempi di scrittura per individuare tre caratteristiche stilistiche osservabili: il ritmo delle frasi, il livello di formalità e il modo in cui espongo le idee. Applica tali caratteristiche a un nuovo [FORMATO] destinato a [PUBBLICO].

Utilizza gli esempi solo per lo stile. Utilizza la nuova bozza per i fatti. Indica le tre caratteristiche, quindi la bozza di [NUMERO DI PAROLE] parole.


[INCOLLA IL TUO TESTO]


[ARGOMENTO, SCOPO, FATTI CONFERMATI E AZIONE DEL LETTORE]
Controlla il risultato: Presta attenzione al ritmo delle frasi e alla precisione, quindi verifica che i dati di esempio non siano stati riportati nella nuova bozza.
Scegliete degli esempi di cui volete mantenere lo stile. Un elenco di aggettivi come “cordiale, perspicace, professionale” lascia più spazio all’interpretazione rispetto a pochi esempi concreti. Il nuovo brief dovrebbe rimanere la fonte dei dettagli oggettivi.
3. Individua le modifiche più rilevanti
Una bozza che sembra poco convincente, ma che non richiede una riscrittura completa. Da portare: La tua bozza, il pubblico di riferimento, lo scopo e eventuali passaggi da mantenere.
W3 · Modello personalizzabile
Esamina questa bozza per [DESTINATARI] che hanno bisogno di [OBIETTIVO DEL LETTORE]. Individua fino a tre modifiche che migliorerebbero maggiormente la chiarezza o l’utilità del testo. Se ne servono meno di tre, specificalo.

Per ogni modifica, cita il passaggio originale, spiega il problema del lettore e proponi una formulazione alternativa. Mantieni il significato oggettivo e questi elementi: [DA MANTENERE]. Non riscrivere l’intera bozza.


[INCOLLA BOZZA]
Controlla il risultato: Respingere i risultati che non siano in grado di individuare un passaggio concreto o un problema significativo per il lettore.
4. Riutilizzare una fonte per due tipi di pubblico
Trasformare un aggiornamento approvato in una nota interna e in un messaggio per i clienti. Da portare: Una fonte approvata e due schede informative per il pubblico.
W4 · Modello personalizzabile
Adattare il testo di riferimento approvato in due versioni brevi:
A. [FORMATO, DESTINATARI, SCOPO, LIMITE DI PAROLE]
B. [FORMATO, DESTINATARI, SCOPO, LIMITE DI PAROLE]

Mantenere coerenti le date, i numeri, la disponibilità delle funzionalità e gli impegni. Modificare la spiegazione e i punti salienti in modo da adattarli a ciascun pubblico. Se un pubblico necessita di un dettaglio non presente nel testo di riferimento, elencare tale lacuna dopo le bozze.


[INCOLLA TESTO DI RIFERIMENTO]
Controlla il risultato: Confronta entrambe le versioni con lo stesso elenco di fatti; un nuovo pubblico non giustifica l’introduzione di nuove caratteristiche o promesse.
Prova questi esercizi in GlobalGPT
Trasforma un brief in un'e-mail, un pacchetto di materiali in una proposta e una segnalazione di bug in una correzione.
Abbiamo utilizzato Claude Sonnet 5 in GlobalGPT per tutte e tre le attività. Le bozze delle e-mail contenevano i dettagli chiave degli eventi, le risposte alla ricerca hanno individuato i motivi per cui è opportuno rinviare il lancio e entrambe le correzioni in Python hanno superato tutti i 24 controlli quando le abbiamo eseguite separatamente. Questi sono utili punti di partenza per il lavoro che potete integrare nella stessa dashboard.
Per provarlo tu stesso, scegli uno dei modelli qui sotto e sostituisci il testo di esempio con il tuo. GlobalGPT riunisce strumenti di scrittura, ricerca, programmazione e altri strumenti basati sull'intelligenza artificiale in un unico abbonamento conveniente, così potrai passare dalla comprensione di un problema alla stesura del prossimo documento senza dover destreggiarti tra servizi separati.
Come abbiamo confrontato i prompt
Il 14 settembre 2026, per ogni compito sono state fornite due richieste basate sullo stesso materiale di riferimento fittizio e sugli stessi requisiti: una breve istruzione e una versione più strutturata. Abbiamo conservato la prima risposta completa fornita per ciascuna richiesta, per un totale di sei risposte. La ricerca si è basata sui brani forniti; il codice Python restituito è stato verificato separatamente, senza essere eseguito dal modello durante la conversazione.
Questi esempi riguardano tre attività, una per ogni versione. Di seguito sono riportati gli input e le risposte completi, insieme alle modifiche o alle verifiche necessarie per ciascun risultato. I 12 modelli riutilizzabili non sono stati testati separatamente.
Confronto tra le prime uscite · W
Redigi una bozza di email relativa all'evento, inserendo tutti i dettagli principali.
| Controllo | Istruzioni semplici | Istruzione strutturata |
|---|---|---|
| Dati fondamentali e verifiche delle azioni | 8 / 9 | 8 / 9 |
| Lunghezza del soggetto e del corpo | Pass · 126 parole | Pass · 128 parole |
| Promessa di follow-up non approvata | Presente | Presente |
Entrambe le versioni hanno mantenuto la data, gli orari, la capienza, il prezzo, le note e la distinzione tra richiesta e conferma di prenotazione. Questo ti offre una bozza da modificare anziché una pagina vuota. Prima di inviare, rimuovi la promessa di follow-up che nessuno dei due brief autorizzava; la versione semplice definiva inoltre le sessioni “identiche” senza alcuna giustificazione. Per la tua e-mail, elenca sia i fatti da mantenere sia gli impegni che sei autorizzato ad assumere.
Gli otto controlli riguardano la data; l’ora locale e l’ora UTC; la durata; la capienza per sessione; la partecipazione gratuita; gli appunti scaricabili; il divieto di registrazione; e la richiesta di prenotazione anziché la conferma della stessa. Il nono controllo verifica la presenza di fatti o impegni inventati. Il conteggio delle parole non include il titolo.
Tempo trascorso: 9,73 s / 7,02 s. Token di input e output segnalati: 400 + 617 / 468 + 299. Una risposta per ciascuno; nessun tentativo di ripetizione.
Istruzioni semplici — istruzioni complete e materiale di riferimento
Scrivi l’e-mail richiesta nel brief riportato di seguito.

EVENTO DI PROVA FICTIZIO. Si tratta di dettagli inventati relativi a un workshop, non di un’offerta reale.

Stai scrivendo un’e-mail di invito per un workshop comunitario fittizio chiamato “Clear Notes”.
Destinatari: responsabili di progetti con team di piccole dimensioni che desiderano appunti delle riunioni più chiari.
Obiettivo: invitare il lettore a rispondere con "MATTINA" o "POMERIGGIO" per richiedere un posto. La risposta serve a richiedere un posto, non a confermare la prenotazione.
Dati certi:
- Data: 8 ottobre 2026.
- Due sessioni separate iniziano alle 09:00 UTC e alle 16:00 UTC.
- Ogni sessione dura 40 minuti.
- Ogni sessione dispone di 25 posti.
- La partecipazione è gratuita.
- I partecipanti riceveranno gli appunti scaricabili.
- Non saranno fornite registrazioni.
- Non è stata fissata alcuna scadenza per l’iscrizione.
Risultato atteso: un oggetto e un testo dell’e-mail di 100–140 parole. Inglese semplice e cordiale; senza toni esagerati. Includere la data, entrambi gli orari di inizio e il fuso orario, la durata, la capienza per sessione, il prezzo, gli appunti scaricabili, l’assenza di registrazione e l’azione richiesta nella risposta. Non inventare link, scadenze, prenotazioni confermate, relatori o sedi. È accettabile non menzionare la scadenza di registrazione non ancora fissata.
Istruzioni semplici — risposta originale completa
**Oggetto: Workshop Clear Notes – 8 ottobre 2026 – Rispondi per prenotare il tuo posto**

Salve,

invitiamo i responsabili di progetto che desiderano redigere verbali delle riunioni più chiari e utili a partecipare a Clear Notes, un workshop gratuito della comunità che si terrà l’8 ottobre 2026.

Sono previste due sessioni identiche, ciascuna della durata di 40 minuti: una con inizio alle 09:00 UTC e l’altra alle 16:00 UTC. Per ogni sessione sono disponibili 25 posti.

La partecipazione è gratuita e tutti i partecipanti riceveranno degli appunti scaricabili da conservare. Si prega di notare che non verrà fornita alcuna registrazione, quindi la partecipazione in diretta è l’unico modo per prendere parte all’evento.

Per richiedere un posto, è sufficiente rispondere a questa e-mail indicando MORNING o AFTERNOON, a seconda della sessione che preferite. La risposta costituisce una richiesta di posto, ma non conferma la prenotazione. Vi forniremo presto ulteriori dettagli.

Grazie e speriamo di vedervi lì.
Istruzioni strutturate — istruzioni complete e materiale di riferimento
Scrivi l’e-mail di invito richiesta nel brief. Considera i fatti confermati come definitivi. Distingui chiaramente la richiesta di un posto dalla prenotazione confermata. Rispetta il formato e la lunghezza indicati. Utilizza solo i dettagli forniti.


ESEMPIO DI PROVA FICTIZIO. Si tratta di dettagli inventati relativi a un workshop, non di un’offerta reale.

Stai scrivendo un'e-mail di invito per un workshop comunitario fittizio chiamato Clear Notes.
Destinatari: responsabili di progetti in piccoli team che desiderano appunti delle riunioni più chiari.
Obiettivo: invitare il lettore a rispondere MORNING o AFTERNOON per richiedere un posto. Una risposta costituisce una richiesta di posto; non conferma una prenotazione.
Dati confermati:
- Data: 8 ottobre 2026.
- Due sessioni separate iniziano alle 09:00 UTC e alle 16:00 UTC.
- Ogni sessione dura 40 minuti.
- Ogni sessione ha 25 posti disponibili.
- La partecipazione è gratuita.
- I partecipanti riceveranno appunti scaricabili.
- Non sarà fornita alcuna registrazione.
- Non è stata fissata alcuna scadenza per l’iscrizione.
Risultato atteso: un oggetto dell’e-mail e un testo di 100–140 parole. Inglese semplice e cordiale; senza toni esagerati. Includere la data, entrambi gli orari di inizio e il fuso orario, la durata, la capienza per sessione, il prezzo, gli appunti scaricabili, l’assenza di registrazioni e l’azione richiesta nella risposta. Non inventare un link, una scadenza, una prenotazione confermata, un relatore o una sede. È accettabile non menzionare la scadenza di registrazione non ancora fissata.
Istruzione strutturata — risposta originale completa
Oggetto: Sei invitato: Workshop Clear Notes – 8 ottobre 2026

Ciao,

Se sei un responsabile di progetto alla ricerca di appunti delle riunioni più chiari, ci farebbe molto piacere averti al workshop Clear Notes l’8 ottobre 2026.

Sono disponibili due sessioni, ciascuna della durata di 40 minuti: una con inizio alle 09:00 UTC e l’altra alle 16:00 UTC. Ogni sessione prevede 25 posti disponibili e la partecipazione è completamente gratuita.

Tutti i partecipanti riceveranno appunti scaricabili da conservare e consultare in seguito. Si prega di notare che non verrà fornita alcuna registrazione, quindi la partecipazione in diretta è l’unico modo per prendere parte all’evento.

Per richiedere un posto, basta rispondere indicando MORNING o AFTERNOON, a seconda della sessione che preferite. La risposta serve a richiedere un posto, non a confermare la prenotazione; vi forniremo presto ulteriori dettagli.

Speriamo di vedervi lì.

Cordiali saluti,
Il team di Clear Notes
Claude: spunti di ricerca
Le richieste di ricerca devono essere circoscritte alle prove. Inserisci gli ID delle fonti nei passaggi pertinenti oppure utilizza uno strumento in grado di recuperarli effettivamente. Un semplice URL non costituisce prova del fatto che Claude abbia aperto una pagina. Questi modelli distinguono ciò che dicono le fonti da ciò che si può dedurre.
5. Sintetizzare le fonti senza appiattire i disaccordi
Rispondere a una domanda relativa a una decisione sulla base di documenti che è possibile consultare. Da portare: Estratti contrassegnati, relative date, domanda decisiva ed eventuali richieste di verifica.
R1 · Compito rappresentativo testato di seguito
Rispondi alla [DOMANDA DECISIONALE] utilizzando esclusivamente il pacchetto di fonti riportato di seguito. Confronta definizioni, popolazioni e denominatori prima di considerare le differenze numeriche come prova di un miglioramento. Distingui una bozza di affermazione da una misurazione. Collega ogni conclusione a una citazione esatta della fonte che la sostenga effettivamente e ometti le prove mancanti.

Risultato: una raccomandazione di al massimo [LIMITE] parole; una tabella contenente Affermazione, Verdetto, ID della fonte e citazione esatta a sostegno; e tre misurazioni mancanti necessarie per un confronto equo. Utilizzare «Supportato», «Parzialmente supportato», «Non supportato» o «Contraddetto» solo quando le prove giustificano tale etichetta. Verifica queste affermazioni: [AFFERMAZIONI].


[ID FONTI, DATE ED ESTRATTI COMPLETI PERTINENTI]
Controlla il risultato: Verificare il testo citato, l’affermazione che esso sostiene e se le quantità utilizzano la stessa definizione e lo stesso denominatore.
6. Verificare la fondatezza di un’affermazione confrontandola con la fonte citata
Esaminare una bozza prima che una citazione venga utilizzata come prova. Da portare: La citazione esatta e il brano di riferimento, non solo un URL.
R2 · Modello personalizzabile
Verifica ogni affermazione confrontandola con il testo di riferimento fornito insieme ad essa. Per ciascuna di esse, indica: l’affermazione, l’ID della fonte, la citazione esatta pertinente, il verdetto e, se necessario, una versione corretta.

Utilizza “Supportata” quando la fonte conferma l’intera affermazione; "Parzialmente supportata" quando la conferma solo in parte; "Non supportata" quando le prove sono assenti o insufficienti; e "Contraddetta" quando la fonte è in diretto conflitto con l'affermazione. Se il testo di origine è mancante, indicare che non è possibile valutare il supporto. Non dedurre il contenuto della fonte dal titolo o dall'URL.

[INCOLLA COPPIE AFFERMAZIONE–FONTE]
Controlla il risultato: Anche una fonte attendibile può non riuscire a confermare l'affermazione. L'assenza di prove non costituisce una contraddizione.
“Non comprovato” significa che le prove fornite non suffragano l’affermazione. “Contraddetto” significa che le prove la smentiscono. Questa distinzione è importante quando una fonte non riporta ancora alcun risultato: non ha dimostrato né un miglioramento né un peggioramento.
7. Confronta le opzioni con il tuo documento decisionale
Scegliere tra diverse opzioni con prove scientifiche non uniformi. Da portare: I vostri criteri, i vincoli e le informazioni attendibili relative a ciascuna opzione.
R3 · Modello personalizzabile
Confronta [OPZIONI] per [DECISIONE]. Utilizza questi criteri nell’ordine di priorità indicato: [CRITERI]. Vincoli rigidi: [VINCOLI]. Utilizza solo le informazioni sulle opzioni riportate di seguito.

Fornire una tabella comparativa, la scelta meglio supportata e il dato mancante che con maggiore probabilità potrebbe modificare tale scelta. Contrassegnare i valori mancanti come «sconosciuti». Tenere separati i dati oggettivi dai giudizi. Non inventare prezzi, punteggi o pesi numerici. Se dalle prove disponibili non è possibile selezionare alcuna opzione, spiegare il compromesso specifico rimasto irrisolto.


[INCOLLARE LE INFORMAZIONI VERIFICATE CON GLI ID DELLE FONTI]
Controlla il risultato: Verifica se una raccomandazione dipende da un valore sconosciuto o da pesi che non hai mai scelto.
8. Trasformare un argomento di ampio respiro in un piano di ricerca
Iniziare la ricerca prima di disporre di fonti sufficienti per rispondere. Da portare: Una decisione, un pubblico, un ambito di applicazione e una scadenza.
R4 · Modello personalizzabile
Elaborare un piano di ricerca su [DOMANDA] per aiutare [DESTINATARI] a prendere una [DECISIONE]. Ambito: [REGIONE, PERIODO ED ESCLUSIONI]. Tempo a disposizione: [TEMPO].

Fornisci cinque sotto-domande mirate. Per ciascuna di esse, indica le prove necessarie, il tipo di fonte primaria preferita, i termini di ricerca suggeriti e un risultato che potrebbe modificare la decisione. Concludi con le due ricerche di massima priorità. Non inventare studi né affermare di aver letto fonti che non hai consultato. Se utilizzi strumenti di navigazione, indica separatamente le pagine effettivamente aperte e ciò che ciascuna di esse sostiene.
Controlla il risultato: Il risultato è un piano. Considera le ricerche proposte e le potenziali fonti come spunti, non come ricerche concluse.
Confronto tra i primi risultati · R
Un risultato mancante non equivale a una tesi confutata.
| Controllo | Istruzioni semplici | Istruzione strutturata |
|---|---|---|
| Controlli di ricerca predefiniti | 6 / 8 | 7 / 8 |
| Etichetta di prova di conservazione | In contraddizione · troppo forte | Non supportato · appropriato |
| Account invitati vs avvio delle procedure di onboarding | Non è spiegato in modo esplicito | Non è spiegato in modo esplicito |
Entrambe le risposte hanno respinto l’ipotesi di un’implementazione su larga scala e hanno riconosciuto che i progetti pilota utilizzavano definizioni di attivazione e popolazioni diverse. La versione strutturata ha correttamente classificato l’affermazione sulla fidelizzazione come “Non supportata”. La versione semplificata riportava invece “Contraddetta”, sebbene la citazione riportata dimostrasse solo l’assenza di risultati relativi alla fidelizzazione. Nessuna delle due risposte ha evidenziato esplicitamente i diversi denominatori.
Le percentuali erano 40/50 per gli account invitati (80%) e 54/60 per le procedure di onboarding avviate (90%). Il calcolo è corretto; le misurazioni non sono intercambiabili. La risposta strutturata ha aggiunto una verifica separata per accertare se il termine “attivazione” avesse lo stesso significato. Si trattava di un’ulteriore domanda analitica, non di una quarta affermazione contenuta nella nota di lancio.
| Richiesta di risarcimento | Cosa supporta il codice sorgente fornito | Trattamento adeguato |
|---|---|---|
| B ha aumentato l'attivazione di 10 punti percentuali | Tariffe, definizioni, denominatori e popolazioni diversi | Non considerare tale divario come un miglioramento causale |
| B: maggiore ritenzione | S3: non sono ancora disponibili i risultati relativi alla conservazione dei dati per 30 giorni | Non supportato; non smentito |
| B ha ridotto il tempo di assistenza a sei ore | S3: mediana aggregata, senza suddivisione per studio pilota | Nessuna riduzione dimostrata |
Visualizza tutte e otto le verifiche di ricerca
1. A: 40/50 = 80%, utilizzando gli account invitati. Entrambi superano il test.
2. B: 54/60 = 90%, utilizzando gli avvii di onboarding. Entrambi superano il test; le citazioni della fonte contengono i denominatori.
3. Segnalare esplicitamente sia le diverse definizioni di attivazione sia i diversi denominatori. Entrambi non superano la parte relativa al denominatore.
4. Non considerare l’assenza di risultati sulla fidelizzazione come prova di miglioramento. Entrambi spiegano la lacuna nei dati.
5. Non considerare una mediana aggregata del supporto come una diminuzione dimostrata. Entrambi superano il test.
6. Non dedurre un beneficio causale né giustificare un'implementazione completa sulla base di questi progetti pilota. Entrambi superano il test.
7. Abbinare ogni affermazione e ogni etichetta di evidenza a ciò che la citazione citata sostiene. La risposta semplice non supera il test in «Contraddetto»; quella strutturata lo supera.
8. Identificare tre misurazioni mancanti specifiche. Entrambi superano il test.
L'etichetta errata della risposta semplice viene conteggiata una volta, nel controllo 7.
Tempo trascorso: 31,35 s / 31,07 s. Token di input e output segnalati: 743 + 2822 / 832 + 2837. Una risposta per ciascuno; nessun tentativo di ripetizione.
Istruzioni semplici — istruzioni complete e materiale di riferimento
Rispondi all’esercizio riportato alla fine del presente pacchetto di materiale di riferimento.

# Pacchetto di ricerca fittizio

Tutte le organizzazioni, i dati, le citazioni e i documenti riportati di seguito sono stati inventati ai fini di una prova riproducibile. Gli ID delle fonti si riferiscono esclusivamente a questo pacchetto; non si tratta di studi pubblici.

## S1 — Chiusura del progetto pilota A, 2 settembre 2026

"Il progetto pilota A ha invitato 50 account; 40 hanno completato l’attivazione entro sette giorni."
"Per attivazione si intendeva la creazione di uno spazio di lavoro e l’invito di almeno un collaboratore."
"Gli account erano clienti esistenti selezionati dal team di customer success."
"Il progetto pilota ha utilizzato un onboarding guidato."

## S2 — Nota sulla dashboard del progetto pilota B, 3 settembre 2026

"Il progetto pilota B ha registrato 60 avviamenti di onboarding; 54 account hanno creato uno spazio di lavoro entro sette giorni."
"Questa dashboard definisce "attivazione" la creazione di uno spazio di lavoro; non richiede l’invito di un collaboratore."
"Il numero di inviti non è stato registrato."
"Gli account erano nuove registrazioni in modalità self-service effettuate utilizzando una checklist."

## S3 — Revisione dell’analista, 4 settembre 2026

"I progetti pilota non sono stati randomizzati e hanno utilizzato popolazioni di account diverse."
"Il tempo mediano di risposta dell’assistenza è stato di sei ore considerando i due progetti pilota combinati; non è stato suddiviso per singolo progetto pilota."
"Non sono ancora disponibili risultati relativi alla fidelizzazione a 30 giorni né ai ricavi."

## S4 — Bozza di nota di implementazione, 5 settembre 2026

"Il progetto pilota B ha aumentato l’attivazione di 10 punti percentuali, ha migliorato la fidelizzazione e ha ridotto il tempo di risposta dell’assistenza a sei ore. Distribuire la checklist a tutti gli account."
Si tratta di una bozza di proposta, non di una fonte di dati aggiuntiva. Le sue affermazioni devono essere verificate rispetto a S1–S3.

## Compito comune a entrambe le versioni del prompt

Risposta: Questo pacchetto giustifica l’estensione del Progetto pilota B a tutti gli account?
Utilizza solo S1–S4. Produci (1) una raccomandazione di massimo 120 parole, (2) una tabella con le colonne Affermazione, Verdetto, ID fonte, Citazione esatta a sostegno e (3) tre misurazioni mancanti necessarie per un confronto equo.
Verifica tutte e tre le affermazioni empiriche contenute nella nota di implementazione: l’aumento delle attivazioni, il miglioramento della fidelizzazione e la riduzione dei tempi di assistenza. Utilizza i verdetti “Supportato”, “Parzialmente supportato”, “Non supportato” o “Contraddetto”, con una breve spiegazione se necessario. Includi i tassi numerici e i relativi denominatori nella raccomandazione o nella tabella. Non inventare citazioni, URL, effetti causali o risultati non presenti nel fascicolo.
Istruzioni semplici — risposta originale completa
## Raccomandazione (≤120 parole)

Non lanciare ancora il Progetto Pilota B. Il tasso di attivazione grezzo del Progetto Pilota B (54/60 = 90%) è superiore di 10 punti percentuali rispetto a quello del Progetto Pilota A (40/50 = 80%), ma i due progetti pilota hanno misurato l""attivazione" in modo diverso (il progetto B non richiede l’invito di un compagno di squadra), hanno attinto da popolazioni diverse (nuove registrazioni in modalità self-service rispetto a clienti esistenti) e non sono stati randomizzati (S3) — pertanto il divario non può essere attribuito alla checklist. L’affermazione relativa alla fidelizzazione non è supportata: S3 afferma esplicitamente che non esistono ancora dati sulla fidelizzazione a 30 giorni. Il dato relativo al tempo di assistenza di "sei ore" è una mediana combinata di entrambi i progetti pilota, non suddivisa per singolo progetto, quindi non viene dimostrata alcuna riduzione specifica per il Progetto pilota B. Prima del lancio è necessario un confronto controllato, abbinato e definito in modo coerente.

## Tabella di verifica delle affermazioni

| Affermazione | Verdetto | ID fonte | Citazione esatta a sostegno |
|---|---|---|---|
| "Il progetto pilota B ha aumentato l’attivazione di 10 punti percentuali" | Parzialmente supportata — i tassi grezzi differiscono di 10 pp (54/60=90% vs 40/50=80%), ma le definizioni, le popolazioni e il disegno differiscono, quindi la differenza non è attribuibile alla checklist | S1 | "Il progetto pilota A ha invitato 50 account; 40 hanno completato l’attivazione entro sette giorni." |
| (stessa affermazione, continua) | | S2 | "Il progetto pilota B ha registrato 60 avviamenti di onboarding; 54 account hanno creato uno spazio di lavoro entro sette giorni." / "non richiede l’invito di un collega" |
| (stessa affermazione, continua) | | S3 | "I progetti pilota non sono stati randomizzati e hanno utilizzato popolazioni di account diverse." |
| "migliore fidelizzazione" | Contraddittorio — non esistono dati sulla fidelizzazione a sostegno di questa affermazione | S3 | "Non sono ancora disponibili risultati relativi alla fidelizzazione a 30 giorni o ai ricavi." |
| "Tempo di assistenza ridotto a sei ore" | Non supportato — la cifra è una mediana combinata, non attribuita al pilota B né indicata come riduzione | S3 | "Il tempo mediano di risposta dell’assistenza è stato di sei ore considerando i due piloti combinati; non è stato suddiviso per singolo pilota.» |

## Tre dati mancanti necessari per un confronto equo

1. Tassi di attivazione per entrambi i progetti pilota utilizzando una definizione identica (ad es., creazione di uno spazio di lavoro *e* invito di almeno un collega).
2. Tempi di risposta dell’assistenza riportati separatamente per il progetto pilota A e il progetto pilota B (non una mediana combinata), idealmente con un valore di riferimento pre-pilota.
3. Risultati relativi alla fidelizzazione a 30 giorni (e al fatturato) per entrambi i progetti pilota, raccolti da popolazioni di account comparabili, idealmente randomizzate o abbinate.
Istruzioni strutturate — istruzioni complete e materiale di riferimento
Rispondi all’esercizio utilizzando esclusivamente questo pacchetto di fonti. Confronta definizioni, popolazioni e denominatori prima di considerare i due tassi come prova di un miglioramento. Distingi una bozza di affermazione da una misurazione. Collega ogni conclusione a una citazione esatta tratta dalla fonte che la sostenga effettivamente, e ometti le prove mancanti.


# Pacchetto di ricerca fittizio

Tutte le organizzazioni, i dati, le citazioni e i documenti riportati di seguito sono stati inventati ai fini di una prova riproducibile. Gli ID delle fonti si riferiscono esclusivamente a questo pacchetto; non si tratta di studi pubblici.

## S1 — Chiusura del progetto pilota A, 2 settembre 2026

"Il progetto pilota A ha invitato 50 account; 40 hanno completato l’attivazione entro sette giorni."
"Per attivazione si intendeva la creazione di uno spazio di lavoro e l’invito di almeno un collega."
"Gli account erano clienti esistenti selezionati dal team di customer success."
"Il progetto pilota ha utilizzato un processo di onboarding guidato."

## S2 — Nota sulla dashboard del progetto pilota B, 3 settembre 2026

"Il progetto pilota B ha registrato 60 avviamenti di onboarding; 54 account hanno creato uno spazio di lavoro entro sette giorni."
"Questa dashboard definisce "attivazione" la creazione di uno spazio di lavoro; non richiede l’invito di un collaboratore."
"Il numero di inviti non è stato registrato."
"Gli account erano nuove registrazioni in modalità self-service effettuate utilizzando una checklist."

## S3 — Revisione dell’analista, 4 settembre 2026

"I progetti pilota non sono stati randomizzati e hanno utilizzato popolazioni di account diverse."
"Il tempo mediano di risposta dell’assistenza è stato di sei ore considerando i due progetti pilota combinati; non è stato suddiviso per singolo progetto."
"Non sono ancora disponibili risultati relativi alla fidelizzazione a 30 giorni né al fatturato."

## S4 — Bozza di nota di implementazione, 5 settembre 2026

"Il progetto pilota B ha aumentato l'attivazione di 10 punti percentuali, migliorato la fidelizzazione e ridotto il tempo di assistenza a sei ore. Distribuire la checklist a tutti gli account."
Si tratta di una bozza di proposta, non di una fonte di dati aggiuntiva. Le sue affermazioni devono essere verificate rispetto a S1–S3.

## Compito comune a entrambe le versioni del prompt

Risposta: Questo pacchetto giustifica l’implementazione del Progetto pilota B su tutti gli account?
Utilizza solo S1–S4. Produci (1) una raccomandazione di massimo 120 parole, (2) una tabella con le colonne Affermazione, Verdetto, ID fonte, Citazione esatta a sostegno e (3) tre misurazioni mancanti necessarie per un confronto equo.
Verifica tutte e tre le affermazioni empiriche contenute nella nota di implementazione: l’aumento delle attivazioni, il miglioramento della fidelizzazione e la riduzione dei tempi di assistenza. Utilizza i verdetti “Supportato”, “Parzialmente supportato”, “Non supportato” o “Contraddetto”, con una breve spiegazione se necessario. Includi i tassi numerici e i relativi denominatori nella raccomandazione o nella tabella. Non inventare citazioni, URL, effetti causali o risultati assenti dal materiale fornito.
Istruzione strutturata — risposta originale completa
## Raccomandazione (≤120 parole)

No — il pacchetto non giustifica un lancio completo del Pilot B. Pilot A: 40/50 account (80%) hanno raggiunto l""attivazione", definita come creazione di uno spazio di lavoro *più* un invito a un collega, tra i clienti esistenti. Progetto pilota B: 54/60 account (90%) hanno creato uno spazio di lavoro entro sette giorni, senza alcun requisito di invito, tra le nuove registrazioni self-service. Il divario lordo di 10 punti (90%−80%) mescola definizioni diverse, popolazioni diverse e non presenta randomizzazione (S3), quindi non può essere interpretato come un "aumento" dell’attivazione secondo la checklist. Non esistono ancora dati sulla fidelizzazione a 30 giorni né sui ricavi (S3), quindi l’affermazione "miglioramento della fidelizzazione" non ha alcun fondamento. Il dato relativo alle sei ore di assistenza è una mediana *combinata* per entrambi i progetti pilota, non suddivisa per singolo progetto, quindi l’affermazione "riduzione dei tempi di assistenza" non ha un valore di riferimento né è supportata da dati specifici per ciascun progetto.

## Tabella

| Affermazione | Verdetto | ID fonte | Citazione esatta a sostegno |
|---|---|---|---|
| "Il progetto pilota B ha aumentato l’attivazione di 10 punti percentuali" | Parzialmente supportata — il divario aritmetico esiste (54/60=90% vs 40/50=80%), ma il confronto è confuso e non può sostenere un’affermazione causale di "aumento" | S1, S2, S3 | S1: "Il pilota A ha invitato 50 account; 40 hanno completato l’attivazione entro sette giorni." / S2: "Il pilota B ha registrato 60 avviamenti di onboarding; 54 account hanno creato uno spazio di lavoro entro sette giorni." / S3: "I piloti non erano randomizzati e utilizzavano popolazioni di account diverse." |
| L’attivazione è stata misurata allo stesso modo in entrambi i progetti pilota | Contraddittorio | S1, S2 | S1: "Per attivazione si intendeva la creazione di uno spazio di lavoro e l’invito di almeno un collaboratore." / S2: "Questa dashboard definisce "attivazione" la creazione di uno spazio di lavoro; non richiede l’invito di un collaboratore." |
| "miglioramento della fidelizzazione" | Non supportato | S3 | "Non sono ancora disponibili risultati relativi alla fidelizzazione a 30 giorni né al fatturato." |
| "riduzione dei tempi di assistenza a sei ore" | Non supportato | S3 | "Il tempo mediano di risposta dell’assistenza era di sei ore considerando i due progetti pilota combinati; non è stato suddiviso per singolo progetto pilota.» |

## Tre misurazioni mancanti necessarie per un confronto equo

1. Tempi di risposta dell’assistenza specifici per ciascun progetto pilota (non aggregati), prima e dopo l’introduzione della checklist, in modo da poter isolare qualsiasi cambiamento attribuibile al Progetto pilota B.
2. Dati relativi alla fidelizzazione a 30 giorni (e ai ricavi) per entrambi i progetti pilota, poiché al momento non ne esistono (“Non sono ancora disponibili risultati relativi alla fidelizzazione a 30 giorni né ai ricavi”, S3).
3. Una definizione unica e condivisa di «attivazione» (ad es. creazione di uno spazio di lavoro *e* invito di un collega) applicata a popolazioni di account comparabili, idealmente randomizzate, in entrambi i progetti pilota, anziché mescolare i clienti esistenti (S1) con le nuove registrazioni in modalità self-service (S2).
Quando un compito di ricerca diventa una bozza, allega il fascicolo delle fonti alle istruzioni di scrittura. L'area di lavoro multimodello di GlobalGPT ti permette di passare dalla ricerca alla scrittura e alla programmazione all’interno di un’unica dashboard. Trasferisci sia i dati che il riepilogo, in modo che la fase successiva disponga di tutti i dettagli necessari.

Claude: suggerimenti per la programmazione
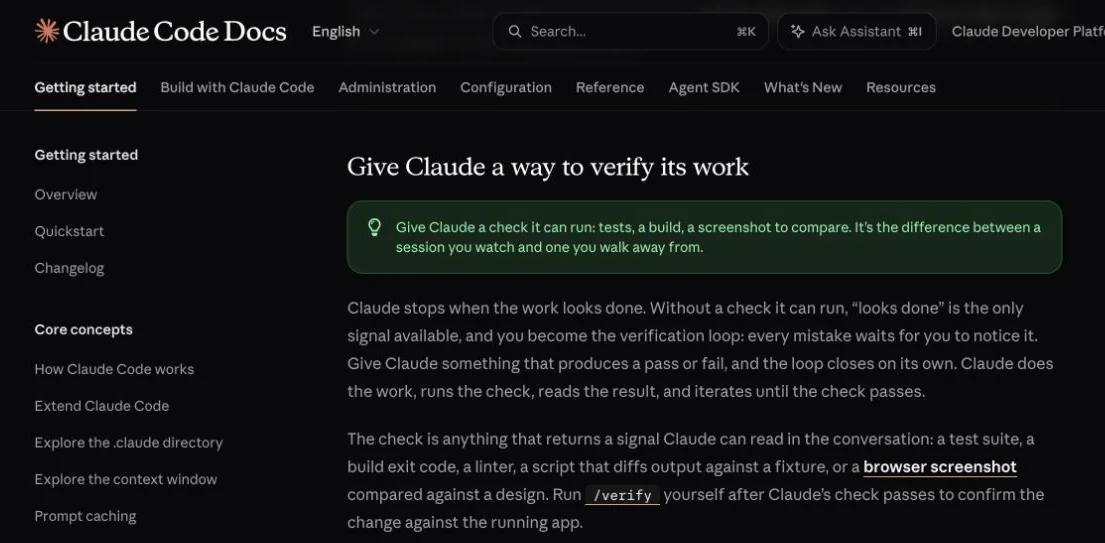
Un suggerimento utile per la programmazione descrive il comportamento, l'ambiente e ciò che si considera "fisso". In una chat, incolla il codice pertinente e l'errore. Nel codice Claude, fai riferimento ai file accessibili e fornisci un obiettivo di verifica concreto. Lo stesso testo non trasforma una chat in un terminale.
Linee guida sul codice Anthropic-Claude consiglia di affidare all'assistente le operazioni che è in grado di eseguire, come i test o la compilazione. Il suo libreria ufficiale di prompt considera i suggerimenti come punti di partenza da cui partire per adattare il proprio lavoro, indicando un risultato, del materiale di riferimento e un modo per verificare il lavoro svolto.
9. Eseguire il debug in base al comportamento esplicito e ai casi limite
Creazione di una piccola funzione il cui comportamento è possibile definire. Da portare: Codice, comportamento previsto, errore o caso di fallimento, fase di esecuzione e vincoli.
C1 · Compito rappresentativo oggetto della prova riportata di seguito
Correggi il codice in base alle specifiche complete. Verifica la validità prima dei ritorni anticipati, i limiti inclusivi o esclusivi e le regole che devono comunque essere applicate quando viene generata un’eccezione. Mantieni [PUBLIC INTERFACE]. Modifica solo ciò che le specifiche richiedono.


[INPUT VALIDI, COMPORTAMENTO IN CASO DI INPUT NON VALIDI, REGOLE DI BUSINESS E OUTPUT PREVISTI]


[INCOLLA IL CODICE]


[RUNTIME, DIPENDENZE E DISPONIBILITÀ DEGLI STRUMENTI DI ESECUZIONE]


Restituisci il codice corretto e una breve spiegazione. Riporta solo le verifiche che hai effettivamente eseguito. Se l’esecuzione non è disponibile, segnalalo e indica i controlli che dovrei eseguire.
Controlla il risultato: Esegui casi indipendenti. Una spiegazione convincente non è un programma che funziona.
10. Scrivere test a partire da una specifica
Individuare i casi mancanti prima di considerare affidabile un'implementazione. Da portare: Requisiti comportamentali e struttura di test del progetto.
C2 · Modello personalizzabile
Scrivere test per [FUNZIONE O COMPONENTE] utilizzando [FRAMEWORK DI TEST]. Considerare le specifiche riportate di seguito come il contratto. Coprire il caso normale, ogni limite indicato, gli input non validi e le interazioni tra le regole laddove siano rilevanti.

Per ogni test, identifica il requisito che verifica e il risultato atteso. Mantieni intatti i requisiti esistenti. Se le specifiche sono ambigue, identifica la domanda che blocca il processo invece di tirare a indovinare. Se si utilizzano strumenti di esecuzione, esegui i test pertinenti e riporta il comando effettivo e il risultato; altrimenti contrassegnali come non eseguiti.


[INCOLLA LA SPECIFICAZIONE]


[INCOLLA IL CODICE O FAI RIFERIMENTO A UN FILE ACCESSIBILE]
Controlla il risultato: I test dovrebbero garantire il rispetto delle specifiche, non riprodurre un bug presente nell'implementazione attuale.
Ove possibile, mantenete i test indipendenti dall'implementazione. Nel caso di un calcolatore delle spese di spedizione, testate le soglie di peso esatte e un input non valido che altrimenti farebbe scattare la spedizione gratuita. Gli esempi relativi al percorso ideale da soli non bastano a individuare le interazioni tra le regole.
11. Ristrutturare il codice senza aumentare il carico di lavoro
Migliorare un piccolo frammento di codice mantenendo inalterato il comportamento. Da portare: Il codice, il problema specifico di manutenzione e i requisiti di compatibilità.
C3 · Modello personalizzabile
Rifattorizzare [CODICE O FILE ACCESSIBILE] per risolvere [UN PROBLEMA SPECIFICO DI MANUTENZIONE]. Mantenere [API PUBBLICA, TIPI DI RESTITUZIONE, COMPORTAMENTO IN CASO DI ERRORE E ALTRI CONTRATTI]. Utilizzare esclusivamente le dipendenze esistenti. Non aggiungere funzionalità non correlate né riprogettare i moduli adiacenti.

Fornire la modifica utile più contenuta possibile, spiegare eventuali comportamenti che non è stato possibile preservare e identificare i test necessari per verificare la compatibilità. Se sono disponibili strumenti, eseguire tali controlli e mostrarne il risultato; in caso contrario, indicare i controlli proposti e specificare che non sono stati eseguiti.

[INCOLLA IL CODICE E I TEST PERTINENTI]
Controlla il risultato: Controlla il file di diff per individuare eventuali modifiche che esulano dall'ambito richiesto, quindi riesegui i test pertinenti.
12. Spiegare il codice che non si conosce utilizzando un input concreto
Comprendere una funzione prima di modificarla. Da portare: Il codice vero e proprio e un esempio di input.
C4 · Modello personalizzabile
Spiega questo codice a uno sviluppatore che conosce [CONTESTO] ma non ha familiarità con [LINGUAGGIO O PROGETTO]. Segui questo esempio di input: [INPUT]. Descrivi l’input, i rami rilevanti, i cambiamenti di stato e l’output atteso.

Indica i nomi effettivi delle funzioni e delle espressioni. Distingui ciò che il codice mostra dalle ipotesi relative alle dipendenze mancanti. Concludi con un caso limite che vale la pena testare. Non riscrivere il codice né inventare comportamenti per funzioni le cui definizioni sono assenti.


[INCOLLA CODICE]
Controlla il risultato: Verifica la diramazione descritta e il valore restituito confrontandoli con il codice; contrassegna le dipendenze mancanti come "sconosciute".
Confronto tra i primi risultati · C
Entrambe le funzioni restituite hanno superato tutti i 24 casi.
| Controllo | Istruzioni semplici | Istruzione strutturata |
|---|---|---|
| Casi locali isolati | 24 / 24 | 24 / 24 |
| Modifiche all'interno della funzione "small" | Sì | Sì |
| Affermazione relativa ai test basati su strumenti | Non sussiste alcuna pretesa del genere | Indica esplicitamente che non deve essere eseguita |
Sia la versione "semplice" che quella "strutturata" hanno gestito correttamente le soglie di peso, la spedizione gratuita, il supplemento per località remote e gli input non validi previsti dalle nostre specifiche fisse. La risposta "strutturata" indicava esplicitamente di non aver eseguito i test. Abbiamo quindi eseguito entrambe le funzioni noi stessi; anche la risposta "semplice" non aveva dichiarato di aver effettuato alcuna esecuzione.
Visualizza tutti i 24 input e i risultati effettivi (superato/non superato)
| [grammi, subtotale in centesimi, remoto] | Centi previsti o eccezione | Semplice | Strutturato |
|---|---|---|---|
| [1, 0, false] | 500 | Passa | Passa |
| [1000, 0, false] | 500 | Passa | Passa |
| [1001, 0, false] | 900 | Passa | Passa |
| [5000, 0, false] | 900 | Passa | Passa |
| [5001, 0, false] | 1500 | Passa | Passa |
| [1, 9999, false] | 500 | Passa | Passa |
| [1, 10000, false] | 0 | Passa | Passa |
| [1000, 10000, true] | 300 | Passa | Passa |
| [5001, 0, true] | 1800 | Passa | Passa |
| [1001, 9999, true] | 1200 | Passa | Passa |
| [5001, 10001, false] | 0 | Passa | Passa |
| [0, 0, false] | ValueError | Passa | Passa |
| [-1, 0, false] | ValueError | Passa | Passa |
| [1,0, 0, false] | ValueError | Passa | Passa |
| ["1000", 0, false] | ValueError | Passa | Passa |
| [vero, 0, falso] | ValueError | Passa | Passa |
| [null, 0, false] | ValueError | Passa | Passa |
| [1, -1, false] | ValueError | Passa | Passa |
| [1, false, false] | ValueError | Passa | Passa |
| [1, 1,5, false] | ValueError | Passa | Passa |
| [1, "0", false] | ValueError | Passa | Passa |
| [1, 0, 1] | ValueError | Passa | Passa |
| [1, 0, null] | ValueError | Passa | Passa |
| [0, 10000, false] | ValueError | Passa | Passa |
Gli input e i risultati attesi sono stati definiti prima della generazione. I valori restituiti dovevano essere numeri interi esatti; gli input non validi dovevano generare un'eccezione ValueError. Entrambe le funzioni sono state verificate e poi eseguite in un processo locale con accesso alla rete, lettura dei file utente e scrittura sui file disabilitate. Il superamento di questi test costituisce una prova della validità della funzione e delle specifiche, ma non una dichiarazione di idoneità all'uso in produzione.
Tempo trascorso: 12,58 s / 13,30 s. Token di input e output riportati: 553 + 735 / 621 + 1015. Una risposta per ciascuno; nessun tentativo di ripetizione.
Istruzioni semplici — istruzioni complete e materiale di riferimento
Modifica la funzione in base alle specifiche riportate di seguito e fornisci il risultato richiesto.

# Calcolatore fittizio delle spese di spedizione

Python 3. Nessuna connessione di rete né pacchetti esterni. Modifica la funzione `shipping_cents(weight_grams, subtotal_cents, remote=False)` nel codice riportato di seguito.

Specifiche:
- weight_grams è un numero intero positivo. subtotal_cents è un numero intero non negativo. I valori booleani di Python non sono considerati numeri interi validi per questi due parametri.
- remote deve essere un valore booleano.
- Generare un'eccezione ValueError per qualsiasi input non valido, anche quando l'ordine soddisfa i requisiti per la spedizione base gratuita.
- La spedizione base è di 500 centesimi per 1–1000 grammi, 900 centesimi per 1001–5000 grammi e 1500 centesimi oltre i 5000 grammi.
- Un subtotale di almeno 10000 centesimi esenta solo dalla spedizione base.
- La consegna in località remote aggiunge 300 centesimi, compresi gli ordini con spedizione base gratuita.
- Restituisci un numero intero. Mantieni la firma della funzione. Non modificare i dati di input, non eseguire operazioni di I/O né importare pacchetti.

Codice errato:
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if subtotal_cents >= 10000:
 return 0
    if weight_grams < 1000:
 fee = 500
    elif weight_grams < 5000:
 fee = 900
    else:
 fee = 1500
    if remote:
 fee += 300
    return fee
```

Risultato atteso: un blocco Python racchiuso tra le parentesi contenente la funzione corretta, seguito da una breve spiegazione delle modifiche. Non dichiarare di aver eseguito il codice a meno che non si disponga effettivamente degli strumenti di esecuzione. Il valutatore eseguirà casi che coprono le soglie, la regola della spedizione gratuita, il supplemento per le spedizioni a distanza e tutte le categorie di input non validi presenti in questa specifica.
Istruzioni semplici — risposta originale completa
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if isinstance(weight_grams, bool) or not isinstance(weight_grams, int):
 raise ValueError("weight_grams deve essere un numero intero")
    if peso_grammi <= 0:
 raise ValueError("peso_grammi deve essere positivo")
    if isinstance(totale_cents, bool) or not isinstance(totale_cents, int):
        raise ValueError("subtotal_cents deve essere un numero intero")
    if subtotal_cents < 0:
 raise ValueError("subtotal_cents deve essere non negativo")
    if not isinstance(remote, bool):
        raise ValueError("remote deve essere un valore booleano")

 se weight_grams <= 1000:
 fee = 500
    elif weight_grams = 10000:
 fee = 0

 if remote:
 fee += 300

 return fee
```

Modifiche apportate:
1. **Aggiunta la validazione degli input**: Verifica che `peso_in_grammi` e `totale_parziale_in_centesimi` siano di tipo `int` (escludendo `bool`, poiché `bool` è una sottoclasse di `int`), che `peso_in_grammi` sia positivo, `totale_parziale_in_centesimi` sia non negativo e `spedizione_remota` sia un `bool`. In caso contrario, genera un `ValueError`, anche se l’ordine avrebbe diritto alla spedizione gratuita.
2. **Soglie di peso corrette**: Modificati `< 1000` e `< 5000` in `<= 1000` e `<= 5000`, in modo che i limiti (1000 g, 5000 g) rientrino nella fascia corretta secondo le specifiche ("1–1000 grammi", "1001–5000 grammi", "oltre 5000 grammi").
3. **Correzione della logica per la spedizione gratuita**: il codice originale restituiva immediatamente `0` quando il subtotale era idoneo alla spedizione gratuita, saltando completamente il supplemento per la consegna in località remote. Ora viene calcolata prima la tariffa base, azzerata se il subtotale soddisfa i requisiti, e *solo allora* viene aggiunto il supplemento per le zone remote — garantendo che la consegna in zone remote comporti comunque un costo di 300 centesimi anche con spedizione base gratuita.
4. **Tipo di ritorno**: Tutti i valori delle tariffe rimangono semplici numeri interi (int), soddisfacendo il requisito di ritorno `int`.
Istruzioni strutturate — istruzioni complete e materiale di riferimento
Correggi la funzione in base alle specifiche complete. Applica la convalida degli input prima di qualsiasi ritorno anticipato, mantieni le soglie inclusive e separa la tariffa base dal supplemento per la spedizione a distanza. Fornisci la funzione richiesta e la relativa spiegazione. Riporta solo le verifiche che hai effettivamente eseguito.


# Calcolatore di spedizione fittizio

Python 3. Nessuna connessione di rete né pacchetti esterni. Correggi la funzione shipping_cents(weight_grams, subtotal_cents, remote=False) nel codice riportato di seguito.

Specifiche:
- weight_grams è un numero intero positivo. subtotal_cents è un numero intero non negativo. I valori booleani di Python non sono considerati numeri interi validi per questi due input.
- remote deve essere un valore booleano.
- Generare un ValueError per qualsiasi input non valido, anche quando l’ordine ha diritto alla spedizione base gratuita.
- La spedizione base è di 500 centesimi per 1–1000 grammi, 900 centesimi per 1001–5000 grammi e 1500 centesimi oltre i 5000 grammi.
- Un subtotale di almeno 10.000 centesimi esenta solo dalla spedizione base.
- La consegna in località remota aggiunge 300 centesimi, compresi gli ordini con spedizione base gratuita.
- Restituisci un numero intero. Mantieni la firma della funzione. Non modificare i dati di input, non eseguire operazioni di I/O né importare pacchetti.

Codice errato:
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if subtotal_cents >= 10000:
 return 0
    if weight_grams < 1000:
 fee = 500
    elif weight_grams < 5000:
 fee = 900
    else:
 fee = 1500
    if remote:
 fee += 300
    return fee
```

Risultato richiesto: un blocco recintato in Python contenente la funzione corretta, seguito da una breve spiegazione delle modifiche. Non dichiarare di aver eseguito il codice a meno che non si disponga effettivamente degli strumenti di esecuzione. Il valutatore eseguirà casi che coprono le soglie, la regola della spedizione gratuita, il supplemento per le spedizioni a distanza e tutte le categorie di input non validi presenti in questa specifica.
Istruzione strutturata — risposta originale completa
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if isinstance(weight_grams, bool) or not isinstance(weight_grams, int):
        raise ValueError("weight_grams deve essere un numero intero (non un valore booleano)")
    if weight_grams <= 0:
 raise ValueError("weight_grams deve essere positivo")
    if isinstance(subtotal_cents, bool) or not isinstance(subtotal_cents, int):
 raise ValueError("subtotal_cents deve essere un numero intero (non un valore booleano)")
    if subtotal_cents < 0:
 raise ValueError("subtotal_cents deve essere un numero non negativo")
    if not isinstance(remote, bool):
 raise ValueError("remote deve essere un valore booleano")

    se weight_grams <= 1000:
 base_fee = 500
    elif weight_grams = 10000:
 base_fee = 0

 surcharge = 300 if remote else 0

 return base_fee + surcharge
```

Spiegazione delle modifiche:

1. **La convalida degli input è stata spostata prima di qualsiasi ritorno anticipato.** Il codice originale restituiva `0` per `subtotal_cents >= 10000` senza prima convalidare alcun input. Ora tutte le convalide (controlli di tipo per `weight_grams`, `subtotal_cents` e `remote`, inclusa l’esclusione esplicita del tipo `bool` per i due campi interi poiché `bool` è una sottoclasse di `int` in Python) avvengono prima di qualsiasi logica relativa alle spese o istruzione di ritorno, quindi gli input non validi generano sempre un `ValueError` anche quando l’ordine sarebbe altrimenti idoneo alla spedizione base gratuita.

2. **Soglie inclusive corrette.** Il codice originale utilizzava `< 1000` e `< 5000`, il che escludeva i valori limite (1000 e 5000) dall’intervallo inferiore, contrariamente alle specifiche "1–1000 grammi" e "1001–5000 grammi", intervalli inclusivi. Modificato in `<= 1000` e `= 10000`, il che ometteva erroneamente il supplemento per la consegna a distanza per gli ordini con spedizione gratuita. Ora `base_fee` e `surcharge` vengono calcolati in modo indipendente: `base_fee` viene impostata a `0` quando viene raggiunta la soglia del subtotale, ma `surcharge` (300 centesimi se `remote`) viene sempre aggiunta in più, in linea con la regola "La consegna a lunga distanza aggiunge 300 centesimi, compresi gli ordini con spedizione base gratuita".

4. **Tipo di ritorno.** Tutte le componenti della commissione sono semplici numeri interi, e la somma `base_fee + surcharge` viene restituita come `int`, in linea con la firma e il tipo di ritorno richiesti.

**Verifica effettivamente eseguita:** Nessuna — Non dispongo di strumenti per l’esecuzione del codice in questo ambiente, quindi non ho eseguito questo codice. Quanto sopra si basa esclusivamente sulla lettura manuale delle specifiche e sul tracciamento manuale della logica; non ho eseguito casi di test su di esso.
Per i lavori che combinano la programmazione con attività relative a testo, immagini o video, è possibile Collegare la CLI del GlobalGPT al codice del Claude e integrare il modello e le funzioni multimediali della piattaforma nel flusso di lavoro del terminale. Inizia con un’attività ben definita e con i criteri di verifica che utilizzerai per accettare il risultato.
Cosa è cambiato quando abbiamo reso più specifici i suggerimenti?
In questa fase, una struttura più articolata ha aiutato a formulare un giudizio di ricerca. Tuttavia, non ha eliminato la promessa aggiuntiva contenuta nell'e-mail né ha migliorato la funzione di spedizione, che era già corretta. Poiché entrambe le versioni hanno ricevuto requisiti completi, il confronto costituisce un utile promemoria: la qualità del brief è fondamentale prima di iniziare ad aggiungere ulteriori istruzioni.
Risultati degli esempi accoppiati
Compiti diversi richiedono controlli diversi.
| Misura specifica per attività | Istruzioni semplici | Istruzione strutturata | Cosa fare con il risultato |
|---|---|---|---|
| Fatti e impegni | 8 su 9 | 8 su 9 | Eliminare le promesse di seguito inventate |
| Verifica dei risultati della ricerca | 6 di 8 | 7 di 8 | Correggere l'etichetta della prova e confrontare i denominatori |
| Casi di comportamento di Python | 24 su 24 | 24 su 24 | Mantenere una specifica funzionante e test indipendenti |
Si tratta di conteggi ricavati da diverse liste di controllo, non di percentuali comparabili né di un punteggio complessivo del modello. Le istruzioni complete, le risposte originali e i dettagli del test sono riportati sotto ciascun esempio. I tempi di esecuzione singola e il conteggio dei token descrivono queste richieste; non indicano un vantaggio in termini di velocità o di costo.
Utilizza una breve descrizione quando il compito e il materiale di riferimento sono già chiari. Aggiungi una struttura quando le istruzioni, i documenti, gli esempi o i requisiti contrastanti diventano difficili da distinguere. Le linee guida di Anthropic distinguono inoltre i comportamenti specifici di ciascun modello, quindi la vecchia abitudine di richiedere ripetuti autocontrolli non dovrebbe diventare un'aggiunta automatica a ogni richiesta.
Come correggere un prompt che fornisce una risposta poco convincente
Modifica la parte che ha causato il problema. Se la risposta ha fissato una scadenza, dire “migliora questo” è troppo generico. Indica il dettaglio non supportato, specifica i limiti e chiedi una correzione mirata. Mantieni la risposta originale se stai confrontando diverse versioni del prompt, invece di sostituirla senza avvisare.
| Cosa è andato storto | Cosa fornire o modificare | Un utile approfondimento |
|---|---|---|
| La risposta è generica | Un lettore, un compito concreto e materiale reale | Riscrivi il testo per [pubblico] utilizzando esclusivamente questi dettagli: [sintesi]. |
| La voce suona strana | Un esempio di un tuo testo | Rispetta il ritmo e il tono formale di questo esempio; mantieni i fatti riportati nella nuova memoria. |
| Aggiunge una promessa | Un limite esplicito e la frase incriminata | Eliminare l'impegno successivo. La fonte non lo autorizza. |
| La citazione sembra plausibile | Il brano effettivamente citato | Questo brano conferma l'affermazione nella sua interezza, solo in parte o per nulla? |
| Le due percentuali sembrano simili | Definizioni, denominatori, popolazioni, periodo | Prima di confrontare i tassi, indica per quale numero viene divisa ciascuna percentuale. |
| Il codice sembra corretto, ma non funziona | Un input errato riproducibile e il risultato atteso | Questo input dovrebbe restituire [valore], ma restituisce [valore]. Correggi la regola ed esegui questo caso. |
Nel caso di un requisito effettivamente mancante, Claude dovrebbe porre una domanda mirata. Per un’attività ordinaria con un contesto sufficientemente chiaro, un colloquio obbligatorio di venti domande non fa altro che rallentare il lavoro. Allo stesso modo, è preferibile richiedere una spiegazione concisa, prove o risultati di test piuttosto che una trascrizione del ragionamento interno privato.
Salva i suggerimenti utili insieme al formato di inserimento dei dati e ai controlli che hanno individuato gli errori. Se l'attività diventa un flusso di lavoro ripetibile dell'applicazione, utilizzando Claude tramite un'API ti offre uno spazio in cui gestire le versioni dei prompt e conservare i registri delle richieste. Ricontrolla i tuoi esempi quando cambiano i requisiti del modello o dell'attività.
FAQ
Cosa dovrebbe includere un buon prompt Claude?
Includi l'attività, il contesto pertinente o il materiale di riferimento, i vincoli importanti, il risultato desiderato e una verifica del corretto esito. Nel caso di una richiesta semplice, una sola frase può coprire diversi di questi elementi. Adotta una struttura più articolata quando combini documenti, esempi o regole che altrimenti potrebbero creare confusione.
I prompt Claude richiedono l'uso di tag XML?
No. Un linguaggio chiaro e semplice è un utile punto di partenza. I tag XML possono aiutare a distinguere le istruzioni, gli esempi e il testo di partenza in un prompt complesso. Utilizzate etichette descrittive che rendano le parti più facili da seguire. I tag non garantiscono l'accuratezza dei fatti e la loro semplice presenza non basta a stabilire che un prompt sia migliore di un altro.
Claude è in grado di controllare le fonti che non riesce ad aprire?
È in grado di analizzare il testo fornito, ma il titolo o l'URL di una fonte non sono sufficienti per stabilire il contenuto di una pagina. Incolla il passaggio pertinente oppure utilizza gli strumenti di navigazione disponibili per recuperarlo. Verifica quindi sia la citazione che la fondatezza dell'affermazione ad essa associata.
Posso usare lo stesso prompt sia nella chat di Claude che in Claude Code?
È possibile riutilizzare l'attività e i vincoli, ma occorre adattare la richiesta agli strumenti disponibili. Nella chat, fornire il codice e il contesto pertinente. In Claude Code, è possibile fare riferimento ai file di progetto accessibili e richiedere l'esecuzione. Un prompt che recita “esegui i test” non costituisce prova che i test siano stati effettivamente eseguiti.
I migliori prompt Claude sono quelli che puoi adattare e verificare. Inizia con un’attività ricorrente, sostituisci il materiale di esempio con il tuo e utilizza i controlli riportati accanto al modello prima di fidarti della risposta. Prova il flusso di lavoro in GlobalGPT quando il passo successivo richiede un altro modello o strumento di intelligenza artificiale nello stesso spazio di lavoro.
Fonti e data del test: I prompt ufficiali e la documentazione relativa al codice Claude sono stati verificati il 14 settembre 2026. Gli esempi abbinati sono stati generati con Claude in GlobalGPT in quella data utilizzando materiale di fantasia. Esamina i prompt e le risposte completi riportati sopra, quindi adatta un modello al tuo compito specifico.