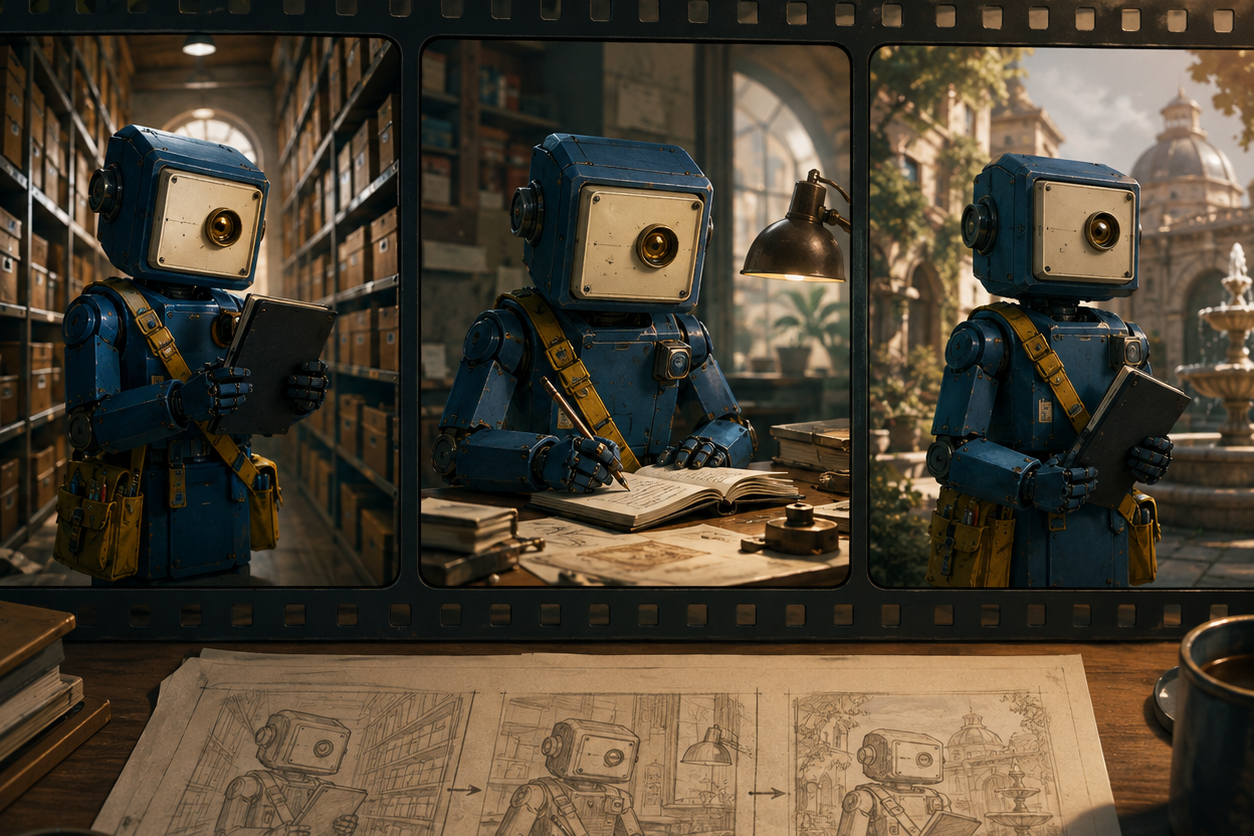
La coerenza video nell’ambito dell’intelligenza artificiale significa che un personaggio, i suoi tratti distintivi, gli oggetti di scena significativi e la logica visiva di una singola inquadratura mantengano il loro senso anche nell’inquadratura successiva. Il metodo più sicuro non consiste nel realizzare un unico grande prompt. È meglio creare un piccolo pacchetto di continuità, realizzare brevi riprese, ciascuna dedicata a un’attività specifica, e verificare il passaggio tra una ripresa e l’altra prima di passare alla clip successiva.
Ecco perché userei Video GlobalGPT per questo flusso di lavoro. Inizia con un riferimento del personaggio in Image, trasferisci lo stesso brief in Video, quindi scegli il percorso più adatto alla ripresa. Seedance, Veo, Kling e altre opzioni video sono disponibili nello stesso spazio di lavoro, in modo che il pacchetto di continuità rimanga vicino alle clip invece di dover essere ricostruito su strumenti separati. Il montatore tradizionale continua a assemblare le riprese approvate.
Cosa significa realmente la coerenza dei video generati dall'IA
Una scena può sembrare accattivante e tuttavia non rispettare la continuità. Un pannello che raffigura un volto può cambiare forma, una borsa può trasformarsi in un libro oppure un personaggio può allontanarsi nella direzione sbagliata. Considera la continuità come quattro elementi correlati: identità, riferimento, regola dell’inquadratura e passaggio di testimone.
I quattro controlli di continuità
Crea il pacchetto di continuità prima della prima clip
Scrivi il profilo del personaggio una volta sola, poi copia alla lettera la parte fissa. Modifica l’ambientazione, l’azione e la prospettiva, ma non l’identità fondamentale del personaggio.
- Risolto: volto o sagoma, tavolozza di colori, abbigliamento caratteristico e un oggetto di scena.
- Flessibile: luogo, condizioni meteorologiche, azione e distanza dell'obiettivo.
- È necessario indicare: due o tre elementi che devono essere visibili in questo specifico fotogramma.
Pacchetto di continuità riutilizzabile
Personaggio: [elementi identificativi fissi nello stesso ordine].
Da mostrare: [due o tre elementi visibili].
Scena: [nuova ambientazione e illuminazione].
Azione: [un’azione chiara che coinvolga un oggetto di scena chiave].
Ripresa: [un’indicazione relativa all’inquadratura e al movimento].
Utilizzare il flusso di lavoro in GlobalGPT
- Utilizzo Immagine per creare una referenza al personaggio di facile lettura.
- Salva l'immagine approvata e copia il pacchetto di caratteri corretto senza modificarlo.
- Vai a Video, selezionare un percorso disponibile e, se presente, utilizzare il comando di riferimento.
- Per prima cosa, riprendi una inquadratura di riferimento, poi controlla i punti chiave da non tralasciare prima di cambiare location o angolazione di ripresa.
- Per la clip seguente, definisci il passaggio di scena: posa, direzione, posizione degli oggetti di scena e tipo di illuminazione.
Per la fase relativa all'immagine, consulta questo flusso di lavoro basato su immagini di riferimento per garantire la coerenza dei personaggi nelle diverse scene. Il passaggio di consegne è il momento in cui una semplice indicazione si trasforma in un flusso di lavoro di produzione: registrare la direzione di uscita, l’ultima posa, la posizione degli oggetti di scena e la famiglia di luci prima di dare indicazioni per la clip successiva.
Cosa hanno rivelato i quattro primi filmati
Si tratta dei primi risultati validi ottenuti da un pacchetto robotico fittizio "congelato", non da una classifica dei modelli. A ciascun percorso è stato richiesto di generare, tramite Anywhere, un filmato di cinque secondi in formato 16:9 a 480p. È stato selezionato il primo risultato riproducibile.
C01: Inquadratura dell’ancora
MARA-9 percorre una corsia della biblioteca. Inquadratura laterale a figura intera, a media distanza.- Percorso: Seedance 2.0 tramite Anywhere
- Uscita: primo file MP4 valido della durata di 5 secondi; richiesto in formato 16:9 e 480p
- Cosa è rimasto: corpo color cobalto, pannello color crema, lente color ambra, fascia gialla.
- Limite: Il taccuino in grafite non era chiaramente leggibile.
C02: Azione con oggetti di scena in un nuovo contesto
MARA-9 apre il taccuino di grafite su un tavolo da restauro.- Percorso: Seedance 2.0 tramite Anywhere
- Uscita: primo file MP4 valido della durata di 5 secondi; richiesto in formato 16:9 e 480p
- Cosa è rimasto: robot centrale, lente e fascia gialla.
- Limite: Il taccuino si trasformò in un grande libro aperto.
C03: Inquadratura ampia con spostamento laterale
All'alba, MARA-9 attraversa un cortile lastricato all'aperto.- Percorso: Seedance 2.0 tramite Anywhere
- Uscita: primo file MP4 valido della durata di 5 secondi; richiesto in formato 16:9 e 480p
- Cosa è rimasto: corpo color cobalto, fascia gialla, trasportava un oggetto rettangolare.
- Limite: Il pannello frontale quadrato color crema si è trasformato in una testa allungata simile a quella di un binocolo.
C04: Percorso alternativo verificato
MARA-9 ripete la ripresa di riferimento della libreria utilizzando lo stesso pacchetto fisso.- Percorso: Seedance 2.0: velocità elevata ovunque
- Uscita: primo file MP4 valido della durata di 5 secondi; richiesto in formato 16:9 e 480p
- Cosa è rimasto: corpo in cobalto, lente quadrata, lente color ambra, fascia gialla.
- Limite: Il taccuino non era ancora ben visibile.
Risolvere i problemi più comuni di coerenza nei video generati dall'IA
- L'oggetto cambia forma: Indica il materiale e la forma, rendili parte integrante dell'azione e chiedi che l'inquadratura sia libera da ostacoli.
- I cambiamenti del viso da una nuova prospettiva: utilizzare prima un'inquadratura di riferimento media, quindi mantenere alla lettera gli elementi di riferimento e i dettagli del volto.
- Il guardaroba scompare: trasformalo in un elemento visivo che ne definisca la sagoma, non in un minuscolo dettaglio nascosto da un'inquadratura ravvicinata.
- Il taglio sembra sbagliato: assicurati che la direzione di uscita, la posa finale, il tipo di illuminazione e la posizione degli oggetti di scena corrispondano prima di generare la clip successiva.
Quando la questione riguarda la durata piuttosto che l'identità, consulta questo articolo Guida per allungare i video Sora 2.
FAQ
Che cos’è la coerenza dei video generati dall’intelligenza artificiale?
È la capacità di garantire che i personaggi, gli oggetti di scena, la logica dell’ambientazione e la direzione dei movimenti rimangano riconoscibili da una ripresa all’altra, grazie a un approccio standardizzato e a una revisione fotogramma per fotogramma.
Come faccio a mantenere lo stesso personaggio nei video generati dall'IA?
Se disponibile, utilizzare la stessa immagine di riferimento, copiare il pacchetto di identità già definito senza riscriverlo e rendere visibili gli elementi chiave in ogni inquadratura.
Le immagini di riferimento migliorano la coerenza dei video generati dall’IA?
Possono fungere da punto di riferimento per il volto, la tavolozza dei colori e il guardaroba, ma non garantiscono che ogni elemento significativo rientri nell’inquadratura. Adotta anche una regola sui dettagli imprescindibili.
Perché un personaggio di un video generato dall'intelligenza artificiale cambia abito o perde un oggetto di scena?
Il modello può dare priorità all'azione o allo scenario, e la fotocamera può escludere l'oggetto dall'inquadratura. Inserisci l'oggetto nell'azione e richiedi una composizione in cui sia visibile.
Come faccio a mantenere lo sfondo uniforme nei video generati dall'intelligenza artificiale?
Mantieni costanti la descrizione della location, la famiglia di luci e la direzione di movimento nelle clip adiacenti. Modifica una sola variabile principale della scena alla volta.
Posso correggere un video dell'IA che presenta un'incongruenza senza dover ricominciare da capo?
Sì. Individuare la ripresa mancante nel registro delle riprese, conservare il montaggio approvato e rigenerare solo quella clip con un’azione più serrata e una regolazione della telecamera più precisa.