
Il Lunar Foundation Model della NASA e IBM è un modello di intelligenza artificiale aperto destinato all'analisi delle osservazioni lunari. Annunciato il 10 settembre 2026, può essere adattato per individuare crateri, delineare caratteristiche vulcaniche e prevedere modelli in una mappa di potenzialità ghiacciaria. I vantaggi riportati riguardano specifici parametri di riferimento della ricerca: il risultato principale relativo al ghiaccio è un minore errore di previsione, non la scoperta di una maggiore quantità d'acqua sulla Luna.
Per studenti e ricercatori, i punti di partenza utili sono i scheda tecnica ufficiale, il rapporto tecnico e il codice reso pubblico. Insieme spiegano cosa ha appreso il modello, quali compiti sono stati valutati e cosa occorre per realizzare un proprio esperimento.
Se il primo passo è comprendere la ricerca, GlobalGPT riunisce la ricerca delle fonti, l’analisi dei documenti, il ragionamento e la redazione in un unico spazio di lavoro multimodello. Offre un modo conveniente per passare da termini scientifici poco familiari a un chiaro documento di sintesi della ricerca tramite un unico abbonamento.

Che cos’è il Lunar Foundation Model della NASA e IBM?
L'annuncio della NASA presenta il progetto come un modello di base per la scienza lunare, sviluppato in collaborazione con IBM. Un modello di base apprende schemi riutilizzabili da un’ampia raccolta di dati; i ricercatori adattano poi tali schemi a un compito più specifico. In questo caso, il materiale di riferimento è costituito dai dati di telerilevamento lunare anziché dal linguaggio quotidiano.
L'LFM della NASA-IBM utilizza un codificatore e un decodificatore basati su Vision Transformer, con un'architettura ViT-B. I suoi input comprendono immagini e altri prodotti di osservazione con diverse risoluzioni spaziali. Uno scienziato può adattare la rappresentazione risultante per il rilevamento, la segmentazione o la regressione: tre modi per individuare oggetti, delineare regioni e prevedere valori numerici.
Ciò rende questa versione utile ai team che lavorano sulle mappe lunari e agli studenti che si occupano di machine learning planetario. La lettura del progetto è inoltre utile per chiunque voglia comprendere come viene valutato un modello di IA scientifica. L’utilizzo del suo checkpoint, tuttavia, rientra in un flusso di lavoro di calcolo scientifico piuttosto che in una conversazione via chat.
Da quali dati apprende?
Il scheda del modello descrive i dati di addestramento di SomBench: 963.609 gruppi di tessere della telecamera grandangolare (WAC) e 1.000.113 gruppi della telecamera ad angolo stretto (NAC). La scala delle WAC è di circa 100 metri per pixel; quella delle NAC è di circa 1 metro per pixel. Ciò fornisce al modello sia un contesto territoriale più ampio sia dettagli superficiali molto più precisi, su un totale di circa due milioni di bundle.
IBM descrive la risorsa di dati in senso lato costituito da oltre 30 livelli allineati provenienti da nove strumenti nell’ambito di quattro missioni. La scheda del modello specifica 11 modalità di input. Queste figure descrivono le diverse fasi della pipeline di dati: livelli sorgente, esempi di addestramento raggruppati e tipi di input codificati dal modello.
Un progetto, tre diverse unità di misura
IBM descrive una risorsa di dati costituita dai dati raccolti da nove strumenti nel corso di quattro missioni.
I 963.609 pacchetti WAC e i 1.000.113 pacchetti NAC offrono due livelli di materiale didattico.
Il modello integra diversi tipi di osservazioni, tra cui immagini satellitari e dati topografici.
I livelli delle sorgenti, i pacchetti di tessere e le modalità di input si riferiscono a elementi diversi. Sorgenti: Descrizione del set di dati di IBM e il scheda tecnica ufficiale.
Anche l’illuminazione fa parte del progetto. Il modello riceve la geometria di osservazione, compresi gli angoli di illuminazione, come contesto esplicito. Ciò aiuta a distinguere l’aspetto di una superficie sotto una determinata illuminazione dai modelli del terreno sottostanti che sta apprendendo.
Un pixel che rappresenta circa 100 metri di terreno non può rivelare gli stessi dettagli di un pixel che rappresenta circa 1 metro. Ecco perché i risultati relativi ai crateri WAC e NAC meritano un’attenzione a parte. Un miglioramento nelle immagini su larga scala non garantisce lo stesso miglioramento per le piccole caratteristiche superficiali.
Il progetto segue l'approccio di pre-addestramento di TerraMind, ma si basa su dati lunari partendo da zero. Va quindi inteso come un modello creato appositamente per le osservazioni lunari, piuttosto che come una versione ribattezzata del modello di osservazione terrestre. La domanda fondamentale è: in che modo la rappresentazione appresa da questo modello contribuisce a un particolare compito legato alla Luna?.
Tre attività che può supportare
Le valutazioni pubblicate riguardano tre famiglie di compiti. Ciascuna produce un tipo diverso di risposta, quindi il significato di “migliore” varia a seconda del compito.
| Compito | Uscita | Cosa può supportare il risultato |
|---|---|---|
| Rilevamento dei crateri | Riquadri di delimitazione attorno ai crateri nelle immagini WAC o NAC | Confronto dell'efficacia con cui un rilevatore individua e localizza i crateri contrassegnati. |
| Segmentazione irregolare della macchia della cavalla | Un profilo a livello di pixel delle caratteristiche della superficie vulcanica | Analizzare in che misura le regioni previste corrispondono ai confini delle caratteristiche etichettate. |
| Regressione della potenzialità ghiacciaria polare | Una previsione continua di una mappa prospettica basata sulla conoscenza | Analisi della corrispondenza con un obiettivo modellizzato per possibili condizioni legate al ghiaccio. |
Il rilevamento dei crateri e la segmentazione delle caratteristiche vulcaniche possono aiutare i ricercatori a organizzare e analizzare le immagini. La loro utilità dipende dalle etichette, dalla scala e dall’area di valutazione. Un modello che offre buone prestazioni su un insieme di test definito deve comunque essere valutato in relazione ai dati e alle questioni scientifiche di un nuovo progetto.
La potenzialità del ghiaccio richiede un’interpretazione estremamente accurata. L'obiettivo è quello di ottenere una mappa basata sulle conoscenze scientifiche che indichi dove potrebbe esserci del ghiaccio, non una misurazione diretta dei depositi di ghiaccio. Una maggiore corrispondenza con tale mappa può favorire la ricerca sui modelli e sulle regioni candidate. Ciò non significa che sia stata individuata una quantità aggiuntiva di acqua.
Cosa significano i risultati dei test di benchmark
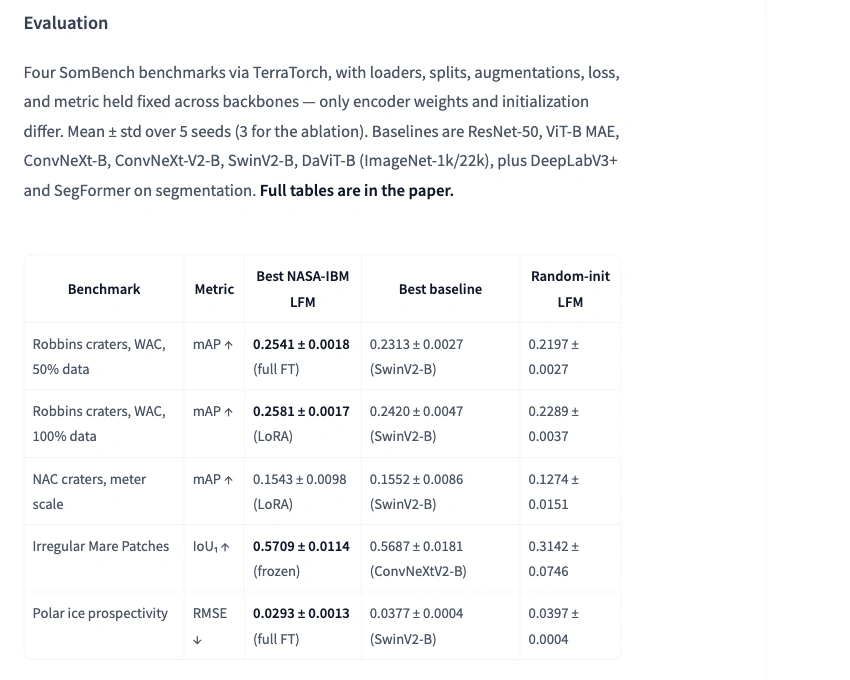
Il relazione tecnica fornisce le medie e le deviazioni standard relative a cinque semi casuali. I risultati mettono a confronto configurazioni adattate del modello lunare con modelli di riferimento specifici del modello visivo. Abbiamo verificato le tabelle pubblicate; non abbiamo riprodotto gli esperimenti relativi al modello lunare.
Questi indicatori rispondono a domande diverse. La precisione media (mAP) valuta il rilevamento degli oggetti; l’intersezione sull’unione (IoU) misura la sovrapposizione tra le regioni previste e quelle etichettate; l’errore quadratico medio (RMSE) misura l’errore numerico di previsione. Valori più elevati di mAP e IoU sono migliori, mentre un valore più basso di RMSE è preferibile. Questi indicatori non dovrebbero essere combinati in un unico punteggio di accuratezza.
Errore di prospettività del ghiaccio: il miglioramento più evidente segnalato
L'RMSE è sceso da da 0,0377 a 0,0293 contro SwinV2-B, un 22,31 TP40T riduzione relativa. Un valore RMSE più basso indica una maggiore corrispondenza con la mappa di potenzialità glaciale del benchmark.
RMSE: più è basso, meglio è. Le barre partono da zero. Media ± deviazione standard su cinque campioni. L'obiettivo è una mappa di prospettività modellizzata, non una misurazione del ghiaccio.
| Attività e dati | Sistema metrico ↑ | Modello lunare | Una solida base di partenza |
|---|---|---|---|
| Crateri WAC · Dati di addestramento 50% | mAP | 0,2541 ± 0,0018 messa a punto completa | 0,2313 ± 0,0027 SwinV2-B |
| Crateri WAC · Dati di addestramento 100% | mAP | 0,2581 ± 0,0017 LoRA | 0,2420 ± 0,0047 SwinV2-B |
| Crateri NAC · Dati di addestramento 100% | mAP | 0,1543 ± 0,0098 LoRA | 0,1552 ± 0,0086 SwinV2-B |
| Macchie irregolari sulla giumenta | IoU1 | 0,5709 ± 0,0114 encoder bloccato | 0,5687 ± 0,0181 ConvNeXtV2-B |
Gli autori descrivono i risultati relativi ai crateri e alle formazioni vulcaniche su scala metrica come paragonabili a linee di riferimento affidabili. Le lievi differenze riscontrate vanno interpretate alla luce della variazione da esecuzione a esecuzione.
Fonte: Relazione tecnica NASA-IBM, Tabelle 4–7, pagine 16 e 18. Si tratta dei risultati degli autori, non di una riproduzione indipendente.
Il risultato ottenuto con il modello 22% è una riduzione dell'errore
Per quanto riguarda la potenzialità di presenza di ghiaccio, la configurazione lunare più significativa riportata presenta un RMSE pari a 0,0293, contro lo 0,0377 di SwinV2-B. Il calcolo è il seguente: (0,0377 − 0,0293) ÷ 0,0377 × 100 = 22,3%. L'RMSE misura l'errore di previsione rispetto alla mappa di riferimento; un valore più basso è indicativo di una maggiore precisione. Questa percentuale non rappresenta né un punteggio di accuratezza né una variazione della quantità di ghiaccio lunare.
I risultati relativi ai crateri dipendono dalla metrica e dalla scala dei dati
Con 50% dei dati di addestramento WAC, il modello lunare registra un mAP di 0,2541 contro lo 0,2313 di SwinV2-B. Lo stesso risultato del modello lunare supera anche lo 0,2420 del modello di riferimento con 100% di dati di addestramento. Il primo confronto utilizza frazioni di dati uguali; il secondo è una dimostrazione dell’efficienza delle etichette in questo particolare esperimento.
Il miglioramento di circa 19% registrato da IBM può essere riconciliato con i valori AP@75 riportati nel rapporto sui dati di addestramento a 50%: 0,2213 contro 0,1862, con un aumento relativo di 18,9%. L’AP@75 valuta i rilevamenti a una determinata soglia di sovrapposizione. Non dovrebbe essere reinterpretato come un aumento di 19% nella metrica mAP della tabella.
Alla scala NAC più fine, l’mAP del modello lunare è pari a 0,1543, mentre quello del modello di riferimento è pari a 0,1552. Per quanto riguarda le «Irregular Mare Patches», i valori di IoU in primo piano riportati sono 0,5709 e 0,5687 rispetto a ConvNeXtV2-B. Gli autori descrivono questi compiti come paragonabili a baseline di alto livello. Le piccole differenze, insieme alla variazione riportata tra le esecuzioni, non supportano l’affermazione secondo cui il modello lunare sia vincente in ogni caso.
Dove reperirlo e quali sono i costi di accesso
Inizia dalle risorse ufficiali riportate di seguito. I pesi del modello e il codice sono coperti da licenza Apache-2.0, mentre il checkpoint è disponibile pubblicamente. Il repository descrive in particolare un versione di messa a punto e inferenza; esclude espressamente il codice relativo al pre-addestramento.
Scegli la risorsa per il tuo prossimo passo
Inizia con gli usi previsti, i dati di input, le licenze e le limitazioni.
La scheda "File" contiene il checkpoint pubblicato e i file correlati.
Utilizza il file README e le configurazioni delle attività di TerraTorch per pianificare un esperimento.
Segui la raccolta ufficiale per accedere ai modelli e ai set di dati correlati.
Le tabelle da 4 a 7 riportano i risultati delle prove, le impostazioni e le variazioni tra le diverse esecuzioni.
Esplora la versione demo del progetto. In questa revisione non abbiamo eseguito la generazione.
Al momento della verifica, effettuata il 28 settembre 2026, la scheda del modello non riportava alcun Hugging Face Inference Provider implementato. Il checkpoint scaricabile e la pagina dimostrativa sono accessibili tramite percorsi separati.
Se si desidera adattare il modello, selezionare l'attività a valle prima di configurare l'esperimento. Il repository fornisce componenti e configurazioni compatibili con TerraTorch che collegano il checkpoint, l'attività e i dati. TerraTorch è il framework software utilizzato per organizzare il flusso di lavoro di addestramento e valutazione.
- Leggi la scheda del modello e il file README, quindi scegli tra rilevamento, segmentazione o regressione in base alla domanda scientifica.
- Procurarsi i dati corrispondenti e il checkpoint ufficiale, quindi verificare la configurazione delle attività e le istruzioni relative all'ambiente del repository.
- Preparare i dati per quella configurazione ed eseguire il flusso di lavoro di ottimizzazione o di inferenza pertinente.
- Valutare rispetto a un valore di riferimento adeguato e conservare la suddivisione dei dati, le impostazioni e i risultati in modo da poter verificare l'esito.
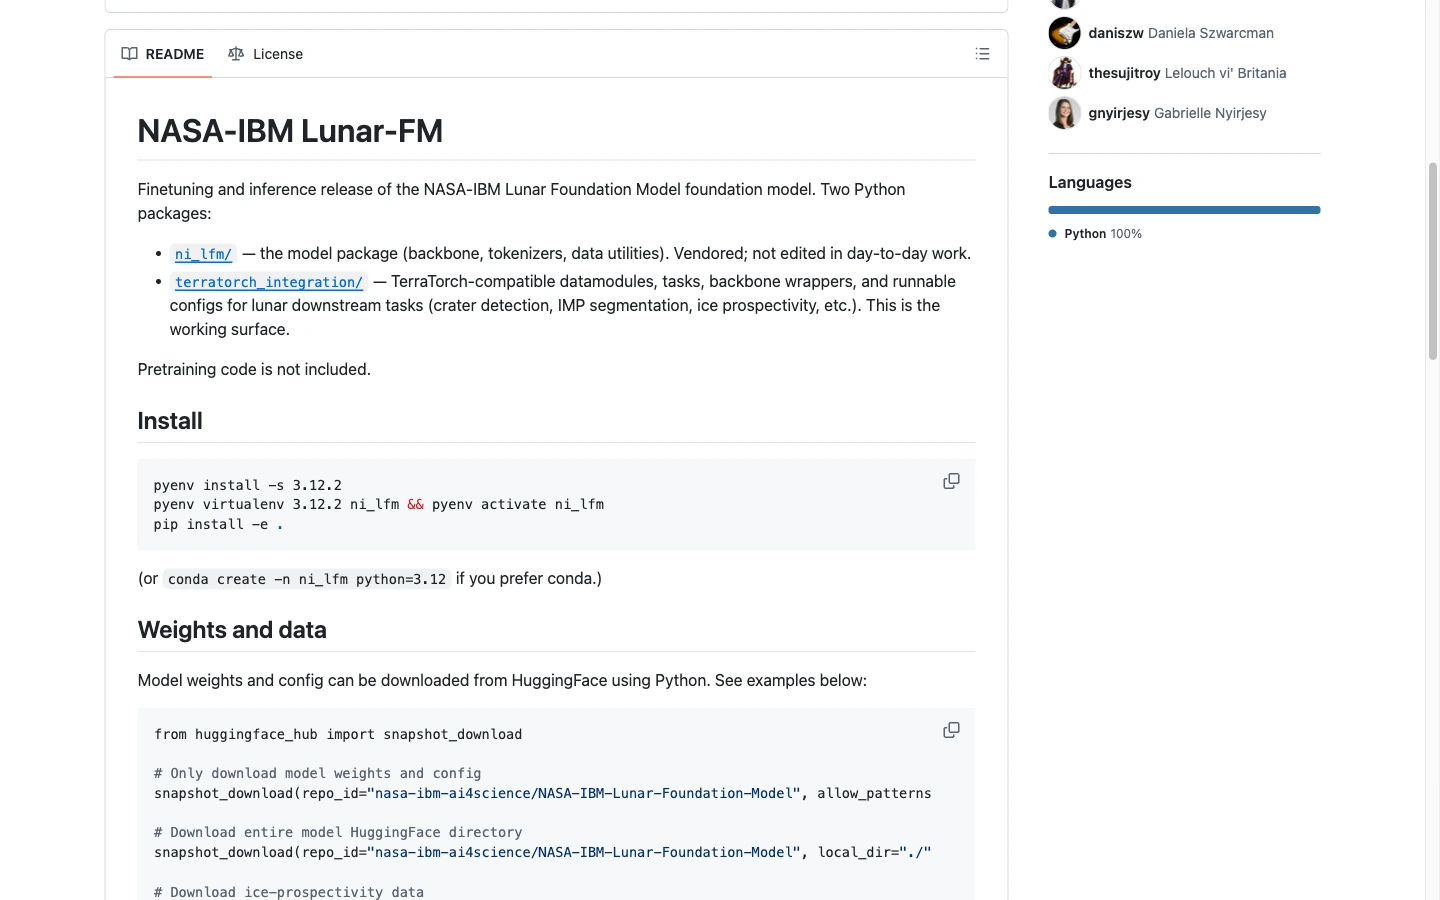
L'accesso aperto elimina l'acquisto della licenza del modello dalla fase iniziale del processo, ma l'esecuzione di un esperimento comporta comunque dei costi. Sono necessarie risorse di calcolo, spazio di archiviazione, preparazione dei dati e tempo per la valutazione. Un checkpoint pubblicato non include automaticamente un'API ospitata o tempo di GPU gratuito, e i codici sorgente non stabiliscono una quantità minima universale di GPU per ogni attività a valle.
| Il tuo obiettivo | Risorse o costi da prevedere |
|---|---|
| Leggi e valuta il comunicato | Comunicati pubblici, scheda del modello, relazione e archivio. |
| Eseguire o adattare il modello scientifico | Risorse di calcolo e archiviazione adeguate, dati pertinenti, configurazione dell’ambiente e attività di valutazione. |
| Comprendere gli articoli scientifici e redigere una sintesi di ricerca | Uno spazio di lavoro per assistenti di ricerca come GlobalGPT, che offre accesso ai modelli e strumenti per la gestione dei documenti in un unico abbonamento. |
Utilizzare l'intelligenza artificiale per comprendere la ricerca
Una prima domanda costruttiva deve essere ben circoscritta: “Cosa misura effettivamente il miglioramento riportato di 22%?” Per rispondere occorre un obiettivo, un indicatore, un valore di riferimento e un calcolo. Chiedere questi quattro elementi è più utile che chiedere a un assistente se il modello sia impressionante.
GlobalGPT ti permette di portare avanti il lavoro di lettura attraverso la ricerca delle fonti, l'analisi dei documenti e la stesura del testo senza dover passare da uno strumento all'altro per ogni fase. Per un metodo ripetibile, redigere una sintesi di ricerca con verifica delle fonti con un breve elenco di fonti e domande precise prima di richiedere una sintesi ben strutturata.
Dalle fonti ufficiali a un utile riassunto informativo
- Raccogliere il materiale di base. Inizia con l'annuncio della NASA, poi aggiungi la scheda del modello, il rapporto tecnico e il file README. Puoi ricerca con Perplexity su GlobalGPT per individuare le fonti a sostegno.
- Poni domande mirate. Chiedi a un assistente di spiegarti separatamente i concetti di mAP, IoU e RMSE, quindi elenca il target, il valore di riferimento e le impostazioni di valutazione relative a ciascuna affermazione.
- Controlla e scrivi. Riapri la tabella citata, verifica ogni dato e trasforma le note che hai controllato in una sintesi che rispetti i limiti scientifici.
Abbiamo testato una versione ridotta di questo flusso di lavoro con GPT-5.6 Sol. Il sistema ha ricevuto un pacchetto di informazioni distillato dalle quattro fonti ufficiali e doveva produrre un breve riassunto, classificare sei affermazioni, calcolare la riduzione dell’RMSE e suggerire i prossimi passi da intraprendere. Il compito si basava su testo fornito; il sistema non ha cercato nuove prove.
Un test di briefing basato sulle fonti
Abbiamo fornito a GPT-5.6 Sol una breve documentazione tratta dal comunicato della NASA, dalla scheda tecnica ufficiale, dal rapporto tecnico e dal file README su GitHub. Il sistema doveva redigere un briefing, verificare sei affermazioni e spiegare il calcolo dell’RMSE.
- Spazio di lavoro e data
- GlobalGPT · 28 settembre 2026
- Applicare la politica
- Un solo compito; prima risposta completa; nessun tentativo aggiuntivo
- Ingresso
- Pacchetto sorgente di 355 parole con quattro ID sorgente
- Ambito di applicazione
- Lettura e sintesi; nessuna ricerca in tempo reale né esecuzione del modello lunare
- Impostazioni di risposta
- Limite dei token in uscita: 4.096; tutti gli altri controlli di campionamento sono stati lasciati ai valori predefiniti del servizio
- Utilizzo e costo
- Sono stati segnalati in totale 2.154 token; la risposta non includeva alcun addebito monetario
La prima risposta ha mantenuto le affermazioni scientifiche entro i limiti del tema
La risposta ha generato un documento informativo di 112 parole, ha respinto l’affermazione secondo cui il modello avesse individuato 22% di ghiaccio reale in più e ha mantenuto le restrizioni relative alla certificazione dei siti di atterraggio e all’accesso al codice di pre-addestramento. I tre passi successivi indicati rimandavano alla scheda ufficiale del modello, al checkpoint e alle risorse di TerraTorch.
Si trattava di un esercizio di lettura basato su materiale fornito. Il pacchetto di riferimento indicava già i limiti principali. Il risultato non è indicativo delle prestazioni in materia di ricerca autonoma o di inferenza tramite telerilevamento lunare.
Visualizza il prompt esatto e il pacchetto di origine
SISTEMA
Sei un redattore scientifico meticoloso che scrive per uno studente universitario. Utilizza esclusivamente il pacchetto di fonti fornito. Non effettuare ricerche aggiuntive. Distingui le misurazioni di benchmark riportate dalle misurazioni scientifiche reali. Cita gli ID delle fonti tra parentesi quadre. Se un’affermazione non è supportata, dillo chiaramente. Non inventare citazioni, prezzi, requisiti hardware o risultati sperimentali. Fornisci la risposta richiesta, senza ragionamenti nascosti.

UTENTE
Trasforma il pacchetto di fonti in una nota di ricerca pratica. Consegna: (1) una sintesi in inglese semplice di 100–130 parole; (2) una tabella di verifica delle affermazioni a sei righe che utilizzi esattamente le diciture “Supportata” o “Non supportata”, un ID della fonte e una spiegazione di una frase per ciascuna affermazione fornita; (3) la relativa riduzione dell’RMSE calcolata da 0,0377 a 0,0293, arrotondata a una cifra decimale, con una formula e una frase che spieghi cosa non misura; (4) tre passi pratici successivi per uno studente che voglia esaminare o adattare il modello pubblicato. La risposta complessiva deve contenere meno di 500 parole.

Affermazioni da verificare:
1. La NASA e IBM hanno annunciato pubblicamente il modello il 10 settembre 2026.
2. L’RMSE relativo alla presenza potenziale di ghiaccio è sceso da 0,0377 per SwinV2-B a 0,0293 per il modello lunare completamente ottimizzato.
3. Il modello ha individuato 22% di ghiaccio d’acqua reale in più sulla Luna.
4. La NASA ha convalidato questo modello ai fini della certificazione dei siti di atterraggio e della valutazione dei rischi.
5. Il rilascio su GitHub include il codice di pre-addestramento.
6. Un checkpoint aperto garantisce che l’elaborazione su GPU e l’inferenza in cloud siano gratuite.

Pacchetto sorgente:
[S1] Annuncio della NASA, 10 settembre 2026.
Titolo: La NASA e IBM lanciano un modello di base di IA per la scienza lunare.
URL: https://science.nasa.gov/science-research/artificial-intelligence-lunar-foundation-model/
La NASA ha annunciato un modello di base per la scienza lunare sviluppato in collaborazione con IBM. È ospitato pubblicamente su Hugging Face, con il codice disponibile su GitHub. Può essere adattato per la mappatura dei crateri, l’identificazione delle caratteristiche vulcaniche e la ricerca sui ghiacci polari.

[S2] Scheda ufficiale del modello NASA-IBM e relazione tecnica, consultate il 28 settembre 2026.
URL della scheda del modello: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
URL del rapporto tecnico: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model/blob/main/NI_LFM_Technical_Report.pdf
La tabella 7 del rapporto (pagina 18) riporta l’errore quadratico medio (RMSE) sul set di test per la regressione della prospettività del ghiaccio. Più basso è, meglio è. Media più/meno deviazione standard su cinque semi casuali: NASA-IBM LFM con ottimizzazione completa, 0,0293 ± 0,0013; SwinV2-B preaddestrato su ImageNet, 0,0377 ± 0,0004. L’obiettivo è una mappa della prospettività del ghiaccio basata sulla conoscenza. Si tratta di risultati di benchmark riportati dagli autori, non di una replica indipendente né di una misurazione diretta del ghiaccio d’acqua.
Tabella 4 (pagina 16), crateri WAC con dati di addestramento 50%: il mAP del bounding box è pari a 0,2541 ± 0,0018 per LFM completamente ottimizzato e a 0,2313 ± 0,0027 per SwinV2-B. Nelle stesse righe, l’AP@75 è rispettivamente pari a 0,2213 ± 0,0028 e 0,1862 ± 0,0041. Queste metriche non devono essere scambiate.

[S3] Scheda ufficiale del modello, Destinazione d’uso / Esclusioni / Limiti.
URL: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
L’uso previsto è il telerilevamento lunare tramite messa a punto o adattamento LoRA per il rilevamento, la segmentazione e la regressione densa. Il modello non è convalidato per la certificazione dei siti di atterraggio o per l’esclusione dei pericoli. I risultati relativi alla presenza potenziale di ghiaccio derivano da una mappa basata su conoscenze, non da misurazioni effettive del ghiaccio. I campi generati sono sondaggi qualitativi, non previsioni scientifiche calibrate. Il modello non mantiene un sistema di riferimento geodetico assoluto. Non è stato valutato al di fuori della Luna. La licenza indicata è Apache-2.0. La pagina non riporta alcuna implementazione di un Inference Provider. Questo pacchetto non garantisce risorse di calcolo GPU gratuite né inferenza ospitata gratuita, né indica requisiti minimi di hardware o il prezzo dell’API ospitata.

[S4] File README ufficiale su GitHub, consultato il 28 settembre 2026.
URL: https://github.com/NASA-IMPACT/NASA-IBM-Lunar-Foundation-Model
Il repository descrive una versione dedicata alla messa a punto e all’inferenza. Il codice di pre-addestramento non è incluso. I pesi e la configurazione possono essere scaricati dal repository ufficiale dei modelli di Hugging Face. Sono forniti moduli dati, attività, wrapper backbone e configurazioni delle attività compatibili con TerraTorch. La messa a punto e il test richiedono i dati, i checkpoint e la configurazione delle attività pertinenti. Il file README riporta una licenza Apache 2.0.
Visualizza la prima risposta completa
## 1. Presentazione

Il 10 settembre 2026 la NASA e IBM hanno annunciato il Lunar Foundation Model. Il rilascio pubblico fornisce i pesi su Hugging Face e il codice di fine-tuning e inferenza su GitHub, con l'obiettivo di svolgere attività di telerilevamento lunare quali la mappatura dei crateri, l'identificazione delle caratteristiche vulcaniche e la ricerca sul ghiaccio polare. Il benchmark riportato sulla prospettività del ghiaccio migliora l’RMSE rispetto a uno SwinV2-B preaddestrato su ImageNet, ma l’obiettivo è una mappa basata sulla conoscenza, non il ghiaccio lunare misurato direttamente. Il risultato è riportato dagli autori su cinque semi casuali e non costituisce una replica indipendente. Il modello è destinato all’adattamento tramite fine-tuning completo o LoRA, ma non è convalidato per la certificazione dei siti di atterraggio o la valutazione dei rischi. Manca il codice di pre-addestramento e la versione rilasciata non promette né risorse di calcolo GPU gratuite né inferenza in cloud. [S1][S2][S3][S4]

## 2. Tabella di verifica delle affermazioni

| Affermazione | Verdetto | Fonte | Spiegazione |
|---|---|---|---|
| 1 | Confermato | [S1] | L’annuncio della NASA è datato 10 settembre 2026 e identifica il modello come un progetto NASA–IBM. |
| 2 | Confermata | [S2] | La tabella 7 riporta valori RMSE pari a 0,0377 per SwinV2-B e 0,0293 per il modello lunare completamente ottimizzato. |
| 3 | Non supportato | [S2] | Le cifre rappresentano errori di benchmark rispetto a una mappa di prospettività basata sulle conoscenze, non misurazioni effettive di ghiaccio d’acqua lunare. |
| 4 | Non supportato | [S3] | La scheda del modello indica esplicitamente che il modello non è convalidato ai fini della certificazione del sito di atterraggio o dell’autorizzazione alla presenza di pericoli. |
| 5 | Non supportato | [S4] | Il repository GitHub fornisce risorse per la messa a punto e l’inferenza, ma esclude il codice di pre-addestramento. |
| 6 | Non supportato | [S3] | Il pacchetto non promette risorse di calcolo GPU gratuite né inferenza in hosting e non riporta alcuna implementazione da parte di un fornitore di inferenza. |

## 3. Riduzione relativa dell’RMSE

\[
\frac{0,0377-0,0293}{0,0377}\times 100 = 22,3\%
\]

Si tratta di una **riduzione relativa del 22,3% dell’RMSE del benchmark riportato dagli autori**; non misura la scoperta di ulteriore ghiaccio d’acqua reale né prestazioni scientifiche validate in modo indipendente. [S2]

## 4. Prossimi passi pratici

1. Leggere gli usi previsti, i limiti e la licenza Apache-2.0 della scheda del modello prima di selezionare un’attività di rilevamento, segmentazione o regressione. [S3]
2. Scaricare il checkpoint ufficiale e la configurazione da Hugging Face, quindi esaminare i wrapper backbone su GitHub e le configurazioni delle attività. [S4]
3. Procurarsi il dataset lunare pertinente e utilizzare i componenti compatibili con TerraTorch forniti per la messa a punto e il test, tenendo presente che il codice di pre-addestramento non è disponibile e che i risultati dei benchmark richiedono una valutazione indipendente. [S2][S4]
Il risultato utile è stato il mantenimento delle distinzioni: errore di riferimento rispetto al ghiaccio rilevato, utilizzo a fini di ricerca rispetto alla certificazione di atterraggio e codice di adattamento rilasciato rispetto al codice di pre-addestramento assente. Poiché tali limiti erano già presenti nel pacchetto sorgente, ciò costituisce la prova del successo dell’attività di lettura e sintesi, non la dimostrazione che un assistente sarebbe in grado di individuare autonomamente ogni avvertenza.
Per un progetto più ampio, organizzare una sessione di ricerca più approfondita con il supporto dell'intelligenza artificiale riguardo a questioni specifiche relative a dati, metodi, valutazione e limiti. Tieni la tabella originale accanto alla bozza e ricontrolla ogni cifra dopo averla modificata. Questa abitudine è più importante della fluidità con cui suona la prima sintesi.
Limiti rilevanti nella pratica
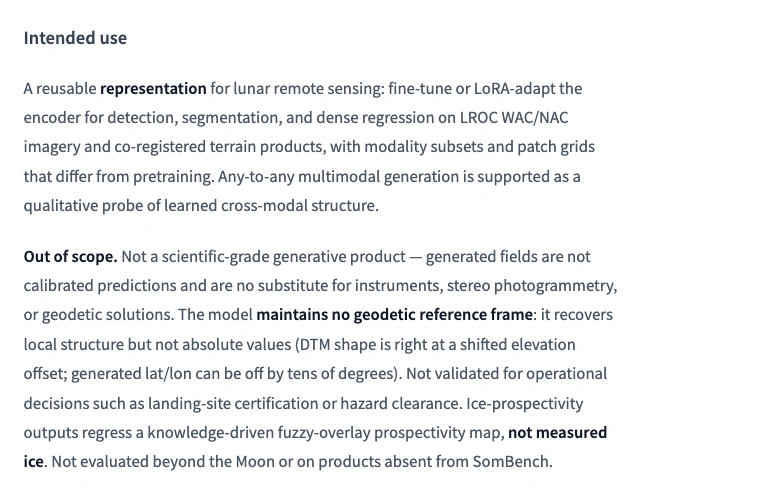
La scheda tecnica indica che il modello lunare non è stato convalidato per decisioni operative quali la certificazione del sito di atterraggio o l'esclusione di pericoli. Un modello scientifico può aiutare ad analizzare le osservazioni senza essere in grado di certificare che un veicolo spaziale possa atterrare in sicurezza in un determinato luogo. Tali utilizzi richiedono un diverso livello di convalida.
Anche i campi generati richiedono cautela. Il modello non mantiene un sistema di riferimento geodetico assoluto e i valori generati possono discostarsi dai valori fisici. Gli autori descrivono la generazione come uno strumento di analisi qualitativa piuttosto che come una previsione scientifica calibrata. Una mappa del terreno o delle osservazioni che appaia plausibile non dovrebbe essere interpretata come un prodotto misurato.
Il checkpoint non è stato valutato al di là della Luna. Anche nell'ambito della ricerca lunare, il quadro di riferimento è contrastante: progressi evidenti in alcune attività e risultati simili in altre. La conclusione che si può trarre è quella di valutare il modello in base all'obiettivo, alla scala, ai dati e alla linea di riferimento che corrispondono al proprio esperimento.
Domande frequenti
Il Lunar Foundation Model della NASA e IBM è di libero utilizzo?
La scheda ufficiale del modello e il repository del codice indicano una licenza Apache-2.0, e il checkpoint è disponibile pubblicamente. L'esecuzione degli esperimenti richiede comunque risorse di calcolo adeguate, la preparazione dei dati e una valutazione specifica per ogni attività. L'accesso aperto al modello non garantisce la disponibilità gratuita di risorse di calcolo su GPU o di inferenza in cloud.
Il Lunar Foundation Model della NASA e IBM è un chatbot?
Si tratta di un modello di base per il telerilevamento lunare, progettato per elaborare immagini, prodotti relativi al terreno e dati di osservazione correlati. I ricercatori lo adattano per attività di rilevamento, segmentazione e regressione. Un assistente di chat può aiutare a spiegare la documentazione, ma interagire con un chatbot rappresenta un flusso di lavoro diverso dall’esecuzione di questo modello.
Il modello ha individuato altra acqua ghiacciata sulla Luna?
Il risultato relativo al ghiaccio riportato misura quanto le previsioni corrispondano a una mappa di potenzialità glaciale basata sulle conoscenze. Il miglior RMSE riportato scende da 0,0377 a 0,0293 rispetto al valore di riferimento citato, con una riduzione relativa di circa 22%. Si tratta di un miglioramento rispetto al benchmark; non è una misura della quantità aggiuntiva di ghiaccio scoperta.
Posso esplorare il progetto senza scrivere codice?
È possibile leggere l'annuncio della NASA, esaminare la scheda del modello, consultare le tabelle di benchmark pubblicate e visitare la pagina ufficiale di dimostrazione senza dover creare una pipeline di addestramento. Per adattare il checkpoint rilasciato a un compito scientifico si utilizzano il codice, i dati e le configurazioni TerraTorch presenti nel repository, seguiti da una validazione specifica per il compito in questione.
In che modo il modello lunare è collegato a Prithvi e Surya?
Essi rientrano nella più ampia collaborazione tra la NASA e IBM sui modelli di base per la scienza. La NASA descrive i modelli Prithvi per le osservazioni terrestri e le applicazioni meteorologiche, Surya per l’eliofisica e il modello lunare per le osservazioni della Luna. I loro ambiti di applicazione e i compiti previsti differiscono; il modello lunare non è stato valutato al di fuori della Luna.
Il Lunar Foundation Model della NASA e IBM offre un punto di partenza riutilizzabile per la ricerca sul telerilevamento lunare. Utilizzate le tabelle ufficiali per comprenderne i punti di forza, la scheda del modello per definirne i limiti e le risorse rese disponibili per pianificare un esperimento specifico per un determinato compito. Se il vostro obiettivo immediato è l’apprendimento o la redazione di un testo, iniziate trasformando tali fonti in un briefing verificato.
Trasforma un documento tecnico in una sintesi che puoi utilizzare
Importa le tue fonti ufficiali in GlobalGPT, approfondisci i concetti che non conosci e trasforma i risultati verificati in appunti chiari o in una bozza completa, il tutto in un unico spazio di lavoro multimodello.
Scopri le ricerche con GlobalGPT








