
Claude Sonnet 5.5 adalah model yang andal untuk penggunaan sehari-hari: cukup mumpuni untuk menangani perbaikan bug yang rumit atau dokumen yang padat, dengan harga token yang lebih rendah daripada Opus 5.5. Keunggulannya semakin jelas ketika Anda dapat mendefinisikan seperti apa jawaban yang baik itu. Untuk strategi terbuka atau masalah yang belum dikenal dengan banyak variabel, Opus tetap layak mendapat tempat dalam alur kerja Anda.
Dalam pengujian GlobalGPT kami, Sonnet 5.5 menyusun draf email untuk pelanggan, memperbaiki fungsi alokasi dana yang lolos 43 pemeriksaan, dan berhasil merekonsiliasi sekumpulan catatan faktur sebanyak 13.078 kata. Email tersebut juga memperkenalkan asumsi proses kecil yang perlu diperiksa. Pertanyaan yang lebih menarik adalah kapan kecepatan dan harganya dapat menghasilkan hari kerja yang lebih baik—dan kapan penalaran tambahan mulai menimbulkan biaya lebih besar daripada penghematan yang dihasilkannya.
Anda dapat menggunakan Claude Sonnet 5,5 pada GlobalGPT bersama dengan model-model terkemuka lainnya untuk menulis, pemrograman, penelitian, gambar, dan video. Satu langganan multi-model memberi Anda cara yang terjangkau untuk mengerjakan sebuah proyek mulai dari draf pertama hingga hasil akhir tanpa perlu mengelola langganan terpisah untuk setiap tahap.
Claude Sonnet 5.5: kesimpulan singkat
Pilihan default yang praktis untuk pekerjaan yang telah didefinisikan dengan jelas
Mulailah dengan Sonnet untuk membuat ringkasan, laporan bug, dokumen, atau implementasi awal. Berikan Sonnet bahan sumber, batasan, dan kriteria penerimaan. Beralihlah ke Opus ketika bagian tersulitnya adalah menentukan apa sebenarnya masalahnya.
Yang membuat kami terkesan: pemformatan yang terkendali, kode yang andal, dan rekonsiliasi dokumen yang akurat.
Yang patut ditonton: Asumsi-asumsi kecil bisa tanpa disadari menyusup ke dalam teks yang sudah disempurnakan; penalaran menambah biaya; konteks yang panjang tidak menjamin ingatan akan hal tersebut.
Ini adalah ulasan mengenai model yang baru dirilis, bukan studi produksi yang berlangsung selama berbulan-bulan. Kami menggabungkan spesifikasi Anthropic, evaluasi yang telah dipublikasikan, dan tiga tugas praktis yang dijalankan pada 1 Oktober 2026. Tugas penulisan diulang dua kali; sedangkan tugas kode dan dokumen masing-masing dijalankan sekali. Hasil di bawah ini memperhitungkan sampel kecil tersebut.
Apa saja yang baru di Claude Sonnet 5.5?
Anthropic merilis Sonnet 5.5 pada tanggal 28 September 2026 sebagai alternatif yang lebih cepat dan lebih terjangkau untuk Opus 5.5. Keunggulan yang ditonjolkan adalah kemampuan menangani pekerjaan sehari-hari dengan cakupan yang tepat, memperbaiki bug, serta menghasilkan dokumen, slide, dan spreadsheet yang rapi. Posisi pasar ini penting: Anda tidak perlu menggunakan model termahal untuk setiap pengeditan, tanggapan dukungan, atau tugas implementasi.
Apa saja yang baru di Claude Sonnet 5.5?
| Fitur | Sonnet 5.5 | Apa artinya hal itu dalam praktiknya |
|---|---|---|
| Masukan dan keluaran | Teks dan gambar masuk; teks keluar | Tanyakan mengenai diagram atau tangkapan layar, lalu jadikan jawaban tersebut sebagai draf atau rencana. |
| Jendela konteks API | 1 juta token | Tersedia ruang yang cukup untuk bahan sumber yang banyak; atur dan beri label dengan cermat. |
| Output maksimum API standar | 128 ribu token | Ini hanyalah batas model, bukan panjang jawaban yang direkomendasikan untuk setiap pertanyaan. |
| Penalaran | Pikiran adaptif | Upaya dapat memengaruhi baik waktu penyelesaian maupun jumlah total penggunaan token. |
| Batas akhir pengetahuan | Juni 2026 | Gunakan sumber terkini atau alat pencarian untuk memeriksa kebenaran fakta-fakta tersebut. |
Batasan konteks dan keluaran ini menjelaskan API Claude. Jumlah data yang dapat Anda unggah atau terima dalam suatu aplikasi tertentu juga bergantung pada antarmuka produk tersebut. Demikian pula, model yang mampu memahami sebuah gambar bukanlah generator gambar. Sonnet dapat memberikan kritik terhadap sebuah visual atau menyusun brief produksi; sedangkan model gambar atau video lah yang menghasilkan media jadi.
Peningkatan yang bermanfaat ini merupakan kombinasi antara pelaksanaan tugas yang lebih baik dan proses iterasi yang lebih cepat. Anda dapat meminta draf awal, memeriksa bagian yang kurang baik, dan meminta revisi yang lebih terfokus. Sebuah prompt yang baik memberikan arahan yang jelas: “Pertahankan semua gambar apa adanya, persingkat teks ini menjadi 200 kata, dan cantumkan segala hal yang tidak dijelaskan dalam teks sumber.”
Harga Claude Sonnet 5.5: tarif token dan biaya riil
Biaya Sonnet 5.5 $2 per juta token masukan dan $10 per juta token keluaran dengan tarif API standar Anthropic. Harga satuan tersebut sama dengan Sonnet 5. Dibandingkan dengan tarif input $4 dan tarif output $20 pada Opus 5.5, Sonnet memakan biaya setengah dari tarif per token input atau output—namun, sebuah tugas yang telah diselesaikan mungkin menghabiskan jumlah token yang berbeda.
Harga Claude Sonnet 5.5: tarif token dan biaya riil
| Kategori penagihan API | Harga per satu juta token |
|---|---|
| Masukan yang tidak disimpan dalam cache | $2.00 |
| Output, termasuk token pemikiran yang telah ditagih | $10.00 |
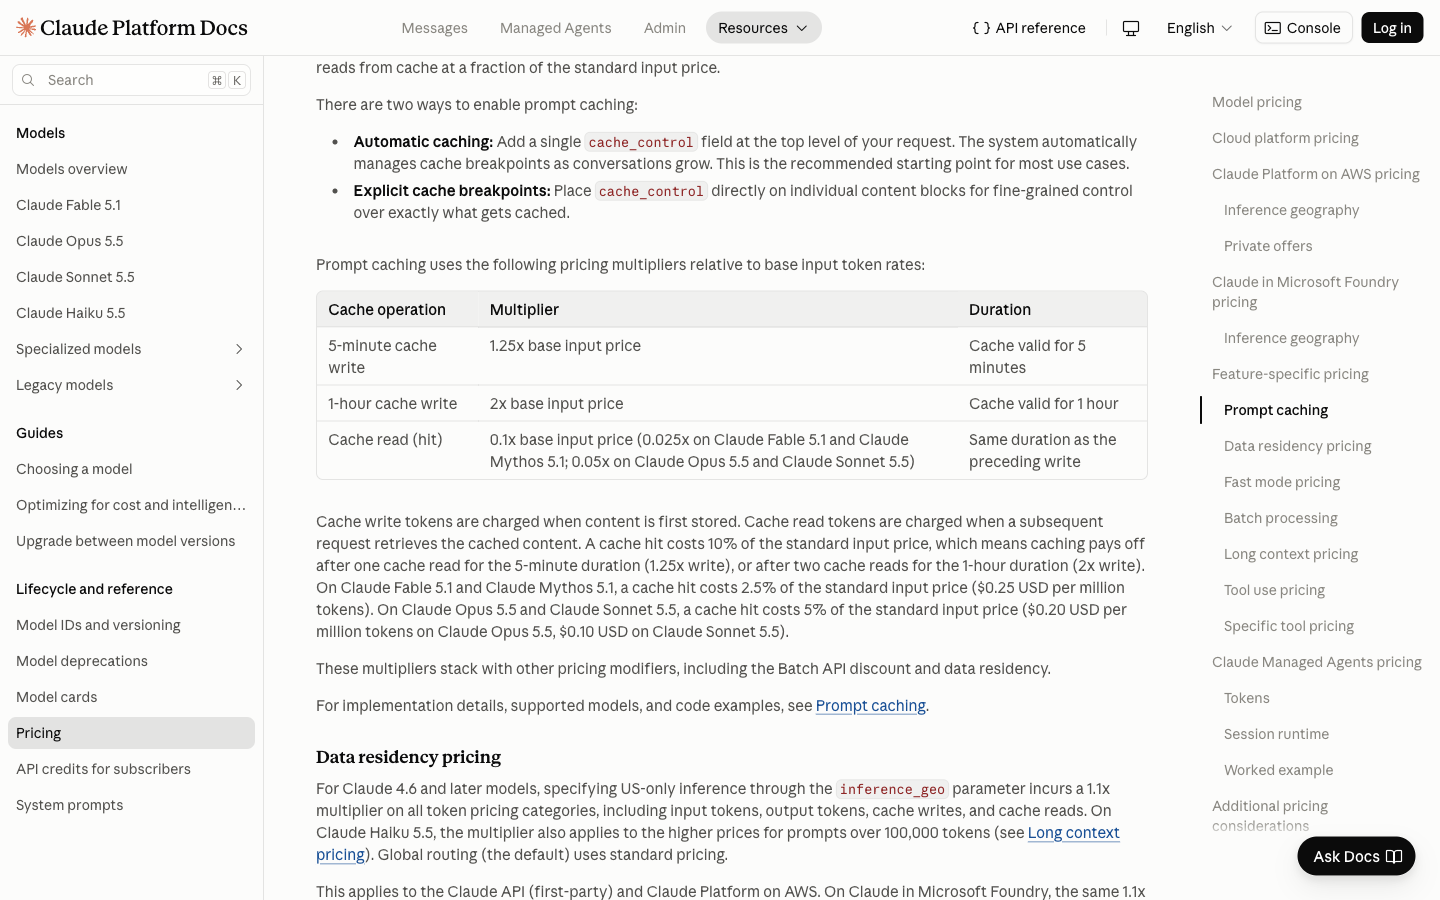
| Pembacaan / penyegaran cache | $0.10 |
| Penulisan cache, 5 menit | $2.50 |
| Penulisan cache, 1 jam | $4.00 |
Untuk permintaan yang tidak disimpan dalam cache, kalikan token masukan dengan $2 per juta dan token keluaran dengan $10 per juta. Masukan sebesar 10.000 token dengan 2.000 token keluaran dikenakan biaya $0,04. Input sebesar 100.000 token dengan output sebesar 10.000 token dikenakan biaya sebesar $0,30. Ini adalah contoh perhitungan API, bukan tagihan GlobalGPT; alat, operasi cache, tingkatan layanan, dan faktor penentu harga lainnya dapat mengubah total biaya.
Berapa biaya yang harus dikeluarkan untuk permintaan tersebut
Contoh biaya standar API per permintaan. Hanya mencakup input dan output yang tidak disimpan dalam cache.
Rumus: (jumlah token masukan × $2 + jumlah token keluaran × $10) ÷ 1.000.000. Aktivitas pemrosesan yang ditagihkan dihitung sebagai bagian dari jumlah token keluaran. Ini hanyalah contoh, bukan harga langganan atau tagihan yang sebenarnya.
Klaim Anthropic bahwa “biayanya bisa berkurang hingga 30% per tugas” berasal dari penyelesaian beberapa pekerjaan dengan jumlah token yang lebih sedikit. Ini bukanlah pemotongan harga sebesar 30%. Di sisi lain yang berlawanan, Evaluasi peluncuran Artificial Analysis Hasilnya mencapai sekitar $7,60 per tugas Indeks Kecerdasan pada tingkat usaha maksimal, atau sekitar 50% di atas Sonnet 5 dalam tes tersebut. Tugas-tugas benchmark yang menantang itu bukanlah pesan obrolan biasa, namun hal itu menunjukkan mengapa meningkatkan kemampuan penalaran hingga batas maksimal dapat menghilangkan keuntungan yang semula tampak jelas.
Penagihan API, langganan Claude, dan GlobalGPT adalah pilihan yang berbeda
Paket konsumen Claude menggunakan sistem harga berlangganan: Paket Gratis adalah $0, Paket Pro adalah $20 per bulan atau $200 yang ditagihkan per tahun, dan Paket Max mulai dari $100 per bulan, belum termasuk pajak yang berlaku. Penggunaan aplikasi memiliki batasan sesuai paket. Anthropic juga mencantumkan $100 atau $200 sebagai kuota API bulanan untuk tingkatan Max yang sesuai; paket Gratis dan Pro tidak menyertakan kuota API bulanan. Bandingkan akses aplikasi dan kuota API secara terpisah saat memilih paket. Platform multi-model cocok untuk orang-orang yang pekerjaannya secara rutin melibatkan berbagai keluarga model dan jenis media.
Jika kegiatan harian Anda meliputi menulis halaman peluncuran, meninjau kode, dan membuat materi visual kampanye, GlobalGPT menggabungkan berbagai alat tersebut. Keunggulannya terletak pada cakupan alur kerja yang ditawarkan dalam satu langganan, alih-alih harus membayar beberapa produk terpisah hanya untuk menyelesaikan satu proyek. Pilihlah paket yang sesuai dengan pekerjaan yang sebenarnya Anda lakukan.
Perbandingan kinerja: hampir setara dengan Opus dalam beberapa tugas, namun tidak dalam semua tugas
Hasil peluncuran ini menunjukkan kemajuan signifikan dibandingkan Sonnet 5. Hasil tersebut juga menunjukkan mengapa satu skor utama saja tidak cukup untuk menentukan pilihan model. Sonnet 5.5 memimpin dalam perbandingan Terminal-Bench yang dilaporkan, sementara Opus 5.5 tetap unggul pada FrontierCode dan CursorBench. Peringkat kinerja berbasis pengetahuan yang hampir setara memang menjanjikan, tetapi hal itu tidak membuat kedua model tersebut dapat saling menggantikan.
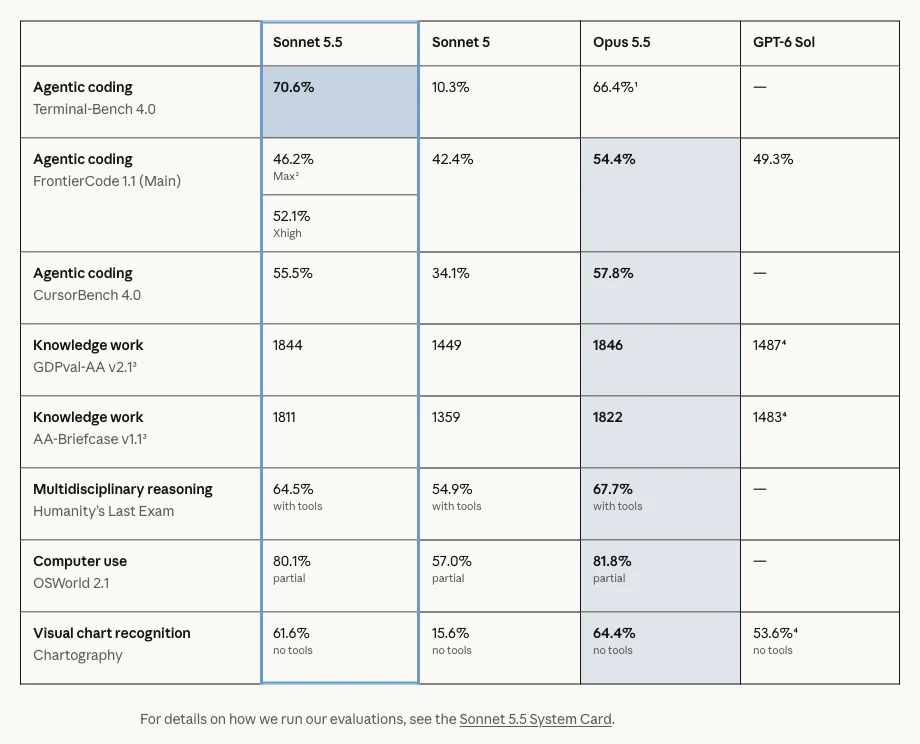
Perbandingan kinerja: hampir setara dengan Opus dalam beberapa tugas, namun tidak dalam semua tugas
| Evaluasi pada tabel peluncuran Anthropic | Sonnet 5.5 | Soneta 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66,41 TP40T (Xhigh) | - |
| FrontierCode 1.1 Utama | 52,11 TP40T (Xhigh); 46,21 TP40T (Maks) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA v2.1 | 1844 Elo | 1449 Elo | 1846 Elo | 1487 |
| AA-Briefcase v1.1 | 1811 Elo | 1359 Elo | 1822 Elo | 1483 |
| Ujian Terakhir Manusia | 64,51 TP40T beserta perkakasnya | 54,91 TP40T beserta perkakasnya | 67,71 TP40T beserta perkakasnya | - |
| OSWorld 2.1 | 80.1% parsial | 57,01 TP40T parsial | 81,81 TP40T parsial | - |
| Kartografi | 61,61 TP40T tanpa alat | 15,61 TP40T tanpa alat | 64,41 TP40T tanpa alat | 53,61 TP40T tanpa alat |
Ini adalah hasil benchmark yang telah dipublikasikan, terpisah dari pengujian GlobalGPT kami. Evaluasi-evaluasi tersebut menggunakan lingkungan dan pengaturan upaya yang berbeda; peringkat Elo bukanlah persentase akurasi. Nilai GPT-6 Sol tercantum dalam tabel perbandingan yang dipublikasikan oleh Anthropic, dan tanda hubung (-) berarti halaman tersebut tidak melaporkan nilai untuk evaluasi tersebut. Anthropic juga mencatat bahwa pengujian GDPval-AA dan AA-Briefcase pada saat peluncuran menggunakan deployment pra-rilis yang mengandung bug pada output terstruktur, yang kemudian telah diperbaiki. Anggaplah tabel ini sebagai gambaran dari evaluasi-evaluasi tersebut, bukan jaminan terkait beban kerja Anda.
Hasil FrontierCode sangat berguna: Sonnet memperoleh skor yang lebih baik pada Xhigh daripada pada Max. Anthropic mengaitkan penurunan skor pada Max dengan proses peninjauan tambahan, batas waktu, dan perubahan di luar cakupan yang diminta. Berpikir lebih dalam bisa saja menambah beban kerja tanpa menghasilkan jawaban yang lebih baik. Mulailah dengan tugas yang jelas dan tingkatkan upaya Anda hanya jika ada alasan spesifik.
Hasil independen memberikan konteks tambahan. Artificial Analysis melaporkan skor Indeks Kecerdasan sebesar 56 pada konfigurasi Max/default-fallback-nya, disertai dengan penggunaan token keluaran yang sangat tinggi. A Evaluasi alur kerja CodeRabbit Ditemukan 6 dari 13 kasus sinyal sulit yang terdeteksi oleh Sonnet 5.5, dibandingkan dengan 4 dari 13 yang terdeteksi oleh Sonnet 5, dengan waktu eksekusi rata-rata yang lebih rendah. Ini adalah studi skala kecil dari vendor, bukan bukti bahwa setiap tinjauan kode akan membaik, tetapi ini merupakan contoh yang berguna dalam mengevaluasi tugas secara menyeluruh daripada sekadar skor.
Seberapa cepat Claude Sonnet 5.5?
Anthropic dilaporkan menghasilkan keluaran lebih dari 30% kali lebih cepat daripada Sonnet 5. Pembuatan keluaran hanyalah salah satu bagian dari proses menunggu jawaban: pemrosesan masukan, penalaran, waktu jaringan, dan beban layanan juga berperan penting. Sebuah model dapat menulis keluaran dengan cepat begitu proses dimulai, namun tetap membutuhkan waktu untuk bekerja sebelum jawaban akhir muncul.
Tiga kali pengulangan perintah email pelanggan yang sama telah diselesaikan dalam 11,60, 12,16, dan 11,78 detik, dengan median 11,78 detik. Tugas kode memakan waktu 19,08 detik dan tugas dokumen 16,42 detik. Kami mengukur waktu respons secara keseluruhan, termasuk overhead layanan dan jaringan. Kami tidak mengukur latensi token pertama atau menjalankan pengujian kontrol Sonnet 5, sehingga waktu-waktu ini tidak membuktikan adanya peningkatan 30%.
Untuk penggunaan sehari-hari, hal ini menjadikan model tersebut layak dicoba pada pekerjaan yang direvisi dalam siklus singkat. Mintalah hasil akhir terlebih dahulu, batasi cakupan pekerjaan, dan hindari meminta penjelasan yang bertele-tele ketika yang Anda butuhkan hanyalah fungsi yang telah diperbaiki atau jawaban singkat. Jika pengaturan tingkat upaya ditampilkan, coba evaluasi pengaturan yang lebih ringan sebelum secara otomatis memilih opsi "Max".
Kinerja di dunia nyata: tiga uji GlobalGPT
Kami menggunakan tugas-tugas praktis dengan jawaban yang dapat kami periksa. Semua permintaan menggunakan Claude Sonnet 5.5 dengan batas keluaran 6.000 token yang sama dan tanpa alat eksternal. Kami membiarkan pengaturan sampling dan penalaran pada pengaturan default layanan. Kami menyimpan keluaran pertama yang selesai untuk setiap tugas; dua putaran penulisan tambahan merupakan pemeriksaan konsistensi terpisah. Kelima panggilan tersebut selesai tanpa perlu percobaan ulang.
Menulis: balasan kepada pelanggan dengan janji-janji yang tetap terkendali
Petunjuk tersebut meminta agar dibuat email berisi 90–120 kata kepada Maya mengenai keterlambatan pengiriman lampu biru, tepatnya tiga poin, batas waktu pengiriman pada 4 Oktober, serta opsi untuk membalas dengan kata “refund” guna mendapatkan pengembalian dana penuh ke metode pembayaran semula. Petunjuk tersebut secara tegas melarang penyebutan alasan yang dibuat-buat, jaminan kedatangan, diskon, atau janji pengembalian dana seketika.
Jawaban pertama terdiri dari 110 kata dengan tepat tiga poin, serta tetap mempertahankan tenggat waktu pengiriman dan ketentuan pengembalian dana sebagaimana adanya. Jawaban tersebut tidak mengada-ada mengenai tanggal pengiriman, alasan keterlambatan, atau keuntungan tambahan. Namun, jawaban tersebut menambahkan kalimat “Anda tidak perlu membalas” bagi pelanggan yang tetap mempertahankan pesanan—sebuah detail proses yang tidak tercantum dalam brief. Hal ini menjadikan jawaban tersebut sebagai draf yang berguna, tetapi belum sepenuhnya memenuhi persyaratan ketat yang hanya mengutamakan fakta.
Jawaban yang diulang tersebut masing-masing terdiri dari 101 dan 97 kata serta telah memenuhi aturan format, namun keduanya mengulang asumsi yang sama bahwa tidak perlu mengambil tindakan apa pun. Jawaban ketiga bahkan menggunakan dua poin untuk opsi yang pada dasarnya sama, yaitu “pertahankan urutan dan tunggu”. Sebelum mengirim balasan kepada pelanggan, pastikan detail operasionalnya dan hilangkan bagian yang berulang.
Uji penulisan: format lolos, asumsi satu proses
Jawaban pertama: 110 kata, 3 poin, 11,60 detik. Ketentuan pengiriman dan pengembalian dana sudah benar. Instruksi untuk mempertahankan pesanan tanpa membalas tidak tercantum dalam brief dan perlu dikonfirmasi. Jawaban berikutnya: 101 dan 97 kata; keduanya mengulangi asumsi tersebut.
Claude Sonnet 5,5 · GlobalGPT · 1 Oktober 2026 · batas maksimum keluaran 6.000 token · tanpa alat bantu · pengambilan sampel dan upaya disesuaikan dengan pengaturan default layanan. Waktu yang dimaksud adalah waktu respons lengkap, bukan waktu token pertama.
Petunjuk tugas
Tuliskan email layanan pelanggan dalam bahasa Inggris kepada Maya mengenai pesanan R-418, sebuah lampu biru yang pengirimannya tertunda. Panjang email secara keseluruhan harus 90–120 kata (termasuk angka-angka tersebut) dan berisi tepat tiga poin. Sertakan permintaan maaf, jelaskan langkah selanjutnya dengan jelas, dan gunakan hanya fakta-fakta berikut: lampu akan dikirim paling lambat tanggal 4 Oktober; sebagai alternatif, Maya dapat membalas dengan kata “refund” untuk meminta pengembalian dana penuh ke metode pembayaran semula. Jangan menjanjikan tanggal pengiriman atau kedatangan, pengembalian dana instan, diskon, kompensasi, atau manfaat lain yang tidak dijanjikan. Jangan mengada-ada alasan keterlambatan. Batas waktu yang dimaksud adalah batas waktu pengiriman, bukan batas waktu penerimaan. Sertakan salam pembuka dan penutup. Kirimkan kembali hanya email tersebut. Untuk tugas ini, satu kata adalah token yang dipisahkan oleh spasi, tidak termasuk penanda poin yang berdiri sendiri.
Hasil pertama secara lengkap
Perihal: Pembaruan mengenai pesanan Anda R-418

Halo Maya,

Saya mohon maaf karena pengiriman lampu biru Anda, pesanan R-418, mengalami keterlambatan. Saya tahu hal ini cukup menjengkelkan, dan saya mohon maaf atas ketidaknyamanan yang ditimbulkan.

Berikut adalah perkembangan terkini dan langkah yang dapat Anda ambil selanjutnya:

- Lampu Anda akan dikirim paling lambat tanggal 4 Oktober.
- Jika Anda ingin tetap mempertahankan pesanan ini, Anda tidak perlu membalas email ini.
- Jika Anda tidak ingin menunggu, balas email ini dengan kata "refund", dan kami akan memproses pengembalian dana penuh ke metode pembayaran awal Anda.

Terima kasih atas kesabaran dan pengertian Anda. Silakan balas jika Anda memiliki pertanyaan mengenai pesanan Anda.

Hormat kami,
Tim Layanan Pelanggan
Penulisan pengulangan 2 · keluaran lengkap
Maya yang terhormat,

Saya mohon maaf karena pengiriman pesanan Anda nomor R-418, yaitu lampu biru, mengalami keterlambatan. Saya memahami bahwa hal ini tentu membuat Anda kecewa, dan saya mohon maaf atas ketidaknyamanan yang ditimbulkan.

Berikut langkah-langkah selanjutnya:

- Lampu biru Anda akan dikirim paling lambat tanggal 4 Oktober.
- Jika Anda ingin menunggu, Anda tidak perlu melakukan apa pun.
- Jika Anda lebih memilih untuk tidak menunggu, balas email ini dengan kata "refund" untuk meminta pengembalian dana penuh ke metode pembayaran awal Anda.

Harap diperhatikan bahwa tanggal 4 Oktober adalah batas waktu pengiriman kami, bukan tanggal pengiriman barang.

Terima kasih atas kesabaran dan pengertian Anda.

Hormat kami,
Tim Layanan Pelanggan
Penulisan ulangan 3 · keluaran lengkap
Perihal: Pembaruan mengenai pesanan Anda R-418

Halo Maya,

Maaf atas keterlambatan pengiriman lampu biru Anda, pesanan R-418. Saya mohon maaf atas ketidaknyamanan ini dan mengapresiasi kesabaran Anda.

Berikut adalah pilihan Anda:

- Tunggu pengiriman: lampu Anda akan dikirim paling lambat tanggal 4 Oktober.
- Meminta pengembalian dana: balas dengan kata "refund" dan kami akan memproses pengembalian dana penuh ke metode pembayaran awal Anda.
- Tetap mempertahankan pesanan: jika Anda bersedia menunggu, tidak diperlukan tindakan lebih lanjut.

Harap diperhatikan bahwa tanggal 4 Oktober adalah batas waktu pengiriman kami, bukan tanggal pengiriman barang.

Salam hangat,
Tim Layanan Pelanggan
Lampu Anda akan dikirimkan paling lambat tanggal 4 Oktober. … Jika Anda tidak ingin menunggu, balas email ini dengan kata “refund”, dan kami akan memproses pengembalian dana penuh ke metode pembayaran awal Anda.
Kutipan dari tes menulis GlobalGPT yang pertama; salah satu poin di antaranya dihilangkan.
Ini adalah pola yang berguna untuk komunikasi dengan pelanggan dan penulisan bisnis: sampaikan fakta-fakta yang telah disetujui, tentukan nada penyampaiannya, dan sebutkan janji-janji apa saja yang tidak boleh dicantumkan. Sonnet kemudian dapat membantu dalam penyusunan kalimat tanpa diminta untuk membuat kebijakan Anda.
Pemrograman: perbaiki logika pembulatan, lalu verifikasi jumlah totalnya
Fungsi Python kami yang bermasalah membagi uang menggunakan bilangan desimal dan membulatkan setiap bagian secara terpisah. Hal itu dapat menghasilkan atau menghilangkan sen. Kami meminta Sonnet untuk menggantinya dengan metode alokasi sisa terbesar berbasis desimal, mempertahankan jumlah total, menentukan pemenang jika terjadi seri berdasarkan indeks asli, dan menolak masukan yang tidak valid.
Fungsi pertama yang dikembalikan diteruskan 43 dari 43 pemeriksaan, mencakup nilai nol, bobot pecahan, hasil seri deterministik, masukan yang tidak valid, nilai besar, dan batas presisi. Program ini mengurai string desimal, mengubahnya menjadi bilangan bulat yang tepat, dan mengalokasikan sisa sen dalam urutan yang konsisten. Hasil yang bermanfaat bukan sekadar kode yang tampak masuk akal: jumlah totalnya benar-benar sesuai.
Hal ini mendukung penggunaan Sonnet untuk implementasi yang terfokus dengan kriteria penerimaan yang eksplisit. Ini merupakan uji fungsi mandiri, bukan perbaikan repositori secara otonom atau audit keamanan. Untuk kode produksi, tambahkan uji integrasi Anda sendiri dan tinjau penanganan kesalahan dalam aplikasi yang terkait.
Tes pemrograman: 43 pemeriksaan berhasil dilalui
Jawaban pertama: 19,08 detik. Lulus semua 43 pemeriksaan terkait alokasi yang benar, ikatan yang stabil, validasi masukan, dan presisi. Dievaluasi sebagai fungsi mandiri, bukan sebagai perbaikan repositori otonom.
Claude Sonnet 5,5 · GlobalGPT · 1 Oktober 2026 · batas maksimum keluaran 6.000 token · tanpa alat bantu · pengambilan sampel dan upaya disesuaikan dengan pengaturan default layanan. Waktu yang dimaksud adalah waktu respons lengkap, bukan waktu token pertama.
Petunjuk tugas
Gantilah fungsi Python yang salah di bawah ini dengan implementasi yang benar dari `allocate_cents(total: str, weights: list[str]) -> list[int]`. Kembalikan hanya kode sumber Python yang dapat dijalankan, tanpa tanda pembatas Markdown atau penjelasan.

Persyaratan:
1. total adalah jumlah USD yang tidak negatif dan terbatas, ditulis sebagai string, dengan nol, satu, atau dua digit desimal, seperti "0", "12.3", atau "12.34". Harus menggunakan digit desimal ASCII dengan titik desimal tunggal yang opsional. Tolak tanda, notasi eksponen, spasi kosong, NaN/Infinity, string kosong, titik desimal di akhir, titik desimal di awal, dan lebih dari dua digit desimal, termasuk "1.000". Nol di depan diperbolehkan. Tolak masukan non-string dengan ValueError.
2. weights adalah daftar string yang tidak kosong. Setiap string menggunakan angka desimal ASCII, opsional dengan titik desimal dan satu atau lebih digit setelahnya. Wajibkan nilai-nilai nonnegatif yang terbatas dengan setidaknya satu bobot yang positif murni. Tolak string yang tidak valid, tanda, notasi eksponen, spasi kosong, entri non-string, atau masukan `weights` yang bukan daftar dengan `ValueError`. Nol di depan diperbolehkan.
3. Gunakan `Decimal` untuk mengurai dan mempertahankan jumlah desimal yang diberikan secara tepat. Konversikan dolar menjadi sen bilangan bulat. Alokasikan sen bilangan bulat secara proporsional sesuai bobot, menggunakan metode sisa terbesar: ambil bagian bulat dari setiap kuota yang tepat, lalu alokasikan sisa sen ke sisa pecahan terbesar. Selesaikan kesamaan dengan mengutamakan indeks asli yang lebih rendah. Daftar yang dikembalikan harus mempertahankan urutan masukan dan jumlahnya harus sama persis dengan total sen.
4. Jangan secara diam-diam mengorbankan presisi untuk nilai yang sangat panjang atau bobot yang sangat tidak seimbang. Jangan mengubah bobot. Impor hanya dari `decimal` atau `math` jika diperlukan. Dilarang melakukan operasi berkas, jaringan, lingkungan, proses, atau masukan/keluaran.

Implementasi yang salah:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
Hasil pertama secara lengkap
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 if not isinstance(s, str) or not s:
 return False
 parts = s.split(".")
 if len(parts) > 2:
            kembalikan False
 jika tidak ada parts[0] atau tidak semua c dalam DIGITS untuk setiap c dalam parts[0]:
 kembalikan False
 jika len(parts) == 2:
 frac = parts[1]
 jika tidak ada frac atau tidak semua c dalam DIGITS untuk setiap c dalam frac:
                kembalikan False
 jika max_frac bukan None dan len(frac) > max_frac:
 kembalikan False
 kembalikan True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # mengembalikan (mantissa bilangan bulat, eksponen) dengan nilai = mantissa * 10**eksponen
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("total tidak valid")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("bobot tidak valid")
    for w in weights:
 if not valid(w, None):
 raise ValueError("bobot tidak valid")

 mant, exp = to_scaled(total)
    if exp >= -2:
 cents = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # tidak tercapai untuk masukan yang telah divalidasi

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    jika W <= 0:
        raise ValueError("setidaknya satu bobot harus positif")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
Dokumen: temukan catatan yang tepat setelah dilakukan koreksi dan penghapusan duplikat
Tugas ketiga menyediakan paket faktur sintetis yang terdiri dari 13.078 kata: 120 catatan dasar, delapan koreksi, dan empat salinan arsip. Sonnet harus memilih hanya faktur Atlas yang telah disetujui dengan tanggal pada September 2026, menggunakan versi tertinggi dari setiap catatan, dan mengembalikan data dalam format JSON yang ketat beserta totalnya serta tiga pemeriksaan lanjutan yang masuk akal.
Fitur tersebut memilih semuanya 16 nomor faktur yang benar, mengembalikan nilai yang persis sama $15,305.66 secara keseluruhan, dan tetap mempertahankan struktur JSON. Langkah-langkah lanjutan yang dilakukan mencakup rekonsiliasi buku besar, dokumen pendukung untuk koreksi, serta pemeriksaan duplikat atau pemotongan. Sistem tersebut tidak menganggap salinan arsip lama sebagai faktur baru.
Inilah jenis detail yang penting dalam pengolahan dokumen: koreksi terbaru harus diutamakan, meskipun salinan yang lebih lama muncul di bagian akhir paket dokumen. Hasilnya menjanjikan untuk ekstraksi dokumen dengan batasan tertentu. Namun, ini masih sekadar latihan simulasi, jauh lebih kecil daripada jendela konteks satu juta token yang diiklankan; pekerjaan keuangan yang penting memerlukan perhitungan independen.
Pengujian dokumen: 16 catatan, jumlah persis
Jawaban pertama: 16,42 detik. Ke-16 ID faktur dan total $15.305,66 semuanya sesuai dengan referensi independen; format JSON yang ketat serta tiga pemeriksaan lanjutan juga benar.
Claude Sonnet 5,5 · GlobalGPT · 1 Oktober 2026 · batas maksimum keluaran 6.000 token · tanpa alat bantu · pengambilan sampel dan upaya disesuaikan dengan pengaturan default layanan. Waktu yang dimaksud adalah waktu respons lengkap, bukan waktu token pertama.
Paket sintetis yang disediakan berisi 120 catatan dasar, delapan koreksi, dan empat salinan arsip (13.078 kata). Kolom-kolom yang ada adalah ID, versi, proyek, tanggal, status, jumlah, dan catatan deskriptif. Petunjuk di bawah ini sudah lengkap; paket sumber yang panjang dirangkum di sini.
Petunjuk tugas
Audit catatan faktur proyek sintetis di bawah ini. Untuk setiap ID, gunakan hanya versi tertinggi; catatan duplikat yang identik tidak akan menghasilkan faktur tambahan. Versi tertinggi dapat muncul sebelum salinan arsip yang lebih lama. Pilih hanya catatan yang proyek akhirnya adalah Atlas, status akhirnya disetujui, dan tanggal akhirnya jatuh pada bulan September 2026. Jumlahnya dalam USD. Kembalikan JSON yang ketat dengan kunci-kunci berikut ini: "ids" (ID terpilih yang unik dan diurutkan secara ascending), "total_usd" (string dengan tepat dua desimal), dan "action_items" (tiga string ringkas yang memberikan petunjuk pemeriksaan akuntansi selanjutnya yang masuk akal). Jangan tambahkan pembatas Markdown atau teks penjelasan. Abaikan catatan naratif untuk penyaringan; semua bidang akuntansi bersifat terstruktur. Jangan hitung catatan dari bulan lain, catatan draf, catatan Orion, versi lama, atau salinan yang berulang.
Hasil pertama secara lengkap
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056","INV-062","INV-068","INV-074","INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15305,66","action_items":["Lakukan rekonsiliasi terhadap 16 faktur yang dipilih dan total 15.305,66 USD dengan buku besar umum Atlas dan buku besar pembantu hutang dagang per September 2026.","Tinjau catatan yang diubah akibat koreksi (INV-003, INV-008, INV-020, INV-050, ditambah INV-002, INV-014, dan INV-026 yang dikecualikan) untuk bukti persetujuan dan dokumen pendukung.","Pastikan bahwa salinan arsip duplikat tidak diposting sebagai faktur terpisah, dan periksa adanya masalah akrual atau pemotongan pada faktur yang dikoreksi yang bertanggal mendekati akhir bulan."]}Sonnet 5.5 vs Opus 5.5: mana yang sebaiknya Anda gunakan?
Pilihlah berdasarkan jenis tugasnya. Sonnet merupakan pilihan awal yang tepat jika petunjuk dan tujuan akhirnya sudah jelas. Opus lebih cocok sebagai titik awal jika tugas tersebut membutuhkan penilaian yang berkelanjutan, mengidentifikasi asumsi yang terlewatkan, atau mengoordinasikan rangkaian keputusan yang panjang. Baca artikel kami Ulasan Claude Opus 5.5 untuk melihat model tersebut lebih dekat.
Sonnet 5.5 vs Opus 5.5: mana yang sebaiknya Anda gunakan?
| Tugas Anda | Titik awal yang direkomendasikan | Mengapa |
|---|---|---|
| Menulis ulang teks singkat, menyusun draf teks untuk pelanggan, dan mengekstrak data | Sonnet 5.5 | Keterbatasan yang jelas membuat kualitas lebih mudah diverifikasi. |
| Memperbaiki bug yang telah diidentifikasi atau mengimplementasikan fungsi yang ditentukan | Sonnet 5.5 | Pelaksanaan tugas yang optimal pada tingkat token masukan/keluaran yang lebih rendah. |
| Menentukan arsitektur dengan persyaratan yang belum lengkap | Opus 5.5 | Yang sulit adalah mempertahankan penilaian yang konsisten, bukan sekadar pelaksanaannya. |
| Selesaikan sebuah kampanye dengan teks, gambar, dan video | Alur kerja multi-model GlobalGPT | Gunakan Sonnet untuk model-model singkat dan khusus terkait aset-aset tersebut. |
Alur kerja yang berguna adalah dengan meminta model penalaran yang lebih canggih untuk mengkritisi rencana yang rumit, kemudian memberikan spesifikasi yang telah disepakati dan pemeriksaan konkret kepada Sonnet. Pilihan model dapat berubah antar tahap. Anda tidak perlu menjadikan setiap revisi kecil sebagai tugas penalaran yang paling mahal.
Gunakan Sonnet 5.5 pada GlobalGPT
GlobalGPT menjadikan model ini berguna sebagai bagian dari pengaturan kerja yang lebih luas. Buka Claude Sonnet 5.5 untuk tahap penulisan atau analisis, lalu beralih ke model lain ketika proyek membutuhkan pendekatan yang berbeda. Anda dapat menyusun brief kampanye, menyempurnakan naskah, membuat materi visual, dan memproduksi video tanpa perlu membangun ulang alur kerja di beberapa langganan.
Agar hasil awal lebih baik, kirimkan materi sumber beserta sejumlah kecil aturan penerimaan secara bersamaan. Untuk tulisan, tentukan target pembaca, panjang teks, nada, dan fakta-fakta yang harus tetap tidak berubah. Untuk kode, berikan contoh yang mengalami kesalahan dan perilaku yang diharapkan. Untuk dokumen, beri label pada bagian-bagian sumber dan jelaskan cara menangani versi yang bertentangan. Hal-hal ini petunjuk untuk menulis, meneliti, dan membuat kode memberikan Anda titik awal yang dapat digunakan kembali.
Para pengembang juga dapat mengintegrasikan alur kerja terminal mereka melalui GlobalGPT CLI dengan Kode Claude. Gunakan situs web untuk proyek yang lebih luas dan antarmuka baris perintah (CLI) jika sesuai dengan proses pengembangan. Keunggulannya terletak pada kumpulan alat yang terintegrasi, di mana pemilihan model ditentukan oleh tugas berikutnya.
Hal-hal yang perlu diketahui mengenai batasan dan detail pembaruan
Upaya keras adalah sebuah pilihan, bukan jaminan kualitas. Sonnet bisa saja terlalu mendalami masalah yang sempit atau melampaui perubahan yang diminta. Minta Sonnet untuk tetap berpegang pada ruang lingkup, menjalankan pemeriksaan yang relevan, dan berhenti begitu kriteria penerimaan terpenuhi. Jika produk menyediakan fitur pengendalian upaya, bandingkan kualitas dan biaya tugas yang telah diselesaikan sebelum menaikkan keduanya.
Fakta terkini tetap memerlukan sumber terkini. Data model per Juni 2026 tidak mencakup informasi terkini mengenai setiap harga, kebijakan, atau pengumuman. Sediakan dokumen terbaru atau gunakan alur kerja yang dilengkapi alat pencarian. Untuk materi sensitif, periksa ketentuan privasi dan penyimpanan dari layanan serta akun yang Anda gunakan; nama model tidak menentukan pengaturan tersebut.
Migrasi API tidak hanya sekadar mengganti nama model. Sonnet 5.5 mengubah beberapa pola permintaan yang lebih lama. API Claude langsung menolak pengaturan suhu, top_p, dan top_k yang tidak sesuai standar, sehingga pola pikir lama atau konfigurasi alat yang dipaksakan mungkin perlu diperbarui. Pola pikir adaptif menjadi pengaturan default; mode `between_tools` yang didokumentasikan menghilangkan proses pemikiran di awal pada tingkat Up-front Thinking dengan tingkat usaha High atau di bawahnya. Ringkasan saat ini juga menjelaskan bahwa penggunaan alat yang dipaksakan akan menghasilkan kesalahan, alat berbasis komputer versi lama tidak diterima pada API Claude dan Google Cloud, serta teks di antara panggilan alat dapat muncul dalam blok pemikiran. Periksa panduan migrasi resmi sebelum memindahkan sebuah aplikasi. Kami Panduan API Claude membahas konsep-konsep umum terkait pengaturan dan penagihan.
Anthropic juga menerapkan langkah-langkah pengamanan terhadap permintaan yang berkaitan dengan keamanan siber dan biologi yang berisiko lebih tinggi. Pengembangan perangkat lunak rutin tetap menjadi bagian dari tujuan penggunaan model ini. Jika suatu tugas sah namun bersifat sensitif, jelaskan ruang lingkup dan izinnya dengan jelas, alih-alih menganggap setiap penolakan sebagai batasan umum dalam pemrograman.
Kesimpulan akhir: model yang bagus untuk dijadikan bagian dari alur kerja harian Anda
Sonnet 5.5 membuktikan nilainya melalui hasil kerja yang praktis dan dapat diverifikasi. Alasan terkuat untuk menggunakannya adalah kemampuan pemrograman berlingkup yang mumpuni serta pengelolaan dokumen yang bermanfaat, dengan biaya token API yang lebih rendah daripada Opus. Penggunaan untuk penulisan juga sangat baik, disertai pemeriksaan akhir terhadap detail yang masuk akal namun tidak pernah tercantum dalam brief. Kumpulan data uji kecil kami mendukung posisi sebagai alat untuk pekerjaan sehari-hari; hal ini tidak menunjukkan keunggulan universal dalam hal kecepatan, biaya, atau penalaran kompleks.
Mulailah dengan tugas nyata yang hasilnya dapat Anda nilai. Jelaskan batasan-batasannya secara eksplisit, periksa detail-detail pentingnya, dan beralihlah ke model lain ketika masalahnya berubah. Coba Sonnet 5.5 pada GlobalGPT untuk menggabungkan penulisan, pemrograman, analisis, dan langkah kreatif berikutnya ke dalam satu alur kerja multi-model.
Pertanyaan yang Sering Diajukan
Apa itu Claude Sonnet 5.5?
Claude Sonnet 5.5 adalah model Anthropic yang dirilis pada 28 September 2026. Model ini mendukung masukan teks dan gambar dengan keluaran teks, serta dirancang untuk pemrograman sehari-hari yang cepat, penulisan, pengolahan dokumen, dan alur kerja yang dibantu alat.
Berapa harga Claude Sonnet 5.5?
Harga API standar Anthropic adalah $2 per juta token masukan dan $10 per juta token keluaran. Biaya pembacaan cache adalah $0,10 per juta token. Langganan aplikasi Claude dan paket GlobalGPT tidak termasuk dalam tarif API ini.
Apakah Claude Sonnet 5,5 lebih cepat daripada Sonnet 5?
Anthropic melaporkan kecepatan pembuatan output yang lebih cepat 30% dibandingkan Sonnet 5. Dalam uji penulisan GlobalGPT kami, tiga respons lengkap memakan waktu 11,60–12,16 detik. Kami tidak menjalankan Sonnet 5 sebagai kontrol, sehingga uji coba kami tidak mengukur peningkatan kecepatan antar generasi.
Apakah Sonnet 5.5 lebih baik daripada Opus 5.5?
Pilih Sonnet 5.5 untuk tugas-tugas yang terdefinisi dengan jelas dan harga token input/output yang lebih rendah. Opus 5.5 merupakan titik awal yang lebih unggul untuk pekerjaan yang kompleks dan bersifat terbuka yang membutuhkan penilaian yang berkelanjutan. Sonnet memimpin dalam beberapa evaluasi yang telah dipublikasikan, namun tidak ada pemenang yang mutlak.
Apakah Claude Sonnet 5.5 mampu menangani dokumen yang panjang?
API Claude menetapkan jendela konteks sebesar satu juta token. Dalam uji coba dokumen sintetis kami yang lebih kecil, yang terdiri dari 13.078 kata, Sonnet berhasil memilih semua 16 catatan yang memenuhi syarat dan menghitung total yang benar. Hasil tersebut belum membuktikan akurasi di seluruh jendela konteks yang diiklankan.
Apakah saya bisa menggunakan Claude Sonnet 5.5 pada GlobalGPT?
Ya. GlobalGPT menyediakan Claude Sonnet 5.5 bersama dengan model AI lainnya, sehingga Anda dapat menyusun draf, membuat kode, menganalisis dokumen, dan melanjutkan ke pekerjaan terkait gambar atau video dalam satu platform.
Sumber dan catatan pengujian
Spesifikasi dan harga saat peluncuran telah diverifikasi pada tanggal 13 Oktober 2026; pengujian langsung di bawah ini dilakukan pada tanggal 1 Oktober 2026. Referensi utama: Pengumuman peluncuran Anthropic, Referensi model Sonnet 5.5, Harga API, dan Harga langganan Claude. Konteks independen ini bersumber dari Artificial Analysis dan studi CodeRabbit yang tautannya tercantum di atas.
Uji GlobalGPT menggunakan jawaban pertama yang diselesaikan pada tiga tugas, ditambah dua pengulangan penulisan. Tidak ada alat eksternal yang diaktifkan. Waktu pengujian mencakup respons lengkap, termasuk overhead jaringan dan layanan; nilai upaya penalaran tidak dipilih. Paket faktur bersifat sintetis dan tidak mengandung data pelanggan. Ilustrasi header dihasilkan khusus untuk ulasan ini; gambar lainnya adalah tangkapan layar dari situs web yang disebutkan.









