Claude Fable 5.1 adalah model baru Anthropic yang telah tersedia secara umum untuk pemrograman, pekerjaan berbasis pengetahuan, pemecahan masalah jangka panjang, dan penelitian ilmiah. Harga tersebut diumumkan pada 1 September 2026. Perubahan utama bukanlah kenaikan harga daftar API: harga input tetap $10 per juta token dan harga output tetap $50. Sebaliknya, Anthropic menurunkan harga pembacaan cache menjadi $0,25 per juta token dan memperkirakan biaya yang lebih rendah untuk beban kerja yang banyak menggunakan konteks yang sama.
Hal itu menjadikan Fable 5.1 layak untuk ditelaah secara serius ketika pekerjaan Anda bergantung pada dokumen panjang, konteks yang berulang, atau analisis yang dibatasi secara cermat. Hal ini tidak membuat setiap jalur akses menjadi identik, dan tidak mengubah tolok ukur vendor menjadi penilaian independen. Pertanyaan yang berguna sebenarnya lebih sederhana: apakah rute yang Anda rencanakan untuk digunakan memberikan konteks, kontrol, ketentuan privasi, dan perilaku model yang dibutuhkan oleh alur kerja Anda?
Bagi tim yang membandingkan beberapa keluarga model di satu tempat, Ruang kerja multi-model GlobalGPT merupakan pilihan praktis selain jalur resmi. Pilihan ini berguna untuk membandingkan model-model yang tersedia dalam tugas yang sama; pastikan direktori saat ini dan cakupan rencana sebelum menetapkan platform mana pun sebagai jalur akses Fable 5.1 Anda.

Apa Itu Claude Fable 5.1?
Anthropic meluncurkan Fable 5.1 bersamaan dengan Mythos 5.1. Perusahaan tersebut menggambarkan keduanya sebagai model dasar yang sama dengan mekanisme perlindungan dan aturan akses yang berbeda: Fable tersedia secara umum, sedangkan Mythos diperuntukkan bagi program akses tepercaya di bidang keamanan siber dan ilmu hayati. Perbedaan tersebut penting. Kemampuan Mythos tidak boleh dianggap sama dengan akses Fable biasa.
Anthropic menempatkan Fable 5.1 dalam konteks pemrograman, pekerjaan berbasis pengetahuan, pemecahan masalah jangka panjang, dan penelitian ilmiah. Hal-hal tersebut merupakan klaim produk, bukan jaminan bahwa setiap platform API menyediakan alat atau batasan yang sama.
Yang membuat rilis ini lebih signifikan daripada sekadar penggantian nama model rutin adalah kombinasi antara kemampuan, pengendalian upaya, efisiensi cache, dan batasan penerapan yang lebih jelas. Bagi seorang pengembang, hal ini dapat berarti model yang lebih mudah dibenarkan untuk tugas-tugas dengan konteks berulang. Bagi tim riset, hal ini berarti memisahkan jawaban yang sangat bergantung pada sumber dari alur kerja yang masih memerlukan akses ke alat, tinjauan manusia, dan ketentuan penyimpanan yang spesifik untuk rute tertentu.
- Gunakan untuk: diagnosis kode, sintesis dokumen, analisis dengan banyak batasan, dan interpretasi gambar menjadi teks.
- Pastikan terlebih dahulu: batasan konteks, ketersediaan alat, masa penyimpanan data, wilayah, dan akses paket pada rute yang Anda pilih.
- Jangan menyimpulkan: bahwa akses Mythos, spesifikasi khusus cloud, atau tolok ukur resmi secara otomatis berlaku untuk akun Anda.
Sekilas tentang Identitas
Di mana Anda bisa mengakses Claude Fable 5.1?
Anthropic menyatakan bahwa Fable 5.1 tersedia di seluruh platformnya dan menyebutkan AWS, Google Cloud, dan Microsoft Azure. Pada API Anthropic, pengenal modelnya adalah claude-fable-5-1. Pada rute AWS Bedrock, aturan konteks, keluaran, masukan, cache, dan retensi yang tercantum dalam dokumentasi merupakan bagian dari dokumentasi AWS dan tidak boleh dianggap berlaku untuk semua rute lainnya.
- API Anthropic: Gunakan pengenal model yang tercantum dalam dokumentasi dan batasan platform saat ini.
- AWS Bedrock: AWS mendokumentasikan jendela konteks sebesar 1 juta token, keluaran maksimum 128 ribu, masukan berupa teks dan gambar, serta keluaran berupa teks untuk layanan route-nya.
- Rute cloud lainnya: Pastikan wilayah, rencana, dukungan alat, dan penanganan data sebelum migrasi.
Rute akses: apa saja yang dapat ditransfer dan apa saja yang tidak
Baca setiap spesifikasi sebagai spesifikasi khusus rute. Nama model saja tidak menjamin adanya batasan, masukan, alat, atau ketentuan data yang sama.
ID Model:
claude-fable-5-1Batas-batas saat ini, wilayah, dan kontrol yang didukung.
Konteks 1M, keluaran 128K, masukan teks/gambar, keluaran teks.
Kualifikasi berdasarkan wilayah dan akun.
ID model yang tepat, keluaran JSON terstruktur, dan masukan gambar PNG.
Alat sistem berkas dan eksekusi agen.
Untuk Apa Fable 5.1 Didesain?
Posisi resmi ini cukup luas, sehingga akan membantu jika kita memisahkan antara apa yang tercatat secara resmi dengan apa yang dapat dipastikan melalui pemeriksaan praktis sederhana. Dalam pengujian input tertutup dan output pertama kami melalui Anywhere API, Fable 5.1 menghasilkan perbaikan JavaScript minimal yang mempertahankan nilai nol, melacak kontradiksi anggaran kumpulan dokumen tanpa menyelesaikannya dengan tebakan, menjaga hasil pengamatan tetap non-kausal, dan mengekstrak nilai berlabel dari bagan PNG. Itu adalah sinyal yang berguna untuk tugas-tugas terbatas, bukan reproduksi dari tolok ukur agen jangka panjang Anthropic.
Rute API yang sama tidak menyediakan akses ke sistem berkas maupun alat validasi. Karena alasan itulah, kami tidak mengklaim hasil yang benar-benar berasal dari agen otonom.
Peta kemampuan: klaim, pemeriksaan, batas
Claude Fable 5.1 Perubahan Harga dan Biaya
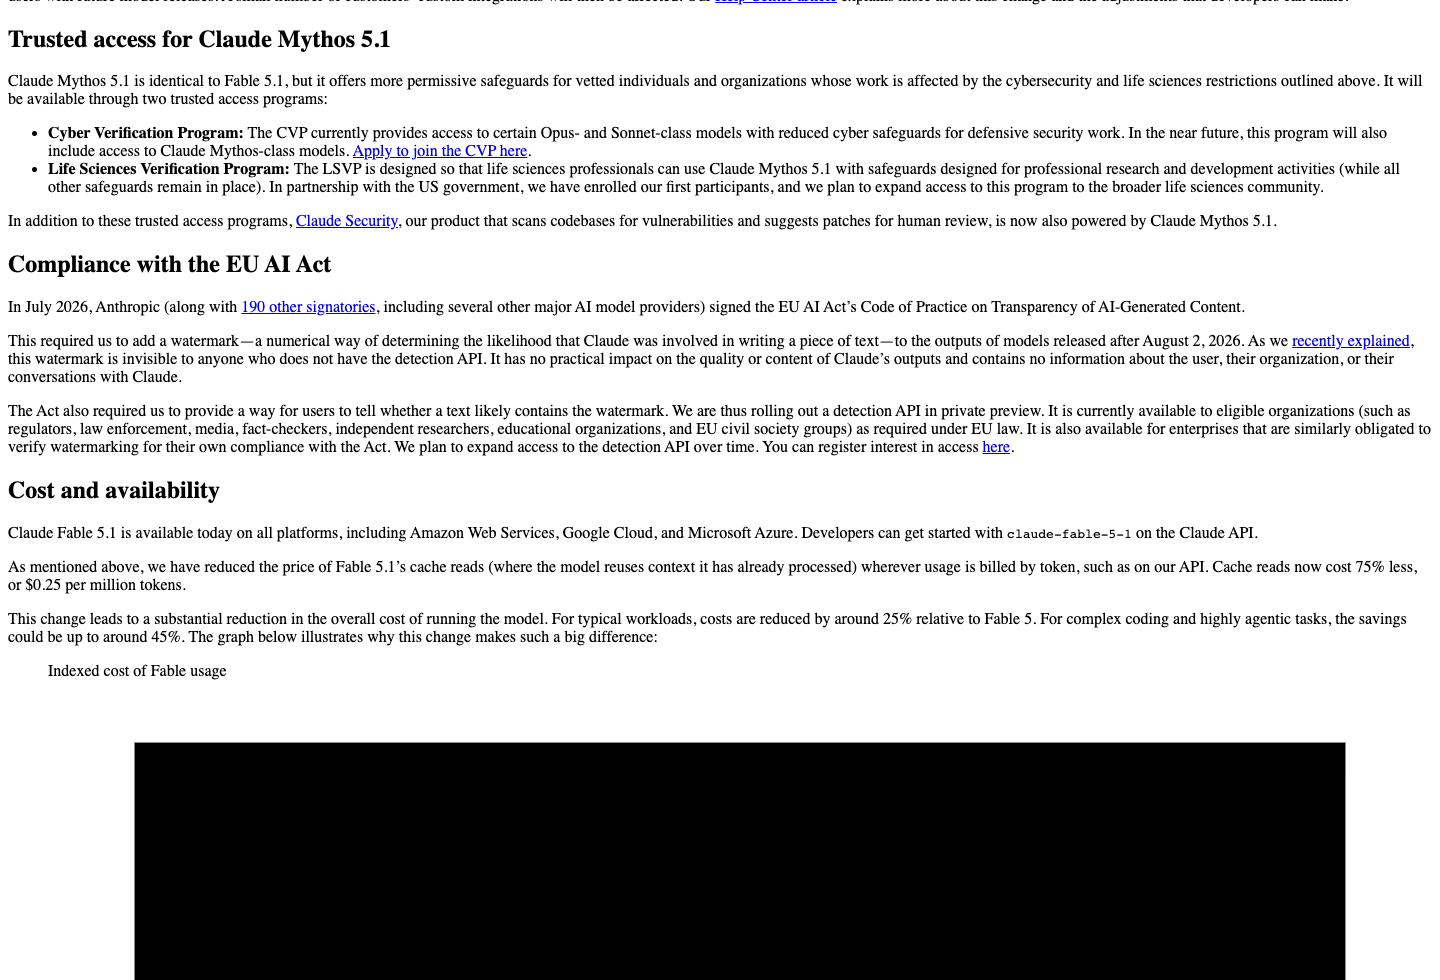
Anthropic mencantumkan Fable 5.1 sebesar $10 per juta token masukan dan $50 per juta token keluaran, dengan tarif yang sama seperti Fable 5. Pembacaan cache sebesar $0.25 per juta token. Anthropic memperkirakan penghematan biaya sekitar 25% untuk beban kerja tipikal dan hingga sekitar 45% untuk pekerjaan agen yang kompleks dan sarat konteks; angka-angka tersebut merupakan perkiraan Anthropic berdasarkan asumsi beban kerja yang dinyatakan, bukan diskon yang dijamin.
Variabel utamanya adalah pemanfaatan ulang. Permintaan yang hanya dilakukan sekali tidak akan banyak mendapat manfaat dari penetapan harga berdasarkan pembacaan cache, sedangkan alur kerja yang berulang kali mengirimkan brief yang panjang, ringkasan basis kode, atau paket kebijakan dapat memanfaatkannya. Untuk konteks generasi sebelumnya, lihat artikel kami Panduan Harga Claude Fable 5. Jika perbandingan yang Anda lakukan adalah antara langganan yang terpisah, bukan penagihan berdasarkan token API, Paket GlobalGPT menyediakan jalur langganan multi-model yang terpisah; jalur tersebut bukanlah konversi dari struktur harga API Anthropic.
Daftar harga resmi API
Geser penggeser untuk volume input bulanan. Perkiraan ini mengasumsikan bahwa output sama dengan 20% dari input, dan 50% dari token input merupakan pembacaan cache.
10 juta token masukan per bulanClaude Fable 5.1 vs Fable 5: Apakah Ini Peningkatan yang Signifikan?
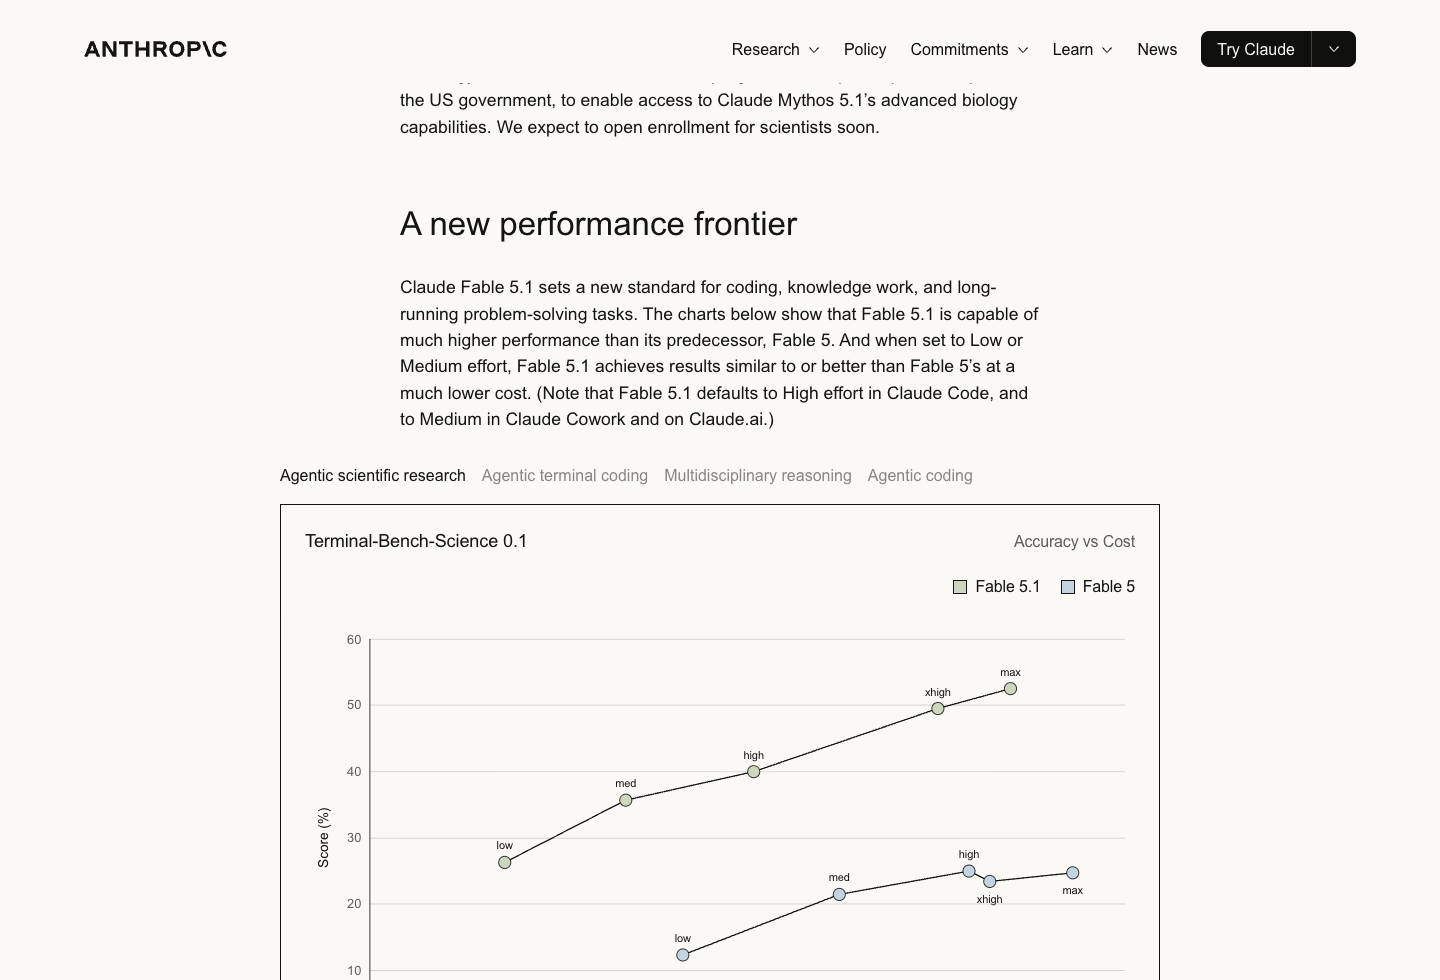
Anthropic mencatat skor Fable 5.1 yang lebih tinggi daripada Fable 5 pada beberapa evaluasi khusus tugas, termasuk 52,6% dibandingkan 24,7% pada Terminal-Bench-Science, 55,8% dibandingkan 42,0% pada Terminal-Bench, 31,4% dibandingkan dengan 17,1% pada AutomationBench, dan 73,4% dibandingkan dengan 70,5% pada CursorBench. Hasil GDPval-AA v2-nya adalah 1853 versus 1723. Angka-angka ini dilaporkan oleh Anthropic dengan rangkaian pengujian dan kondisi mereka sendiri, sehingga lebih berguna sebagai konteks daripada sebagai peringkat keseluruhan yang direproduksi secara independen.
Kami tidak melakukan pengujian baseline langsung Fable 5 di lokasi yang sama. Oleh karena itu, kesimpulan jujur mengenai peningkatan ini bersifat bersyarat: bukti resmi menunjukkan peningkatan kinerja pada tugas tertentu dan biaya pembacaan cache yang lebih rendah, sementara penilaian independen antara Fable 5.1 dan Fable 5 masih belum selesai.
Jika pilihan Anda lebih luas daripada peningkatan ini saja, kami Perbandingan Claude Fable 5 vs GPT 5.5 lebih baik dijadikan bacaan selanjutnya daripada menganggap satu baris hasil pengujian sebagai peringkat universal.
Hasil tugas yang dilaporkan dalam Anthropic
Uji Coba Langsung: Hal-Hal yang Sebenarnya Kami Periksa
Kami menggunakan rute API Anywhere /v1/chat/completions setelah memverifikasi ID model yang dikembalikan claude-fable-5-1 dan sebuah probe keluaran terstruktur berukuran kecil. Setiap hasil di bawah ini merupakan keluaran valid pertama dari tugas yang dibekukan dengan masukan tertutup. Masukan SVG ditolak sebelum T05 mencapai model, sehingga fixture yang identik dikonversi ke PNG dan dijalankan satu kali; tidak ada hasil valid yang diganti.
Bukti hasil pertama
Tanggapan tersebut mengidentifikasi alasan mengapa nilai nol menghilang, mengusulkan perubahan kode yang minimal, dan secara tegas tidak mengklaim telah melakukan uji coba.
{
  "root_cause": "scores.filter(Boolean) menghapus semua nilai yang dianggap "false", termasuk skor numerik 0, sehingga normalize([0, 4, null, undefined]) menghilangkan angka 0 dan mengembalikan [4] alih-alih [0, 4]. Predikatnya terlalu luas; seharusnya hanya mengecualikan null dan undefined.",
  "unified_diff": "--- a/normalize.js\n+++ b/normalize.js\n@@ -1,3 +1,3 @@\n function normalize(scores) {\n-  return scores.filter(Boolean);\n+  return scores.filter((score) => score != null);\n }",
  "expected_test_results": "normalize([0, 4, null, undefined]) diharapkan mengembalikan [0, 4] karena score != null hanya bernilai false untuk null dan undefined, sehingga 0 tetap dipertahankan. normalize([7]) diharapkan mengembalikan [7], tanpa perubahan. Ini adalah ekspektasi berdasarkan pembacaan kode; tidak ada uji coba yang dilakukan.",
  "remaining_risk": "Nilai-nilai palsu lainnya yang sebelumnya disaring (NaN, string kosong, false) kini akan dipertahankan, yang sesuai dengan persyaratan yang dinyatakan (hanya hapus null/undefined) tetapi mungkin muncul sebagai perubahan perilaku jika ada pemanggil yang mengandalkan penyaringan lama. Jika input bukan array, fungsi ini tetap akan melempar pengecualian, seperti sebelumnya."
}Respons tersebut memetakan klaim-klaim yang diajukan, menemukan konflik antara $18.000 dan $20.000, serta membiarkan penyebabnya tetap belum terselesaikan alih-alih mengada-ada penyebabnya.
{
  "klaim": [{"klaim":"Program percontohan ini dimulai pada 3 Maret dengan 120 siswa yang terdaftar.","source":"Dokumen A","section":"A1","status":"disebutkan"},{"claim":"Kehadiran dicatat setiap minggu.","sumber":"Dokumen A","bagian":"A2","status":"disebutkan"},{"klaim":"Pada titik pemeriksaan tanggal 31 Maret, 96 dari 120 siswa yang terdaftar telah menghadiri setidaknya tiga sesi.","sumber":"Dokumen B","bagian":"B1","status":"dinyatakan"},{"klaim":"Anggaran program sebesar $18.000.","sumber":"Dokumen B","bagian":"B2","status":"bertentangan"},{"klaim":"Catatan keuangan mencantumkan anggaran program yang disetujui sebesar $20.000.","sumber":"Dokumen C","bagian":"C1","status":"bertentangan"},{"klaim":"Catatan tersebut tidak menyebutkan apakah selisih anggaran tersebut mencerminkan revisi atau kesalahan pencatatan.","sumber":"Dokumen C","bagian":"C2","status":"disebutkan"}],
  "kontradiksi": [{"topik":"Anggaran program","sumber":[{"sumber":"Dokumen B","bagian":"B2","nilai":"$18.000"},{"sumber":"Dokumen C","bagian":"C1","nilai":"$20.000"}],"deskripsi":"Dokumen B menyatakan bahwa anggaran program sebesar $18.000, sedangkan Dokumen C mencantumkan anggaran program yang disetujui sebesar $20.000."}],
  "belum terselesaikan": [{"masalah":"Apakah selisih sebesar $2.000 antara anggaran $18.000 (Dokumen B, B2) dan anggaran yang disetujui sebesar $20.000 (Dokumen C, C1) mencerminkan revisi atau kesalahan pencatatan.","source":"Dokumen C","section":"C2","reason":"Dokumen C secara eksplisit menyatakan bahwa catatan tersebut tidak menjelaskan penyebab selisih tersebut, dan tidak ada dokumen lain yang disediakan yang membahas hal tersebut."}]
}Titik akhir obrolan yang terverifikasi tersebut tidak menyediakan alat penulisan berkas maupun alat validasi. Oleh karena itu, tugas tersebut tidak dikirim sebagai uji kualitas model, dan tidak ada hasil maupun skor yang dilaporkan.
Hasil analisis tersebut menghitung selisih yang teramati dan menolak kesimpulan kausal yang tidak didukung bukti.
{
  "mean_control": {"value": 10, "units": "poin"},
  "mean_treatment": {"value": 14, "units": "points"},
  "difference": {"value": 4, "units": "points", "direction": "perlakuan dikurangi kelompok kontrol"},
  "kesimpulan_yang_didukung": "Dalam dataset ini, kelompok perlakuan memiliki skor rata-rata 4 poin lebih tinggi daripada kelompok kontrol (14 vs. 10 poin).",
  "kesimpulan_yang_tidak_didukung": "Bahwa perlakuan menyebabkan skor yang lebih tinggi sebesar 4 poin; kelompok-kelompok tersebut tidak ditugaskan secara acak dan tidak ada skor awal yang dikumpulkan, sehingga perbedaan tersebut mungkin mencerminkan perbedaan yang sudah ada sebelumnya antara kelompok-kelompok tersebut.",
  "keterbatasan": ["Penugasan kelompok tidak acak, sehingga bias seleksi tidak dapat dikesampingkan", "Tidak ada skor awal, sehingga perbedaan yang sudah ada sebelumnya antara kelompok tidak dapat dinilai", "Ukuran sampel sangat kecil (n=4 per kelompok)", "Tidak ada statistik inferensial yang dihitung; perbedaan tersebut belum diuji signifikansinya secara statistik", "Desain observasional tidak mendukung klaim kausal"]
}Proses PNG tersebut menghasilkan nilai-nilai berlabel untuk bulan April, membedakan perkiraan visual dari nilai-nilai berlabel, dan menghindari ekstrapolasi yang tidak memiliki dasar.
{
  "april_alpha": 30,
  "april_beta": 25,
  "trend": "Baik Alpha maupun Beta meningkat secara stabil setiap bulan dari Januari hingga April, dengan Alpha secara konsisten sekitar 5 jam di atas Beta (diperkirakan secara visual: Januari ~15/10, Feb ~20/15, Mar ~25/20, Apr 30/25 seperti yang tertera).",
  "unsupported": ["Nilai bulan April secara eksplisit tertera pada grafik; nilai Januari, Februari, dan Maret hanyalah perkiraan visual", "Tidak ada data setelah April atau sebelum Januari yang ditampilkan, sehingga tidak dapat dibuat klaim mengenai bulan-bulan lainnya", "Satuan dilabeli sebagai jam belajar tetapi tidak ada sumber, ukuran sampel, atau definisi kelompok Alpha/Beta yang diberikan"]
}
Batas Keamanan, Data, dan Kompatibilitas
Fable 5.1 dapat digunakan untuk mengidentifikasi kerentanan perangkat lunak, namun Anthropic menyatakan bahwa hal ini tidak dimaksudkan untuk pengembangan eksploit dan mungkin akan mengalihkan beberapa pekerjaan dengan kegunaan ganda ke Opus. Penelitian ilmu hayati dan akses ke Mythos memiliki batasan yang terpisah. Retensi data bergantung pada jalur akses: dokumentasi AWS, misalnya, tidak boleh diterapkan secara umum ke setiap jalur Claude atau API pihak ketiga.
Anthropic juga mencatat adanya celah dalam cakupan penyelarasan modelnya sendiri untuk skenario konteks yang sangat panjang, multi-agen, dan tugas yang mustahil. Hal tersebut merupakan alasan untuk memvalidasi penerapan berisiko tinggi dengan tugas terbatas Anda sendiri, bukan alasan untuk mengabaikan peningkatan yang telah didokumentasikan dari model tersebut.
Siapa yang Sebaiknya Mencoba Claude Fable 5.1?
Cobalah jika pekerjaan Anda akan mendapat manfaat dari dukungan pemrograman yang cermat, sintesis berbasis sumber, pemeriksaan kontradiksi dokumen, atau ekstraksi gambar ke teks. Lakukan verifikasi terlebih dahulu jika Anda memerlukan penerapan regional tertentu, ketentuan tanpa penyimpanan data, agen yang menggunakan alat bantu, atau perbandingan langsung Fable 5. Jika Anda memilih paket Claude umum daripada akses API, maka Panduan harga Claude AI menjelaskan perbedaan antara rencana dan API.
Claude Fable 5.1 Pertanyaan yang Sering Diajukan
Apa perbedaan praktis antara Claude Fable 5.1 dan Mythos 5.1?
Anthropic menggambarkan keduanya sebagai model dasar yang sama dengan mekanisme pengamanan dan aturan akses yang berbeda. Fable 5.1 adalah jalur ketersediaan umum yang dibahas di sini. Mythos 5.1 diperuntukkan bagi program akses tepercaya di bidang keamanan siber dan ilmu hayati, sehingga kemampuan Mythos tidak menjamin adanya akun Fable standar.
Apakah saya bisa menggunakan Claude Fable 5.1 di aplikasi Claude, atau apakah fitur tersebut hanya tersedia melalui API?
Jangan menyimpulkan akses ke aplikasi konsumen hanya berdasarkan pengumuman API atau layanan cloud. Anthropic menyebutkan platformnya sendiri dan penyedia layanan cloud utama sebagai jalur akses, namun rencana, wilayah, kuota, dan rangkaian alat yang digunakan bergantung pada jalur yang dipilih. Pastikan untuk memeriksa cakupan akun yang tepat yang akan Anda gunakan sebelum mengubah alur kerja yang terkait dengannya.
Apa ID model Claude Fable 5.1 yang benar?
Daftar Anthropic claude-fable-5-1 untuk API-nya. Penyedia layanan cloud dapat menggunakan pengenal khusus rute; oleh karena itu, salin ID model dari dokumentasi penyedia untuk titik akhir yang sebenarnya Anda panggil.
Apakah Claude Fable 5.1 memiliki jendela konteks sebesar 1 juta token?
AWS mencantumkan jendela konteks sebesar 1 juta token dan batas keluaran maksimum sebesar 128 ribu untuk rute Bedrock-nya. Informasi ini berguna untuk perencanaan Bedrock, namun tidak boleh digeneralisasikan ke setiap API Claude, konsumen, atau rute pihak ketiga tanpa memeriksa dokumentasi masing-masing.
Apakah Fable 5.1 dapat menerima gambar dan menghasilkan gambar?
AWS mendokumentasikan masukan teks dan gambar dengan keluaran teks untuk rute Bedrock. Artinya, pemahaman gambar telah didokumentasikan di sana; hal ini tidak berarti bahwa model tersebut merupakan generator gambar atau bahwa setiap rute menerima format yang sama. Dalam pemeriksaan API terbatas yang kami lakukan, masukan PNG berhasil diproses setelah masukan SVG ditolak oleh lapisan permintaan.
Kapan harga pembacaan cache yang lebih rendah menjadi faktor penentu?
Hal ini menjadi penting ketika konteks besar yang sama digunakan kembali di berbagai permintaan: misalnya, ringkasan basis kode yang bersifat persisten, kumpulan kebijakan, atau paket penelitian yang panjang. Untuk prompt pendek yang terpisah, volume input dan output normallah yang menjadi faktor utama dalam biaya. Gunakan kalkulator di atas sebagai perkiraan perencanaan, lalu bandingkan dengan perilaku caching aktual dari rute Anda.
Apakah Fable 5.1 dapat menjalankan agen yang menggunakan alat secara mandiri?
Itu tergantung pada lingkungan di sekitar model. Sebuah titik akhir (endpoint) pelengkapan obrolan dapat menghasilkan jawaban teks yang komprehensif tanpa melibatkan penulisan berkas, validator, penjelajahan, atau lingkungan sandbox repositori. Rute pengujian kami tidak melibatkan alat-alat tersebut, sehingga tidak digunakan untuk mengklaim adanya eksekusi agen otonom.
Apakah Claude Fable 5.1 benar-benar lebih baik daripada Fable 5?
Anthropic melaporkan peningkatan kinerja pada tugas tertentu serta harga pembacaan cache yang lebih rendah. Hal ini menjadi alasan kuat untuk mempertimbangkan peningkatan pada pekerjaan yang serupa dengan yang Anda kerjakan, namun bukan berarti ini merupakan kesimpulan mutlak bahwa Anthropic selalu unggul. Artikel ini tidak menyertakan data acuan Fable 5 yang diuji di lingkungan yang sama.
Sumber: Pengumuman Peluncuran Anthropic; Pengumuman AWS; Kartu Model Amazon Bedrock.