
Jawaban singkat: GPT-6 Sol berhasil menyelesaikan ringkasan lima bagian yang diuji dengan batasan keluaran 2.400 token; Claude Opus 5.5 memberikan diagnosis yang lebih akurat dalam tugas peninjauan kode singkat kami. Tak satu pun dari hasil tersebut dapat ditetapkan sebagai pemenang mutlak.
Perbandingan yang bermanfaat ini mencakup aspek yang lebih luas daripada sekadar skor. Claude Opus 5.5 dan GPT-6 Sol memiliki perbedaan dalam cara mereka menangani penulisan, sintesis penelitian, tinjauan kode, respons terstruktur, jalur akses, dan alur kerja sehari-hari. Hasil tugas di bawah ini menunjukkan di mana perbedaan-perbedaan tersebut menjadi penting.
GlobalGPT Menyediakan kedua model tersebut dalam satu langganan multi-model yang terjangkau, bersama dengan model-model lain dan fitur-fitur AI. Satu dasbor dapat mengelola proyek mulai dari tahap riset dan penulisan hingga pemrograman, gambar, dan video, sementara antarmuka baris perintah (CLI) -nya menghubungkan konteks kerja yang sama ke terminal dan alat-alat produksi.
Jawaban singkat
Pilih GPT-6 Sol Pertama, terkait alur kerja penulisan dengan batasan yang diuji di sini; alur kerja tersebut berhasil menyelesaikan kelima bagian dalam batas keluaran bersama sebesar 2.400 token. Pilih Claude Opus 5,5 ketika diagnosis, analisis risiko yang terperinci, dan format JSON yang ketat menjadi lebih penting. Gunakan keduanya ketika pekerjaan mengalami perubahan sepanjang hari.
Keunggulan masing-masing model
Claude Opus 5,5 cocok untuk pekerjaan yang dilakukan secara terencana: meninjau perubahan kode, mengurai persyaratan yang rumit, mengidentifikasi risiko, dan memastikan kepatuhan terhadap kontrak hasil yang ketat. Anthropic memfokuskan pendekatan ini pada penulisan kode, penggunaan komputer, pekerjaan berbasis pengetahuan, keselamatan, serta komunikasi dalam sesi panjang yang lebih alami. Lihat Ulasan Claude Opus 5.5 untuk tampilan terpisah yang berfokus pada model. Ini merupakan pilihan yang wajar ketika tinjauan ulang yang cermat lebih berharga daripada jawaban awal yang lebih singkat.
GPT-6 Sol cocok untuk menghasilkan keluaran sesuai batasan: laporan panjang, memo keputusan, rencana terstruktur, atau draf yang harus mencakup banyak bagian yang diminta. OpenAI menggambarkannya sebagai model GPT-6 yang lebih terjangkau untuk pekerjaan profesional, keakuratan fakta, pemrograman, penggunaan komputer, dan kolaborasi. The Ulasan GPT-6 Sol membahas model tersebut secara terpisah; dalam tugas format panjang ini, model tersebut menyelesaikan kontrak pada hasil pertama, yang berguna ketika biaya akibat adanya bagian yang hilang cukup tinggi.
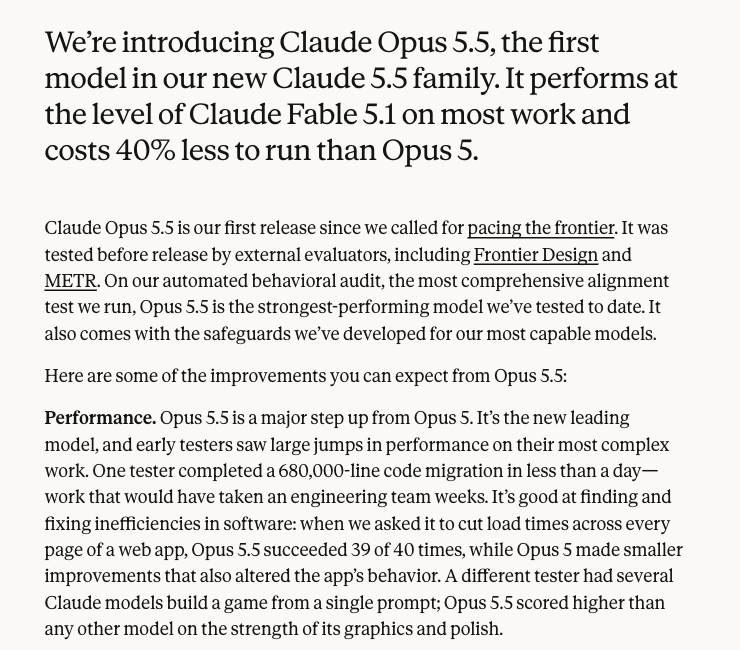
Ini adalah laporan resmi dari Anthropic mengenai peluncuran tersebut, termasuk contoh-contoh dari para penguji awal. Laporan ini mendukung arah pengembangan yang direncanakan untuk produk tersebut; namun, laporan ini tidak menyajikan hasil perbandingan langsung dengan GPT-6 Sol. Prompt yang disesuaikan di bawah ini membahas pertanyaan yang lebih spesifik mengenai hasil yang dihasilkan masing-masing model dalam pengujian ini.
Perbandingan fitur dan kemampuan
Claude Opus 5.5 vs GPT-6 Sol: peta kemampuan
| Area pengambilan keputusan | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Penulisan berbentuk panjang | Ahli dalam menyusun draf yang cermat dan penuh nuansa serta mencantumkan peringatan yang jelas | Mahir dalam menyelesaikan tugas yang panjang dan memiliki banyak batasan dalam satu kali proses |
| Sintesis penelitian | Rekonsiliasi terperinci dan penjelasan risiko | Ringkasan sintesis yang ringkas dengan rekomendasi yang jelas |
| Pemrograman dan peninjauan | Diagnosis yang akurat dan pelaporan risiko yang terstruktur | Patch minimal yang berguna; memverifikasi penjelasan untuk kasus-kasus khusus |
| Hasil terstruktur | JSON yang valid dan konsisten dalam tugas yang diuji | JSON yang valid dengan semua kunci yang diminta dalam tugas yang diuji |
| Multimodal dan alat bantu | Periksa rute dan model akses untuk tugas tertentu | Periksa rute dan model akses untuk tugas tertentu |
| Gaya kerja terbaik | Peninjauan yang cermat, penalaran yang kompleks, dan pekerjaan yang mempertimbangkan risiko | Telah menyelesaikan ringkasan yang telah diuji dengan batasan tertentu di bawah batas keluaran yang ditetapkan |
Cara membaca ini: Ini adalah kecenderungan alur kerja, bukan peringkat universal. Pilihan yang tepat bergantung pada apakah Anda lebih mengutamakan peninjauan yang cermat atau penyelesaian brief yang padat ini dengan batas hasil yang sama.
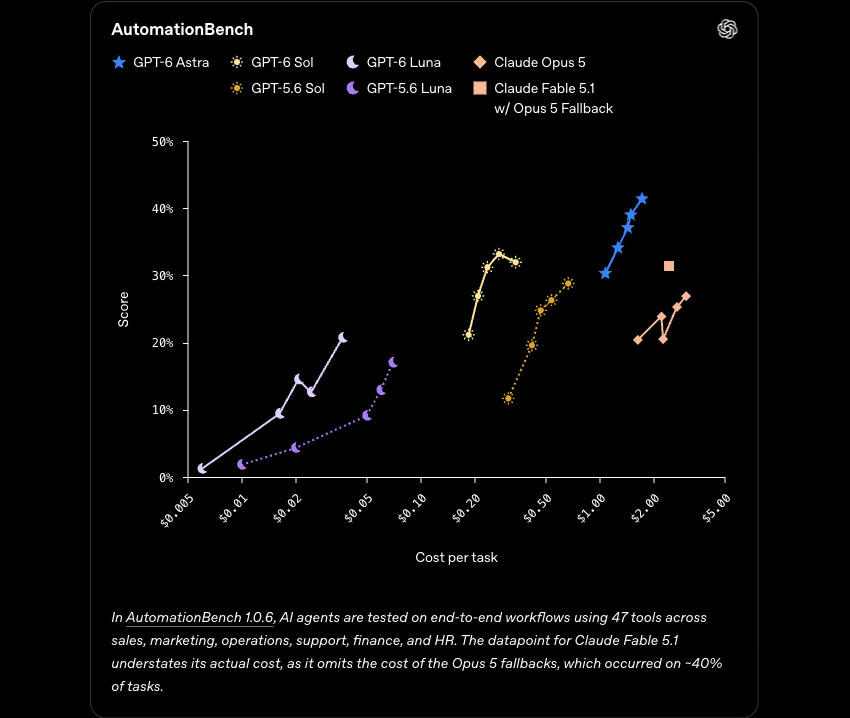
Perhatikan kedua sumbu: pergerakan ke atas menunjukkan skor yang lebih tinggi, sedangkan pergerakan ke kiri menunjukkan biaya per tugas yang lebih rendah. Seri Claude yang dimaksud di sini adalah Opus 5, bukan Opus 5.5. Grafik yang dilaporkan oleh penerbit ini membantu menjelaskan posisi Sol dalam hal efisiensi biaya; namun, grafik ini tidak dapat menjadi penentu perbandingan dalam artikel ini. Catatan kaki tersebut juga menyebutkan bahwa data Fable tidak mencakup beberapa biaya cadangan.
Menulis, dokumen panjang, dan sintesis penelitian
Dalam hal penulisan, tes ini membedakan antara penyelesaian dengan batasan output tetap dan kualitas pemeriksaan editorial. GPT-6 Sol menunjukkan kinerja yang lebih baik pada kontrak bentuk panjang. Claude Opus 5.5 menunjukkan kinerja yang lebih baik ketika tugasnya adalah mendiagnosis, menilai, dan menjelaskan. Untuk catatan penelitian, kedua model mencapai hasil praktis yang sama, sehingga kualitas bahan sumber dan proses peninjauan masih lebih penting daripada pemenang berdasarkan judul.
- Gunakan GPT-6 Sol untuk membuat draf awal dengan banyak batasan, memo keputusan, atau rencana konten terstruktur.
- Gunakan Claude Opus 5.5 untuk menguji asumsi, mengidentifikasi risiko, dan menyempurnakan draf sebelum diserahkan kepada klien atau diterapkan pada sistem produksi.
- Jika fakta menjadi hal yang penting, berikan bahan sumber kepada salah satu model tersebut dan tetap lakukan tahap peninjauan oleh manusia.
Pemrograman, hasil yang terstruktur, dan pekerjaan yang siap diproses oleh alat
Kedua model tersebut menghasilkan JSON yang valid dengan semua kunci yang diminta serta patch minimal yang sama. Claude mendeskripsikan filter yang ada dengan benar; sedangkan GPT-6 Sol secara keliru menyatakan bahwa elemen None akan memicu kesalahan. Hal ini mendukung penggunaan Claude untuk diagnosis dalam tugas khusus ini. Tipe bidang risiko tidak ditentukan dalam prompt, sehingga string risiko yang dihasilkan Sol tidak melanggar kontrak.
Untuk pekerjaan yang siap diproses oleh alat, tentukan spesifikasi keluaran yang benar-benar Anda butuhkan: format JSON yang valid, kolom yang lengkap, perintah yang dapat direproduksi, dan patch yang dapat diterapkan tanpa perlu interpretasi. Kedua model tersebut dapat menjadi bagian dari alur kerja tersebut, dengan pengujian dan tinjauan tetap dilibatkan dalam prosesnya.
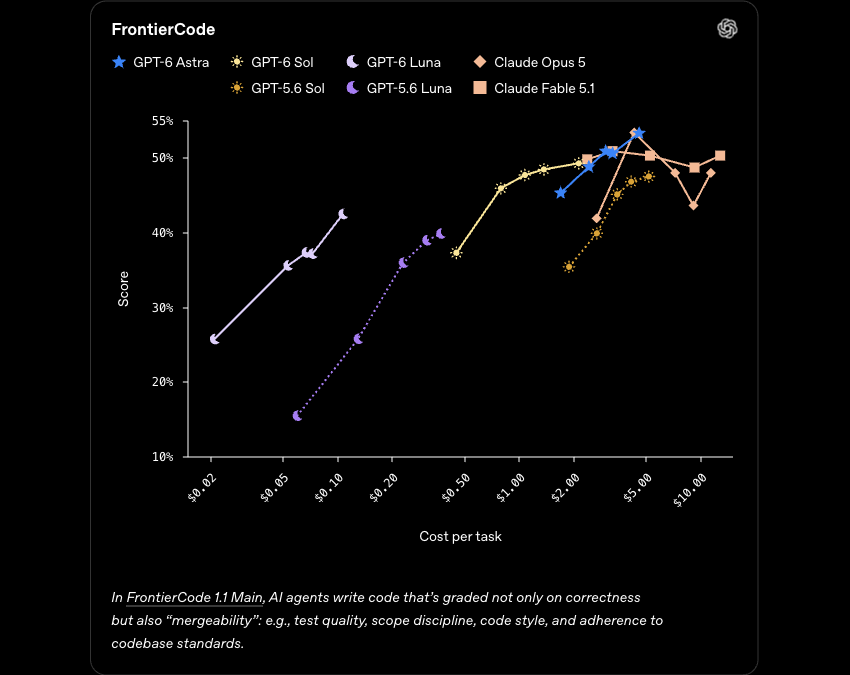
Tolok ukur ini mencakup pengkodean agensial yang lebih luas daripada prompt tinjauan kode singkat kami. Komparator Claude-nya adalah Opus 5, sehingga hal ini berfungsi sebagai konteks untuk posisi pengkodean Sol, bukan sebagai bukti bahwa Sol mengungguli Opus 5.5. Dalam tugas kami sendiri, kedua patch tersebut benar; perbedaan yang berguna terletak pada akurasi diagnosisnya.
Harga dan akses
Harga dan akses: bandingkan rutenya, bukan hanya modelnya
| Rute | Apa yang Anda bayar | Jika memang masuk akal |
|---|---|---|
| Claude Opus 5,5 API | Anthropic mencantumkan $4 per juta token masukan, $20 per juta token keluaran, dan $0,20 per juta token pembacaan cache di halaman rilisnya tanggal 22 September 2026 | Anda sedang mengembangkan sebuah produk atau alur kerja otomatis dan ingin menggunakan sistem penagihan berbasis token secara langsung |
| API GPT-6 Sol | OpenAI mencantumkan $2 per juta token masukan dan $10 per juta token keluaran, dengan pengurangan sebesar 50% dari harga promosi GPT-5.6 Sol; pembacaan masukan yang disimpan dalam cache mendapatkan diskon sebesar 90% | Anda memerlukan kontrak API penyedia langsung dan ingin biaya per penggunaan yang lebih rendah untuk pekerjaan berkelanjutan |
| GlobalGPT | Satu langganan terjangkau yang mencakup kedua model tersebut serta banyak model dan fungsi AI lainnya | Anda ingin mengelola penelitian, penulisan, pemrograman, pengolahan gambar, dan pengeditan video dalam satu dasbor |
Angka-angka ini merupakan tarif token API, bukan harga langganan. OpenAI menempatkan GPT-6 Sol sebagai anggota dengan biaya lebih rendah dalam keluarga GPT-6 untuk pekerjaan profesional, keakuratan fakta, pemrograman, penggunaan komputer, dan kolaborasi, sedangkan Anthropic menempatkan Claude Opus 5.5 pada bidang pemrograman, penggunaan komputer, pekerjaan berbasis pengetahuan, keamanan, dan komunikasi. GlobalGPT memastikan kedua model dan seluruh rangkaian alat tetap tersedia melalui satu langganan yang terjangkau, sementara antarmuka baris perintahnya (CLI) menghubungkan akses tersebut ke terminal, alur kerja pengembangan, dan alat produksi yang sudah ada.
Sumber primer: Halaman rilis Claude Opus 5.5 dari Anthropic dan Halaman rilis GPT-6 Sol dan Luna dari OpenAI.
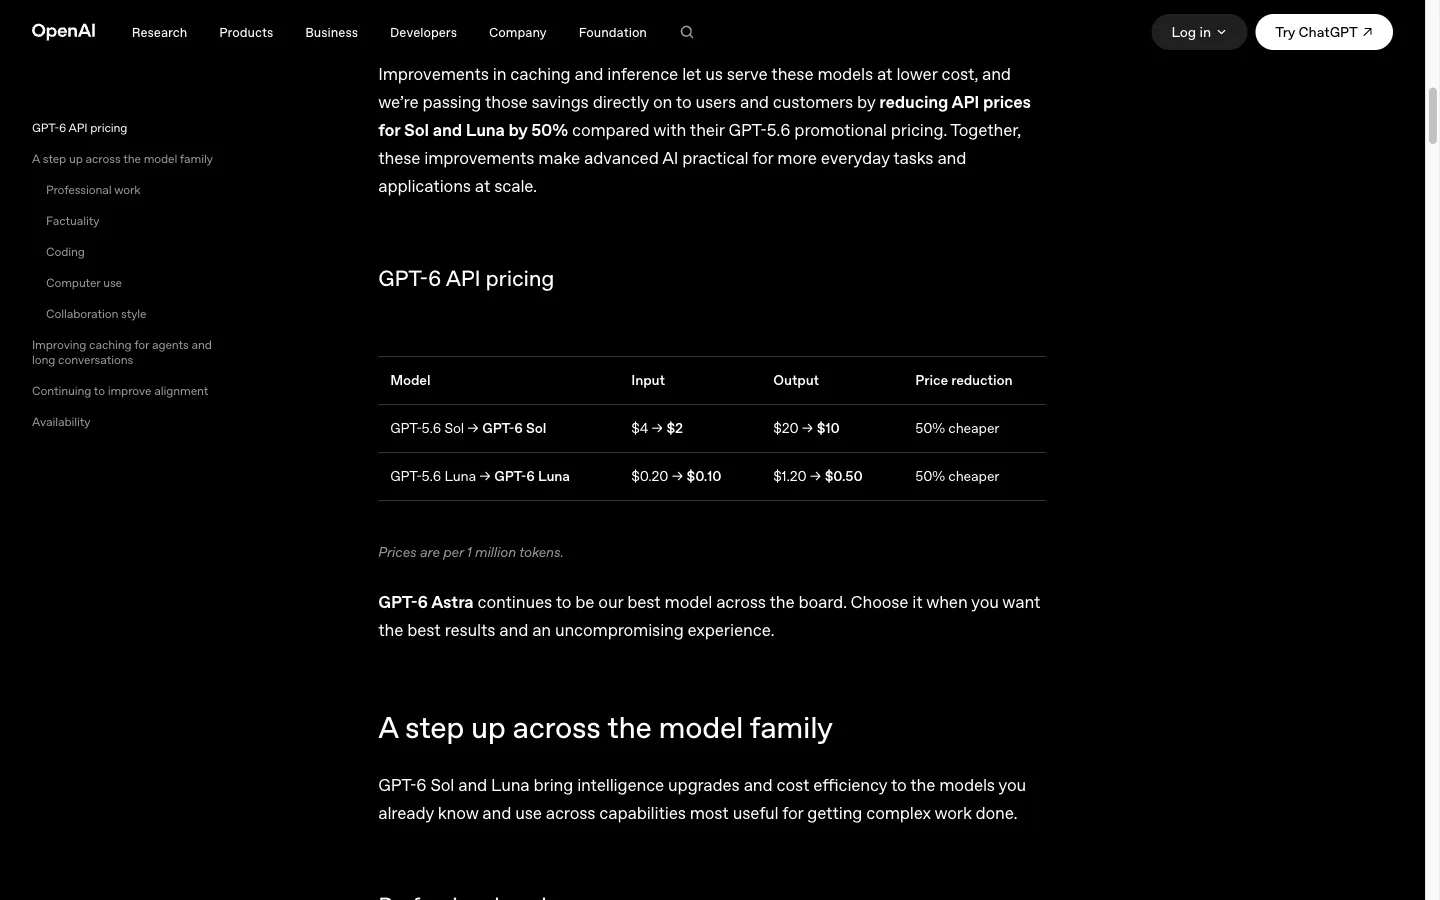
Tarif-tarif ini berlaku untuk token API. Tarif-tarif tersebut tidak mencakup langganan bulanan untuk konsumen maupun paket GlobalGPT.
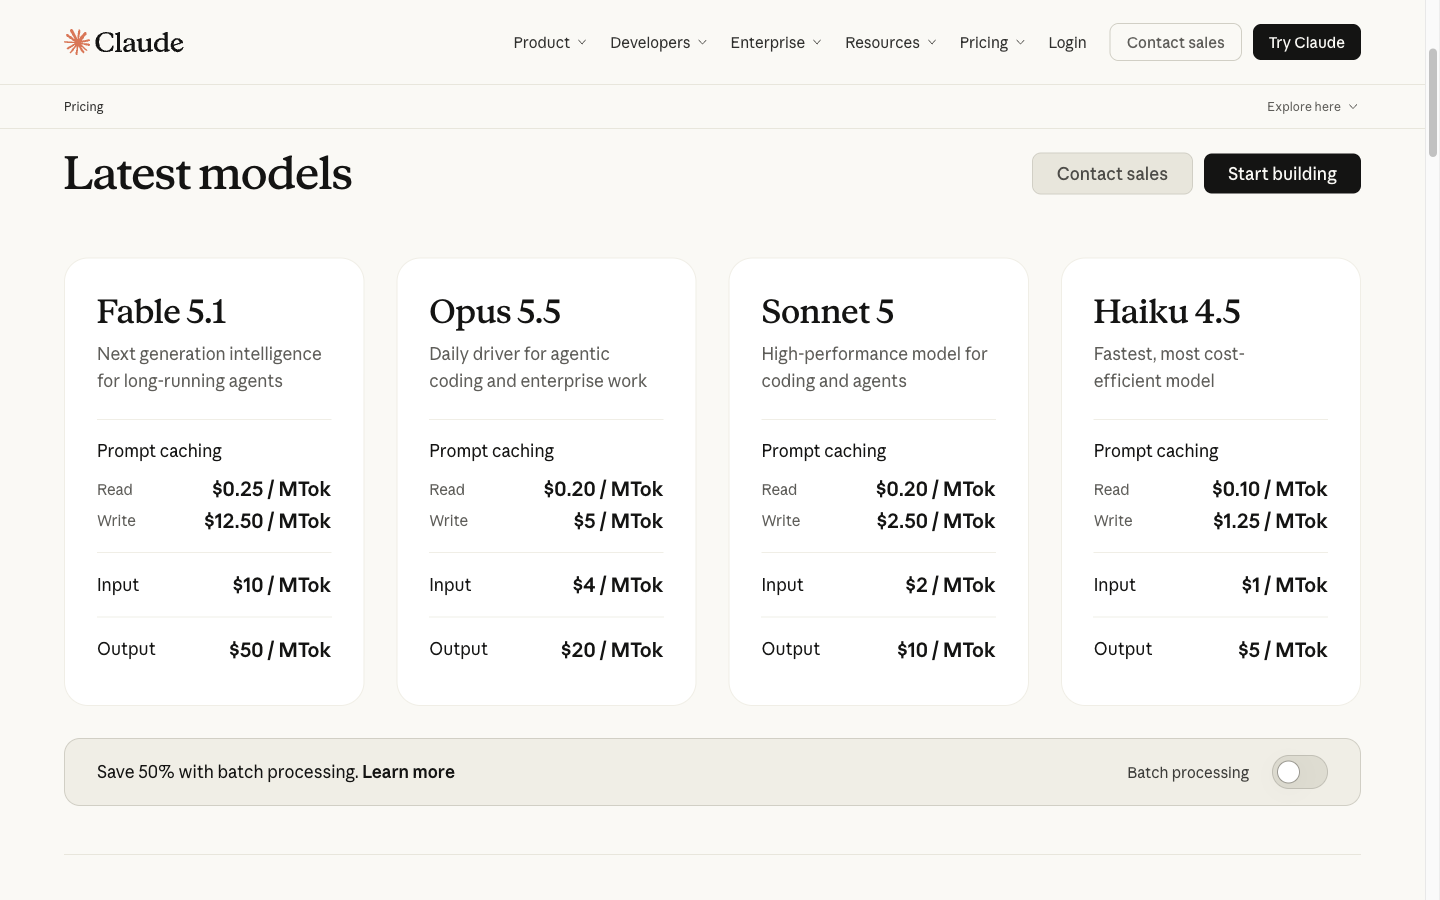
Laju input dan output standar Opus 5.5 dua kali lipat dari Sol, sementara laju pembacaan dari cache yang dipublikasikan untuk keduanya adalah $0.20/M. Oleh karena itu, alur kerja yang banyak menggunakan cache dapat memiliki selisih biaya yang berbeda dibandingkan dengan yang tidak menggunakan cache; bandingkan komposisi token yang sama sebelum memutuskan berdasarkan harga.
Apa arti perbedaan tingkat tersebut untuk beban kerja yang sama
Contoh perhitungan: 1 juta token masukan yang tidak disimpan dalam cache + 100.000 token keluaran, tarif API standar. Warna teal menunjukkan biaya input; warna karat menunjukkan biaya output.
Biaya Sol hanya setengah dari biaya untuk kombinasi token yang sama persis ini. Itu hanyalah perhitungan berdasarkan daftar tarif, bukan klaim bahwa setiap tugas yang diselesaikan biayanya setengah dari itu: upaya ulang, panjang keluaran, hit cache, biaya alat, dan pengaturan penalaran dapat memengaruhi tagihan.
Sumber: Harga API Anthropic dan Harga peluncuran OpenAI, diperiksa pada tanggal 25 September 2026.Perkiraan biaya API langsung
Kalkulator Biaya API
Masukkan token yang ingin Anda kirim dan terima. Perkiraan ini menggunakan tarif API yang telah diverifikasi di atas: Claude Opus 5,5 dengan input $4/M dan output $20/M; GPT-6 Sol dengan input $2/M dan output $10/M.
| Model | Laju masukan | Laju keluaran | Perkiraan biaya |
|---|---|---|---|
| Claude Opus 5,5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
Ini adalah perkiraan tagihan berbasis token untuk penggunaan API secara langsung. Perkiraan ini tidak memperhitungkan harga langganan konsumen atau paket GlobalGPT, serta tidak mencakup diskon cache, alat bantu, pajak, dan biaya lain yang berlaku khusus bagi penyedia layanan.
Siapa yang sebaiknya memilih model mana?
Model mana yang sebaiknya Anda pilih?
| Prioritas Anda | Pilih dulu | Mengapa |
|---|---|---|
| Sebuah memo panjang yang disusun dengan rapi namun memiliki banyak kendala | GPT-6 Sol | Tugas bentuk panjang yang telah direvisi mencapai aturan keputusan yang diminta dalam satu hasil |
| Diagnosis kode, JSON yang ketat, dan risiko yang jelas | Claude Opus 5,5 | Tugas pemrograman tersebut menghasilkan diagnosis yang lebih akurat serta inventarisasi risiko |
| Catatan penelitian yang perlu diselaraskan | Salah satu dari keduanya | Hasil tugas sintesis sumber terkendali menunjukkan hasil imbang |
| Alur kerja mingguan yang beragam | GlobalGPT dengan keduanya | Simpan pilihan model, penulisan kode, pemrograman, gambar, dan video dalam satu dasbor; gunakan CLI saat pekerjaan beralih ke terminal |
Gunakan kedua model tersebut dalam satu alur kerja yang lengkap
Alur kerja GlobalGPT yang praktis
- Mulailah dengan ringkasan penelitian dan mintalah satu model untuk mengungkap asumsi-asumsinya.
- Pindahkan sketsa yang sudah diperbaiki ke model lainnya untuk proses penggambaran atau mendapatkan masukan tambahan.
- Gunakan pendekatan pemrograman yang lebih kuat untuk implementasi, peninjauan, dan hasil keluaran yang terstruktur.
- Simpan hasil pekerjaan tersebut di dasbor yang sama, lalu gunakan Alur kerja CLI GlobalGPT ketika perlu dimasukkan ke dalam terminal atau alat produksi.
Alur kerja itulah yang menjadi nilai utama dari akses ke kedua model tersebut: Anda dapat mengalokasikan tugas, alih-alih harus menyesuaikan proses Anda agar sesuai dengan satu model tertentu.

Bagaimana perbandingan tersebut dilakukan
Kedua model tersebut menerima pesan sistem, masukan tugas, dan materi sumber yang sama, serta tidak menggunakan alat bantu atau penjelajahan apa pun. Setiap hasil mempertahankan keluaran pertama yang dihasilkan, termasuk pemotongan akibat batasan keluaran. Ini merupakan perbandingan praktis untuk memilih alur kerja, bukan peringkat universal atas setiap kemampuan.
Metode perbandingan
Bagaimana perbandingan ini dilakukan
| Kondisi | Aturan perbandingan |
|---|---|
| Model | Claude Opus 5.5 dan GPT-6 Sol, ID yang tepat telah dikonfirmasi di direktori model live |
| Kesetaraan prompt | Pesan sistem yang sama, petunjuk tugas, bahan sumber, tanpa alat atau penjelajahan |
| Tugas | Pemeriksaan batas T01, perbandingan bentuk panjang eksplisit T01R, sintesis sumber T02, kode/JSON T03 |
| Upaya Ulang | Hanya kegagalan terkait transportasi/kapasitas/amplop kosong; hasil lemah yang valid tetap dipertahankan |
| Pencetak Gol | 10 poin per tugas yang dinilai: kontrak objektif 4, keterlacakan 3, kegunaan 2, format 1 |
Prompt pertama memeriksa apakah suatu model akan dapat menebak ketika konteks kunci tidak tersedia, sehingga prompt ini dipisahkan dari perhitungan pemenang. Perbandingan langsung ini menyebutkan kedua model tersebut dan memberikan arahan yang sama kepada keduanya. Tidak dilakukan pengulangan uji stabilitas.
Mengapa prompt pertama tidak memilih pemenang
Penanganan konteks
Mengapa prompt pertama tidak memilih pemenang
Kedua model tersebut menolak untuk menciptakan identitas model karena prompt aslinya tidak menyebutkan nama mereka. Itu memang respons yang tepat terhadap konteks yang hilang, tetapi hal itu tidak dapat memberi tahu kita model mana yang lebih baik dalam mengerjakan tugas tersebut.
Claude Opus 5,5 · input penuh
Anda sedang membandingkan dua model AI untuk panduan praktis bagi pembeli. Dengan hanya menggunakan paket sumber di bawah ini, tulislah 700–900 kata dengan judul-judul berikut persis seperti ini: Keputusan, Bukti, Peringatan, Langkah Selanjutnya. Pertahankan fakta-fakta berikut secara tepat: Proyek North memiliki tenggat waktu 12 minggu; anggaran migrasi sebesar $48.000; tinjauan keamanan belum dijadwalkan. Jika ada fakta yang belum jelas, sebutkan secara eksplisit. Jangan mengarang harga, tolok ukur, atau kemampuan produk.

PAKET SUMBER:
Proyek North adalah migrasi selama 12 minggu untuk tim yang terdiri dari 40 orang. Anggaran migrasi yang disetujui adalah $48.000. Waktu tinjauan keamanan belum dijadwalkan. Tim menginginkan rekomendasi model untuk penelitian, penulisan, dan tinjauan kode. Sebuah catatan dari pemangku kepentingan menyebutkan bahwa draf saat ini terlalu panjang, tetapi tidak mencantumkan jumlah kata.

Kembalikan hanya panduan ini.
Claude Opus 5,5 · daya penuh
## Keputusan

Tidak ada rekomendasi yang dapat diberikan mengenai kedua model tersebut berdasarkan paket sumber yang disediakan. Paket tersebut tidak menyebutkan nama model mana pun, maupun memberikan informasi mengenai harga, hasil uji banding, atau kemampuan produk. Memilih salah satu model daripada yang lain saat ini berarti mengada-ada bukti yang seharusnya menjadi dasar panduan ini.

Keputusan praktisnya adalah menunda pemilihan model. Perlakukan fase berikutnya sebagai evaluasi terstruktur yang diatur oleh tiga batasan tetap:

- Proyek North memiliki tenggat waktu 12 minggu.
- Anggaran migrasi sebesar $48.000.
- Peninjauan keamanan belum dijadwalkan.

Model apa pun yang akan dilanjutkan harus sesuai dengan batas waktu 12 minggu dan anggaran migrasi sebesar $48.000. Model tersebut juga harus lulus tinjauan keamanan, dan tinjauan tersebut belum dijadwalkan. Sampai kedua model diidentifikasi dan dievaluasi berdasarkan tiga tujuan yang dinyatakan tim (penelitian, penulisan, dan tinjauan kode), pemilihan model tetap belum terselesaikan. Panduan ini menyatakan hal tersebut secara jelas daripada menawarkan preferensi yang tidak didukung oleh bukti.

## Bukti

Paket sumber berisi fakta-fakta berikut, dan hanya fakta-fakta inilah yang menjadi dasar panduan ini:

- **Ruang lingkup dan waktu:** Proyek North adalah migrasi selama 12 minggu.
- **Ukuran tim:** Migrasi ini melayani tim beranggotakan 40 orang.
- **Anggaran:** Anggaran migrasi yang disetujui adalah $48.000.
- **Keamanan:** Waktu tinjauan keamanan belum dijadwalkan.
- **Kasus penggunaan:** Tim menginginkan rekomendasi model untuk penelitian, penulisan, dan tinjauan kode.
- **Masukan pemangku kepentingan:** Sebuah catatan dari pemangku kepentingan menyebutkan bahwa draf saat ini terlalu panjang, tetapi tidak mencantumkan jumlah kata.

Paket tersebut tidak memuat beberapa hal yang biasanya menjadi dasar perbandingan. Paket tersebut tidak mengidentifikasi kedua model yang dibandingkan. Paket tersebut tidak mencantumkan harga per pengguna, per token, atau harga berlangganan untuk kedua opsi tersebut. Paket tersebut tidak menyediakan skor benchmark maupun hasil pengujian internal. Paket tersebut juga tidak menjelaskan apa yang dapat atau tidak dapat dilakukan oleh masing-masing model untuk penelitian, penulisan, atau tinjauan kode. Selain itu, tidak ada penjelasan mengenai ketentuan penanganan data, opsi penerapan, atau persyaratan integrasi.

Karena tidak ada satu pun hal tersebut yang tercantum dalam paket tersebut, panduan ini tidak membuat perkiraan mengenai hal-hal tersebut. Tidak diketahui apakah salah satu model tersebut sesuai dengan anggaran $48.000 untuk tim beranggotakan 40 orang. Tidak diketahui pula apakah salah satu model tersebut berkinerja lebih baik dalam penelitian, penulisan, atau tinjauan kode. Setiap angka atau klaim kemampuan yang ditambahkan di sini akan menjadi rekayasa belaka.

## Peringatan

Beberapa pertanyaan yang belum terjawab memengaruhi cara keputusan ini harus ditafsirkan.

**Identitas model belum jelas.** Perbandingan ini melibatkan dua model AI, tetapi dokumen tersebut tidak menyebutkan model mana yang dimaksud. Setiap penilaian selanjutnya bergantung pada jawaban atas pertanyaan ini terlebih dahulu.

**Ruang lingkup anggaran belum jelas.** Dokumen tersebut menyebut angka $48.000 sebagai "anggaran migrasi yang disetujui." Dokumen tersebut tidak menyebutkan apakah jumlah tersebut dimaksudkan untuk menutupi biaya lisensi model atau biaya penggunaan. Sebaliknya, angka tersebut mungkin hanya mencakup pekerjaan migrasi seperti waktu staf, peralatan, atau layanan. Jika biaya model harus diambil dari anggaran $48.000 yang sama, ruang gerak biaya untuk kedua model tersebut lebih sempit daripada yang disarankan oleh angka utama tersebut. Hal ini perlu dikonfirmasi.

**Waktu pelaksanaan tinjauan keamanan belum ditentukan dan merupakan risiko jadwal.** Tinjauan keamanan belum dijadwalkan. Dengan batas waktu 12 minggu, tinjauan yang belum dijadwalkan merupakan risiko nyata bagi jadwal. Dokumen tersebut tidak menyebutkan berapa lama tinjauan akan berlangsung atau apakah kegagalan tinjauan akan memaksa peralihan ke model lain. Kedua hasil tersebut berpotensi menghabiskan porsi yang signifikan dari 12 minggu tersebut. Tidak ada model yang boleh dianggap disetujui hingga tinjauan selesai.

**Penentuan bobot kasus penggunaan belum diputuskan.** Tim menyebutkan tiga kasus penggunaan: penelitian, penulisan, dan tinjauan kode. Dokumen tersebut tidak menyebutkan apakah ketiganya memiliki bobot yang sama atau apakah salah satunya lebih dominan. Model yang lebih kuat di satu bidang mungkin lebih lemah di bidang lain, dan tanpa penentuan bobot, tidak ada dasar untuk menyeimbangkan hal-hal tersebut.

**Volume penggunaan belum diputuskan.** Tim ini terdiri dari 40 orang, namun dokumen tersebut tidak menyebutkan berapa banyak yang akan menggunakan model tersebut atau seberapa intensif penggunaannya. Volume penggunaan dapat sangat memengaruhi biaya dalam beberapa struktur penetapan harga. Hal ini tidak dapat dinilai tanpa data harga dan perkiraan penggunaan.

**Instruksi mengenai durasi con
GPT-6 Sol · masukan lengkap
Anda sedang membandingkan dua model AI untuk panduan praktis bagi pembeli. Dengan hanya menggunakan paket sumber di bawah ini, tulislah 700–900 kata dengan judul-judul berikut persis seperti ini: Keputusan, Bukti, Peringatan, Langkah Selanjutnya. Pertahankan fakta-fakta berikut secara tepat: Proyek North memiliki tenggat waktu 12 minggu; anggaran migrasi sebesar $48.000; tinjauan keamanan belum dijadwalkan. Jika ada fakta yang belum jelas, sebutkan secara eksplisit. Jangan mengarang harga, tolok ukur, atau kemampuan produk.

PAKET SUMBER:
Proyek North adalah migrasi selama 12 minggu untuk tim yang terdiri dari 40 orang. Anggaran migrasi yang disetujui adalah $48.000. Waktu tinjauan keamanan belum dijadwalkan. Tim menginginkan rekomendasi model untuk penelitian, penulisan, dan tinjauan kode. Sebuah catatan dari pemangku kepentingan menyebutkan bahwa draf saat ini terlalu panjang, tetapi tidak mencantumkan jumlah kata.

Kembalikan hanya panduan ini.
GPT-6 Sol · keluaran lengkap
## Keputusan

Jangan dulu menentukan model pemenang. Paket sumber meminta rekomendasi antara dua model AI, tetapi tidak menyebutkan nama kedua model tersebut maupun menyertakan hasil penelitian, tulisan, atau tinjauan kode. Oleh karena itu, klaim bahwa salah satunya lebih baik tidak memiliki dasar yang kuat. Rekomendasi praktisnya adalah membandingkan kedua kandidat tersebut dengan pekerjaan tim sendiri sebelum membuat pilihan.

Proyek North memiliki tenggat waktu 12 minggu. Anggaran migrasi adalah $48.000. Tinjauan keamanan belum dijadwalkan. Fakta-fakta tersebut membuat keputusan ini mendesak, tetapi tidak membenarkan spekulasi. Pilihan yang tepat harus mempertimbangkan apakah suatu model membantu tim yang beranggotakan 40 orang menyelesaikan tugas-tugas aktualnya, bagaimana penggunaannya sesuai dengan anggaran yang disetujui, dan apa yang masih tidak pasti hingga waktu tinjauan keamanan diketahui.

Perlakukan rekomendasi ini sebagai rekomendasi bersyarat: pilih model yang berkinerja lebih baik pada pekerjaan yang representatif, dapat digunakan dalam anggaran migrasi yang disetujui, dan lolos tinjauan apa pun yang diperlukan untuk penggunaan yang dimaksud. Jika tidak ada kandidat yang memenuhi kondisi tersebut, panduan harus menyatakan bahwa keduanya belum dapat direkomendasikan. Materi yang tersedia tidak membuktikan bahwa salah satu kondisi tersebut telah terpenuhi.

## Bukti

Tim menginginkan rekomendasi model untuk tiga jenis pekerjaan: penelitian, penulisan, dan tinjauan kode. Ini adalah kategori perbandingan yang tepat karena berasal dari kebutuhan yang dinyatakan, bukan dari asumsi kekuatan produk. Paket tersebut tidak memuat contoh hasil keluaran dari kedua model, hasil evaluasi, maupun deskripsi mengenai apa yang ditawarkan oleh kedua kandidat. Paket tersebut juga tidak memuat harga atau tolok ukur. Akibatnya, tidak ada dasar bukti untuk menentukan peringkat model berdasarkan akurasi, kecepatan, kualitas, biaya, atau kesesuaian.

Konteks proyek memang menyediakan kriteria pengambilan keputusan yang berguna. Proyek North adalah migrasi untuk tim beranggotakan 40 orang, sehingga perbandingan harus mencerminkan tugas-tugas yang sebenarnya akan dilakukan oleh anggota tim tersebut. Anggaran migrasi yang disetujui adalah $48.000; setiap usulan penggunaan model harus dievaluasi berdasarkan jumlah tersebut, bukan berdasarkan alokasi fiktif untuk alat AI. Tinjauan keamanan belum dijadwalkan, sehingga waktu pelaksanaan tinjauan—dan dampaknya terhadap adopsi—masih belum jelas.

Seorang pemangku kepentingan menyatakan bahwa draf saat ini terlalu panjang, tetapi tidak memberikan jumlah kata. Hal ini menunjukkan preferensi terhadap kesederhanaan, bukan batasan yang dapat diukur untuk keluaran model. Saat membandingkan contoh tulisan, penilai dapat menilai apakah setiap kandidat mengikuti permintaan untuk bersikap ringkas dan mempertahankan fakta-fakta esensial. Mereka tidak boleh mengklaim bahwa salah satu model memenuhi batas kata yang ditentukan pemangku kepentingan, karena batas tersebut tidak pernah diberikan.

Untuk penelitian, bukti yang berguna adalah apakah setiap kandidat membedakan fakta yang diberikan dari pertanyaan terbuka dan menghindari kesimpulan yang tidak didukung. Untuk penulisan, bukti yang berguna adalah apakah masing-masing kandidat menghasilkan draf yang jelas dan cukup ringkas tanpa mengabaikan batasan yang ada. Untuk tinjauan kode, bukti yang berguna adalah apakah masing-masing kandidat mengidentifikasi masalah dalam contoh yang diberikan dan menjelaskannya dengan cara yang dapat diverifikasi oleh penilai. Ini adalah tes yang diusulkan, bukan temuan mengenai model mana pun.

## Peringatan

Peringatan terbesar adalah bahwa kandidat-kandidat tersebut sendiri belum ditentukan: paket tersebut tidak menyebutkan nama mereka. Paket tersebut juga tidak menjelaskan bagaimana tim akan mengaksesnya, berapa biayanya, atau apakah salah satunya tersedia untuk pekerjaan yang dimaksud. Kemampuan produk apa pun tidak boleh disimpulkan dari frasa “model AI.” Bahkan perbandingan yang dirancang dengan baik pun tidak dapat menghasilkan rekomendasi produk hingga kandidat dan bukti evaluasi diketahui.

Anggaran migrasi telah disetujui, tetapi dokumen tersebut tidak mengalokasikan bagian apa pun darinya untuk penggunaan atau pengujian model. Jangan menganggap $48.000 sebagai anggaran pembelian AI. Demikian pula, tenggat waktu 12 minggu tidak menetapkan tanggal kapan tinjauan keamanan akan dilakukan. Karena tinjauan keamanan belum dijadwalkan, apakah dan kapan kandidat dapat digunakan sesuai persyaratan tim masih belum jelas.

Tiga penggunaan yang diminta juga dapat menghasilkan hasil yang berbeda. Satu kandidat mungkin lebih disukai untuk satu tugas dan tidak untuk tugas lainnya; paket ini tidak memberikan dasar untuk mengasumsikan adanya satu pemenang tunggal di seluruh bidang penelitian, penulisan, dan tinjauan kode. Sebuah rekomendasi seharusnya memperjelas pertimbangan semacam itu, bukan menyembunyikannya di balik label umum. Jika tim memutuskan bahwa satu kategori lebih penting daripada yang lain, prioritas tersebut harus berasal dari pemangku kepentingan, bukan dari panduan ini.

Terakhir, catatan bahwa draf tersebut terlalu panjang tidak boleh disalahartikan sebagai bukti terkait kinerja model. Catatan tersebut menggambarkan umpan balik terhadap draf saat ini, tanpa menyebutkan penulisnya atau memberikan target panjang. Catatan ini dapat menjadi acuan dalam penyajian rekomendasi akhir, tetapi tidak dapat menentukan hasil perbandingan.

## Langkah selanjutnya

Identifikasi kedua kandidat dan mintalah tim untuk menyediakan tugas-tugas penelitian, penulisan, dan tinjauan kode yang representatif. Berikan setiap model bahan dan instruksi yang sama untuk setiap tugas, termasuk petunjuk untuk menandai ketidakpastian dan menghindari penambahan fakta. Minta penilai mencatat apa yang benar dalam setiap jawaban, apa yang terlewatkan, dan klaim mana yang memerlukan verifikasi. Pisahkan pengamatan khusus tugas agar sampel tulisan yang kuat tidak menggantikan bukti mengenai tinjauan kode.

Sebelum memilih, pastikan biaya penggunaan yang direncanakan sesuai dengan anggaran migrasi $48.000 dan tentukan kapan tinjauan keamanan dapat dilakukan. Jawaban untuk kedua hal tersebut tidak terdapat dalam paket. Jika pertanyaan-pertanyaan tersebut tidak dapat diselesaikan tepat waktu untuk pengambilan keputusan, laporkan kendala tersebut secara jelas daripada menyajikan preferensi sementara sebagai pilihan yang telah disetujui.

Rekomendasi akhir kepada pembeli kemudian dapat dibuat singkat dan dapat diaudit: sebutkan kandidat-kandidatnya, nyatakan bukti untuk masing-masing dari tiga penggunaan tersebut, jelaskan trade-off apa pun, dan identifikasi pertanyaan-pertanyaan yang masih tertunda terkait persetujuan atau anggaran. Selama informasi tersebut belum tersedia, jawaban jujur untuk Proyek North bukanlah “Model A” atau “Model B.” Jawabannya adalah bahwa perbandingan tersebut belum didukung oleh bukti.
Anggaplah ini sebagai penilaian dalam konteks, bukan peringkat kualitas.
Penulisan berbentuk panjang
Penyelesaian dengan batas keluaran yang sama, yaitu 2.400 token
Tugas yang sama mensyaratkan lima bagian. Kedua model memiliki batas keluaran sebesar 2.400 token; metadata yang dihasilkan menjelaskan perbedaan yang terlihat tersebut.
Claude telah mencapai batas keluaran yang ditetapkan sebelum aturan Keputusan. Sol menyelesaikan ringkasan tersebut dalam batas tersebut. Hal ini mendukung rekomendasi untuk proses eksekusi yang dibatasi ini, bukan peringkat umum mengenai kemampuan menulis atau kecepatan maksimum. Teks lengkap yang dihasilkan, termasuk respons yang dipotong, disertakan di bawah ini.
Tugas berformat panjang
Penulisan panjang: GPT-6 Sol telah menyelesaikan brief tersebut
Ini adalah tugas perbandingan langsung yang pertama. Petunjuknya secara eksplisit menyebutkan Claude Opus 5,5 dan GPT-6 Sol, memberikan paket pengarahan Project North yang sama kepada keduanya, dan meminta surat keputusan bersyarat.
| Ukuran | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Panjang yang terlihat | 648 kata; alasan_penyelesaian=panjang | 1.065 kata; alasan_selesai=berhenti |
| Bagian yang wajib diisi | 4 dari 5; Aturan keputusan hilang setelah pemotongan | 5 dari 5 |
| Kartu penilaian empat baris | Sekarang dan simetris | Sekarang dan simetris |
| Pemeriksaan awal / kondisi penghentian | Sudah dimulai tetapi dihentikan sebelum selesai | Tiga pemeriksaan dan satu kondisi penghentian |
| Skor | 7.0 / 10 | 10.0 / 10 |
Bawa pulang: Dengan batas keluaran yang sama, yaitu 2.400 token, GPT-6 Sol berhasil menyelesaikan kelima bagian tersebut, sedangkan Claude Opus 5.5 mencapai batas tersebut sebelum aturan Keputusan. Hal ini menunjukkan tingkat penyelesaian dalam konfigurasi ini; namun, hal ini tidak menentukan kemampuan menulis maksimum atau kecepatan umum dari kedua model tersebut.
Masukan lengkap yang dibagikan
Anda sedang menyusun memo keputusan untuk sebuah tim yang sedang memilih antara Claude Opus 5.5 dan GPT-6 Sol. Nama-nama model tersebut bersifat tetap dan harus dicantumkan persis seperti yang tertulis. Dengan hanya menggunakan paket bukti di bawah ini, tulislah teks sepanjang 900–1100 kata yang mencakup bagian-bagian berikut secara tepat: Rekomendasi eksekutif; Apa yang didukung oleh bukti; Di mana bukti masih kurang; Uji coba selama 30 hari; Aturan keputusan.

Persyaratan: (1) bandingkan Claude Opus 5.5 dan GPT-6 Sol secara simetris; (2) pisahkan bukti yang teramati, asumsi, dan hal-hal yang belum diketahui; (3) pertahankan tanggal, anggaran, ukuran tim, dan status keamanan yang belum terselesaikan persis seperti aslinya; (4) sertakan kartu skor ringkas berbaris empat yang mencakup sintesis penelitian, penulisan panjang, tinjauan kode, dan JSON terstruktur; (5) berikan rekomendasi bersyarat daripada menentukan pemenang; (6) cantumkan tiga pemeriksaan percontohan yang dapat diukur dan satu kondisi penghentian; (7) jangan mengarang harga, tolok ukur, batasan konteks, atau kemampuan produk.

PAKET BUKTI
- Proyek North adalah migrasi selama 12 minggu untuk tim beranggotakan 40 orang.
- Anggaran migrasi yang disetujui adalah $48.000. Paket tersebut tidak menyebutkan apakah penggunaan model termasuk dalam anggaran tersebut.
- Waktu tinjauan keamanan belum dijadwalkan.
- Tim membutuhkan sintesis penelitian, penulisan panjang, tinjauan kode, dan ekstraksi JSON terstruktur.
- Seorang pemangku kepentingan mengatakan bahwa draf saat ini terlalu panjang, tetapi belum ada jumlah kata target yang disetujui.
- Belum ada hasil terkontrol dari Claude Opus 5,5 atau GPT-6 Sol yang disediakan.
- Tim menginginkan pilihan yang dapat diaudit dan dapat menjalankan uji coba selama 30 hari dengan prompt yang identik serta tinjauan manusia.

Kembalikan hanya memo tersebut. Jangan menyatakan bahwa paket bukti tersebut membuktikan bahwa salah satu model lebih baik.
Claude Opus 5,5 · keluaran yang dikembalikan secara lengkap
## Rekomendasi Eksekutif

Jangan pilih Claude Opus 5.5 atau GPT-6 Sol untuk saat ini. Paket bukti tidak memuat hasil yang dikontrol dari kedua model tersebut. Oleh karena itu, tidak ada dasar yang teramati untuk menyatakan salah satu model lebih baik daripada yang lain pada keempat beban kerja yang diwajibkan.

Rekomendasi ini bersifat bersyarat. Lakukan uji coba selama 30 hari yang memberikan prompt yang identik kepada kedua model dan menerapkan tinjauan manusia yang sama. Kemudian, pilih model yang memenuhi ambang batas yang telah disepakati sebelum uji coba dimulai, asalkan masalah keamanan dan anggaran di bawah ini telah diselesaikan terlebih dahulu. Terdapat tiga kemungkinan hasil:

- **Satu model memenuhi ambang batas:** pilih model tersebut.
- **Keduanya memenuhi:** terapkan aturan penentu pemenang dalam Aturan Keputusan.
- **Keduanya tidak memenuhi:** jangan adopsi keduanya.

Pendekatan ini memberikan tim pilihan yang dapat diaudit seperti yang diminta.

Fakta-fakta proyek yang tetap adalah:

- Proyek North adalah migrasi selama 12 minggu untuk tim yang terdiri dari 40 orang.
- Anggaran migrasi yang disetujui adalah $48.000. Paket tersebut tidak menyebutkan apakah penggunaan model termasuk dalam anggaran tersebut.
- Waktu peninjauan keamanan belum dijadwalkan.
- Paket tersebut tidak mencantumkan tanggal kalender apa pun (tidak ada tanggal mulai proyek, tanggal akhir, atau jendela uji coba), sehingga memo ini tidak menetapkan tanggal apa pun.

## Apa yang didukung oleh bukti

**Bukti yang diamati.** Berikut adalah fakta-fakta yang disebutkan secara langsung dalam paket:

- Proyek North adalah migrasi selama 12 minggu untuk tim yang terdiri dari 40 orang.
- Anggaran migrasi yang disetujui adalah $48.000, dan cakupan penggunaan model di dalamnya tidak disebutkan.
- Waktu peninjauan keamanan belum dijadwalkan.
- Beban kerja yang diperlukan meliputi sintesis penelitian, penulisan panjang, tinjauan kode, dan ekstraksi JSON terstruktur.
- Seorang pemangku kepentingan menyatakan draf saat ini terlalu panjang, namun jumlah kata target belum disetujui.
- Belum ada hasil terkontrol dari Claude Opus 5.5 atau GPT-6 Sol yang disediakan.
- Tim menginginkan pilihan yang dapat diaudit dan dapat menjalankan uji coba selama 30 hari dengan prompt yang identik serta tinjauan oleh manusia.

**Apa yang didukung oleh hal ini.** Bukti ini mendefinisikan apa yang harus dievaluasi dan bagaimana caranya, tetapi tidak menentukan model mana yang unggul. Hal ini membenarkan dilakukannya uji coba terstruktur secara berdampingan. Bukti ini tidak membenarkan klaim apa pun mengenai kualitas, kecepatan, biaya, penanganan konteks, atau ketersediaan fitur untuk kedua model tersebut.

**Kartu Skor (keadaan bukti saat ini)**

| Beban kerja | Claude Opus 5.5 | GPT-6 Sol | Ukuran uji coba |
|---|---|---|---|
| Sintesis penelitian | Tidak ada output terkontrol yang disediakan | Tidak ada output terkontrol yang disediakan | Skor rubrik penilai buta |
| Penulisan bentuk panjang | Tidak ada output terkontrol yang disediakan | Tidak ada output terkontrol yang disediakan | Skor rubrik ditambah kepatuhan terhadap target panjang yang disetujui |
| Peninjauan kode | Tidak ada keluaran terkontrol yang disediakan | Tidak ada keluaran terkontrol yang disediakan | Persentase masalah yang teridentifikasi |
| JSON terstruktur | Tidak ada keluaran terkontrol yang disediakan | Tidak ada keluaran terkontrol yang disediakan | Tingkat kelulusan validasi skema |

Setiap sel untuk kedua model identik karena paket ini memperlakukan keduanya secara sama. Saat ini, tidak ada baris yang mengunggulkan salah satu model.

## Di mana bukti tidak tersedia

**Hal-hal yang belum diketahui.** Paket tersebut tidak menyebutkan hal-hal berikut:

- Apakah biaya penggunaan model termasuk dalam anggaran migrasi $48.000 atau memerlukan pendanaan terpisah.
- Kapan tinjauan keamanan akan dilakukan, apa saja yang akan dicakup, dan apakah salah satu model dapat diterima berdasarkan tinjauan tersebut. Status keamanan untuk kedua model masih belum jelas.
- Tanggal kalender untuk migrasi selama 12 minggu dan uji coba selama 30 hari.
- Target jumlah kata yang disetujui untuk penulisan bentuk panjang. Komentar pemangku kepentingan bahwa teks "terlalu panjang" tidak dapat dievaluasi tanpa adanya target tersebut.
- Harga, hasil benchmark, batasan konteks, dan kemampuan produk untuk Claude Opus 5.5 dan GPT-6 Sol. Tidak ada informasi yang disediakan, dan memo ini tidak mengasumsikan apa pun.
- Siapa saja peninjau manusia, berapa jumlahnya, dan bagaimana perbedaan pendapat di antara mereka akan diselesaikan.
- Data apa saja yang boleh digunakan dalam uji coba sebelum tinjauan keamanan selesai.

**Asumsi.** Ini adalah usulan yang diajukan dalam memo ini, bukan fakta dari paket dokumen, dan masing-masing memerlukan persetujuan tim:

- Program percontohan dapat menggunakan materi non-sensitif atau sintetis sampai tinjauan keamanan mengizinkan penggunaan data nyata.
- Peninjau dapat diblokir dari informasi mengenai model mana yang menghasilkan setiap keluaran.
- Tim dapat menyusun kumpulan prompt tetap untuk setiap beban kerja yang mewakili tugas-tugas nyata Proyek North.
- Ambang batas kelulusan yang diusulkan di bawah ini merupakan titik awal yang dapat diubah oleh tim sebelum uji coba dimulai, tetapi tidak selama uji coba berlangsung.

## Uji coba selama 30 hari

**Desain**

1.
GPT-6 Sol · hasil keluaran lengkap
## Rekomendasi eksekutif

Jangan pilih Claude Opus 5.5 atau GPT-6 Sol untuk saat ini. Proyek North adalah migrasi selama 12 minggu untuk tim beranggotakan 40 orang, dan paket ini tidak menyediakan hasil terkontrol dari kedua model tersebut. Oleh karena itu, paket ini mendukung rencana perbandingan, bukan penilaian kinerja. Jalankan uji coba 30 hari yang tersedia dengan prompt yang identik dan tinjauan manusia, kemudian buatlah pilihan yang dapat diaudit berdasarkan kriteria yang telah disepakati sebelum hasil diperiksa. Pilih salah satu model hanya jika hasil kerjanya yang telah ditinjau memenuhi kebutuhan tim, penggunaannya sesuai dengan pengaturan keuangan yang disetujui, dan tinjauan keamanan yang belum diselesaikan mengizinkan adopsi. Jika kondisi tersebut tidak terpenuhi, tunda pemilihan daripada menganggap perbandingan yang belum lengkap sebagai kemenangan.

Anggaran migrasi yang disetujui adalah $48.000. Paket tersebut tidak menyebutkan apakah penggunaan model termasuk dalam anggaran tersebut. Waktu tinjauan keamanan belum dijadwalkan. Hal-hal tersebut merupakan batasan keputusan bagi Claude Opus 5.5 dan GPT-6 Sol, bukan bukti untuk memilih salah satunya.

## Apa yang didukung oleh bukti

**Pengamatan:** Tim membutuhkan sintesis penelitian, penulisan panjang, tinjauan kode, dan ekstraksi JSON terstruktur. Tim menginginkan pilihan yang dapat diaudit dan dapat menjalankan uji coba 30 hari menggunakan prompt yang identik serta tinjauan manusia. Seorang pemangku kepentingan mengatakan draf saat ini terlalu panjang, tetapi belum ada target jumlah kata yang disetujui. Umpan balik tersebut mengidentifikasi masalah yang perlu diuji dalam hasil tulisan; hal itu tidak menentukan model yang disukai atau panjang yang dapat diterima.

Kartu skor tugas per tugas saat ini sengaja tidak diberi peringkat:

| Alur Kerja | Claude Opus 5.5 | GPT-6 Sol | Bukti uji coba yang perlu dikumpulkan |
|---|---|---|---|
| Sintesis penelitian | Belum diuji | Belum diuji | Akurasi, cakupan, dan keterlacakan yang dinilai oleh peninjau |
| Penulisan panjang | Belum diuji | Belum diuji | Kegunaan, kejelasan, dan kesederhanaan yang dinilai oleh peninjau |
| Peninjauan kode | Belum diuji | Belum diuji | Temuan yang diverifikasi oleh peninjau dan klaim yang tidak didukung |
| JSON terstruktur | Belum diuji | Belum diuji | Keluaran yang valid dan ekstraksi bidang yang benar |

**Asumsi untuk perencanaan, bukan hasil yang diamati:** Contoh karya yang sebanding dan rubrik peninjauan yang sama dapat mengungkap perbedaan yang relevan dengan Project North. Uji coba ini harus menguji asumsi tersebut. Prompt yang identik saja tidak akan membuat pilihan tersebut dapat diaudit: tim juga harus menyimpan masukan, kedua keluaran, kriteria peninjauan, penilaian peninjau, serta alasan untuk setiap pengecualian atau pengulangan. Peninjauan manusia harus menerapkan standar yang sama untuk setiap model.

Untuk penulisan bentuk panjang, penilai harus membedakan antara “terlalu panjang” dan “tidak berguna.” Jawaban yang lebih pendek bisa saja mengabaikan materi yang diperlukan; jawaban yang lebih panjang bisa tetap jelas dan dapat digunakan. Karena tidak ada target jumlah kata yang disetujui, uji coba ini dapat mencatat panjang teks dan penilaian penilai, tetapi tidak boleh secara retroaktif menetapkan jumlah kata sewenang-wenang sebagai standar penerimaan. Disiplin yang sama berlaku untuk tugas-tugas lainnya: catat apa yang diamati oleh penilai, alih-alih mengubah preferensi menjadi klaim tentang kemampuan model secara umum.

## Di mana bukti tidak tersedia

**Tidak Diketahui:** Paket ini tidak berisi keluaran terkontrol dari Claude Opus 5.5 atau GPT-6 Sol. Paket ini tidak menetapkan kualitas relatif, keandalan, atau kesesuaian untuk keempat alur kerja tersebut. Paket tersebut juga tidak mencantumkan harga, batasan konteks, tolok ukur, atau informasi kemampuan produk. Akibatnya, memo ini tidak dapat memperkirakan biaya penggunaan atau menyimpulkan model mana yang akan berkinerja lebih baik pada materi Project North.

Batasan anggaran perlu diklarifikasi sebelum keputusan pembelian diambil. Anggaran $48.000 adalah anggaran *migrasi* yang telah disetujui; apakah penggunaan model harus dibayar dari anggaran tersebut tidak disebutkan. Menganggapnya sebagai bagian yang sudah termasuk atau tambahan akan menciptakan asumsi keuangan yang tidak didukung oleh paket ini. Tim harus mendokumentasikan jawabannya serta jalur persetujuan yang berlaku sebelum berkomitmen pada penggunaan berkelanjutan.

Masalah keamanan juga belum terselesaikan untuk kedua kandidat. Waktu peninjauan keamanan belum dijadwalkan, dan dokumen tersebut tidak memberikan hasil peninjauan keamanan. Hasil uji coba yang kuat pun tidak akan menyelesaikan status tersebut. Tim harus mengidentifikasi siapa yang dapat menjadwalkan dan memutuskan peninjauan, informasi apa yang dibutuhkan oleh peninjau, serta apakah kegiatan uji coba itu sendiri diizinkan berdasarkan aturan yang berlaku; dokumen tersebut tidak menjawab pertanyaan-pertanyaan tersebut. Tidak ada tanggal awal atau akhir yang ditentukan untuk migrasi, uji coba, atau tinjauan keamanan, sehingga tim tidak boleh menyiratkan bahwa keputusan keamanan akan diambil dalam jangka waktu uji coba 30 hari atau migrasi 12 minggu.

## Uji coba 30 hari

Sebelum perbandingan pertama, tim harus memilih prompt yang representatif untuk keempat alur kerja, mendefinisikan bentuk respons yang diharapkan, dan menyepakati rubrik peninjauan oleh manusia. Kedua model harus menerima prompt yang identik serta instruksi peninjauan yang sama. Penilai harus mencatat penilaian mereka berdasarkan hasil kerja, bukan berdasarkan reputasi model. Simpan prompt, output, tinjauan, dan koreksi yang diminta agar pembaca di kemudian hari dapat merekonstruksi setiap penilaian. Catat penyimpangan dari proses umum, bukan mengabaikan kasus-kasus sulit tanpa penjelasan.

Gunakan tiga pemeriksaan yang dapat diukur:

1. **Kualitas tugas yang ditinjau:** Untuk sintesis penelitian, penulisan panjang, dan tinjauan kode, hitung proporsi keluaran yang diterima peninjau untuk tugas yang dinyatakan. Catat juga alasan penolakan secara terpisah—misalnya, cakupan yang kurang, penulisan yang tidak jelas, atau temuan tinjauan kode yang belum diverifikasi. Laporkan hasil berdasarkan alur kerja dan model, bukan hanya sebagai satu skor gabungan.
2. **Keandalan JSON terstruktur:** Hitung keluaran yang sesuai dengan struktur yang disepakati dan keluaran yang bidang-bidang yang diekstraknya diverifikasi kebenarannya oleh peninjau. Laporkan kedua tingkat tersebut untuk Claude Opus 5.5 dan GPT-6 Sol; jawaban yang valid secara struktural tidak boleh dihitung sebagai akurat hanya karena dapat diparsing.
3. **Upaya peninjauan dan jejak audit:** Catat waktu yang dibutuhkan peninjau untuk memeriksa dan, jika diperlukan, memperbaiki setiap keluaran. Hitung kasus yang tidak memiliki bukti yang cukup untuk menjelaskan keputusan peninjau. Bandingkan ukuran-ukuran ini pada kumpulan prompt yang sama, termasuk kasus di mana tidak ada satu pun keluaran yang dapat diterima.

Sepakati standar penerimaan dan cara menangani hasil seri sebelum melihat hasil uji coba; paket ini tidak menyediakan tolok ukur untuk menentukan ambang batas numerik. Pada akhir 30 hari, publikasikan rubrik, jumlah, alasan penilai, dan pertanyaan yang belum terselesaikan. **Kondisi penghentian:** hentikan adopsi jika persyaratan keamanan untuk uji coba atau penggunaan selanjutnya tidak dapat dipenuhi, atau jika tim tidak dapat menetapkan anggaran yang valid dan jalur persetujuan. Jangan menggantikan skor kualitas yang baik dengan persetujuan tersebut.

## Aturan keputusan

Pilih Claude Opus 5.5 jika bukti uji coba-nya memenuhi standar yang telah disepakati sebelumnya, secara signifikan lebih unggul pada alur kerja yang diprioritaskan tim, dan kondisi keamanan serta keuangannya telah diselesaikan. Terapkan aturan yang persis sama pada GPT-6 Sol. Jika keduanya memenuhi standar tanpa perbedaan yang signifikan dan relevan, ambil keputusan berdasarkan prioritas proyek yang terdokumentasi dan kendala yang telah diselesaikan, bukan dengan mengklaim pemenang berdasarkan kinerja. Jika tidak ada yang memenuhi syarat—atau batas anggaran atau status keamanan masih belum terselesaikan—jangan lakukan pemilihan model terlebih dahulu. Hasil tersebut memastikan keputusan yang dapat diaudit bagi tim yang terdiri dari 40 orang tanpa membuat klaim yang melebihi bukti yang ada.
Metadata: Claude — HTTP 200 · 25,98 detik · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27,763 detik · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
Sintesis sumber
Tugas penelitian
Sintesis sumber: seri
Kedua model tersebut menyelesaikan konflik tanggal menjadi 15 Oktober, mempertahankan anggaran $12.000 yang telah disepakati, dan menganggap pernyataan “selalu akurat” sebagai klaim manajer yang tidak didukung bukti. Hasilnya, tugas ini berakhir seri.
| Ukuran | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Skor | 9.5 / 10 | 9.5 / 10 |
| Penanganan konflik | S2 yang menentukan batas waktu | S2 yang menentukan batas waktu |
| Klaim yang tidak didukung bukti | Ditandai sebagai tidak didukung | Ditandai sebagai tidak didukung |
| Perbedaan praktis | Penjelasan risiko yang lebih terperinci | Rekomendasi yang lebih ringkas |
Masukan lengkap yang dibagikan
Lakukan rekonsiliasi terhadap catatan sumber di bawah ini. Sampaikan (1) tabel Markdown dengan kolom Klaim, Sumber acuan, Status, Alasan, dan (2) rekomendasi sekitar 250 kata. Gunakan catatan kebijakan yang tanggalnya lebih baru sebagai acuan hanya untuk konflik tenggat waktu. Tandai klaim yang tidak didukung sebagai “tidak didukung”. Jangan tambahkan fakta.

[S1 2026-09-01] Program percontohan berakhir pada 30 September. Anggaran sebesar $12.000.
[S2 2026-09-03] Program percontohan berakhir pada 15 Oktober. Anggaran tetap $12.000.
[S3 2026-09-02] Bagian Hukum belum menyetujui pembagian data eksternal.
[S4 2026-09-04] Seorang manajer menyatakan bahwa model tersebut “selalu akurat”; tidak ada bukti pengujian yang dilampirkan.
[S5 2026-09-04] Tim uji coba terdiri dari 8 anggota.
[S6 2026-09-05] Memo keputusan harus mencantumkan risiko yang belum terselesaikan.

Kembalikan hanya tabel dan rekomendasinya saja.
Claude Opus 5,5 · keluaran lengkap
| Klaim | Sumber yang berlaku | Status | Alasan |
|---|---|---|---|
| Program percontohan berakhir pada 30 September | S2 (2026-09-03) | Digantikan | Bertentangan dengan S2. Catatan yang bertanggal lebih baru berlaku untuk konflik tenggat waktu. |
| Program percontohan berakhir pada 15 Oktober | S2 (2026-09-03) | Didukung (mengungguli) | Ini adalah catatan dengan tanggal yang lebih baru mengenai konflik batas waktu, sehingga mengungguli S1. |
| Anggaran sebesar $12.000 | S1 dan S2 | Didukung | Kedua sumber sepakat, dan S2 menyatakan bahwa anggaran "tetap" sebesar $12.000. Tidak ada konflik. |
| Bagian Hukum belum menyetujui pembagian data eksternal | S3 | Didukung | Disebutkan secara langsung dan tidak dibantah oleh sumber lain mana pun. |
| Model tersebut "selalu akurat" | S4 | Tidak didukung | Ini adalah pernyataan manajer tanpa bukti pengujian yang menyertainya. |
| Tim percontohan memiliki 8 anggota | S5 | Didukung | Disebutkan secara langsung dan tidak dibantah. Informasi ini berasal dari satu sumber. |
| Memo keputusan harus mencantumkan risiko yang belum terselesaikan | S6 | Didukung | Ini merupakan persyaratan yang ditetapkan untuk memo tersebut dan tidak dibantah. |

**Rekomendasi**

Memo keputusan harus menggunakan tanggal 15 Oktober sebagai tanggal akhir uji coba. S2 adalah catatan dengan tanggal yang lebih baru dan mengatasi konflik tenggat waktu, sehingga menggantikan tanggal 30 September dalam S1. Aturan tanggal yang lebih baru hanya berlaku untuk konflik ini. Klaim lainnya dievaluasi berdasarkan dukungan masing-masing.

Anggaran harus dicatat sebagai $12.000. S1 dan S2 sepakat mengenai angka ini, sehingga tidak diperlukan rekonsiliasi. Jumlah anggota tim sebanyak delapan orang juga dapat dimasukkan. Hal ini hanya didasarkan pada S5, tetapi tidak ada sumber yang bertentangan dengannya.

S6 mensyaratkan agar memo mencantumkan risiko yang belum terselesaikan, dan catatan mendukung setidaknya dua di antaranya.

- **Berbagi data eksternal:** Bagian Hukum belum menyetujuinya (S3). Memo harus menyatakan hal ini secara jelas. Memo tidak boleh menyiratkan bahwa berbagi data eksternal diizinkan selama masa uji coba.
- **Akurasi model:** Klaim bahwa model "selalu akurat" tidak didukung bukti. S4 mencatat bahwa tidak ada bukti pengujian yang dilampirkan, dan klaim tersebut hanya dicatat sebagai pernyataan manajer. Memo tersebut tidak boleh menyajikannya sebagai temuan atau mengandalkannya untuk membenarkan keputusan. Memo tersebut harus mencantumkan akurasi model sebagai belum terverifikasi hingga bukti pendukung disediakan.

Terakhir, memo tersebut harus secara singkat menyebutkan bahwa tanggal akhir uji coba berubah antara S1 dan S2. Pembaca mungkin menemukan tanggal 30 September yang lebih awal di tempat lain, dan catatan ini akan menjelaskan mengapa tanggal 15 Oktober digunakan. Memo tersebut tidak boleh menambahkan penjelasan mengenai perubahan tersebut, hasil pengujian, atau pembaruan status hukum, karena tidak ada yang tercantum dalam catatan sumber.
GPT-6 Sol · hasil lengkap
| Klaim | Sumber yang berlaku | Status | Alasan |
|---|---|---|---|
| Program percontohan berakhir pada 30 September. | S2 (2026-09-03) | Digantikan | Catatan yang bertanggal lebih baru mengatur konflik batas waktu dan menetapkan tanggal 15 Oktober. |
| Program percontohan berakhir pada 15 Oktober. | S2 (2026-09-03) | Didukung | S2 mencantumkan batas waktu yang berlaku. |
| Anggaran sebesar $12.000. | S1 dan S2 | Didukung | Kedua catatan mencantumkan jumlah yang sama. |
| Bagian Hukum belum menyetujui pembagian data eksternal. | S3 | Didukung | S3 menyatakan hal ini secara langsung; tidak ada catatan selanjutnya yang membahas persetujuan tersebut. |
| Model ini “selalu akurat.” | S4 | Tidak didukung | Seorang manajer membuat klaim tersebut, tetapi tidak ada bukti pengujian yang dilampirkan. |
| Tim uji coba terdiri dari 8 anggota. | S5 | Didukung | S5 menyebutkan jumlah anggota tim. |
| Memo keputusan harus mencantumkan risiko yang belum terselesaikan. | S6 | Didukung | S6 menyebutkan persyaratan ini. |

**Rekomendasi:** Gunakan tanggal 15 Oktober sebagai tanggal akhir uji coba dalam memo keputusan. S2 lebih baru daripada S1 dan menyelesaikan konflik tenggat waktu di antara keduanya. Pertahankan anggaran sebesar $12.000: catatan-catatan tersebut sepakat mengenai jumlah tersebut, sehingga perubahan tenggat waktu tidak memberikan dasar untuk mengubahnya. Catat ukuran tim uji coba sebanyak 8 anggota, sebagaimana dinyatakan dalam S5.

Cantumkan risiko yang belum terselesaikan secara eksplisit, sebagaimana disyaratkan oleh S6. Catatan keputusan harus menyatakan bahwa Bagian Hukum belum menyetujui pembagian data eksternal, tanpa menyiratkan bahwa persetujuan telah diberikan sejak saat itu atau bahwa pembagian data diperbolehkan. Catatan tersebut juga harus membedakan pernyataan manajer mengenai akurasi dari temuan yang telah ditetapkan. S4 mencatat pernyataan bahwa model tersebut “selalu akurat,” tetapi tidak menyertakan bukti pengujian. Jangan sajikan pernyataan tersebut sebagai hasil yang terverifikasi.

Pertahankan cakupan rekonsiliasi agar tetap terbatas. S2 mengatur tanggal akhir yang bertentangan; hal ini tidak menggantikan catatan terpisah mengenai Bagian Hukum, akurasi, ukuran tim, atau persyaratan memo. Jika catatan tidak menetapkan suatu hasil, biarkan hal tersebut belum terselesaikan daripada memberikan asumsi. Secara khusus, catatan tersebut tidak mendukung klaim bahwa pembagian data eksternal telah disetujui maupun klaim bahwa keakuratan model telah dibuktikan.

Oleh karena itu, memo yang dihasilkan dapat menggunakan tenggat waktu 15 Oktober dan anggaran $12.000 sambil mengidentifikasi dua kesenjangan bukti yang terlihat dalam catatan-catatan ini: persetujuan Hukum yang masih tertunda untuk berbagi data eksternal dan tidak adanya bukti pengujian untuk klaim akurasi.
Metadata: Claude — HTTP 200 · 12,846 detik · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12,322 detik · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
Pemrograman dan keluaran terstruktur
Perbedaan dalam penulisan kode terletak pada penjelasannya
Kondisi penyaringan asli: jika t
Elemen None dianggap sebagai nilai palsu, sehingga penyaring ini sudah mengabaikannya.
Kedua model tersebut menghasilkan JSON yang valid dengan empat kunci yang diminta serta patch minimal yang sama. Claude menggambarkan filter yang ada dengan benar; sedangkan GPT-6 Sol secara keliru menyatakan bahwa elemen None akan menyebabkan kesalahan. Kesalahan diagnosis tersebut menjadi penting ketika seorang peninjau memutuskan apakah sebuah patch telah mengatasi masalah yang sebenarnya.
Claude memberikan daftar risiko, sedangkan Sol memberikan rangkaian kata singkat mengenai risiko. Petunjuk tidak mensyaratkan tipe tertentu untuk kolom tersebut, sehingga perbedaan ini tidak dianggap sebagai pelanggaran kontrak. Skor tugas Sol adalah 9,0/10 setelah koreksi atas pengurangan setengah poin sebelumnya yang tidak beralasan; pengurangan skor terkait akurasi fakta tetap berlaku.
Tugas pengkodean
Pemrograman dan keluaran terstruktur: Claude Opus 5.5 lebih akurat
Kedua model tersebut menghasilkan JSON yang valid dengan kunci-kunci yang diminta dan patch minimal yang sama. Claude dengan tepat menjelaskan bahwa filter asli sudah melewatkan sebuah Tidak ada elemen. GPT-6 Sol salah menyatakan bahwa sebuah Tidak ada Elemen tersebut akan menyebabkan kesalahan. Prompt tersebut tidak mensyaratkan tipe tertentu untuk bidang "risks".
| Ukuran | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Skor | 10.0 / 10 | 9.0 / 10 |
| Patch | Benar dan ringkas | Benar dan ringkas |
| Diagnosis | Berhasil mengisolasi kedua cacat tersebut dengan tepat | Melebih-lebihkan kegagalan elemen None |
| Kontrak JSON yang diminta | JSON valid; keempat kunci tersebut ada | JSON valid; keempat kunci tersebut ada |
Masukan lengkap yang dibagikan
Kembalikan JSON yang ketat dengan kunci diagnosis, patch, tests, dan risks saja. Lakukan diagnosis dan terapkan perbaikan minimal pada fungsi Python ini agar ketiga kasus tersebut lulus. Perbaikan tersebut harus mempertahankan tanda tangan fungsi.

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

Kasus:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

Jangan jalankan kode apa pun dan jangan sertakan pagar Markdown atau teks biasa di luar JSON.
Claude Opus 5,5 · keluaran lengkap
{"diagnosis":"Dua kesalahan, terdeteksi saat membaca kode (belum dieksekusi). (a) Kasus 2: ketika `tags` bernilai `None`, generator mengiterasi `None` dan memicu `TypeError`, alih-alih mengembalikan `''`. (b) Kasus 3: filter `if t` dijalankan sebelum proses penghilangan spasi. Tag yang hanya berisi spasi ' ' dianggap benar (truthy), sehingga lolos dan menjadi ''. Hasilnya adalah sorted(['', 'seo']), yang digabungkan menjadi ',seo' alih-alih 'seo'. Elemen None pada kasus 3 sudah dibuang oleh 'if t'. Kasus 1 sudah berfungsi: ' AI ', 'ai', dan 'Code' dinormalisasi menjadi {'ai', 'code'}, sehingga menghasilkan 'ai,code'.','patch":"def normalize_tags(tags):\n return ",".join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))','tests":["assert normalize_tags([" AI ", 'ai', 'Code']) == 'ai,code' # dilacak: {'ai','code'} -> 'ai,code'','assert normalize_tags(None) == "" # traced: (None or []) -> [] -> ''','assert normalize_tags([" ", None, 'SEO']) == 'seo' # traced: ' ' gagal pada t.strip(), None gagal pada t, 'SEO' -> 'seo''],'risiko":["Elemen non-string seperti 123 akan memicu AttributeError pada .strip(). Hal ini tidak berubah dari perilaku aslinya.",""tags atau []" memperlakukan input yang bernilai palsu (misalnya '' atau tuple kosong) sebagai kosong. Hal ini konsisten dengan perilaku yang diharuskan None -> ''.','Jika sebuah string tunggal diberikan alih-alih iterable dari tag, string tersebut akan diiterasi karakter demi karakter. Hal ini tidak berubah dari perilaku aslinya.","Spasi internal tidak digabungkan, sehingga "machine learning" dan 'machine learning' tetap dianggap sebagai tag yang berbeda.','Pengujian hanya diperoleh melalui penelusuran manual dan tidak dijalankan, sesuai instruksi."]}GPT-6 Sol · hasil lengkap
{"diagnosis":"Fungsi ini memunculkan kesalahan jika `tags` bernilai `None` atau berisi `None`, dan tetap mempertahankan entri yang menjadi kosong setelah proses penghilangan karakter.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI ","ai","Code"],"expected":"ai,code"},{"input":null,"expected":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"Tidak dijalankan. Entri yang bukan None dianggap sebagai string."}Metadata: Claude — HTTP 200 · 10,832 detik · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7,71 detik · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
Keputusan akhir
Pilihan yang praktis
Model mana yang sesuai dengan pekerjaan Anda?
GPT-6 Sol memimpin kumpulan hasil awal yang kecil ini karena berhasil menyelesaikan kontrak versi panjang yang telah direvisi, sementara Claude Opus 5.5 mencapai batas hasil bersama sebesar 2.400 token. Claude Opus 5.5 memimpin tugas kode/JSON dalam hal akurasi diagnostik. Untuk sintesis sumber, keduanya sama-sama unggul.
Pilih GPT-6 Sol ketika prioritas utama adalah menyelesaikan dokumen keputusan yang panjang dan memiliki banyak kendala dalam satu kali proses. Pilih Claude Opus 5,5 ketika tinjauan kode atau keluaran terstruktur akan lebih bermanfaat jika disertai diagnosis dan inventarisasi risiko yang lebih eksplisit. Jika pekerjaan Anda menggabungkan keduanya, alokasikan setiap tugas ke model yang paling sesuai, alih-alih memaksakan satu model tunggal yang dianggap paling tepat untuk semua situasi.
GlobalGPT menawarkan cara praktis untuk mengelola model-model serta seluruh alur kerja AI Anda dalam satu dasbor. Kegiatan penelitian, penulisan, pemrograman, pengolahan gambar, video, serta pekerjaan produksi yang terintegrasi dengan antarmuka baris perintah (CLI) dapat dilakukan dalam lingkungan kerja yang sama.
Pertanyaan yang Sering Diajukan
Model mana yang keluar sebagai pemenang dalam perbandingan tersebut?
GPT-6 Sol memimpin dalam kumpulan hasil pertama yang kecil dengan skor 28,5 berbanding 26,5 setelah tugas batas awal dikecualikan dan deduksi kontrak JSON diperbaiki. Keunggulan tersebut berasal dari penyelesaian kontrak bentuk panjang yang telah direvisi di bawah batas keluaran yang sama, yaitu 2.400 token; Claude Opus 5.5 memimpin pada tugas kode dan keluaran terstruktur, sementara pada tugas sintesis sumber terjadi seri.
Mengapa tes berformat panjang yang pertama tidak dimasukkan?
Prompt asli tidak menyebutkan nama kedua model tersebut. Kedua model tersebut dengan tepat menolak untuk menebak identitas yang hilang, sehingga respons tersebut memeriksa apakah sebuah model meminta konteks yang hilang alih-alih berpura-pura tahu.
Apakah Claude Opus 5.5 lebih baik untuk pemrograman?
Dalam tugas pengkodean dan JSON ini, Claude Opus 5.5 memberikan diagnosis yang lebih akurat dan daftar risiko yang terstruktur. Satu tugas saja tidak cukup untuk menetapkan peringkat pengkodean yang universal.
Apakah GPT-6 Sol lebih baik untuk menulis?
GPT-6 Sol telah menyelesaikan memo panjang yang telah direvisi sesuai dengan batasan yang diminta pada hasil keluaran pertama. Hasil ini mendukung rekomendasi alur kerja untuk pengujian ini, bukan pernyataan umum mengenai setiap tugas penulisan.
Apakah saya bisa menguji kedua model tersebut tanpa harus berganti platform?
GlobalGPT dirancang sebagai langganan AI multi-model yang menyatukan berbagai fungsi AI dalam satu dasbor. Layanan ini berguna untuk menjalankan paket prompt yang sama—baik untuk penelitian, penulisan, maupun pemrograman—di berbagai model serta menjaga alur kerja tetap terpusat di satu tempat.
GlobalGPT memungkinkan Anda menyimpan model-model tersebut beserta seluruh alur kerja AI Anda di satu tempat. Mulailah dengan model yang sesuai untuk tugas saat ini, lalu lanjutkan pekerjaan melalui tahap penelitian, penulisan, pemrograman, pengolahan gambar, video, atau tahap produksi yang terhubung dengan CLI tanpa perlu membuka layanan terpisah untuk setiap bagian.









