Revisión basada en la evidencia · Agosto de 2026
Peso abierto, API alojadas y la brecha de nomenclatura: todo ello explicado con claridad.
Límite de las pruebas: No se afirma que exista ninguna puntuación de escucha de primera mano de Qwen3-TTS.
Una reseña útil sobre Qwen3-TTS debe responder a una pregunta más básica antes de valorar las voces: ¿de qué Qwen3-TTS estamos hablando? En 2026, este nombre abarca los puntos de control descargables de 0,6B y 1,7B, las API de Qwen3-TTS alojadas en Alibaba Cloud y un mercado en el que también se recomienda la familia independiente Qwen-Audio 3.0 TTS. Tratar estos productos como si fueran uno solo da lugar a afirmaciones engañosas sobre velocidad, idiomas y precios.
La respuesta breve es que Qwen3-TTS es una de las plataformas de voz abiertas más flexibles de 2026. Ofrece diez idiomas, puntos de control específicos para cada tarea, clonación de voz en unos tres segundos, diseño de voz en lenguaje natural, compatibilidad con streaming y una licencia Apache 2.0. Sin embargo, esta reseña no incluye una puntuación de comprensión auditiva: el entorno de pruebas disponible no exponía un punto final real de Qwen3-TTS, y la GPU local de 2 GB no era adecuada para una prueba comparativa representativa entre 0,6B y 1,7B.
Situación de Qwen3-TTS en 2026
Qwen publicó los coeficientes de ponderación de la categoría abierta Qwen3-TTS el 22 de enero de 2026. El Repositorio oficial Qwen3-TTS enumera cinco puntos de control de 12 Hz publicados: 1,7B VoiceDesign, 1,7B CustomVoice, 1,7B Base, 0,6B CustomVoice y 0,6B Base. La correspondencia Colección de Hugging Face También incluye el tokenizador. Estos son los modelos que los desarrolladores pueden consultar, descargar y ejecutar bajo la licencia publicada.
Alibaba Cloud ofrece por separado las familias de productos Qwen3-TTS Flash, Instruct, clonación de voz y diseño de voz a través de interfaces en tiempo real y no en tiempo real. Su oferta actual catálogo de modelos de síntesis de voz debe considerarse la fuente de referencia para los alias alojados, las regiones, los idiomas y las interfaces, ya que esos datos pueden cambiar sin que se modifiquen los nombres de los puntos de control abiertos.
Hay otra pequeña complicación en cuanto a la nomenclatura. La guía de selección de modelos de Alibaba Cloud para 2026 también recomienda a los usuarios el modelo Qwen-Audio 3.0 TTS para varios trabajos alojados. Qwen-Audio 3.0 TTS no es un punto de control Qwen3-TTS 0.6B o 1.7B renombrado. Si ya estás al tanto de la familia más amplia de Qwen, nuestra Qwen 3.8: especificaciones máximas y análisis de acceso muestra por qué es importante indicar el nombre exacto del modelo en todos los productos de la gama Qwen.
Utiliza el nombre del punto de control abierto para la inferencia local, el ID exacto del modelo de Alibaba Cloud para el comportamiento de la API y Qwen-Audio 3.0 TTS únicamente como alternativa independiente. De este modo, todas las afirmaciones relativas a la calidad, la latencia y el precio se mantendrán vinculadas al producto que las generó.
Veredicto rápido: potente, abierto y sensible a los datos
Opinión rápida
Implementación abierta, investigación, clonación y voces de personajes.
Cinco puntos de control específicos para cada tarea, disponibles en dos tamaños.
La rapidez del proveedor depende del entorno; la calidad no se valora en este caso.
Las rutas «Hosted Qwen3-TTS» y «Qwen-Audio 3.0» son rutas independientes.
Qwen3-TTS resulta especialmente atractivo para los equipos que buscan control y flexibilidad en la implementación. Los puntos de control de Base admiten la clonación, CustomVoice ofrece altavoces preconfigurados con nombre y control de instrucciones, y VoiceDesign puede crear una voz a partir de una descripción escrita. La compatibilidad con diez idiomas hace que la plataforma sea mucho más útil que una demo abierta solo en inglés, mientras que las versiones 0.6B ofrecen a los desarrolladores un punto de partida más reducido.
La principal salvedad es la calidad de los datos. Qwen presenta unos resultados de pruebas de rendimiento muy sólidos y una baja latencia del primer paquete en un entorno interno optimizado. Esas cifras no tienen en cuenta los arranques en frío de los portátiles, el margen de VRAM de los contenedores ni la pronunciación de los nombres de sus productos. Las promesas de «97 ms universales» omiten las condiciones de las pruebas de rendimiento.
Para un prototipo autohospedado, Qwen3-TTS se sitúa entre las primeras opciones de la lista. Para una API de producción, compara la opción alojada de Qwen3-TTS con las recomendaciones más recientes de Qwen-Audio, el soporte operativo, la disponibilidad regional y el coste de gestionar voces clonadas. Si su objetivo va más allá del habla y abarca los efectos de sonido o la música, la gama más amplia Pruebas de voz, efectos de sonido y música de Seed Audio 1.0 abarcan un flujo de trabajo de audio diferente y más multimodal.
En resumen: Qwen3-TTS ofrece unos resultados excelentes en cuanto a arquitectura, apertura y cobertura de funciones. Su rendimiento real en producción sigue dependiendo del punto de control o punto final concreto, de tu hardware, de tu idioma y de una voz de referencia acordada que se haya probado con tus propios scripts.
¿Qué es Qwen3-TTS?
Qwen3-TTS es una familia de modelos de generación de voz basada en un tokenizador de voz discreto que funciona a 12,5 fotogramas por segundo. Según el Informe técnico Qwen3-TTS, el sistema se entrenó con más de cinco millones de horas en diez idiomas. La baja tasa de tokens es un aspecto fundamental del diseño: un menor número de tokens acústicos puede reducir el trabajo de decodificación y hacer que la transmisión en tiempo real resulte más práctica, sin que por ello el modelo deje de conservar el timbre, la pronunciación y la prosodia.
Tres niveles, tres normas probatorias
0,6 mil millones / 1,7 mil millones
Base, CustomVoice y 1.7B VoiceDesign. Utilizar para reclamaciones de modelos locales.
Flash / Instruct / VC / VD
Utiliza el modelo, la interfaz, la región y la fecha exactos de la API.
Qwen-Audio 3.0 TTS
Una alternativa alojada actual, no un «Open Checkpoint» renombrado.
Los cinco puntos de control publicados se centran en tareas específicas, en lugar de constituir una escala en la que cada modelo más grande sea capaz de hacer de todo:
| Punto de control liberado | Tamaño | El puesto que mejor se ajusta a tu perfil | Límite importante |
|---|---|---|---|
| Qwen3-TTS-12 Hz-0,6 B-Base | 0,6 mil millones | Flujos de trabajo de clonación e investigación a menor escala | No hay ningún catálogo de CustomVoice predefinido |
| Qwen3-TTS-12 Hz-1,7 B-Base | 1.7 mil millones | Trabajos de clonación y continuación a mayor escala | Necesita más memoria y potencia de cálculo |
| Qwen3-TTS-12Hz-0,6B-CustomVoice | 0,6 mil millones | Voces predefinidas con control de instrucciones | Utiliza el conjunto de altavoces ya comercializado |
| Qwen3-TTS-12Hz-1,7B-CustomVoice | 1.7 mil millones | Síntesis de voz predefinida de mayor capacidad | No es el punto de control de VoiceDesign |
| Qwen3-TTS-12Hz-1,7B-VoiceDesign | 1.7 mil millones | Creación de un timbre a partir de una descripción textual | No se ha lanzado la versión 0.6B de VoiceDesign peer |
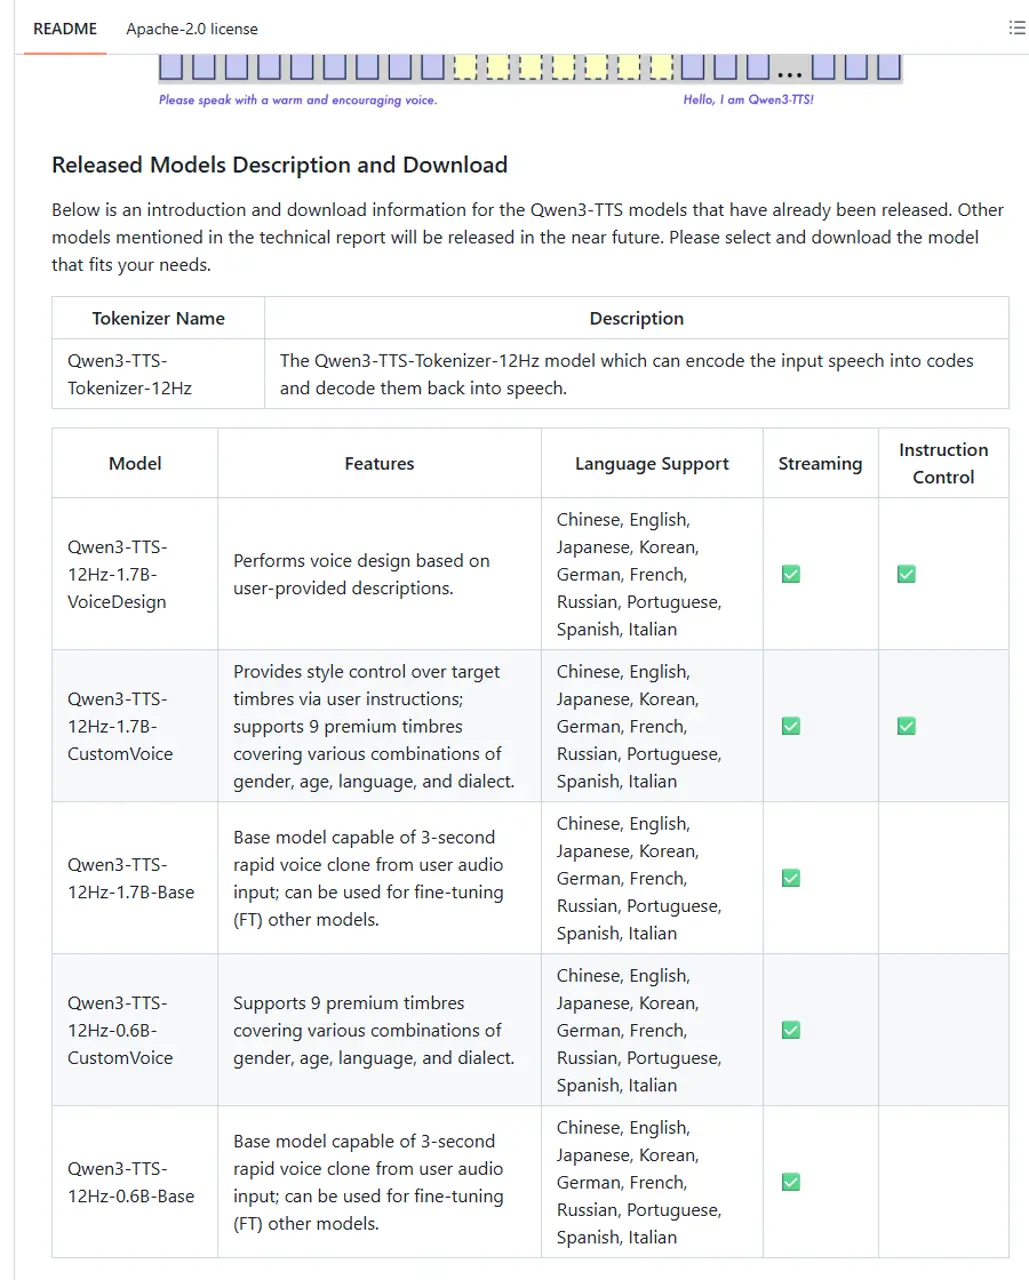
“Base” es la opción ideal cuando se dispone de una voz de referencia y se tiene permiso para utilizarla. «CustomVoice» es la opción más sencilla cuando alguno de los timbres predefinidos lanzados por Qwen se adapta al proyecto. «VoiceDesign» está pensado para descripciones de personajes como «un narrador tranquilo y maduro con un registro grave suave», en las que no se requiere ninguna grabación de referencia.
No es necesario clonar un tutorial de producto si un narrador predefinido funciona, y puede que un personaje de ficción no necesite la grabación de una persona real si VoiceDesign crea una identidad adecuada. Evalúa cada tarea con el punto de control correspondiente.
Cómo se realizó la prueba de este modelo Qwen3-TTS
El análisis se basa en cuatro niveles de evidencia: documentación oficial, el informe técnico Qwen, la inspección del hardware local y una prueba controlada de un envoltorio de audio alojado de forma independiente. Las fuentes oficiales respaldan los datos del producto y los resultados de las pruebas de rendimiento facilitados por el proveedor. La prueba controlada del envoltorio solo corrobora su comportamiento observado, no una puntuación de calidad de voz Qwen3-TTS.
El entorno de tareas disponible que se indica qwen-audio-3.0-tts-flash, no un qwen3-tts-* modelo.
Genera una grabación de voz en inglés hablado y clara. Lee exactamente lo siguiente: 'Al amanecer, el equipo de investigación comprobó cada señal dos veces antes de anunciar el resultado'. Utiliza la voz de un narrador adulto, cálida y tranquila, con un ritmo natural, consonantes claras y una breve pausa después de 'amanecer'. No añadas música, efectos de sonido, una introducción ni ninguna palabra que no figure en la frase citada.En nuestra prueba, esta entrada generó un archivo MP3 de 21,263673 segundos y reprodujo las instrucciones en voz alta. El resultado de la prueba demostró que el envoltorio interpretó la indicación completa como texto de voz.
Al amanecer, el equipo de investigación comprobó cada señal dos veces antes de dar a conocer el resultado.Repetimos la prueba de control utilizando únicamente la frase de referencia. En nuestra prueba, el resultado fue un archivo MP3 de 6,086531 segundos, a 22 050 Hz, 128 kbps y en mono. Coincidía palabra por palabra con la frase de referencia y no incluía ninguna instrucción adicional.
El usuario ha escuchado ambos archivos y ha confirmado las valoraciones que figuran a continuación. Se trata de una comprobación práctica realizada por un único oyente, no de un estudio MOS ni de un panel de escucha.
| Dimensión de la escucha | Control con instrucciones | Control de texto sin formato |
|---|---|---|
| Naturalidad | 4/5 | 5/5 |
| Inteligibilidad | 5/5 | 5/5 |
| Pronunciación | 5/5 | 5/5 |
| Prosodia | 4/5 | 5/5 |
| Fidelidad del texto | 1/5 | 5/5 |
| Cumplimiento de las normas de estilo | Sin puntuación | 5/5 |
| Ausencia de artefactos | 5/5 | 5/5 |
| Usabilidad en la producción | 1/5 | 5/5 |
La muestra que incluía instrucciones sonaba clara y, en general, natural, pero la lectura de las instrucciones mermaba la fidelidad del texto y la facilidad de uso de la producción. La muestra de texto sin formato sonaba natural, seguía la frase al pie de la letra y no requería ninguna corrección del contenido. Estas puntuaciones solo describen las dos qwen-audio-3.0-tts-flash controles de envoltura; no se trata de una valoración de la calidad de voz del punto de control Qwen3-TTS.
Nunca des por sentado que las instrucciones de estilo y la narración pertenecen al mismo ámbito. Nuestra guía sobre hacer que los discursos escritos por IA suenen más humanos Mejora el guion, pero los campos de los puntos finales determinan si las instrucciones controlan la voz o se incorporan a la grabación.
La inspección local reveló una tarjeta gráfica NVIDIA GeForce MX450 con 2 GB de VRAM y unos 16,9 GB de memoria del sistema. Esa no es una plataforma adecuada para la matriz prevista de 0,6B frente a 1,7B. La descarga de la CPU podría deberse a una prueba de lanzamiento, por lo que la velocidad no es representativa. Por lo tanto, la calidad de voz del Qwen3-TTS, el RTF local, la similitud de clonación y la coherencia entre idiomas siguen sin puntuarse.
Calidad de voz del Qwen3-TTS: lo que demuestran los datos
El informe oficial muestra unos sólidos resultados de Qwen3-TTS en cuanto a inteligibilidad, similitud con el hablante, seguimiento de instrucciones, generación multilingüe, discurso de larga duración y transmisión en streaming. Se trata de indicadores comparativos útiles, pero siguen siendo valores de referencia facilitados por Qwen, y no grabaciones generadas aquí.
Una prueba de voz para producción debe abarcar la pronunciación, los artefactos, el ritmo, la emoción, la repetibilidad, la carga de edición, las abreviaturas, las fechas, las divisas, las URL, los nombres, el cambio de código lingüístico y las frases largas.
Combina la escucha con las transcripciones y los metadatos; el Flujo de trabajo de transcripción de audio ChatGPT hace que la comprobación del texto sea repetible.
El modelo Qwen3-TTS parece prometedor, pero esta reseña no incluye resultados de pruebas de rendimiento de primera mano. Antes de enviarlo, pruébalo con varias generaciones, altavoces integrados, auriculares y los altavoces del teléfono.
En qué se centraron los críticos externos
La demostración en redes sociales de Qwen destaca múltiples timbres, idiomas y dialectos. El creador independiente Bijan Bowen se centró en la ejecución local y la clonación de voces; Jeff Geerling presentó el lanzamiento como una fuerte competencia de código abierto para las plataformas de síntesis de voz gestionadas. Se trata de puntos de vista de los críticos, no de resultados de pruebas comparativas ni de una prueba de consenso en todo el mercado.
Velocidad y latencia del Qwen3-TTS
Latencia del primer paquete
0.288 / 0.313
0,6 mil millones / 1,7 mil millones con una concurrencia de 1.
Entorno interno optimizado para vLLM: no se garantiza el funcionamiento en un ordenador portátil.
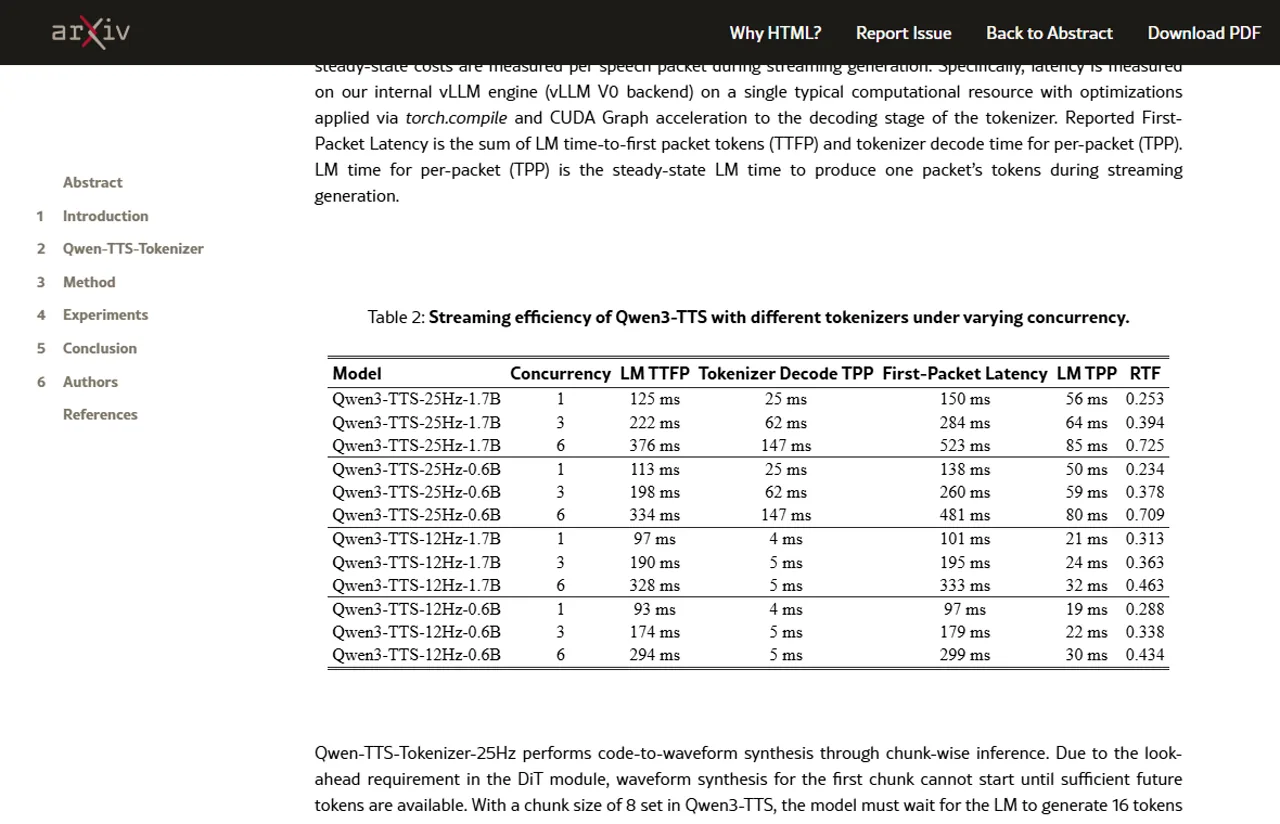
La cifra de velocidad destacada es una latencia del primer paquete de 97 ms para el modelo de 0,6B y 12 Hz. La misma tabla del informe técnico indica 101 ms para el modelo de 1,7B y 12 Hz con una concurrencia de 1. Los factores de tiempo real (RTF) registrados fueron 0,288 y 0,313, respectivamente. En términos sencillos, un RTF inferior a 1 significa que la síntesis se ejecutó más rápido que la duración del audio generado en ese entorno.
Esos resultados proceden de la configuración interna optimizada del vLLM de Qwen. No se trata de estimaciones genéricas del tiempo hasta el primer audio para un portátil con Windows, un contenedor sin servidor en estado frío o una región de API compartida. El informe también muestra que la concurrencia afecta a la latencia. La carga del modelo, el procesamiento del audio de referencia, el tránsito por la red, las colas, el empaquetado del audio y la reproducción en el cliente pueden quedar fuera del número de decodificadores principales.
Un historial de referencia adecuado debería incluir:
- Hardware, precisión, revisión de modelos y atención al cliente.
- Estado en frío o en caliente, concurrencia, tiempo de primer audio, tiempo total, pico de VRAM, duración de la salida y RTF.
- En el caso de una API: región, tipo de conexión, ID de solicitud, gestión de colas y reintentos.
El modelo de 0,6B debería ser la opción más segura cuando la memoria y la concurrencia son más importantes que la capacidad máxima. El modelo de 1,7B es la opción más sensata en términos de calidad cuando la máquina dispone de margen de rendimiento. Sin embargo, si no se utilizan la misma prompt, el mismo hablante, los mismos ajustes de muestreo y el mismo estado de calentamiento, el tamaño del modelo por sí solo no permite determinar la diferencia real de latencia.
Qwen3-TTS: idiomas y pronunciación
Los puntos de control abiertos Qwen3-TTS admiten diez idiomas: chino, inglés, japonés, coreano, alemán, francés, ruso, portugués, español e italiano. Esta lista procede del repositorio actual y de los materiales del modelo publicados. No añadas sin avisar el tailandés, el indonesio, el malayo ni el vietnamita porque otro producto de audio Qwen ya los admite.
| Idioma | Apoyo oficial a los proyectos de código abierto | Prioridad en la revisión de la producción |
|---|---|---|
| Chino | Sí | Tonos, nombres, lectura de números, estilo de texto regional |
| Inglés | Sí | El estrés, las abreviaturas, los nombres de marcas, las frases largas |
| Japonés | Sí | Acento tonal, partículas, nombres, texto mixto en latín |
| Coreano | Sí | Espaciado, préstamos lingüísticos, finales de las frases |
| Alemán | Sí | Compuestos, números, grupos de consonantes |
| Francés | Sí | Enlaces, abreviaturas, nombres tomados de otras lenguas |
| Ruso | Sí | Acentos, nombres, números, inserciones en latín |
| Portugués | Sí | Confirma el acento regional y la ortografía que deseas utilizar |
| Español | Sí | Verificar el acento regional y los nombres propios |
| Italiano | Sí | Acentuación, geminación, nombres extranjeros |
“Compatible” significa que el modelo puede sintetizar el idioma; no implica que todas las voces tengan el mismo grado de naturalidad en todas las regiones. Solo el portugués y el español presentan importantes variaciones regionales. Una implementación comercial debería definir la configuración regional de destino, contar con revisores nativos y crear un conjunto de datos de regresión de pronunciación para nombres, medidas, direcciones y expresiones jurídicas.
El cambio de código requiere una prueba específica. Una frase como “Abre la API Qwen3-TTS en São Paulo a las 9:30 de la mañana” combina una estructura en inglés, el nombre de un modelo, la pronunciación en portugués, la puntuación y una hora. Esto se acerca mucho más al texto real de una aplicación que una frase de demostración monolingüe sin adornos. En el doblaje de vídeos, la pronunciación también debe ajustarse a la sincronización; nuestro Veo 3.1: Flujo de trabajo de diálogos, audio y sincronización labial aborda el problema de la sincronización circundante.
Clonación de voz, CustomVoice y VoiceDesign
Los puntos de control de Base permiten clonar rápidamente la voz a partir de unos tres segundos de audio de referencia. Se trata de un nivel mínimo de capacidad impresionante, no de una garantía de que tres segundos sean siempre la mejor muestra para la producción. Las referencias breves pueden no reflejar adecuadamente el registro vocal, el ritmo, la cobertura de las vocales, la emoción y la consistencia del micrófono.
Las instrucciones de registro de Alibaba Cloud son más conservadoras: exigen al menos tres segundos de voz clara y continua, admiten muestras más largas y recomiendan una grabación más nítida y prolongada para facilitar la clonación. Sigue las instrucciones actuales documentación sobre la clonación de la voz en cuanto a las normas relativas al formato, la frecuencia de muestreo, los canales, la duración y la región, en lugar de considerar la demostración de tres segundos del artículo como una especificación de subida.
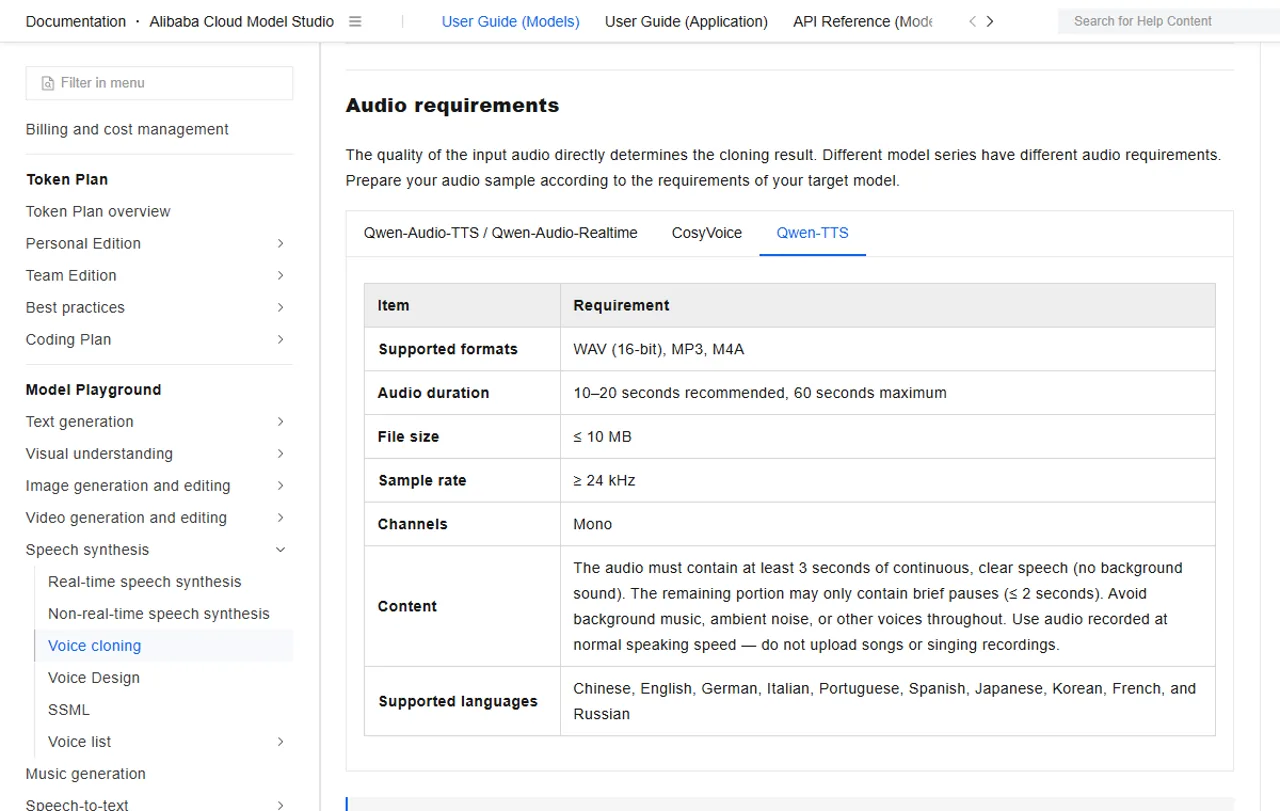
CustomVoice evita clonar a una persona real. La versión abierta incluye nueve timbres premium para diferentes idiomas o estilos, lo que la hace muy interesante cuando basta con una identidad predefinida y el control de las instrucciones.
VoiceDesign crea un timbre a partir de una descripción en lenguaje natural. El servicio alojado Documentación de Voice Design Muestra el proceso de creación independiente. Es adecuado para personajes de ficción y voces de marca sintéticas, pero las descripciones deben someterse a pruebas para evaluar la edad percibida, el acento y los sesgos culturales.
Matriz de riesgos de identidad vocal
Anota quién lo ha dicho, el ámbito de aplicación, el término y la forma de retirarlo.
Cifra las referencias y elimina las voces derivadas junto con la fuente.
Bloquea las afirmaciones perjudiciales sobre la identidad e incluye la posibilidad de denunciarlas.
Indica cuándo se trata de voz sintética, en caso de que los oyentes puedan confundirla con la de una persona.
La clonación requiere derechos explícitos y consentimiento informado. Conserva el registro original del consentimiento, define los usos permitidos, evita la reinscripción posterior y establece un proceso de eliminación. Los riesgos no son teóricos; el Análisis de la privacidad y el consentimiento en el reconocimiento facial y de voz explica por qué las medidas de seguridad relacionadas con la identidad, los datos biométricos y la suplantación de identidad deben integrarse en el diseño del producto y no limitarse a una nota al pie.
Qwen3-TTS 0,6B frente a 1,7B: ¿cuál deberías utilizar?
Elige 0,6B cuando tu principal limitación sea la implementación. Es la mejor opción para GPU más pequeñas, mayor concurrencia, experimentación más rápida y autoalojamiento con presupuesto limitado. Tanto Base como CustomVoice están disponibles en este tamaño, por lo que puedes evaluar la clonación o las voces predefinidas sin tener que empezar con el punto de control más grande.
Elige 1.7B cuando el margen de calidad y la amplitud de funciones sean más importantes. Es el único tamaño disponible con VoiceDesign, y es la opción más recomendable para los equipos dispuestos a sacrificar memoria y rendimiento a cambio de capacidad. Las cifras de concurrencia 1 del informe técnico muestran una pequeña diferencia en el primer paquete y en el RTF en la configuración optimizada de Qwen, pero su propio hardware puede ampliar o reducir esa diferencia.
| Factor decisivo | Empieza con 0,6 B | Empieza con 1.7B |
|---|---|---|
| La memoria de la GPU es escasa | Ajuste más firme | Mayor riesgo de descarga o baja concurrencia |
| Necesito VoiceDesign | No está disponible en el conjunto publicado | Requerido |
| Es necesario clonar la base | Disponible | Disponible con mayor capacidad |
| ¿Necesitas CustomVoice? | Disponible | Disponible con mayor capacidad |
| Necesito una prueba de viabilidad rápida | El mejor punto de partida | Utilizar una vez finalizadas las obras de la tubería |
| Se necesita la decisión definitiva sobre la producción | Compara el rendimiento de ambos | Compara el rendimiento de ambos |
El número de parámetros no equivale a los requisitos de VRAM. La precisión, la implementación de la atención, la caché, la longitud de referencia, el tamaño del lote y la sobrecarga del marco de trabajo son factores importantes. Un modelo que apenas se carga no es un servicio de producción fiable.
En el caso de la MX450 de 2 GB analizada en esta reseña, ninguna de las dos configuraciones ofrece una prueba de rendimiento de la GPU representativa. El siguiente paso práctico sería disponer de una pila CUDA más reciente y una GPU adecuada o un punto final alojado oficialmente. La afirmación “funcionó con descarga de la CPU” sería una nota sobre compatibilidad, no una valoración significativa de la velocidad.
API Qwen3-TTS: HTTP, streaming e identificadores de modelos
Elige el medio de transporte en función de las necesidades de reproducción
La forma más sencilla de realizar narraciones por lotes y completar archivos.
Entrega por partes; comprueba de todos modos cuándo se puede reproducir el audio.
Ideal para conversar y para la reproducción progresiva.
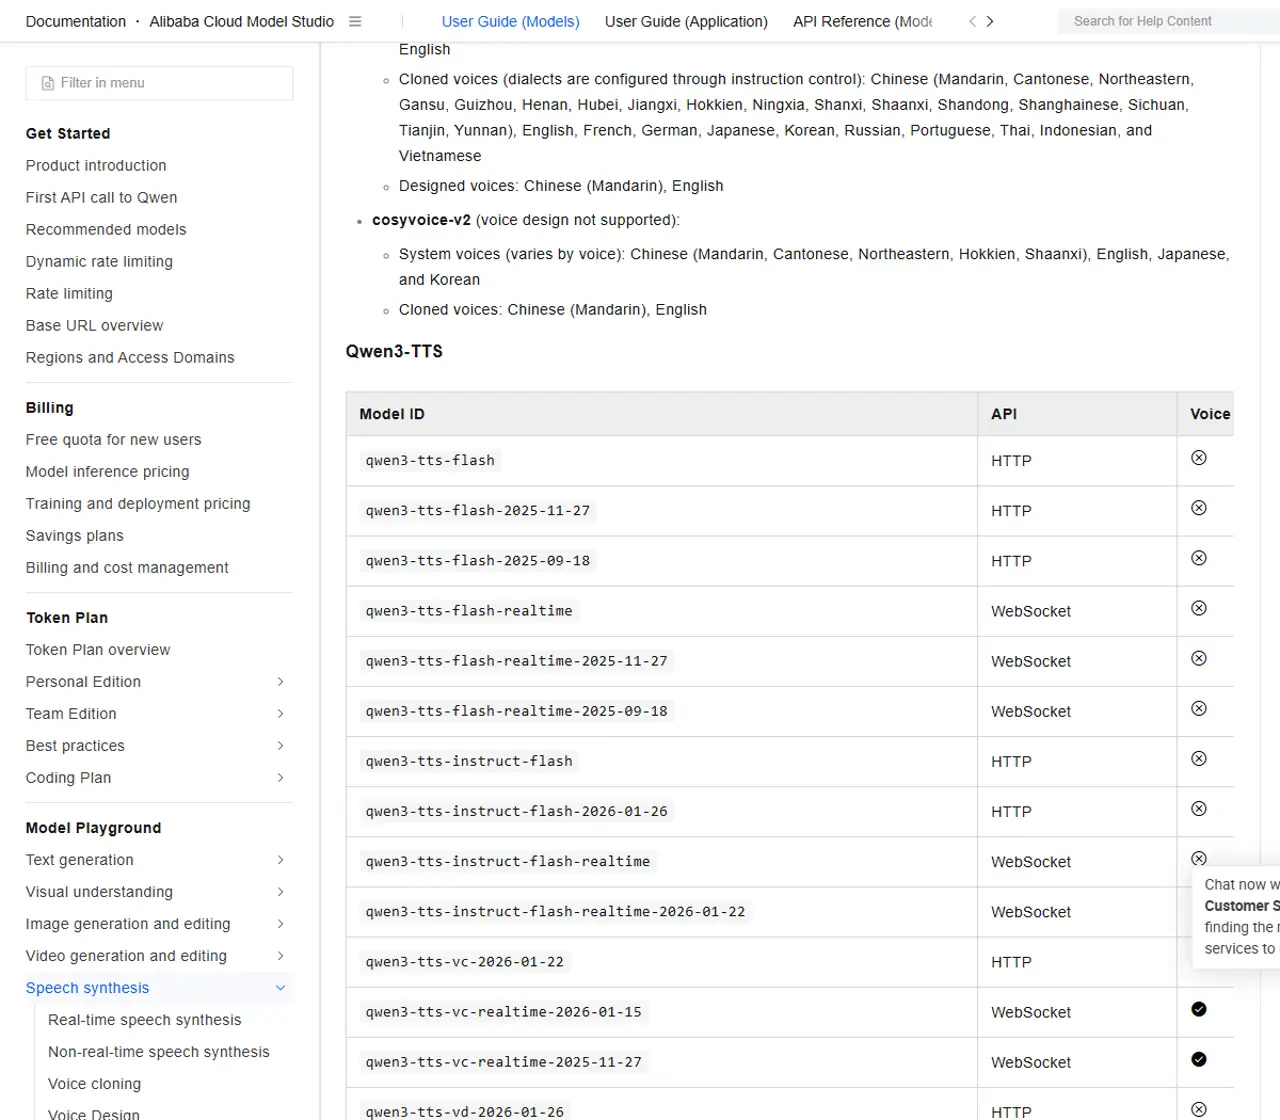
Alibaba Cloud ofrece modelos de generación HTTP no en tiempo real y de WebSocket en tiempo real. Utiliza la síntesis no en tiempo real cuando puedas esperar a obtener un resultado completo y desees el flujo de solicitud más sencillo. Utiliza la transmisión por WebSocket cuando la latencia en la conversación o la reproducción progresiva sean importantes. La transmisión por HTTP o los eventos enviados por el servidor pueden devolver datos incrementales, pero no deben confundirse con la familia de modelos dedicados en tiempo real de baja latencia.
Las familias alojadas actualmente incluyen Qwen3-TTS Flash para voces integradas, Instruct Flash para el control del rendimiento mediante lenguaje natural, VC para voces clonadas y VD para voces diseñadas. Los identificadores de modelo y las instantáneas con fecha difieren entre las rutas en tiempo real y las que no lo son, por lo que conviene copiarlos de la documentación actual en lugar de crear nombres por analogía.
La corriente Documentación de la API de Qwen-TTS limita la entrada a 512 tokens por solicitud. Ese es el límite aplicable a esta familia; no se debe copiar en una integración Qwen3-TTS una regla independiente de 600 caracteres documentada para otros modelos de TTS. Las URL de audio completas siguen siendo válidas durante 24 horas, por lo que los sistemas de producción deben trasladar los archivos necesarios a un almacenamiento duradero en lugar de utilizar la URL de respuesta como medio permanente.
import os
import dashscope

dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

response = dashscope.MultiModalConversation.call(
    model="qwen3-tts-flash",
    api_key=os.environ["DASHSCOPE_API_KEY"],
    text="Tu pedido está listo para recoger a las 16:30",
    voice="Cherry",
    language_type="English",
)

print(response)
La clave de la API y la región del punto final deben coincidir. Las implementaciones de Pekín y Singapur utilizan credenciales y URL base diferentes, mientras que la disponibilidad de los modelos puede variar según la región. Nunca incrustes la clave en WordPress, en JavaScript del lado del cliente ni en un binario para móviles. Envía las solicitudes de síntesis a través de un servidor que controles, registra los ID de las solicitudes sin registrar datos confidenciales de entrada y establece una política de ciclo de vida para el audio generado.
En el caso de documentos largos, divide el texto en fragmentos según los límites semánticos, conserva el contexto, normaliza los números y presta atención a todas las uniones. Los fragmentos válidos pueden seguir sonando como tomas independientes cuando el ritmo o la energía cambian entre una llamada y otra.
Precios del Qwen3-TTS en el mercado internacional
Resumen de precios por región a nivel internacional
Flash
$0.10
por cada 10 000 caracteres introducidosInstruct / VC / VD
$0.115
por cada 10 000 caracteres introducidosFlash / VC
$0.13
por cada 10 000 caracteres introducidosInstruir
$0.143
por cada 10 000 caracteres introducidosVD
$0.143353
por cada 10 000 caracteres introducidosCreación de voces: $0.01 por inscripción · $0.20 por voz diseñada.
Alibaba Cloud’s Página de precios de Model Studio A continuación se indican los precios para la región internacional según la información consultada el 11 de agosto de 2026. En estas filas, los caracteres de entrada se facturan, mientras que los de salida son gratuitos. Los precios, las cuotas gratuitas, los alias y la disponibilidad regional pueden variar, por lo que se recomienda confirmar la configuración seleccionada antes de realizar un lote de gran volumen.
| Ruta | Familia de modelos | Precio por cada 10 000 caracteres introducidos |
|---|---|---|
| No en tiempo real | Qwen3-TTS Flash | $0.10 |
| No en tiempo real | Instruct, VC o VD | $0.115 |
| En tiempo real | Flash o VC actual | $0.13 |
| En tiempo real | Instruir | $0.143 |
| En tiempo real | VD | $0.143353 |
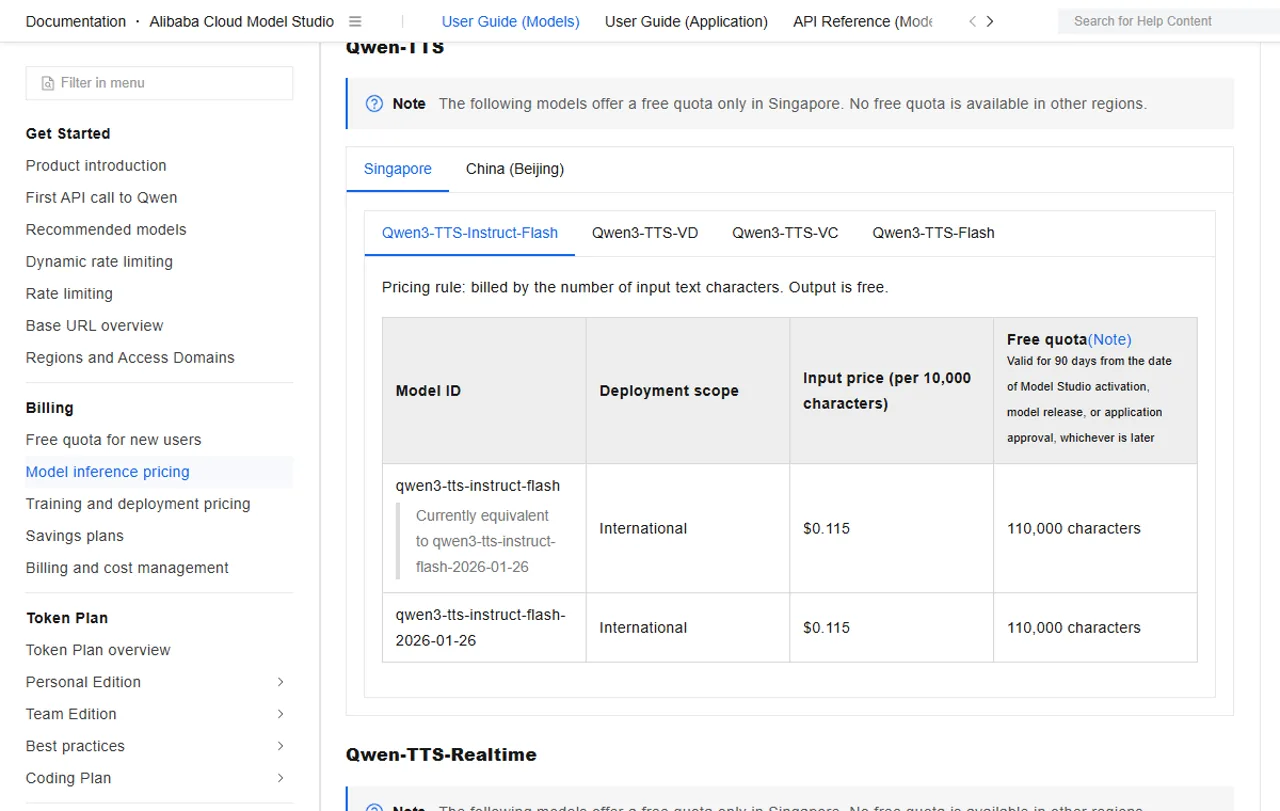
La creación de voces se cobra por separado de la síntesis. En la misma tabla de tarifas internacionales, el registro de voces Qwen tiene un coste de $0,01 por clon, y el diseño de voces, de $0,20 por voz diseñada. Una identidad clonada o diseñada puede incurrir en el coste de síntesis correspondiente por carácter cuando se utilice.
Presupuesta por separado la creación de voces, la síntesis de personajes, la infraestructura y la regeneración. El tiempo de edición y las repeticiones suelen determinar el coste real de producción.
El precio de la API no es lo mismo que el coste local. Los puntos de control abiertos eliminan la facturación por carácter de los proveedores, pero añaden el tiempo de GPU, la ingeniería de implementación, la supervisión, el almacenamiento, el escalado y la respuesta ante incidencias. El autoalojamiento resulta más ventajoso cuando el control, el volumen, la localidad de los datos o la personalización justifican esa carga operativa.
Alternativas y la ruta de audio GlobalGPT
Qwen3-TTS no es necesariamente la mejor opción para todos los proyectos de audio. ElevenLabs es una plataforma de voz gestionada más consolidada, pensada para equipos que dan prioridad a un panel de control optimizado, un amplio conjunto de herramientas de producción y una infraestructura más sencilla. Los modelos de voz de OpenAI pueden ser adecuados para desarrolladores que ya estén estandarizando su trabajo en un único ecosistema de API. Qwen-Audio 3.0 TTS es la opción alojada más reciente de Qwen que hay que tener en cuenta a la hora de seguir las recomendaciones actuales de Alibaba Cloud.
Las necesidades en materia de música y efectos de sonido deben analizarse por separado. El Comparación de audio entre el ElevenLabs, el Lyria 3 Pro y el Mureka ayuda a diferenciar las herramientas de voz hablada de la generación musical completa. Un modelo de conversión de texto a voz no debería perder puntos por no ser capaz de producir una canción masterizada, y un modelo musical no debería elegirse como API de narración de baja latencia.
GlobalGPT cuenta actualmente con un ruta del generador de audio que recoge qwen-audio-3.0-tts-flash y Seed Audio 1.0. En la página consultada no aparecía Qwen3-TTS. Esto convierte a GlobalGPT en un espacio de trabajo de audio independiente a efectos prácticos, pero no es una prueba de que los puntos de control abiertos de Qwen3-TTS estén disponibles allí.
Si tu producto final es un vídeo, decide si necesitas un narrador independiente, diálogos generados, efectos de sonido o un modelo que genere sonido junto con las imágenes. Nuestra respuesta a si el Veo 3.1 tiene sonido refleja esa decisión más amplia. La mejor estrategia suele consistir en utilizar un pequeño conjunto de herramientas especializadas, en lugar de obligar a un único modelo a realizar todas las tareas de audio.
Licencia, consentimiento, privacidad y uso comercial
El repositorio Qwen3-TTS y las fichas de modelos publicadas utilizan la licencia Apache-2.0. Esta licencia permite el desarrollo, la modificación y la distribución con fines comerciales, pero no concede derechos sobre la voz, la interpretación, el guion, la marca registrada ni los datos personales de terceros. La licencia del modelo y los derechos sobre el contenido son aspectos independientes.
La inferencia local te ofrece un mayor control y una mayor responsabilidad en materia de seguridad. Cifra las grabaciones de referencia, restringe el acceso, minimiza el tiempo de conservación, documenta los derivados y extiende la eliminación a las voces registradas y a los resultados almacenados en caché.
En el caso de la síntesis alojada, comprueba las condiciones del servicio, el tratamiento de los datos a nivel regional, los plazos de conservación y los controles corporativos antes de enviar guiones confidenciales o muestras de voz.
Toda voz clonada destinada al público debe tener un titular, un registro de consentimiento, una política de uso permitido y un procedimiento de respuesta ante abusos. Se debe incluir un aviso cuando una voz sintética pueda confundirse razonablemente con la de una persona real. Se debe impedir la suplantación de identidad de particulares y figuras públicas de alto riesgo, y ofrecer una forma de denunciar contenidos de audio perjudiciales.
¿Quién debería utilizar el Qwen3-TTS?
¿Qué ruta es la más adecuada?
Compatible con Pipeline, memoria más compacta, Base o CustomVoice.
VoiceDesign o comparación de calidad y capacidad con el margen de rendimiento de la GPU.
Operaciones más rápidas cuando la región, la política de privacidad y los precios se ajustan a tus necesidades.
Estudio sin necesidad de configuración, mercado con licencia o asistencia para proveedores ya existentes.
Qwen3-TTS es ideal para investigadores, desarrolladores, equipos de videojuegos y grupos de localización que necesiten pesos abiertos, opciones de implementación, clonación o voces de personajes descritas mediante texto.
Empieza con 0,6 mil millones si estás probando el proceso, gestionando una memoria limitada o comprobando si Base y CustomVoice se ajustan a las necesidades del producto. Empieza con 1,7B si necesitas VoiceDesign o dispones de suficiente hardware para comparar adecuadamente la calidad y el rendimiento. Utiliza la API alojada si la infraestructura es el cuello de botella y la disponibilidad regional, las credenciales y el tratamiento de datos se ajustan al proyecto.
Elige otra opción si necesitas un estudio de edición que no requiera configuración, un amplio catálogo de voces con licencia o un servicio de asistencia empresarial ya existente de otro proveedor. Nunca realices una clonación sin consentimiento documentado.
Utiliza cinco guiones reales, tres repeticiones, una lista de nombres difíciles, un párrafo largo y una prueba de recuperación. Mide la latencia y el coste y, a continuación, pregunta a oyentes nativos si el resultado está listo sin necesidad de correcciones. El trabajo de edición puede echar por tierra una victoria en las pruebas de rendimiento.
Preguntas frecuentes sobre Qwen3-TTS
¿Es gratuito el Qwen3-TTS?
Los puntos de control Qwen3-TTS publicados están disponibles bajo la licencia Apache-2.0, por lo que puedes descargarlos y ejecutarlos sin tener que pagar una tarifa por carácter del modelo. El autoalojamiento sigue conllevando costes de computación, almacenamiento, ingeniería y supervisión. Las API Qwen3-TTS alojadas en Alibaba Cloud son servicios de pago con precios y cuotas específicos para cada región.
¿Se puede utilizar Qwen3-TTS con fines comerciales?
La licencia Apache-2.0 permite el uso comercial del código y los pesos del modelo publicados, pero no te otorga derechos para clonar la voz de una persona ni para utilizar scripts y marcas protegidos. Los proyectos comerciales siguen requiriendo el consentimiento del locutor, los derechos sobre el contenido, los controles de privacidad y el cumplimiento de la legislación local y las condiciones de uso de la plataforma.
¿Qué idiomas admite Qwen3-TTS?
La versión abierta Qwen3-TTS es compatible con chino, inglés, japonés, coreano, alemán, francés, ruso, portugués, español e italiano. La cobertura lingüística de los modelos alojados puede variar según el terminal y la voz, por lo que es necesario verificar el ID exacto del modelo de Alibaba Cloud y la región antes de desarrollar un producto multilingüe.
¿Es el Qwen3-TTS realmente capaz de alcanzar una latencia de 97 ms?
Qwen registró una latencia del primer paquete de 97 ms para el modelo 0.6B a 12 Hz con un nivel de concurrencia de 1 en un entorno vLLM interno optimizado. Se trata de una referencia válida del fabricante, no de una garantía universal del dispositivo. Los arranques en frío, el hardware, la precisión, el tránsito de red, las colas y el almacenamiento en búfer del cliente pueden aumentar la latencia observada.
¿Cuánta VRAM necesita el modelo Qwen3-TTS?
No existe una cifra única y fiable de VRAM válida para todas las configuraciones. El tamaño del modelo, la precisión, el backend de atención, el tamaño del lote, la caché, la longitud de referencia y la sobrecarga del marco de trabajo son factores que influyen. La MX450 de 2 GB analizada no resultaba adecuada para realizar pruebas de rendimiento representativas; prueba el punto de control elegido con una concurrencia similar a la de producción y deja un margen operativo.
¿Cuánto material de audio se necesita para la clonación de voz con Qwen3-TTS?
Los materiales de ejemplo muestran una clonación rápida a partir de unos tres segundos, mientras que las directrices de registro del servicio alojado recomiendan un habla clara y continua y admiten muestras más largas. Considera los tres segundos como un mínimo de capacidad, no como un objetivo de calidad automático. Utiliza material de audio con consentimiento previo y sin ruidos que abarque el rango vocal normal del hablante y el idioma previsto.
¿Cuál es el límite de entrada de la API Qwen3-TTS?
La documentación actual de la API de Qwen-TTS indica que la entrada máxima para los modelos de Qwen-TTS es de 512 tokens. Las URL de audio completo tienen una validez de 24 horas. Divide los guiones largos en fragmentos según los límites semánticos y copia los resultados necesarios en un almacenamiento duradero, en lugar de considerar la URL devuelta como un alojamiento permanente.
¿Puedo utilizar el Qwen3-TTS en el GlobalGPT?
El generador de audio GlobalGPT marcado que aparece en la lista qwen-audio-3.0-tts-flash y Seed Audio 1.0, no Qwen3-TTS. Puedes utilizar esa ruta como un flujo de trabajo de audio independiente, pero no debe describirse como acceso a los puntos de control abiertos 0.6B o 1.7B de Qwen3-TTS.
Veredicto final
Esta reseña del Qwen3-TTS destaca por su inusual amplitud: puntos de control abiertos de 0,6B y 1,7B, diez idiomas, voces predefinidas, clonación rápida, VoiceDesign, arquitectura de streaming, una licencia permisiva y API alojadas.
La limitación objetiva es igualmente importante. No se generó audio real Qwen3-TTS en el entorno de trabajo disponible, y la GPU de 2 GB analizada no permitía realizar una comparación local representativa. Por ese motivo, este artículo no otorga una puntuación de calidad de voz ni afirma que el rendimiento sea universalmente de 97 ms.
Si valoras la flexibilidad en los pesos y el control, prueba primero el punto de control de 0,6B y, a continuación, compáralo con el de 1,7B utilizando los mismos scripts y el mismo hardware. Si lo que más te importa es la rapidez de puesta en producción, prueba la ruta exacta de Alibaba Cloud que tienes pensado adquirir y compárala con la familia Qwen-Audio 3.0 TTS, que se comercializa por separado. Anota el nombre del modelo, el punto final, la región, el registro de consentimiento, la latencia y el coste total de edición en la misma hoja de decisión.
Merece la pena probar Qwen3-TTS. No sirve de nada pretender que la documentación por sí sola pueda interpretar lo que quieres decir. La vía ganadora es aquella que se adapta a tus nombres, tu idioma, tu hardware, tus requisitos de privacidad y tus plazos de producción.