
La página actual de la API de OpenAI indica que, para un contexto breve, GPT-5.6 Sol equivale a $4 por cada millón de tokens de entrada y a $20 por cada millón de tokens de salida. Las tasas de contexto largo son de $8/M en entrada y $30/M en salida. La entrada en caché es de $0,40/M en contexto corto o de $0,80/M en contexto largo, y las escrituras en caché son de $5/M o $10/M, respectivamente.
En la misma página se indican, a modo de resumen, los valores de GPT-5.6 Cyber con una entrada de $12,50/M y una salida de $75/M. Según OpenAI, el precio promocional de GPT-5.6 Sol estará disponible al menos hasta el 21 de noviembre de 2026. Se trata de tarifas de la API; un plan ChatGPT o un crédito Codex constituyen una compra diferente.
Para trabajar de forma interactiva con modelos, programación y funciones creativas, GlobalGPT te ofrece un espacio de trabajo por suscripción centrado en la tarea. La cuestión es si necesitas una llamada de producción con tarificación por uso, un flujo de trabajo para desarrolladores o un entorno más económico en el que comparar y completar el trabajo antes de comprometer el presupuesto destinado a la API.
- Resumen de precios de GPT-5.6
- Tarifas de GPT-5.6 Sol y Cyber API
- Estimaciones del token GPT-5.6 ya calculadas
- Entrada almacenada en caché y contexto extenso
- Los planes ChatGPT y los créditos Codex son distintos de los precios de la API
- Elegir una API, una CLI o un espacio de trabajo multimodelo
- El acceso al plan ChatGPT es un presupuesto independiente
- Elige la ruta modelo para realizar la tarea
- Una prueba repetible del uso de tokens
- Cuándo merece la pena el gasto adicional en la API para realizar una actualización
- Desde una llamada a la API hasta un flujo de trabajo completo para desarrolladores
- PREGUNTAS FRECUENTES
Resumen de precios de GPT-5.6
| Modelo / modo | Entrada breve | Salida breve | Texto largo | Salida larga |
|---|---|---|---|---|
| GPT-5.6 Sol | $4.00/M | $20,00/M | $8.00/M | $30,00/M |
| GPT-5.6 Cyber | $12,50/M | $75,00/M | - | - |
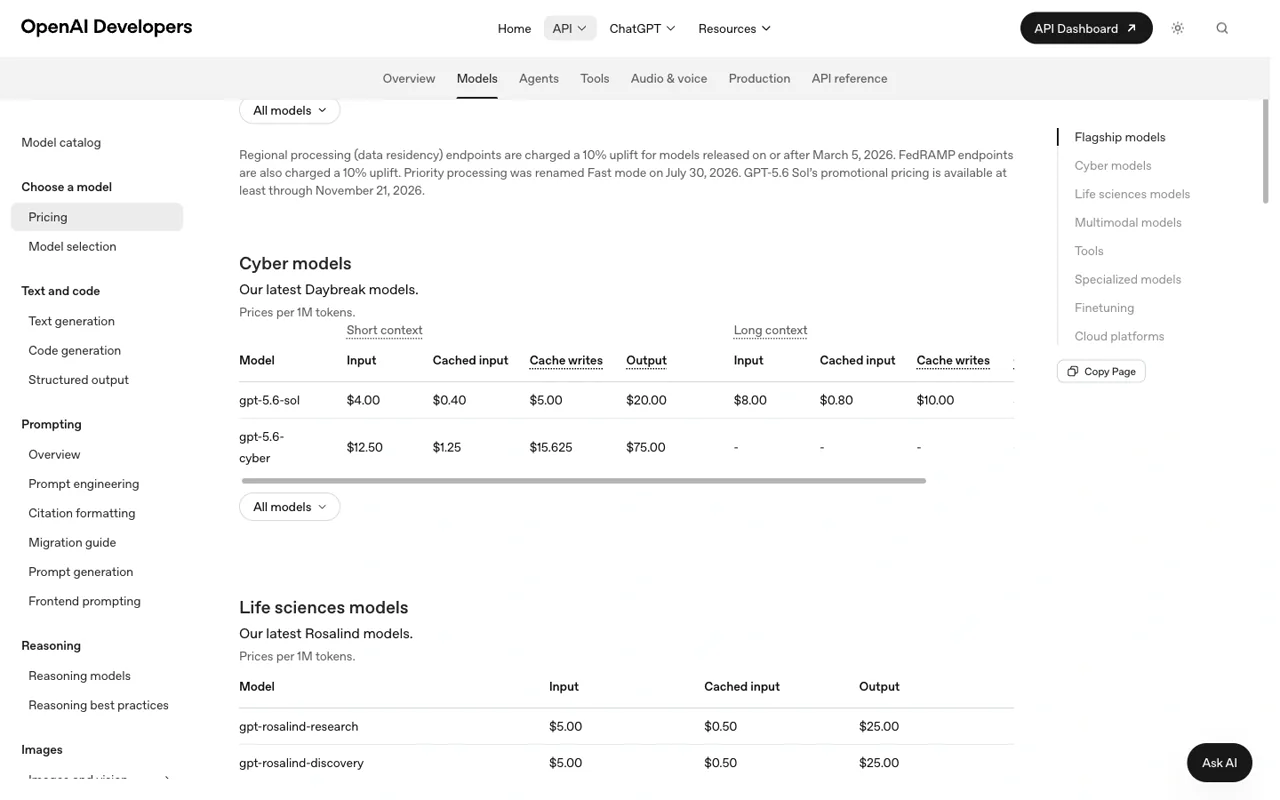
Consulta la tabla de tarifas por unidad de facturación: la entrada, la entrada almacenada en caché, las escrituras en caché y la salida aparecen en filas separadas, mientras que las solicitudes de contexto largo se clasifican en un nivel diferente.
Las entradas en caché y las escrituras en caché tienen sus propias tasas. La página de la API de OpenAI también distingue entre las columnas «Estándar», «Por lotes» y «Flex»; elige un modo que tu aplicación pueda utilizar realmente antes de aplicar un descuento a una previsión.
Tarifas de GPT-5.6 Sol y Cyber API
| Tarifa por cada millón de tokens | GPT-5.6 Posición corta en Sol | GPT-5.6 Posición larga en Sol | GPT-5.6 Corto cibernético |
|---|---|---|---|
| Entrada | $4.00 | $8.00 | $12.50 |
| Entrada almacenada en caché | $0.40 | $0.80 | $1.25 |
| Escrituras en la caché | $5.00 | $10.00 | $15.625 |
| Salida | $20.00 | $30.00 | $75.00 |
GPT-5.6 Cyber se posiciona como un modelo específico para ciberseguridad, más que como un sustituto general de Sol. Úsalo cuando la tarea se beneficie específicamente de esa opción; no compares únicamente el precio final y lo califiques como una mejora universal.
Estimaciones del token GPT-5.6 ya calculadas
Utiliza los tokens ÷ 1 000 000 × la tarifa aplicable. Estos ejemplos utilizan el contexto corto GPT-5.6 Sol y no incluyen impuestos, cargos por herramientas, diferencias entre Batch y Flex ni comisiones del plan.
| Escenario | Entrada | Salida | Presupuesto |
|---|---|---|---|
| Pequeña modificación | 20 000 × $4/M = $0,08 | 3.000 × $20/M = $0,06 | $0.14 |
| Revisión del código | 250 000 × $8/M = $2,00 (largo) | 20 000 × $30/M = $0,60 | $2.60 |
| Lote grande de contexto corto | 1M × $4/M = $4,00 | 100 000 × $20/M = $2,00 | $6.00 |
coste estimado de la API = tokens de entrada / 1 000 000 × tarifa de entrada + entrada almacenada en caché / 1 000 000 × tarifa de caché + tokens de salida / 1 000 000 × tarifa de salida + gastos de la herramienta
Entrada almacenada en caché y contexto extenso
La entrada almacenada en caché resulta útil cuando un prefijo repetido —como un resumen del sistema o un contexto de repositorio— cumple los requisitos para su almacenamiento en caché. Sin embargo, esto no reduce el coste de todas las solicitudes repetidas. Utiliza los datos de facturación de uso para confirmar las coincidencias en la caché y añade los costes de escritura en caché o de almacenamiento cuando el proveedor los especifique.
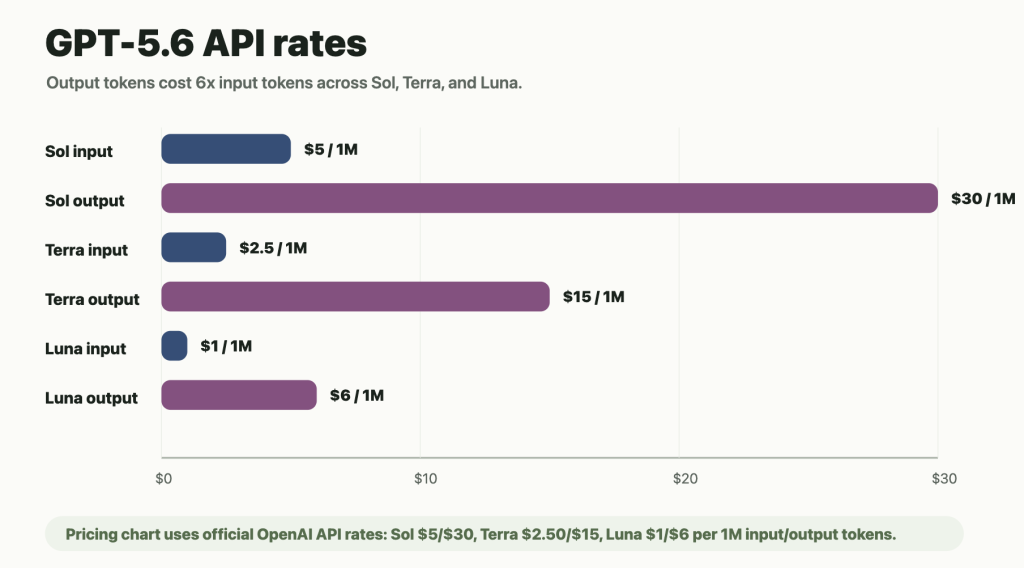
El contexto largo también modifica el nivel de tarifa. Si la solicitud supera el límite de contexto largo del proveedor, utiliza los precios de entrada y salida del contexto largo para esa solicitud, en lugar de aplicar la tarifa del contexto corto a toda la factura.
Los planes ChatGPT y los créditos Codex son distintos de los precios de la API
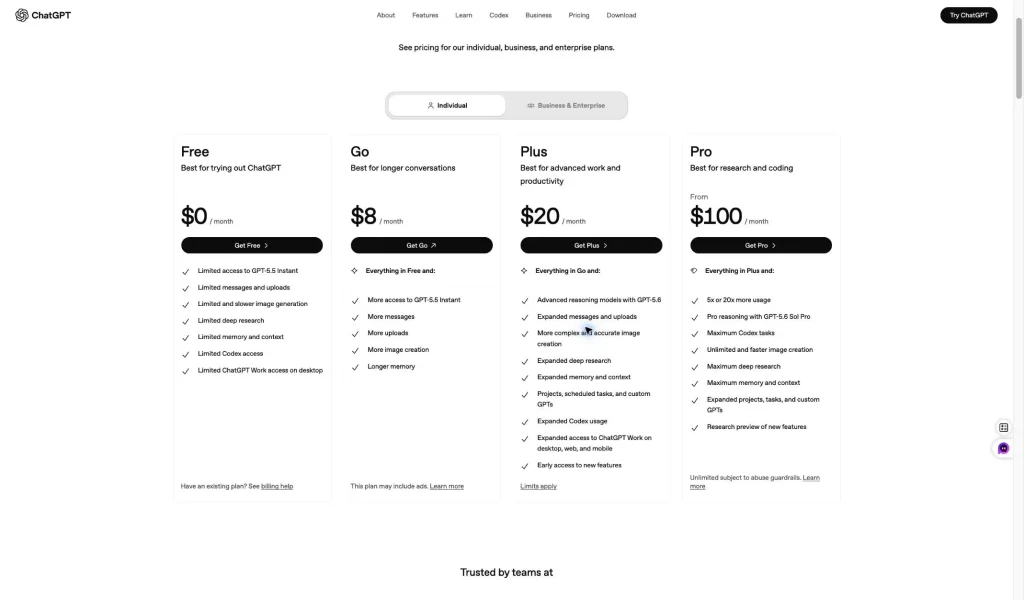
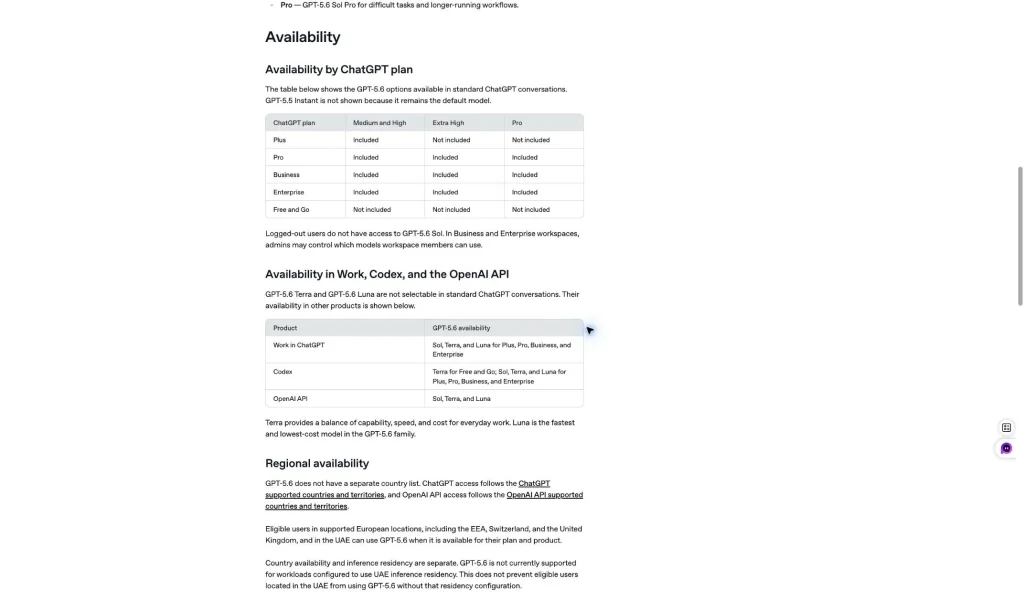
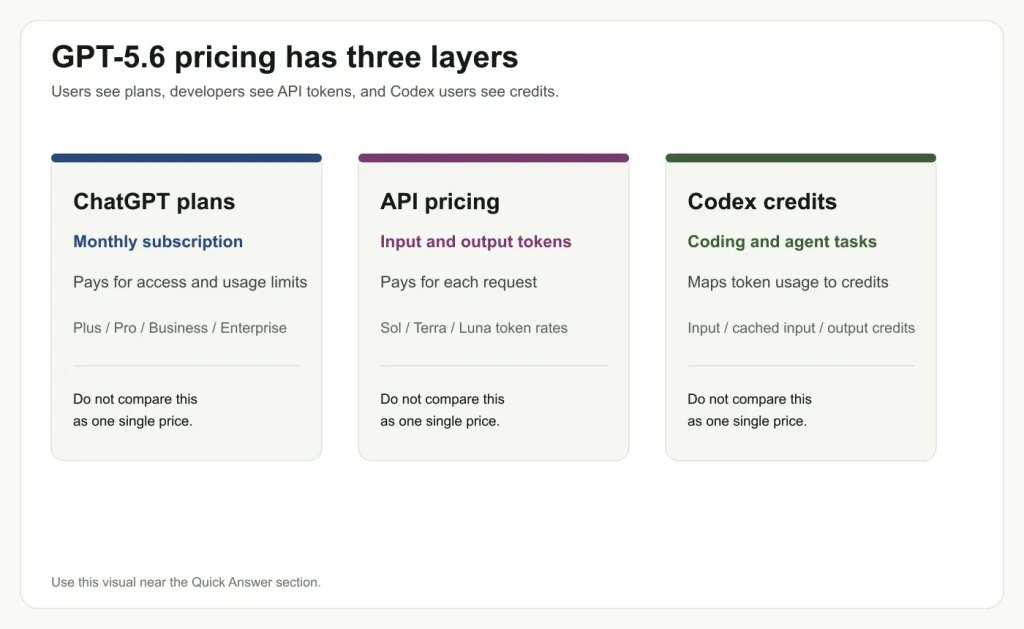
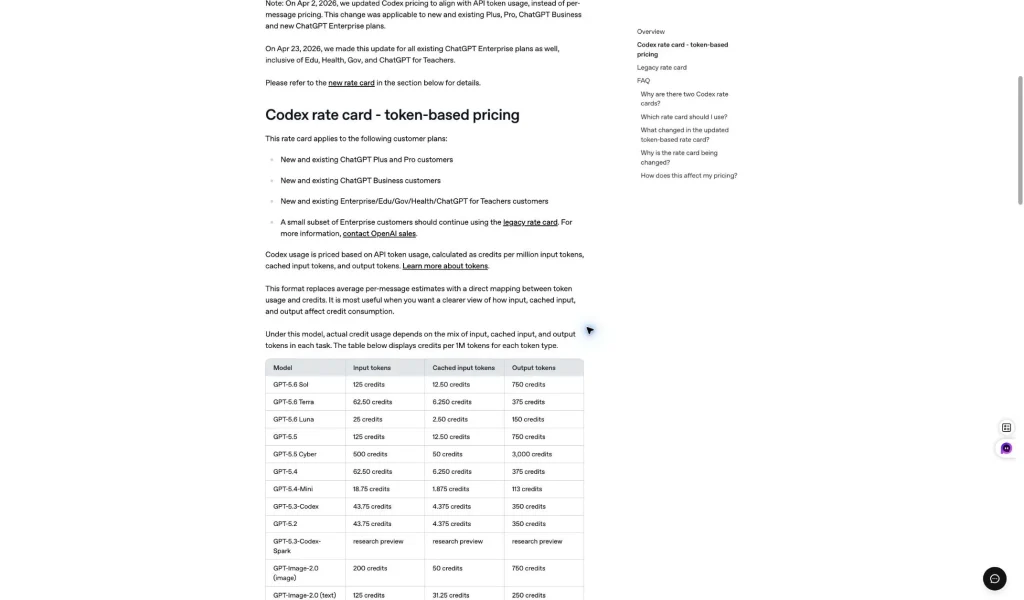
Las suscripciones ChatGPT incluyen el acceso a la aplicación y a sus funciones. Los créditos de Codex corresponden al uso dentro de la interfaz de un producto. Las llamadas a la API se contabilizan en función de un proyecto de desarrollador. Mantén estos tres presupuestos separados cuando compares los “precios de GPT-5.6”.”
Elegir una API, una CLI o un espacio de trabajo multimodelo

Utiliza la API para gestionar el tráfico de producción de forma programable y realizar la contabilidad a nivel de token. Utiliza la CLI cuando el modelo deba estar vinculado a un terminal y a un repositorio. Utiliza MCP cuando el flujo de trabajo dependa de herramientas aprobadas. Utiliza un agente Yukie cuando la tarea abarque la planificación, el uso de herramientas y los traspasos.
GlobalGPT Se adapta a la capa de comparación interactiva y entrega: prueba diferentes modelos, pasa a la fase de programación u otras funciones de IA, y mantén la decisión sobre la suscripción separada de la factura de la API de OpenAI. Su menor coste global del flujo de trabajo es una propuesta de valor, no una afirmación de que modifica las tarifas de OpenAI.
El acceso al plan ChatGPT es un presupuesto independiente
Una suscripción ChatGPT da derecho al acceso a una interfaz de producto. La API cobra a un proyecto de desarrollador por token, y los créditos de Codex representan el uso dentro del flujo de trabajo de un producto. Estos registros pueden estar relacionados con la misma familia de modelos, aunque se trate de compras diferentes.
| Ruta | Lo que pagas por | La mejor pregunta que se puede hacer |
|---|---|---|
| Plan ChatGPT | Acceso a la aplicación interactiva y características de la tarifa | ¿El plan incluye el modelo y las herramientas que necesito? |
| API de OpenAI | Entrada, entrada almacenada en caché, escrituras en caché, salida y costes de herramientas | ¿Cuánto costará esta carga de trabajo con su volumen real de tokens? |
| Créditos de Codex | Uso en la superficie del producto Codex | ¿Qué volumen de trabajo relacionado con el repositorio o la programación cubre el presupuesto destinado a créditos? |
| Espacio de trabajo de GlobalGPT | Un flujo de trabajo de suscripción más amplio que abarca distintos modelos y herramientas | ¿Puedo realizar la tarea sin tener que pagar por varios productos distintos? |
No utilices el precio del plan ChatGPT como previsión de API, ni utilices una tarifa de API para describir el acceso por suscripción. Una comparación clara empieza por nombrar la vía que realmente hará llegar tu trabajo a su destino.
Elige la ruta modelo para realizar la tarea
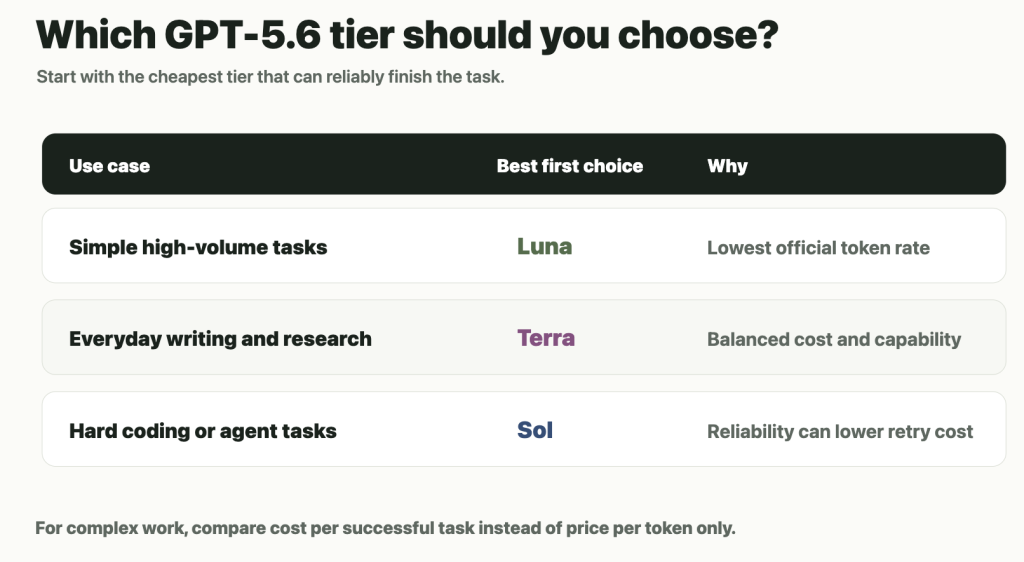
La fila más barata no es necesariamente la tarea completada más barata. Una edición breve puede resultar económica en un modelo general, mientras que un contexto de repositorio extenso puede hacer que el nivel de contexto y la longitud de la salida cobren mayor importancia. En el caso de una llamada en producción, registra por separado los tokens de entrada, la entrada almacenada en caché, los tokens de salida y cualquier llamada a herramientas.
| Modalidad de trabajo | Indicador presupuestario | Buenas prácticas de funcionamiento |
|---|---|---|
| Transformación de textos breves | La producción suele ser escasa | Establece un formato de salida claro y una condición de finalización. |
| Revisión exhaustiva de un código o documento | Es posible que se aplique el nivel de contexto amplio | Mide el tamaño del mensaje antes de enviar el repositorio completo. |
| Contexto repetido del sistema o del repositorio | Los datos almacenados en caché pueden ser importantes | Confirma las entradas efectivas en la caché en los datos de uso. |
| Flujo de trabajo autónomo de herramientas | Las llamadas a herramientas añaden uso | Registra el modelo, la herramienta y el coste de la producción en un mismo lugar. |
Utiliza el selector de modelos y la tabla de tarifas actuales para conocer los nombres exactos de los modelos y las condiciones de acceso. Si cambia la denominación de un modelo, el método de presupuestación sigue siendo el mismo: asigna la tarea a la ruta y, a continuación, multiplica las unidades reales.
Una prueba repetible del uso de tokens
Para estimar una tarea real, utiliza la misma instrucción, la misma entrada y el mismo resultado esperado en dos ejecuciones. Registra los tokens de entrada, los tokens de salida, el estado de la caché y si se ha realizado una llamada a una herramienta. A continuación, compara el coste de un resultado satisfactorio, en lugar de comparar un precio de referencia de forma aislada.
- Utiliza un código breve y representativo o una tarea de redacción.
- Mantén el formato de salida fijo para que la comparación sea justa.
- Anota el primer resultado y el resultado final tras cualquier nuevo intento.
- Separa los errores de los proveedores, los límites de tarifas y la calidad del modelo del cálculo del precio.
- Anótalo con la fecha, ya que los precios promocionales y la disponibilidad de los modelos pueden variar.
Esto convierte la pregunta “¿qué modelo es más barato?” en una pregunta operativa útil: ¿qué vía permite completar la tarea con el menor gasto y el menor volumen de trabajo adicional previsibles?
Cuándo merece la pena el gasto adicional en la API para realizar una actualización
Un modelo más nuevo justifica su mayor coste cuando reduce un modo de fallo real: correcciones repetidas, llamadas a herramientas omitidas, código frágil o una solicitud de entrada larga que la opción más económica no puede gestionar de forma fiable. Si el resultado ya es correcto y breve, un modelo más caro puede resultar un derroche.
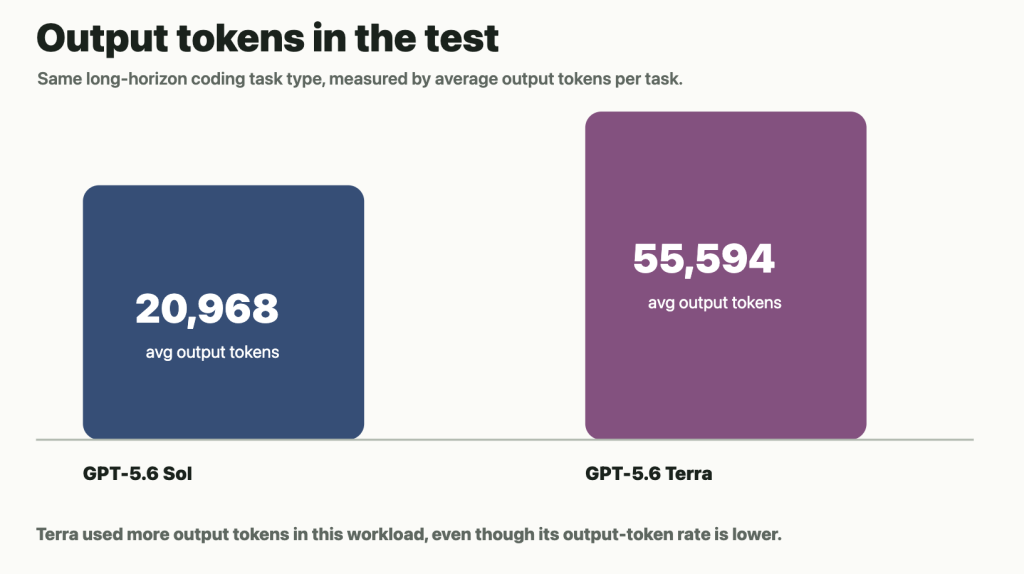
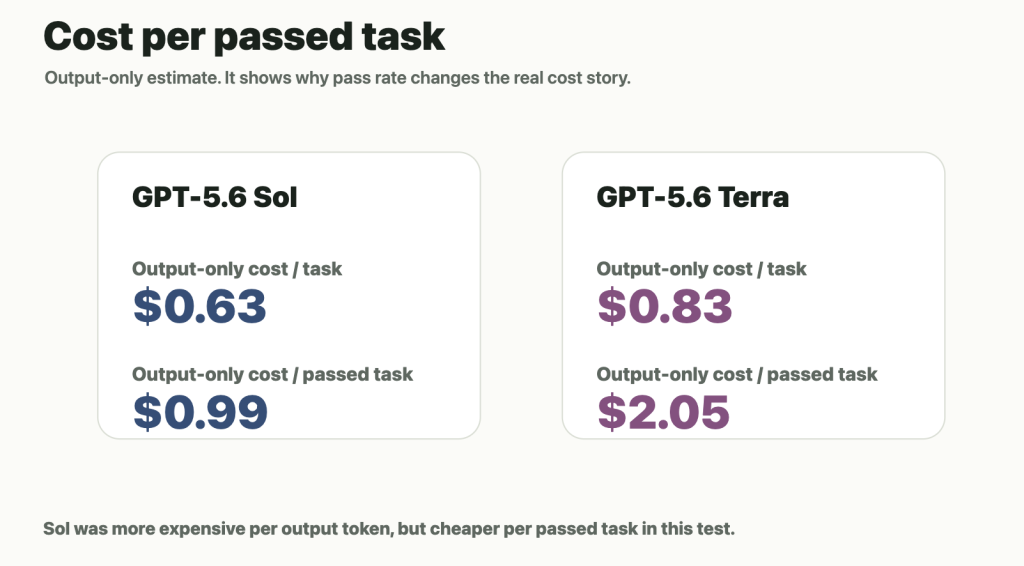
En el caso de un equipo, compara tres cifras correspondientes al mismo conjunto de tareas: el número de tareas completadas con éxito, el promedio de tokens generados y el tiempo de corrección humana. El modelo con el precio por token más bajo no siempre supone el menor coste total del proyecto.
Desde una llamada a la API hasta un flujo de trabajo completo para desarrolladores
Utilice el Ruta de la API GlobalGPT para llamadas programables, CLI cuando el modelo debe situarse junto a un terminal y un repositorio, y MCP cuando el flujo de trabajo depende de herramientas homologadas. Un agente Yukie puede coordinar la planificación, el uso de herramientas y los traspasos. Para el trabajo interactivo, Acceso al espacio de trabajo GlobalGPT y GPT-5.6 te permite probar la tarea antes de comprometerte con una ruta de producción con consumo medido.
La ventaja práctica radica en el proceso: definir claramente la tarea, comparar un modelo adecuado, ejecutar la prueba útil más sencilla y, a continuación, trasladar el comando operativo a la API, la CLI o el MCP. De este modo, se mantienen separados los gastos destinados a la experimentación y a la producción.
PREGUNTAS FRECUENTES
¿Cuál es el precio de la API GPT-5.6 Sol?
OpenAI indica una entrada de $4/M y una salida de $20/M para el contexto corto, y una entrada de $8/M y una salida de $30/M para el contexto largo. La entrada en caché y las escrituras en caché utilizan velocidades distintas.
¿Es más caro el GPT-5.6 Cyber?
Sus tasas de contexto corto publicadas son $12,50/M de entrada y $75/M de salida, por lo que se trata de una decisión presupuestaria diferente y debería elegirse para una tarea que requiera su ruta específica.
¿Incluye ChatGPT Plus créditos de API?
No des eso por sentado. Las suscripciones a ChatGPT y los proyectos de API son entidades de facturación independientes.
¿Qué son los créditos Codex?
Son créditos de uso de productos cuyo consumo real depende del modelo y del uso de tokens. Manténlos separados de la previsión de un proyecto de API.
¿Cuál es la forma más económica de utilizar GPT-5.6?
Para trabajar de forma interactiva con varios modelos, compara un plan de espacio de trabajo actual. En el caso del software de producción, compara las estimaciones de tokens, los aciertos en la caché, el nivel de contexto y la tasa de finalización del modelo que elijas.
Empieza por la unidad de facturación: Las tarifas de los tokens responden a la pregunta sobre la API; el acceso al plan, los créditos y el valor del flujo de trabajo responden a la pregunta sobre el producto.





