Empieza por el sonido que quieras producir. Elige «Eleven Music v2» para canciones e instrumentales estructurados, «Qwen Audio 3.0 TTS Flash» para la narración y las voces expresivas, y «Seed Audio 1.0» cuando quieras combinar diálogo, ambiente y efectos en una escena completa.
No es necesario encontrar un único modelo de audio ‘óptimo’. Un creador que compone música de fondo necesita algo diferente a un profesional del marketing que graba una voz en off o a un cineasta que está rodando una escena en una estación de tren. Hemos probado esos trabajos reales —no solo las listas de características— y puedes escuchar los diez primeros resultados a continuación.
Si quieres probar la misma idea con tu propia indicación, GlobalGPT te ofrece un único lugar desde el que alternar entre los tres. Además, es un espacio de trabajo multimodelo más amplio: puedes utilizar modelos como GPT-5.6 Sol, Claude Opus 4.8 y Gemini 3.1 Pro para escribir e investigar, y luego pasar a GPT Image 2 o Seedance 2.0 cuando el proyecto requiera imágenes o vídeo. Esto significa que puedes redactar el guion, generar el audio y seguir desarrollando el resto del proyecto sin tener que combinar un montón de herramientas independientes. El acceso a los modelos varía según el plan.
Empieza por lo que quieras hacer
Son puntos de partida, no una clasificación universal.
Respuesta rápida: ¿qué modelo es el más adecuado para cada tarea de audio?
Esta es la forma más sencilla de decidir: elige en función del resultado final, no de la marca. Eleven es el punto de partida natural cuando el resultado final es música; Qwen TTS Flash es ideal para la narración y las voces expresivas; Seed se adapta a las escenas que requieren diálogo, ambiente y efectos al mismo tiempo. Nuestras seis pruebas prácticas muestran en qué casos cada opción nos pareció más adecuada, y los diez reproductores que aparecen a continuación te permiten escuchar por ti mismo las diferencias entre ellas.
| Modelo | Empieza por aquí cuando… | Lo que probamos | Ten en cuenta que |
|---|---|---|---|
| Eleven Music v2 | Necesitas una canción o un tema instrumental con estructura | Dos enfrentamientos musicales y una actuación de canciones con voz | No lo utilizamos para la narración |
| Qwen Audio 3.0 TTS Flash | Necesitas una narración o una voz expresiva | Dos enfrentamientos de discursos | Estos resultados se refieren a la versión de Flash sometida a prueba |
| Seed Audio 1.0 | Necesitas una escena completa con varios tipos de sonido | Música, diálogos y una escena en una estación de tren | Una salida flexible no reproduce todas las características de la fase anterior |
En primer lugar, hay tres tipos diferentes de modelos de audio
Eleven Music v2: un flujo de trabajo específico para la música
ElevenLabs describe Eleven Music como texto convertido en música, con control sobre el género, el estilo y la estructura. La documentación también muestra resultados vocales o instrumentales, la generación multilingüe y la edición por secciones o de toda la canción. Estas características lo convierten en el flujo de trabajo musical especializado más claro de los aquí presentados; sin embargo, ello no implica que se trate del mismo tipo de solución de síntesis de voz (TTS) que Qwen.

Qwen Audio 3.0 TTS Flash: la ruta de voz probada en este caso
Qwen Audio 3.0 TTS Flash: la ruta exacta de Anywhere es qwen-audio-3.0-tts-flash—es la vía del habla que se utiliza en los niveles B1 y B2. Documentación sobre la síntesis de voz de Alibaba Cloud incluye ese nombre exacto de Flash en su contexto de voz personalizada. Este artículo no transfiere las especificaciones relativas a la duración, el formato o las voces integradas de otras filas o variantes de Qwen.

Seed Audio 1.0: un flujo de trabajo más amplio para el ámbito del audio
Puestos en ByteDance Seed Audio 1.0 para la generación de escenas completas que abarcan voces, efectos de sonido, ambiente y orquestación unificada. Esto la convierte en la opción más lógica cuando una salida debe coordinar varios tipos de sonido. La imagen capturada no hace ninguna referencia visible a la música, por lo que las observaciones musicales de este artículo se basan en nuestras pruebas prácticas y no en dicha imagen.

El separado Página de la API de BytePlus identifica seed-audio-1.0 como una ruta sin transmisión en directo con entradas de audio o imagen de referencia, control de sincronización y una duración de salida de hasta 120 segundos. Estos son los datos de la ruta, que se mantienen separados de la declaración más amplia sobre el posicionamiento del modelo.

Cómo hemos probado los tres flujos de trabajo de audio
Congelamos las indicaciones antes de la generación, enviamos diez tareas de forma secuencial y conservamos el primer resultado válido de cada tarea. Las diez solicitudes se completaron con éxito sin necesidad de reintentos. Se excluyeron los fragmentos de preparación; el audio de prueba que se muestra a continuación es el primer resultado válido sin procesar.
- Pruebas oficiales: documentación sobre productos propios o sobre API.
- Pruebas observadas de la ruta: formato, duración, coste, decodificación y comprobaciones de la señal de esta sesión.
- Pruebas auditivas: las preferencias por pares a ciegas de un usuario respecto a A1, A2, B1 y B2, además de una revisión semántica de C1 y C3.
- Límites: No se ejecutó la prueba de estabilidad; los archivos B1 y B2 no se transcribieron ni se revisaron automáticamente palabra por palabra.
El importe total cobrado fue de $0,4819752667 por diez resultados. Esa cifra corresponde a esta sesión y no constituye una promesa oficial de precio.
Pruebas musicales: Eleven Music v2 frente a Seed Audio 1.0
A1: Banda sonora de fondo para un documental
A1: Banda sonora de fondo para documentales
Música de fondo instrumental de 30 segundos para un documental de viajes, con una progresión suave y un final resuelto.
Mostrar el mensaje exacto que se ha quedado bloqueado
Crea una banda sonora instrumental de 30 segundos para un breve documental de viajes. Empieza con una suave guitarra acústica tocada con los dedos y un piano cálido; añade una ligera percusión manual tras el primer tercio; ve aumentando el volumen suavemente y termina con una cadencia clara y resuelta. Que transmita esperanza y sea reflexiva. Sin voces, sin diálogos ni efectos de sonido.
| Modelo | Ruta exacta | Estado | Duración real | Formato | Coste observado |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Primera fecha de validez | 30,041 s | MP3, estéreo a 44,1 kHz | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Primera fecha de validez | 30 000 | PCM WAV, 40 kHz, estéreo | $0.0700000 |
- Comprobaciones objetivas
- Ambos archivos se descodificaron correctamente, no presentaron ningún signo de saturación y terminaron con un fundido nítido. No se registró el cumplimiento exhaustivo de los parámetros de los instrumentos.
- Juicio del oyente
- El oyente prefirió Eleven Music v2 porque la progresión de lo suave a lo intenso le pareció más natural y la coordinación instrumental sonaba más armoniosa.
- Resultado de la tarea
- Se ha elegido el número once para esta primera tarea.
- Limitaciones
- Una primera salida válida por modelo; no se ha ejecutado la prueba de estabilidad.
Prueba de comprensión auditiva del A1
Escucha las primeras grabaciones del A1
Juega cualquiera de las dos cartas para comparar ambos modelos directamente.
Eleven Music v2
eleven-music-v2Generado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
Seed Audio 1.0
seed-audio-1.0Generado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
En el caso de A1, el oyente eligió la primera versión de Eleven por su transición más natural de lo ligero a lo intenso y por una coordinación instrumental más armoniosa.
A2: Señal estructurada para el lanzamiento de un producto
A2: Señal estructurada para el lanzamiento de un producto
Una pieza instrumental cronometrada de tres partes y 30 segundos de duración: ritmo minimalista, incorporación de percusión y aumento de la energía, para terminar con un brillante crescendo final.
Mostrar el mensaje exacto que se ha quedado bloqueado
Crea una pieza instrumental de 30 segundos para el lanzamiento de un producto, dividida en tres secciones bien diferenciadas: de 0 a 8 segundos, un pulso sintético minimalista; de 8 a 22 segundos, añade una batería electrónica nítida y una energía armónica creciente; de 22 a 30 segundos, crea un remate final brillante y un final limpio. Moderno y enérgico, pero sin resultar agresivo. Sin voces, diálogos ni sonidos ambientales.
| Modelo | Ruta exacta | Estado | Duración real | Formato | Coste observado |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Primera fecha de validez | 30,041 s | MP3, estéreo a 44,1 kHz | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Primera fecha de validez | 27,704 s | PCM WAV, 40 kHz, estéreo | $0.0646436 |
- Comprobaciones objetivas
- Ambos archivos se descodificaron correctamente sin apenas pérdida de señal. La semilla devolvió 27,704 segundos para una solicitud de 30 segundos; se trata de un comportamiento propio de la ruta, no de una merma en la calidad.
- Juicio del oyente
- El oyente prefirió Seed Audio 1.0 por su introducción más nítida y su mayor riqueza en las capas musicales; la introducción de Eleven resultaba difícil de escuchar.
- Resultado de la tarea
- Se ha elegido la semilla preferida para esta primera tarea de salida; las dos pruebas musicales se han dividido.
- Limitaciones
- No se ha comprobado de forma exhaustiva la sincronización exacta de los tramos; no se han realizado pruebas de estabilidad.
Prueba de comprensión auditiva del nivel A2
Escucha las primeras grabaciones del A2
Juega cualquiera de las dos cartas para comparar ambos modelos directamente.
Eleven Music v2
eleven-music-v2Generado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
Seed Audio 1.0
seed-audio-1.0Generado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
En el caso de A2, la primera propuesta de Seed se ganó la preferencia de los oyentes porque la introducción era más clara y las capas sonaban más ricas. La propuesta de Seed dio como resultado 27,704 segundos para una solicitud de 30 segundos; registramos esa variación por separado, sin considerarla una penalización en cuanto a la calidad. Dado que cada modelo ha obtenido mejores resultados en una tarea musical, no hay un ganador en la categoría de música.
Pruebas de voz: Qwen TTS Flash frente a Seed Audio 1.0
B1: Narración documental neutra
B1: Narración documental neutra
La misma narración sobre el puerto inglés, con un tono tranquilo y neutro, un ritmo moderado y pausas naturales.
Mostrar el mensaje exacto que se ha quedado bloqueado
Cada mañana, el puerto se despierta antes que la ciudad. Los transbordadores cruzan el agua, se encienden las luces de las tiendas y los primeros viajeros pisan el muelle. A las siete en punto, la tranquila costa se ha convertido en el centro de la jornada. Narración documental tranquila en un inglés claro y neutro. Utiliza un ritmo moderado y pausas naturales. Sin música, ambiente ni efectos de sonido.
| Modelo | Ruta exacta | Estado | Duración real | Formato | Coste observado |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Primera fecha de validez | 27,507 s | MP3, 22,05 kHz, mono | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | Primera fecha de validez | 18,780 s | PCM WAV, 40 kHz estéreo (canales idénticos) | $0.0438200 |
- Comprobaciones objetivas
- Ambos archivos se descodificaron correctamente y contenían actividad similar al habla y pausas. El usuario no señaló ningún problema evidente con el texto.
- Juicio del oyente
- El oyente prefirió Qwen por considerarlo más natural y con un estilo más documental; Seed sonaba rígido, como un recordatorio previo al examen.
- Resultado de la tarea
- Se recomienda utilizar Qwen para esta primera tarea de salida.
- Limitaciones
- No se ha comprobado la exactitud palabra por palabra; no se ha comprobado la estabilidad.
Prueba de comprensión auditiva del nivel B1
Escucha las primeras grabaciones del B1
Juega cualquiera de las dos cartas para comparar ambos modelos directamente.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashGenerado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
Seed Audio 1.0
seed-audio-1.0Generado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
El primer resultado de Qwen sonaba más natural y parecía sacado de un documental; el de Seed resultaba algo rígido para el oyente. Si la revisión de transcripciones es un elemento fundamental de tu flujo de trabajo, en esta guía independiente se explica Cómo puede ChatGPT transcribir audio. No utilizamos la transcripción para verificar el texto B1 palabra por palabra.
B2: Progresión emocional
B2: Progresión emocional
Una voz femenina que pasa de un susurro tenso a una narración neutra y, finalmente, a un tono de emoción y alivio.
Mostrar el mensaje exacto que se ha quedado bloqueado
“Lo hemos conseguido”, susurró Maya. Entonces se encendieron las luces. “Vale, ¡ahora ya podemos celebrarlo!”. Utiliza una sola voz femenina adulta y coherente. Pronuncia la primera frase en voz baja y con tensión, la frase del medio con un tono narrativo neutro y la última frase con emoción y alivio. Mantén claros los cambios emocionales, pero sin exagerar. Sin música ni efectos de sonido.
| Modelo | Ruta exacta | Estado | Duración real | Formato | Coste observado |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Primera fecha de validez | 25,913 s | MP3, 22,05 kHz, mono | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | Primera fecha de validez | 9,180 s | PCM WAV, 40 kHz estéreo (canales idénticos) | $0.0214200 |
- Comprobaciones objetivas
- Ambos archivos se descodificaron correctamente; se detectaron varias regiones de voz. Las diferencias de duración no se tuvieron en cuenta a la hora de evaluar la calidad.
- Juicio del oyente
- El oyente prefirió el Qwen por su sonido más susurrante y por la sensación de que la narración resultaba más convincente.
- Resultado de la tarea
- Se recomienda utilizar Qwen para esta primera tarea de salida.
- Limitaciones
- No se ha comprobado la exactitud palabra por palabra; no se ha comprobado la estabilidad.
Prueba de comprensión auditiva del nivel B2
Escucha las primeras grabaciones del B2
Juega cualquiera de las dos cartas para comparar ambos modelos directamente.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashGenerado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
Seed Audio 1.0
seed-audio-1.0Generado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
La primera respuesta de Qwen tenía un carácter más susurrante y transmitía una mayor sensación narrativa. El usuario no detectó ningún problema evidente en el texto de B1 ni de B2, pero aún no se ha verificado la exactitud de las palabras.
Ejemplos de flujos de trabajo con un único modelo
C1: Canción vocal estructurada «Eleven Music v2»
C1: Canción vocal estructurada
Una canción de indie-pop de 30 segundos con instrumentación y estructura fijas, y dos versos obligatorios.
Mostrar el mensaje exacto que se ha quedado bloqueado
Crea una canción de indie-pop alegre de 30 segundos con una vocalista principal femenina, guitarra brillante, bajo y palmas. Estructura: una introducción instrumental de cuatro segundos, una estrofa corta, un estribillo y un final limpio. Utiliza cada una de estas frases de la letra una vez: Estrofa: ‘La mañana en la ventana, los planes echan a volar’. Estribillo: ‘Empieza donde estás y haz que el momento brille’. Sin narración hablada ni efectos de sonido.
| Modelo | Ruta exacta | Estado | Duración real | Formato | Coste observado |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Primera fecha de validez | 30,041 s | MP3, estéreo a 44,1 kHz | $0.0750000 |
- Comprobaciones objetivas
- El MP3 se ha descodificado correctamente. Se ha detectado una muestra aislada insignificante a escala completa, sin recortes generalizados.
- Juicio del oyente
- El oyente consideró que se cumplía parcialmente: la voz sonaba un poco artificial y tenía un tono de ruido eléctrico.
- Resultado de la tarea
- Se ha cumplido parcialmente este primer objetivo.
- Limitaciones
- Esta observación se refiere únicamente a este primer resultado; no se ha comprobado la estabilidad.
Prueba de comprensión auditiva del C1
Escucha la primera salida del C1
Reproduce la primera salida válida de esta presentación de un solo modelo.
Eleven Music v2
eleven-music-v2Generado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
C1 cumplió parcialmente con lo estipulado en el contrato. El oyente consideró que la voz sonaba algo poco natural y percibió un ruido de fondo de carácter eléctrico. Se trata de una observación específica de esa muestra, no de una reclamación por defecto general.
C3: Seed Audio 1.0 — Escena completa de una estación de tren
C3: Escena completa de la estación de tren
Una escena de 20 segundos en una estación costera que combina el ambiente de fondo, un tren en movimiento, un timbre y un anuncio concreto.
Mostrar el mensaje exacto que se ha quedado bloqueado
Crea una escena completa de 20 segundos en una estación de tren costera al amanecer. Empieza con una suave brisa marina y gaviotas en la lejanía. Un tren se acerca por la izquierda y frena en el andén. Una locutora de la estación, con voz tranquila, dice exactamente lo siguiente: ‘El servicio costero de las siete y cuarto llega ahora al andén dos’. Añade un breve y suave toque musical antes del anuncio y, a continuación, deja que el tren y el ambiente se desvanezcan de forma natural. Mantén la inteligibilidad del discurso y la coherencia espacial de la escena.
| Modelo | Ruta exacta | Estado | Duración real | Formato | Coste observado |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | Primera fecha de validez | 20 000 | PCM WAV, 40 kHz, estéreo | $0.0466667 |
- Comprobaciones objetivas
- El archivo WAV se decodificó correctamente, no presentaba ningún signo de saturación y, desde el punto de vista técnico, contenía la estructura de escena en varias partes solicitada.
- Juicio del oyente
- El oyente consideró que se cumplía parcialmente porque los sonidos de frenada y parada del tren parecían algo artificiales.
- Resultado de la tarea
- Se ha cumplido parcialmente este primer objetivo.
- Limitaciones
- El texto exacto del anuncio no se transcribió de forma independiente; no se ha comprobado su veracidad.
Prueba de comprensión auditiva C3
Escucha la primera salida del C3
Reproduce la primera salida válida de esta presentación de un solo modelo.
Seed Audio 1.0
seed-audio-1.0Generado mediante la ruta «Anywhere» probada el 6 de agosto de 2026. Un primer resultado válido; no se ha comprobado la estabilidad.
C3 también cumplió parcialmente con lo estipulado en el contrato: al oyente le parecieron algo artificiales los sonidos de frenada y parada del tren. A los creadores de vídeos que combinan voz generada con imágenes también les puede parecer esto Guía sobre diálogos, audio y sincronización labial útil, aunque aquí no se ha comprobado la sincronización labial.
Coste, longitud de salida y comportamiento de la ruta
Carga observada y duración real de la producción
Una primera valoración válida por tarea a través de Anywhere el 6 de agosto de 2026. Las tarifas corresponden a observaciones de sesión, no a una tarifa oficial. Las dos minibarras utilizan escalas visuales independientes; no se utiliza ningún eje doble ni puntuación combinada.
Los costes observados oscilan entre $0,00513 para Qwen B1 y $0,075 por cada salida de Eleven. La duración real oscila entre los 9,180 segundos de Seed B2 y los 30,041 segundos de las salidas musicales de Eleven. Se trata de resultados medidos en sesiones reales, no de precios de catálogo ni de puntuaciones de calidad.
¿Por qué probar estos modelos de audio en GlobalGPT?
La generación de música, la síntesis de voz expresiva y los paisajes sonoros completos son tareas diferentes, por lo que en este caso no hay un único modelo que destaque por encima del resto. GlobalGPT hace que esa distinción sea práctica: puedes empezar con Eleven Music para una pista, cambiar a Qwen Audio para la narración o utilizar Seed Audio para una escena compuesta sin tener que mantener una plataforma independiente para cada flujo de trabajo de audio.
Dado que GlobalGPT es un espacio de trabajo multimodelo y no una herramienta dedicada exclusivamente al audio, el trabajo no tiene por qué limitarse a un archivo de audio. Puedes utilizar otros modelos de IA de la plataforma para redactar o pulir un guion, investigar un tema, crear imágenes de apoyo y desarrollar material de vídeo en torno al audio finalizado.
El 10 de agosto de 2026, el Página de precios de GlobalGPT Mostraba equivalentes mensuales de $5,8 para BASIC, $10,8 para PRO y $25,0 para UNLIMITED, con las opciones «Selección anual» y «Facturación anual» activadas. Estas son las cifras de facturación anual de la página; el acceso a los modelos varía según el plan.

¿Qué modelo deberías elegir?
Matriz de resultados de la primera salida con seis tareas
| Flujo de trabajo | Modelos probados | Resultado | Razón observada | Tipo de prueba | Limitación |
|---|---|---|---|---|---|
| A1 · Música | Eleven contra Seed | Once preferidos | Una progresión más natural y una instrumentación más armoniosa | Preferencias de los oyentes en una prueba a ciegas | Una primera salida cada uno |
| A2 · Música | Eleven contra Seed | Se prefiere la semilla | Una introducción más clara y una mayor riqueza en las capas | Preferencias de los oyentes en una prueba a ciegas | Seed ha devuelto 27,704 s |
| B1 · Expresión oral | Qwen contra Seed | Se prefiere Qwen | Un estilo narrativo más natural en los documentales | Preferencias de los oyentes en una prueba a ciegas | Texto no revisado palabra por palabra |
| B2 · Expresión oral | Qwen contra Seed | Se prefiere Qwen | Un susurro más intenso y una mayor sensación de narración | Preferencias de los oyentes en una prueba a ciegas | Texto no revisado palabra por palabra |
| C1 · Canción vocal | Solo once | Cumplido parcialmente | La voz sonaba poco natural, con un ruido similar al de una interferencia eléctrica. | Revisión semántica por parte de los usuarios | Observación específica de la muestra |
| C3 · Paisaje sonoro | Solo semillas | Cumplido parcialmente | El sonido de la frenada y la parada del tren sonaba artificial | Revisión semántica por parte de los usuarios | Anuncio no transcrito |
Ninguna ronda se convierte en una puntuación global ni en un ganador absoluto.
- Elige Eleven Music v2 cuando el trabajo se centra fundamentalmente en la música: piezas instrumentales estructuradas, canciones o edición musical a nivel de sección.
- Elige Qwen Audio 3.0 TTS Flash cuando se trata de narración o de expresión oral controlada.
- Elige Seed Audio 1.0 cuando el resultado debe comportarse como una escena completa que combine ambiente, efectos y diálogo.
Estas recomendaciones resumen la adecuación al flujo de trabajo, además de seis valoraciones basadas en los primeros resultados. No designan a un único ganador absoluto.
Limitaciones de esta comparación
- Una primera salida válida por modelo y tarea; sin repeticiones por estabilidad.
- Los documentos B1 y B2 no se transcribieron ni se revisaron palabra por palabra.
- Las valoraciones auditivas son subjetivas y dependen de la muestra concreta.
- Una ruta «Anywhere» no constituye la totalidad del producto de origen.
- Ninguna clasificación independiente imparcial recoge estas tres rutas concretas bajo un mismo método.
- El formato de archivo, la frecuencia de muestreo, los canales, el tamaño del archivo y el volumen de reproducción no se tuvieron en cuenta a la hora de evaluar la calidad.
Preguntas frecuentes
01¿Son Eleven Music v2, Qwen Audio 3.0 y Seed Audio 1.0 modelos del mismo tipo?
N.º 11: Music v2 es un flujo de trabajo dedicado a la música; Qwen Audio 3.0 TTS Flash es la solución de síntesis de voz analizada aquí, y Seed Audio 1.0 está pensado para la generación de audio de escenas completas. Por lo tanto, esta comparación ofrece recomendaciones en función de cada tarea, en lugar de imponer una clasificación universal.
02¿Qué modelo está diseñado para la generación de música mediante IA?
Eleven Music v2 es, sin duda, la mejor opción especializada en música de esta comparativa. Su documentación oficial describe el control sobre el género, el estilo, la estructura, la salida vocal o instrumental, los distintos idiomas y la edición tanto a nivel de sección como de la canción completa.
03¿Qué recorrido probado se adapta mejor a la narración y al discurso expresivo?
Qwen Audio 3.0 TTS Flash, identificado aquí mediante la ruta exacta de Anywhere «qwen-audio-3.0-tts-flash», fue el que mejor se adaptó a las pruebas de narración y de expresión oral. El oyente prefirió su primera salida tanto en B1 como en B2, pero no se evaluaron la estabilidad ni la precisión exacta en las palabras.
04¿Qué modelo es capaz de crear un paisaje sonoro completo con voz y efectos?
Seed Audio 1.0 es la solución que mejor se adapta al flujo de trabajo para la composición de un paisaje sonoro. Su posicionamiento oficial abarca la voz, los efectos de sonido, el ambiente y la orquestación unificada, mientras que la prueba C3 combinó un anuncio de la estación, el movimiento del tren, un timbre y el ambiente costero en una única salida.
05¿Puedo utilizarlos los tres a través de GlobalGPT?
Sí. Puedes probar Eleven Music para música, Seed Audio 1.0 para escenas de audio completas y Qwen Audio 3.0 para voz en el espacio de trabajo de audio de GlobalGPT. GlobalGPT también integra flujos de trabajo de redacción, investigación, imágenes y vídeo en la misma plataforma multimodelo. La disponibilidad de los modelos varía según el plan.
06¿Esta comparación permite determinar un ganador absoluto?
No. Los modelos se adaptan a flujos de trabajo distintos, y los resultados prácticos incluyen un primer resultado válido por modelo y tarea, sin repeticiones para comprobar la estabilidad. La conclusión útil es condicional: «Eleven» para música específica, «Qwen TTS Flash» para voz y «Seed» para escenas de audio completas.
Prueba tu propio flujo de trabajo de audio
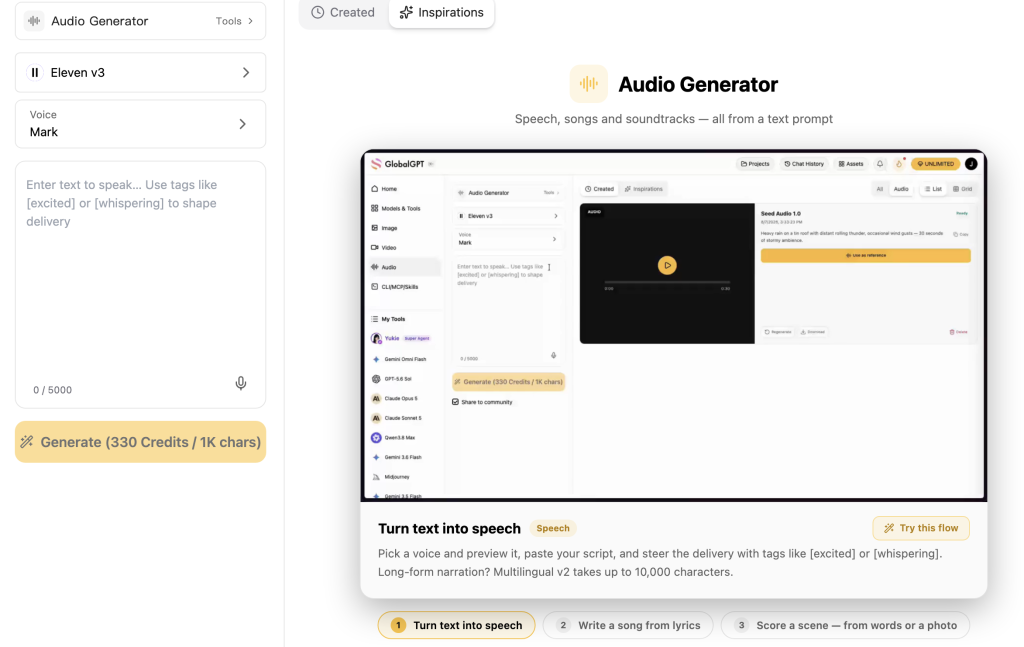
Trae tu propio resumen musical, guion narrativo o propuesta de paisaje sonoro al Generador de audio GlobalGPT y compara el resultado con el trabajo que realmente tienes que terminar. Presta atención a la estructura musical, la interpretación vocal, la coherencia de la escena y el cumplimiento de las indicaciones, en lugar de elegir un modelo solo por su nombre.
Una vez que la dirección de audio funcione, puedes continuar el proyecto con los demás modelos de IA de GlobalGPT para el desarrollo del guion, la investigación, las imágenes de apoyo y los conceptos de vídeo. De este modo, la prueba se convierte en un flujo de trabajo de contenido práctico, en lugar de una demostración de audio aislada; repite los resultados solo cuando necesites pruebas de estabilidad.