
Claude Sonnet 5.5 es un modelo robusto para el trabajo diario: lo suficientemente potente como para resolver un error complicado o trabajar con un documento denso, y con un precio por token inferior al de Opus 5.5. Su atractivo resulta especialmente evidente cuando se puede definir cómo es una buena respuesta. En el caso de estrategias abiertas o de un problema desconocido con muchos factores variables, Opus sigue mereciendo un lugar en tu flujo de trabajo.
En nuestras pruebas con GlobalGPT, Sonnet 5.5 redactó correos electrónicos para clientes, corrigió una función de asignación de fondos que superó 43 comprobaciones y concilió correctamente un conjunto de registros de facturas de 13 078 palabras. El correo electrónico también introdujo una pequeña suposición sobre el proceso que era necesario comprobar. La cuestión más interesante es cuándo su velocidad y su precio se traducen en una jornada laboral más productiva, y cuándo el razonamiento adicional empieza a costar más de lo que ahorra.
Puede utilizar Claude Sonnet 5,5 sobre GlobalGPT junto con otros modelos líderes para la redacción, la programación, la investigación, las imágenes y el vídeo. Una suscripción multimodelo te ofrece una forma asequible de llevar un proyecto desde el primer borrador hasta los resultados finales sin tener que gestionar una suscripción independiente para cada paso.
Claude Sonnet 5.5: el veredicto rápido
Un valor por defecto práctico para un trabajo claramente definido
Empieza con Sonnet para un resumen, un error, un documento o una primera implementación. Proporciónale el material de partida, las restricciones y los criterios de aceptación. Pasa a Opus cuando lo más difícil sea decidir cuál es realmente el problema.
Lo que nos ha impresionado: formato controlado, código robusto y conciliación correcta de los documentos.
Qué ver: En un texto bien redactado pueden colarse pequeñas suposiciones; el razonamiento supone un coste adicional; un contexto extenso no garantiza que se recuerde.
Se trata de una reseña de un modelo recién lanzado, no de un estudio de producción que se haya prolongado durante meses. Combinamos las especificaciones de Anthropic, las evaluaciones publicadas y tres tareas prácticas realizadas el 1 de octubre de 2026. La tarea de redacción se repitió dos veces; las tareas de código y de documentos se realizaron una vez cada una. Los resultados que se muestran a continuación tienen en cuenta ese reducido tamaño de la muestra.
¿Qué novedades presenta la versión 5.5 de Claude Sonnet?
Anthropic lanzó Sonnet 5.5 el 28 de septiembre de 2026 como complemento más rápido y económico de Opus 5.5. Sus puntos fuertes declarados son el trabajo cotidiano bien definido, la corrección de errores y la elaboración de documentos, diapositivas y hojas de cálculo pulidos. Ese posicionamiento es importante: no se necesita el modelo más caro para cada edición, respuesta de asistencia técnica o tarea de implementación.
¿Qué novedades presenta la versión 5.5 de Claude Sonnet?
| Característica | Sonnet 5.5 | Qué significa esto en la práctica |
|---|---|---|
| Entrada y salida | Texto e imágenes dentro; texto fuera | Pide un gráfico o una captura de pantalla y, a continuación, convierte la respuesta en un borrador o un plan. |
| Ventana de contexto de la API | 1 millón de tokens | Hay espacio para una gran cantidad de material de referencia; organízalo y etiquétalo con cuidado. |
| Potencia máxima de salida de la API estándar | 128K fichas | Se trata de un límite de extensión, no de una longitud recomendada para todas las respuestas. |
| Razonamiento | Pensamiento adaptativo | El esfuerzo puede influir tanto en el tiempo de finalización como en el uso total de tokens. |
| Límite de conocimientos | Junio de 2026 | Utiliza fuentes actuales o herramientas de búsqueda para verificar los datos. |
Estos límites de contexto y salida describen la API Claude. La cantidad que puedes subir o recibir en una aplicación concreta también depende de la interfaz de dicho producto. Del mismo modo, un modelo que interpreta una imagen no es un generador de imágenes. Sonnet puede analizar críticamente un elemento visual o redactar un guion creativo; un modelo de imagen o vídeo es el que crea el contenido multimedia final.
La mejora más útil es la combinación de una ejecución más eficaz de las tareas y una iteración más rápida. Puedes pedir un primer borrador, revisar las partes que no están bien y solicitar una revisión específica. Una buena indicación le marca el objetivo: “Mantén todas las cifras sin cambios, acorta esto a 200 palabras y enumera todo lo que el texto original no aclare”.”
Precios de Claude Sonnet 5.5: tarifas por token y coste real
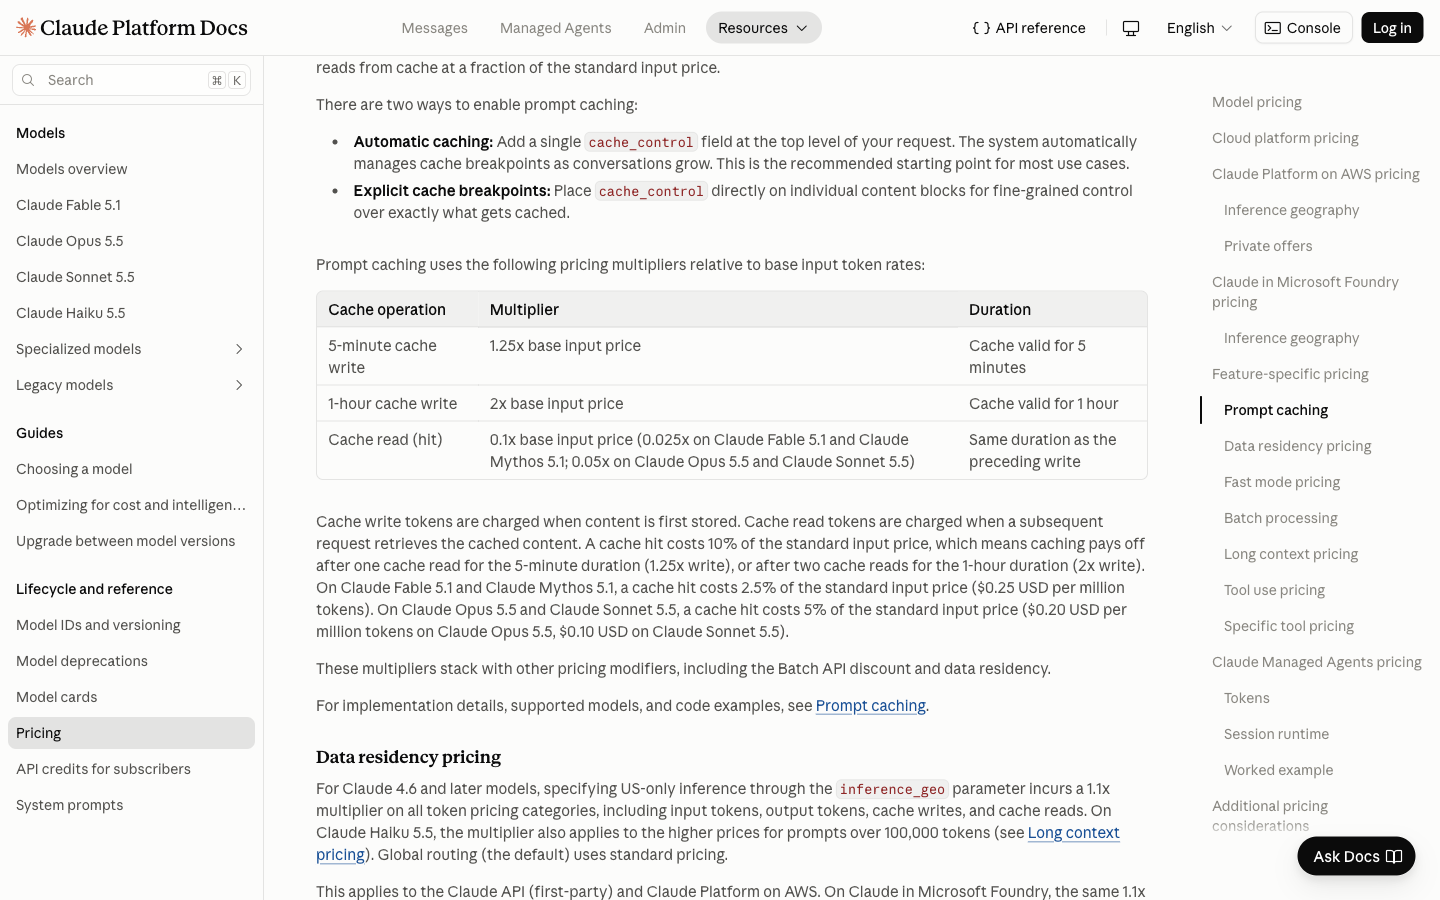
Costes de Sonnet 5.5 $2 por cada millón de tokens de entrada y $10 por cada millón de tokens de salida a las tarifas estándar de la API de Anthropic. Son los mismos precios unitarios que los de Sonnet 5. En comparación con las tarifas de entrada $4 y de salida $20 de Opus 5.5, Sonnet cuesta la mitad por token de entrada o de salida, pero una tarea completada puede consumir un número diferente de tokens.
Precios de Claude Sonnet 5.5: tarifas por token y coste real
| Categoría de facturación de la API | Precio por millón de tokens |
|---|---|
| Entrada sin almacenar en caché | $2.00 |
| Salida, incluidos los tokens de pensamiento facturados | $10.00 |
| Lectura/actualización de la caché | $0.10 |
| Escritura en caché, 5 minutos | $2.50 |
| Escritura en caché, 1 hora | $4.00 |
Para una solicitud sin caché, multiplica los tokens de entrada por $2 por millón y los tokens de salida por $10 por millón. Una entrada de 10 000 tokens con 2 000 tokens de salida cuesta $0,04. Una entrada de 100.000 tokens con 10.000 tokens de salida cuesta $0,30. Se trata de ejemplos prácticos de la API, no de una factura GlobalGPT; las herramientas, las operaciones de caché, los niveles de servicio y otros factores que modifican el precio pueden alterar el total.
Cuánto puede costar una solicitud
Costes orientativos estándar de la API por solicitud. Solo entradas y salidas no almacenadas en caché.
Fórmula: (tokens de entrada × $2 + tokens de salida × $10) ÷ 1 000 000. El «pensamiento facturado» se contabiliza como salida. Se trata de ejemplos, no de precios de suscripción ni de facturas calculadas.
La afirmación de Anthropic de que “se ahorran hasta 30% por tarea” se debe a que se realiza parte del trabajo con menos tokens. No se trata de una rebaja de precio de 30%. En el otro extremo, Evaluación del lanzamiento de «Artificial Analysis» Se midió un valor aproximado de $7,60 por tarea del Índice de Inteligencia con el máximo esfuerzo, lo que supone unos 50% por encima de Sonnet 5 en esa prueba. Esas exigentes tareas de referencia no son mensajes de chat corrientes, pero demuestran por qué llevar el razonamiento al máximo puede anular una ventaja aparente.
La facturación por API, las suscripciones Claude y GlobalGPT son opciones diferentes
Los planes para particulares de Claude se basan en un modelo de suscripción: el plan gratuito es $0; el Pro es $20 al mes o $200 con facturación anual; y el Max empieza en $100 al mes, antes de impuestos. El uso de la aplicación tiene límites según el plan. Anthropic también incluye $100 o $200 en créditos de API mensuales para los niveles Max correspondientes; los planes Free y Pro no incluyen créditos de API mensuales. Compara por separado el acceso a la aplicación y las asignaciones de API a la hora de elegir un plan. Una plataforma multimodelo es ideal para quienes trabajan habitualmente con diferentes familias de modelos y tipos de medios.
Si tu jornada incluye redactar una página de lanzamiento, revisar código y crear elementos visuales para campañas, GlobalGPT reúne todas esas herramientas. Su valor radica en la amplitud del flujo de trabajo que ofrece una sola suscripción, en lugar de tener que pagar por varios productos independientes solo para completar un proyecto. Elige el plan que mejor se adapte al trabajo que realmente realizas.
Resultados de las pruebas de rendimiento: se acercan a los de Opus en algunas tareas, pero no en todas
Los resultados del lanzamiento muestran un avance sustancial con respecto a Sonnet 5. También ponen de manifiesto por qué una única puntuación destacada no basta para decidir qué modelo elegir. Sonnet 5.5 lidera la comparación de Terminal-Bench publicada, mientras que Opus 5.5 sigue a la cabeza en FrontierCode y CursorBench. Las puntuaciones casi iguales en tareas de conocimiento son prometedoras, pero no hacen que los modelos sean intercambiables.
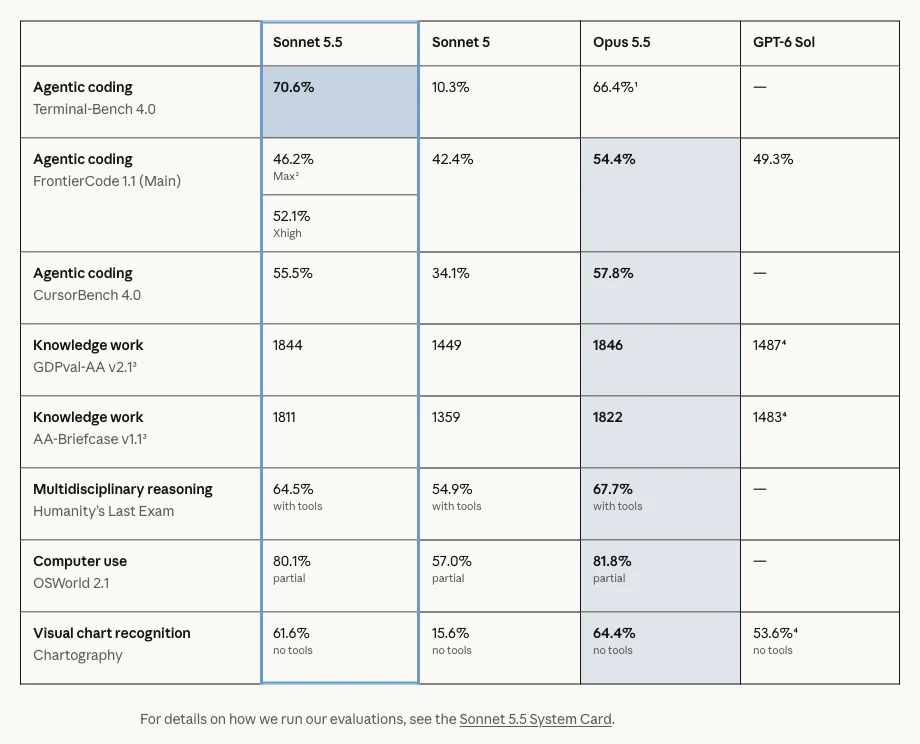
Resultados de las pruebas de rendimiento: se acercan a los de Opus en algunas tareas, pero no en todas
| Evaluación en la tabla de lanzamiento de Anthropic | Sonnet 5.5 | Soneto 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66,41 TP40T (Xhigh) | - |
| FrontierCode 1.1 Principal | 52,11 TP40T (Xhigh); 46,21 TP40T (máx.) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA v2.1 | 1844 Elo | 1449 Elo | 1846 Elo | 1487 |
| AA-Maletín v1.1 | 1811 Elo | 1359 Elo | 1822 Elo | 1483 |
| El último examen de la humanidad | 64,51 TP40T con herramientas | 54,91 TP40T con herramientas | 67,71 TP40T con herramientas | - |
| OSWorld 2.1 | 80.1% parcial | 57.0% parcial | 81,81 TP40T parcial | - |
| Cartografía | 61,61 TP40T sin herramientas | 15,61 TP40T sin herramientas | 64,41 TP40T sin herramientas | 53,61 TP40T sin herramientas |
Estos son resultados de pruebas comparativas publicados, independientes de nuestras pruebas GlobalGPT. Las evaluaciones utilizan entornos y configuraciones de esfuerzo diferentes; las puntuaciones Elo no corresponden a un porcentaje de precisión. Los valores «GPT-6 Sol» aparecen en la tabla comparativa publicada de Anthropic, y un guion significa que la página no facilitó ningún valor para esa evaluación. Anthropic también señala que las ejecuciones de lanzamiento de GDPval-AA y AA-Briefcase utilizaron una implementación previa al lanzamiento que presentaba un error en la salida estructurada, el cual se corrigió posteriormente. Considera la tabla como una representación de dichas evaluaciones, no como una garantía respecto a tu carga de trabajo.
El resultado de FrontierCode resulta especialmente útil: Sonnet obtuvo mejores resultados en Xhigh que en Max. Anthropic atribuye el descenso en Max a revisiones adicionales, tiempos de espera y cambios fuera del alcance solicitado. Reflexionar más puede suponer más trabajo sin que ello se traduzca en una respuesta mejor. Empieza con una tarea clara y aumenta el esfuerzo cuando tengas una razón concreta para hacerlo.
Los resultados independientes aportan contexto. Artificial Analysis registró una puntuación del Índice de Inteligencia de 56 en su configuración máxima/predeterminada, junto con un uso inusualmente elevado de tokens de salida. A Evaluación del proceso de revisión de CodeRabbit Se detectaron 6 de los 13 casos de señales difíciles detectados por Sonnet 5.5, frente a los 4 de 13 detectados por Sonnet 5, con un tiempo de ejecución medio inferior. Se trata de un estudio de un proveedor de pequeña envergadura, que no demuestra que todas las revisiones de código vayan a mejorar, pero es un ejemplo útil de cómo evaluar una tarea completa en lugar de limitarse a una simple puntuación.
¿A qué velocidad va el Claude Sonnet 5.5?
Según los informes, Anthropic genera resultados más de un 30% más rápido que Sonnet 5. La generación de resultados es solo una parte del tiempo de espera para obtener una respuesta: el procesamiento de la entrada, el razonamiento, el tiempo de red y la carga del servicio también influyen. Un modelo puede escribir rápidamente una vez que se pone en marcha y, aun así, seguir trabajando durante un tiempo antes de que llegue la respuesta final.
Nuestras tres repeticiones de la misma solicitud de correo electrónico al cliente se completaron en 11,60; 12,16 y 11,78 segundos, con una mediana de 11,78 segundos. La tarea de código tardó 19,08 segundos y la de documento, 16,42 segundos. Cronometramos la respuesta completa, incluyendo la sobrecarga del servicio y de la red. No medimos la latencia del primer token ni realizamos una prueba de control Sonnet 5, por lo que estos tiempos no demuestran una mejora de 30%.
Para el uso diario, esto hace que merezca la pena probar este modelo en tareas que se revisan en ciclos cortos. Pide primero el resultado final, limita el alcance y evita solicitar una explicación extensa cuando lo único que necesitas es una función corregida o una respuesta breve. Cuando se muestren los controles de esfuerzo, evalúa los ajustes más ligeros antes de optar por «Máximo» por defecto.
Rendimiento en condiciones reales: tres pruebas GlobalGPT
Utilizamos tareas prácticas con respuestas que podíamos comprobar. Todas las solicitudes utilizaron Claude Sonnet 5.5 con el mismo límite máximo de salida de 6.000 tokens y sin herramientas externas. Dejamos los controles de muestreo y razonamiento en los valores predeterminados del servicio. Conservamos la primera salida completada de cada tarea; las dos ejecuciones de escritura adicionales constituyen una comprobación de coherencia independiente. Las cinco llamadas se completaron sin necesidad de reintentos.
Redacción: respuesta a un cliente en la que se controlan los compromisos adquiridos
Las instrucciones pedían un correo electrónico de entre 90 y 120 palabras dirigido a Maya sobre el retraso en la entrega de una lámpara azul, con exactamente tres puntos clave, una fecha límite de envío fijada para el 4 de octubre y la opción de responder “reembolso” para obtener un reembolso completo a través del mismo método de pago utilizado originalmente. Se prohibía expresamente inventar un motivo, garantizar la entrega, ofrecer descuentos o prometer un reembolso inmediato.
La primera respuesta tenía 110 palabras con exactamente tres viñetas, y mantenía intactos el plazo de envío y las condiciones de reembolso. No inventaba una fecha de entrega, una causa de retraso ni ninguna ventaja adicional. Sin embargo, añadió “no es necesario que responda” para los clientes que mantuvieran el pedido, un detalle del proceso que no figuraba en el briefing. Eso la convierte en un borrador útil, pero no en una respuesta perfecta según el estricto requisito de ceñirse únicamente a los hechos.
Las respuestas repetidas tenían 101 y 97 palabras y también cumplían las normas de formato, pero ambas partían de la misma suposición de “no tomar medidas”. La tercera respuesta utilizaba, además, dos viñetas para describir, en esencia, la misma opción de «mantener el pedido y esperar». Antes de enviar una respuesta dirigida al cliente, confirma los detalles operativos y elimina las redundancias.
Prueba de escritura: formato correcto, se asume un único proceso
Primera respuesta: 110 palabras, 3 viñetas, 11,60 segundos. Las condiciones de envío y reembolso eran correctas. La instrucción de mantener el pedido sin responder no figuraba en el resumen y requiere confirmación. Repeticiones: 101 y 97 palabras; ambas repetían esa suposición.
Claude Sonnet 5,5 · GlobalGPT · 1 de octubre de 2026 · límite máximo de salida de 6.000 tokens · sin herramientas · muestreo y esfuerzo según los valores predeterminados del servicio. El tiempo se refiere a la respuesta completa, no al primer token.
Instrucciones de la tarea
Redacta un correo electrónico en inglés dirigido a Maya, del servicio de atención al cliente, sobre el pedido R-418, una lámpara azul cuyo envío se ha retrasado. El correo completo debe tener entre 90 y 120 palabras, ambas incluidas, y contener exactamente tres puntos. Incluye una disculpa, explica claramente el siguiente paso y utiliza únicamente estos datos: la lámpara se enviará antes del 4 de octubre; como alternativa, Maya puede responder “reembolso” para solicitar un reembolso completo a través del método de pago original. No prometas una fecha de entrega o de llegada, un reembolso inmediato, un descuento, una compensación ni ningún otro beneficio no previsto. No inventes un motivo para el retraso. La fecha límite se refiere al envío, no a la entrega. Incluye un saludo y una despedida. Devuelve únicamente el correo electrónico. Para esta tarea, una palabra es un token separado por espacios en blanco, excluyendo los marcadores de viñeta independientes.
Primera salida completa
Asunto: Información actualizada sobre tu pedido R-418

Hola, Maya:

Lamento que el envío de tu lámpara azul, pedido R-418, se haya retrasado. Sé que esto es frustrante y te pido disculpas por las molestias.

Esta es la situación actual y lo que puedes hacer a continuación:

- Tu lámpara se enviará antes del 4 de octubre.
- Si deseas mantener tu pedido, no es necesario que respondas.
- Si prefieres no esperar, responde "reembolso" a este correo electrónico y te tramitaremos un reembolso completo a través de tu método de pago original.

Gracias por tu paciencia y comprensión. Responde si tienes alguna pregunta sobre tu pedido.

Un saludo cordial,
Equipo de Atención al Cliente
Escritura: repetición 2 · salida completa
Querida Maya:

Lamento que el envío de tu pedido R-418, la lámpara azul, se haya retrasado. Entiendo que esto resulte frustrante y te pido disculpas por las molestias.

Esto es lo que va a pasar a continuación:

- Tu lámpara azul se enviará antes del 4 de octubre.
- Si prefieres esperar, no tienes que hacer nada.
- Si prefieres no esperar, responde "reembolso" a este correo electrónico para solicitar un reembolso completo a través de tu método de pago original.

Ten en cuenta que el 4 de octubre es nuestra fecha límite de envío, no la fecha de entrega.

Gracias por tu paciencia y comprensión.

Atentamente,
El equipo de Atención al Cliente
Escritura repetida 3 · salida completa
Asunto: Información actualizada sobre tu pedido R-418

Hola, Maya:

Lamento que el envío de tu lámpara azul, pedido R-418, se haya retrasado. Te pido disculpas por las molestias y te agradezco tu paciencia.

Estas son tus opciones:

- Esperar a que se envíe: tu lámpara se enviará antes del 4 de octubre.
- Solicitar un reembolso: responde con la palabra "reembolso" y te tramitaremos un reembolso completo a través de tu método de pago original.
- Mantener el pedido: si no te importa esperar, no es necesario que hagas nada más.

Ten en cuenta que el 4 de octubre es nuestra fecha límite de envío, no la fecha de entrega.

Un saludo,
Equipo de Atención al Cliente
Tu lámpara se enviará antes del 4 de octubre. … Si prefieres no esperar, responde “reembolso” a este correo electrónico y te tramitaremos un reembolso íntegro a través de tu método de pago original.
Fragmento de la primera prueba de expresión escrita GlobalGPT; se ha omitido una viñeta intermedia.
Este es un modelo útil para la comunicación con los clientes y la redacción comercial: proporciona los datos contrastados, define el tono y especifica qué promesas no deben aparecer. De este modo, Sonnet puede ayudarte con la redacción sin que tengas que pedirle que elabore tu política.
Programación: corrige la lógica de redondeo y, a continuación, comprueba los totales
Nuestra función de Python, que presentaba un error, dividía el dinero utilizando números de coma flotante y redondeaba cada parte de forma independiente. Esto puede generar o hacer perder céntimos. Le pedimos a Sonnet que la sustituyera por un método de asignación basado en el «resto mayor» con Decimal, que mantuviera el total, que desempatara según el índice original y que rechazara las entradas no válidas.
La primera función devuelta pasó 43 de 43 comprobaciones, que abarcaba cantidades nulas, pesos fraccionarios, empates determinísticos, entradas con formato incorrecto, valores elevados y límites de precisión. Analizaba cadenas decimales, las convertía en cantidades enteras exactas y asignaba los céntimos restantes siguiendo un orden estable. El resultado útil no fue solo un código que parecía plausible: las participaciones realmente cuadraban.
Esto respalda el uso de Sonnet para una implementación específica con criterios de aceptación explícitos. Se trataba de una prueba funcional independiente, no de una reparación autónoma del repositorio ni de una auditoría de seguridad. Para el código de producción, añade tus propias pruebas de integración y revisa el manejo de errores en la aplicación en la que se integra.
Prueba de programación: 43 comprobaciones superadas
Primera respuesta: 19,08 segundos. Ha superado las 43 comprobaciones relativas a la asignación correcta, los enlaces estables, la validación de entradas y la precisión. Se ha evaluado como una función independiente, no como una reparación autónoma del repositorio.
Claude Sonnet 5,5 · GlobalGPT · 1 de octubre de 2026 · límite máximo de salida de 6.000 tokens · sin herramientas · muestreo y esfuerzo según los valores predeterminados del servicio. El tiempo se refiere a la respuesta completa, no al primer token.
Instrucciones de la tarea
Sustituye la función de Python defectuosa que aparece a continuación por una implementación correcta de `allocate_cents(total: str, weights: list[str]) -> list[int]`. Devuelve únicamente código fuente de Python ejecutable, sin bloques de Markdown ni explicaciones.

Requisitos:
1. total es una cantidad finita y no negativa en dólares estadounidenses (USD) expresada como cadena, con cero, uno o dos dígitos decimales, como "0", "12,3" o "12,34". Se requieren dígitos decimales ASCII con un único punto decimal opcional. Rechaza los signos, la notación exponencial, los espacios en blanco, NaN/Infinito, una cadena vacía, un punto decimal al final, un punto decimal al principio y más de dos dígitos decimales, incluido "1.000". Se permiten los ceros iniciales. Rechaza las entradas que no sean cadenas con un ValueError.
2. weights es una lista no vacía de cadenas. Cada cadena utiliza dígitos decimales ASCII, opcionalmente con un punto decimal y uno o más dígitos a continuación. Se exigen valores finitos no negativos con al menos un peso estrictamente positivo. Rechaza las cadenas no válidas, los signos, la notación exponencial, los espacios en blanco, las entradas que no sean cadenas o una entrada de pesos que no sea una lista con un ValueError. Se permiten los ceros iniciales.
3. Utiliza Decimal para analizar y conservar con exactitud los importes decimales proporcionados. Convierte los dólares en céntimos enteros. Asigna los céntimos enteros en proporción a los pesos, utilizando el método del resto mayor: toma el valor entero de cada cuota exacta y, a continuación, asigna los céntimos restantes a los restos fraccionarios más grandes. Desempata según el índice original más bajo. La lista devuelta debe conservar el orden de entrada y sumar exactamente el total de céntimos.
4. No se debe perder precisión de forma silenciosa en el caso de valores válidos largos o pesos muy desiguales. No se deben modificar los pesos. Importa únicamente de «decimal» o «math» si es necesario. No se permiten operaciones con archivos, red, entorno, procesos ni de entrada/salida.

Implementación errónea:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
Primera salida completa
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
    if not isinstance(s, str) or not s:
        return False
        parts = s.split(".")
        if len(parts) > 2:
            return False
 if not parts[0] or not all(c in DIGITS for c in parts[0]):
 return False
 if len(parts) == 2:
 frac = parts[1]
 if not frac or not all(c in DIGITS for c in frac):
                return False
 if max_frac is not None and len(frac) > max_frac:
 return False
 return True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # devuelve (mantisa entera, exponente) donde value = mantisa * 10**exponente
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("total no válido")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("pesos no válidos")
    for w in pesos:
 if not valid(w, None):
 raise ValueError("peso no válido")

 mant, exp = to_scaled(total)
    if exp >= -2:
 céntimos = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # inalcanzable para entradas validadas

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    si W <= 0:
        raise ValueError("al menos un peso debe ser positivo")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
Documentos: encontrar los registros correctos tras las correcciones y los duplicados
La tercera tarea consistía en un paquete de facturas sintético de 13 078 palabras: 120 registros básicos, ocho correcciones y cuatro copias de archivo. Sonnet tenía que seleccionar únicamente las facturas de Atlas aprobadas con fecha de septiembre de 2026, utilizar la versión más reciente de cada registro y devolver un JSON estricto con el total y tres comprobaciones de seguimiento pertinentes.
Seleccionó todos 16 números de factura correctos, devolvió el valor exacto $15,305.66 en su totalidad, y respetó la estructura JSON. Las comprobaciones posteriores abarcaron la conciliación contable, los documentos justificativos de las correcciones y los controles de duplicados o de fechas límite. No contabilizó una copia antigua del archivo como una nueva factura.
Este es el tipo de detalle que importa en el trabajo con documentos: la corrección más reciente debe prevalecer, incluso cuando una copia anterior aparezca más adelante en el paquete. El resultado es prometedor para la extracción de documentos delimitados. No obstante, sigue siendo un ejercicio sintético, mucho más reducido que la ventana de contexto de un millón de tokens anunciada; los trabajos financieros importantes requieren un cálculo independiente.
Prueba de documento: 16 registros, total exacto
Primera respuesta: 16,42 segundos. Los 16 números de factura y el total de $15.305,66 coincidían con la referencia independiente; el formato JSON estricto y las tres comprobaciones posteriores también eran correctos.
Claude Sonnet 5,5 · GlobalGPT · 1 de octubre de 2026 · límite máximo de salida de 6.000 tokens · sin herramientas · muestreo y esfuerzo según los valores predeterminados del servicio. El tiempo se refiere a la respuesta completa, no al primer token.
El paquete sintético facilitado contenía 120 registros básicos, ocho correcciones y cuatro copias de archivo (13 078 palabras). Los campos eran: ID, versión, proyecto, fecha, estado, importe y notas descriptivas. Las instrucciones que figuran a continuación son completas; el extenso paquete original se resume aquí.
Instrucciones de la tarea
Revisa los registros sintéticos de facturas de proyectos que se muestran a continuación. Para cada ID, utiliza únicamente la versión más reciente; los registros duplicados idénticos no generan facturas adicionales. La versión más reciente puede aparecer antes que una copia de archivo anterior. Selecciona únicamente los registros cuyo proyecto final sea "Atlas", cuyo estado final sea "aprobado" y cuya fecha final sea en septiembre de 2026. Los importes están expresados en USD. Devuelve un JSON estricto con exactamente estas claves: "ids" (ID seleccionados únicos ordenados de forma ascendente), «total_usd» (una cadena con exactamente dos decimales) y «action_items» (exactamente tres cadenas concisas que indiquen comprobaciones contables lógicas a realizar a continuación). No añadas bloques de Markdown ni texto explicativo. Ignora las notas descriptivas a la hora de filtrar; todos los campos contables están estructurados. No cuentes los registros de otros meses, los borradores, los registros de Orion, las versiones antiguas ni las copias repetidas.
Primera salida completa
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056","INV-062","INV-068","INV-074","INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15 305,66","action_items":["Conciliar las 16 facturas seleccionadas y el total de 15 305,66 USD con el libro mayor de Atlas y el sublibro de cuentas por pagar de septiembre de 2026.","Revisar los registros modificados por correcciones (INV-003, INV-008, INV-020, INV-050, además de los excluidos INV-002, INV-014 e INV-026) para comprobar que existan pruebas de aprobación y documentos justificativos.","Confirme que las copias de archivo duplicadas no se han contabilizado como facturas independientes y compruebe si existen problemas de devengo o de corte en las facturas corregidas con fecha cercana al final del mes."]}Sonnet 5.5 frente a Opus 5.5: ¿cuál deberías usar?
Elige en función del tipo de trabajo. Sonnet es una buena primera opción cuando las instrucciones y el objetivo final están claros. Opus es el punto de partida más adecuado cuando la tarea requiere un juicio constante, detectar supuestos que se han pasado por alto o coordinar una larga cadena de decisiones. Lee nuestro Reseña del Claude Opus 5.5 para ver ese modelo más de cerca.
Sonnet 5.5 frente a Opus 5.5: ¿cuál deberías usar?
| Tu tarea | Punto de partida recomendado | Por qué |
|---|---|---|
| Reescribir un resumen, redactar un borrador del texto para el cliente, extraer registros | Sonnet 5.5 | Unas restricciones claras facilitan la verificación de la calidad. |
| Corregir un error localizado o implementar una función determinada | Sonnet 5.5 | Excelente ejecución de tareas con una tasa de tokens de entrada/salida más baja. |
| Decidir la arquitectura con unos requisitos incompletos | Opus 5.5 | Lo difícil es mantener el criterio, no solo la puesta en práctica. |
| Finaliza una campaña con texto, imágenes y vídeo | Flujo de trabajo multimodelo GlobalGPT | Utiliza Sonnet para los modelos breves y especializados de los activos. |
Un procedimiento útil consiste en pedir a un modelo de razonamiento más potente que analice un plan complejo y, a continuación, proporcionar a Sonnet las especificaciones acordadas y las comprobaciones concretas. La elección del modelo puede variar entre una fase y otra. No es necesario convertir cada pequeña revisión en tu tarea de razonamiento más costosa.
Pon el Sonnet 5.5 a trabajar en el GlobalGPT
GlobalGPT permite utilizar el modelo como parte de un entorno de trabajo más amplio. Abre Claude Sonnet 5.5 para la fase de redacción o análisis y, a continuación, pasa a otro modelo cuando el proyecto requiera un enfoque diferente. Puedes desarrollar un briefing de campaña, perfeccionar el texto, crear elementos visuales y producir vídeos sin tener que reconfigurar el flujo de trabajo en varias suscripciones.
Para obtener un mejor resultado inicial, envía junto con el material original un breve conjunto de reglas de aceptación. En el caso de los textos, especifica el público destinatario, la extensión, el tono y los datos que deben mantenerse sin cambios. En el caso del código, proporciona el ejemplo en el que se produce el error y el comportamiento esperado. En el caso de los documentos, identifica las secciones originales e indica cómo gestionar las versiones contradictorias. Estos ideas para escribir, investigar y programar te ofrecen puntos de partida reutilizables.
Los desarrolladores también pueden integrar su flujo de trabajo de terminal a través de GlobalGPT CLI con código Claude. Utiliza la página web del proyecto general y la CLI cuando resulte adecuado para el proceso de desarrollo. El valor reside en un conjunto de herramientas interconectadas, en el que la elección del modelo viene determinada por la siguiente tarea.
Limitaciones y detalles sobre las actualizaciones que conviene conocer
El gran esfuerzo es una elección, no una garantía de calidad. Sonnet puede centrarse excesivamente en un problema concreto o ir más allá de los cambios solicitados. Pídele que mantenga el alcance, realice las comprobaciones pertinentes y se detenga cuando se cumplan los criterios de aceptación. Si el producto dispone de controles de esfuerzo, compara la calidad y el coste de las tareas completadas antes de aumentarlos.
Los hechos actuales siguen necesitando fuentes actuales. La fecha límite de actualización de datos del modelo, junio de 2026, no implica que se disponga de información actualizada sobre todos los precios, políticas o lanzamientos. Facilita el documento actual o utiliza un flujo de trabajo con herramientas de búsqueda. En el caso de material confidencial, comprueba las condiciones de privacidad y retención del servicio y de la cuenta que utilices realmente; el nombre del modelo no determina esos ajustes.
Las migraciones de API requieren algo más que un simple cambio de nombre del modelo. Sonnet 5.5 modifica algunos patrones de solicitud antiguos. La API directa Claude rechaza los ajustes de temperatura, top_p y top_k que no sean los predeterminados, por lo que puede ser necesario actualizar las configuraciones basadas en enfoques antiguos o en el uso forzado de herramientas. El razonamiento adaptativo es el valor predeterminado; el modo «between_tools», tal y como se documenta, elimina el razonamiento inicial en niveles de esfuerzo «Alto» o inferiores. La descripción general actual también indica que el uso forzado de herramientas devuelve un error, que las herramientas informáticas antiguas no se aceptan en la API Claude ni en Google Cloud, y que el texto entre llamadas a herramientas puede aparecer en bloques de razonamiento. Revisa el guía oficial de migración antes de trasladar una solicitud. Nuestra Guía de la API Claude aborda los conceptos generales de configuración y facturación.
Anthropic también aplica medidas de seguridad a las solicitudes relacionadas con la ciberseguridad y la biología que entrañan un mayor riesgo. El desarrollo habitual de software sigue formando parte del uso previsto del modelo. Si una tarea es legítima pero sensible, describe claramente su alcance y los permisos necesarios, en lugar de dar por sentado que cada denegación se debe a una limitación general de la programación.
Veredicto final: un buen modelo para incorporarlo a tu rutina diaria
Sonnet 5.5 se gana su lugar gracias a un trabajo práctico y verificable. Las razones más sólidas para utilizarlo son su capacidad para programar con ámbito y su útil gestión de documentos, a un precio por token de API inferior al de Opus. También resulta útil para la redacción, con una comprobación final de detalles plausibles que nunca figuraban en el briefing. Nuestro pequeño conjunto de pruebas respalda ese posicionamiento para el trabajo diario; no establece una ventaja universal en cuanto a velocidad, coste o razonamiento complejo.
Empieza con una tarea real cuyo resultado puedas evaluar. Deja claras las restricciones, comprueba los detalles importantes y pasa a otro modelo cuando el problema cambie. Prueba con Sonnet 5.5 en GlobalGPT para integrar la redacción, la programación, el análisis y el siguiente paso creativo en un único flujo de trabajo multimodelo.
Preguntas frecuentes
¿Qué es Claude Sonnet 5.5?
Claude Sonnet 5.5 es un modelo Anthropic lanzado el 28 de septiembre de 2026. Admite la introducción de texto e imágenes con salida de texto, y está diseñado para la programación rápida en el día a día, la redacción, el trabajo con documentos y los flujos de trabajo asistidos por herramientas.
¿Cuánto cuesta el modelo Claude Sonnet 5.5?
El precio estándar de la API de Anthropic es de $2 por cada millón de tokens de entrada y de $10 por cada millón de tokens de salida. Las lecturas de caché cuestan $0,10 por cada millón de tokens. Las suscripciones a aplicaciones de Claude y los planes de GlobalGPT son independientes de estas tarifas de API.
¿Es Claude Sonnet 5,5 más rápido que Sonnet 5?
El Anthropic genera resultados más de un 30% más rápido que el Sonnet 5. En nuestra prueba de escritura con el GlobalGPT, tres respuestas completas tardaron entre 11,60 y 12,16 segundos. No utilizamos el Sonnet 5 como control, por lo que nuestra prueba no mide la mejora de velocidad entre generaciones.
¿Es Sonnet 5.5 mejor que Opus 5.5?
Elige Sonnet 5.5 para tareas bien definidas y un precio por token de entrada/salida más bajo. Opus 5.5 es la mejor opción de partida para trabajos complejos y de alcance abierto que requieran un juicio sostenido. Sonnet encabeza algunas evaluaciones publicadas, pero no hay un ganador indiscutible.
¿El Claude Sonnet 5.5 puede gestionar documentos largos?
La API Claude especifica una ventana de contexto de un millón de tokens. En nuestra prueba con un documento sintético más breve, de 13.078 palabras, Sonnet seleccionó los 16 registros válidos y calculó el total correcto. Ese resultado no garantiza la precisión en toda la ventana de contexto anunciada.
¿Puedo utilizar el Claude Sonnet 5.5 en el GlobalGPT?
Sí. GlobalGPT ofrece Claude Sonnet 5.5 junto con otros modelos de IA, por lo que puedes redactar, programar, analizar documentos y continuar con el trabajo con imágenes o vídeos en una sola plataforma.
Fuentes y notas de las pruebas
Las especificaciones y los precios de lanzamiento se comprobaron el 13 de octubre de 2026; las pruebas prácticas que se describen a continuación se realizaron el 1 de octubre de 2026. Referencias principales: Anuncio del lanzamiento de Anthropic, Referencia del modelo Sonnet 5.5, Precios API, y Precios de suscripción Claude. La información independiente procede de Artificial Analysis y del estudio de CodeRabbit al que se hace referencia en el enlace anterior.
En las pruebas GlobalGPT se utilizó la primera respuesta completada en tres tareas, además de dos repeticiones de redacción. No se habilitó ninguna herramienta externa. Los tiempos abarcan las respuestas completas, incluyendo la sobrecarga de la red y del servicio; no se seleccionó ningún valor de esfuerzo de razonamiento. El paquete de facturación era sintético y no contenía datos de clientes. La ilustración del encabezado se generó para esta revisión; las demás imágenes son capturas de pantalla de los sitios web mencionados.









