
Respuesta rápida: GPT-6 Sol completó el resumen de cinco secciones sometido a prueba con un límite de salida de 2.400 tokens; Claude Opus 5.5 ofreció el diagnóstico más preciso en nuestra tarea de revisión de código breve. Ninguno de los dos resultados establece un ganador absoluto definitivo.
Esta comparación resulta útil más allá de una simple puntuación. Claude Opus 5.5 y GPT-6 Sol difieren en su forma de abordar la redacción, la síntesis de investigaciones, la revisión de código, las respuestas estructuradas, las vías de acceso y el flujo de trabajo diario. Los resultados de las tareas que se muestran a continuación ponen de manifiesto en qué aspectos son relevantes esas diferencias.
GlobalGPT Te ofrece ambos modelos en una única suscripción multimodelo asequible, junto con otros modelos y funciones de IA. Un único panel de control permite llevar un proyecto desde la investigación y la redacción hasta la programación, las imágenes y el vídeo, mientras que su interfaz de línea de comandos (CLI) conecta ese mismo contexto de trabajo con las herramientas de terminal y de producción.
Respuesta rápida
Elige GPT-6 Sol En primer lugar, en cuanto al flujo de trabajo de redacción con restricciones que se ha probado aquí: completó las cinco secciones sin superar el límite de salida compartido de 2.400 tokens. Elige Claude Opus 5,5 cuando el diagnóstico, el análisis explícito de riesgos y un JSON riguroso cobran mayor importancia. Utiliza ambos cuando el trabajo vaya cambiando a lo largo del día.
En qué destaca cada modelo
Claude Opus 5,5 Se adapta al trabajo metódico: revisar un cambio en el código, desentrañar un requisito confuso, identificar riesgos y mantener un contrato de resultados estricto. Anthropic lo enfoca en torno a la programación, el uso de ordenadores, el trabajo intelectual, la seguridad y una comunicación más natural en sesiones prolongadas. Consulta el Reseña del Claude Opus 5.5 para obtener una perspectiva específica centrada en el modelo. Es la opción más lógica cuando merece más la pena realizar un segundo análisis minucioso que dar una primera respuesta más breve.
GPT-6 Sol se adapta a los requisitos de producción con ciertas limitaciones: un informe extenso, un memorándum de decisión, un plan estructurado o un borrador que debe incluir numerosas secciones solicitadas. OpenAI lo describe como un modelo GPT-6 más asequible para el trabajo profesional, la veracidad de los datos, la programación, el uso de ordenadores y la colaboración. El Reseña del GPT-6 Sol aborda el modelo por sí mismo; en la tarea de formato largo que aquí se presenta, completó el contrato en la primera salida, lo cual resulta útil cuando el coste de una sección que falta es elevado.
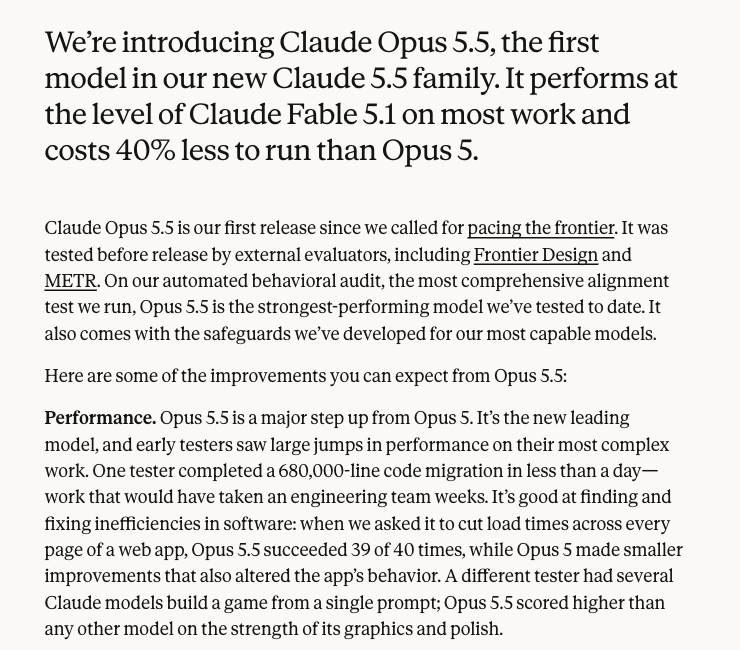
Este es el relato de Anthropic sobre el lanzamiento, que incluye ejemplos de los primeros usuarios que lo probaron. Respalda la orientación prevista del producto; no establece un resultado comparativo directo con GPT-6 Sol. Nuestras indicaciones comparativas que figuran a continuación abordan la cuestión más concreta de qué resultados arrojó cada modelo en esta prueba.
Comparación de características y prestaciones
Claude Opus 5.5 frente a GPT-6 Sol: mapa de capacidades
| Ámbito de decisión | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Redacción de textos largos | Destaca por su redacción cuidadosa y matizada, así como por sus advertencias explícitas | Destaca por su capacidad para completar un encargo extenso y con múltiples restricciones de una sola vez |
| Síntesis de la investigación | Conciliación detallada y explicación de los riesgos | Resumen conciso con una recomendación clara |
| Programación y revisión | Diagnóstico preciso e información estructurada sobre los riesgos | Parches mínimos útiles; validar las explicaciones de los casos extremos |
| Salida estructurada | JSON riguroso y fiable en la tarea evaluada | JSON válido que contiene todas las claves solicitadas en la tarea probada |
| Multimodal y herramientas | Comprueba la ruta y el modelo de acceso para la tarea concreta | Comprueba la ruta y el modelo de acceso para la tarea concreta |
| El mejor estilo de trabajo | Análisis reflexivo, razonamiento complejo y trabajo sensible al riesgo | Se ha completado el resumen con restricciones sometido a prueba dentro del límite máximo de volumen de salida establecido. |
Cómo leer esto: Se trata de tendencias en los flujos de trabajo, no de una clasificación universal. La elección adecuada depende de si valoras más una revisión minuciosa o la finalización de este denso informe dentro del mismo límite de volumen de trabajo.
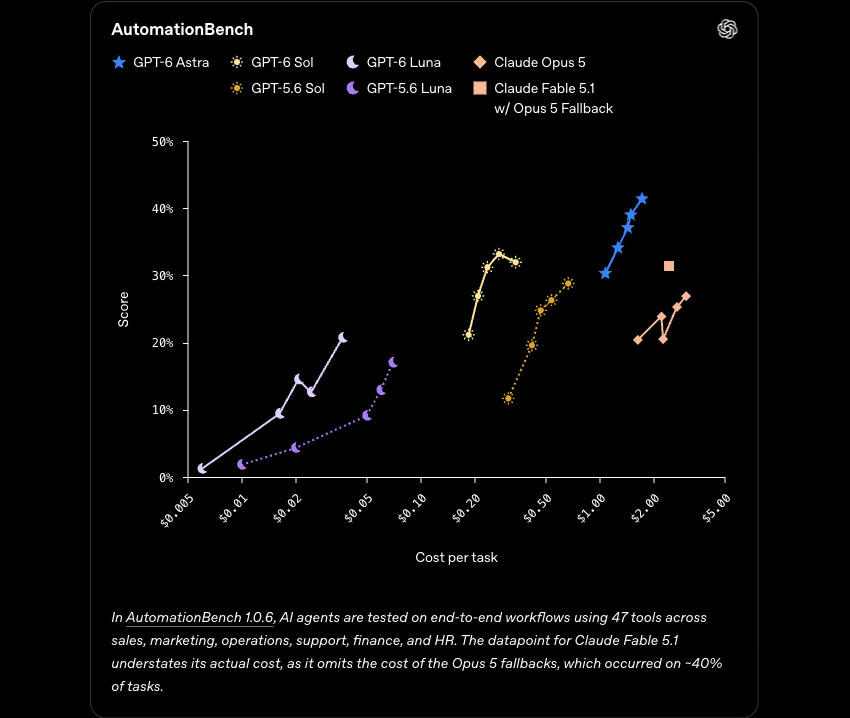
Interpreta ambos ejes: un movimiento hacia arriba indica una puntuación más alta, mientras que un movimiento hacia la izquierda indica un menor coste por tarea. La serie Claude que aparece aquí es la Opus 5, no la Opus 5.5. Este gráfico, facilitado por el editor, ayuda a explicar el posicionamiento de Sol en cuanto a relación calidad-precio; sin embargo, no permite zanjar la comparación que se plantea en este artículo. La nota al pie también indica que los datos de Fable omiten algunos costes de contingencia.
Redacción, documentos extensos y síntesis de investigaciones
En cuanto a la redacción, esta prueba distingue entre la finalización de un texto con un límite de extensión fijo y la calidad del revisión editorial. GPT-6 Sol obtuvo mejores resultados en el contrato de formato extenso. Claude Opus 5.5 obtuvo mejores resultados cuando la tarea consistía en diagnosticar, evaluar y explicar. En cuanto a las notas de investigación, ambos modelos llegaron a la misma conclusión práctica, por lo que la calidad del material de origen y el proceso de revisión siguen siendo más importantes que el ganador a primera vista.
- Utiliza GPT-6 Sol para elaborar un primer borrador con muchas restricciones, un memorándum de decisión o un plan de contenido estructurado.
- Utiliza Claude Opus 5.5 para cuestionar las suposiciones, poner de manifiesto los riesgos y pulir un borrador antes de que llegue al cliente o al sistema de producción.
- Cuando los datos sean importantes, proporciona el material de origen a cualquiera de los dos modelos y mantén una fase de revisión humana.
Programación, salida estructurada y trabajo preparado para su uso con herramientas
Ambos modelos devolvieron un JSON válido con todas las claves solicitadas y el mismo parche mínimo. Claude describió correctamente el filtro existente; GPT-6 Sol afirmó erróneamente que un elemento «None» provocaría un error. Esto respalda el uso de Claude para el diagnóstico en esta tarea concreta. El tipo del campo «risk» no se especificó en la indicación, por lo que la cadena de Sol relativa al riesgo no supone un incumplimiento del contrato.
Para un trabajo preparado para su uso con herramientas, evalúa el contrato de salida que realmente necesitas: formato JSON válido, campos completos, comandos reproducibles y un parche que se pueda aplicar sin necesidad de interpretación. Ambos modelos pueden formar parte de ese flujo de trabajo, manteniendo las pruebas y la revisión en el ciclo.
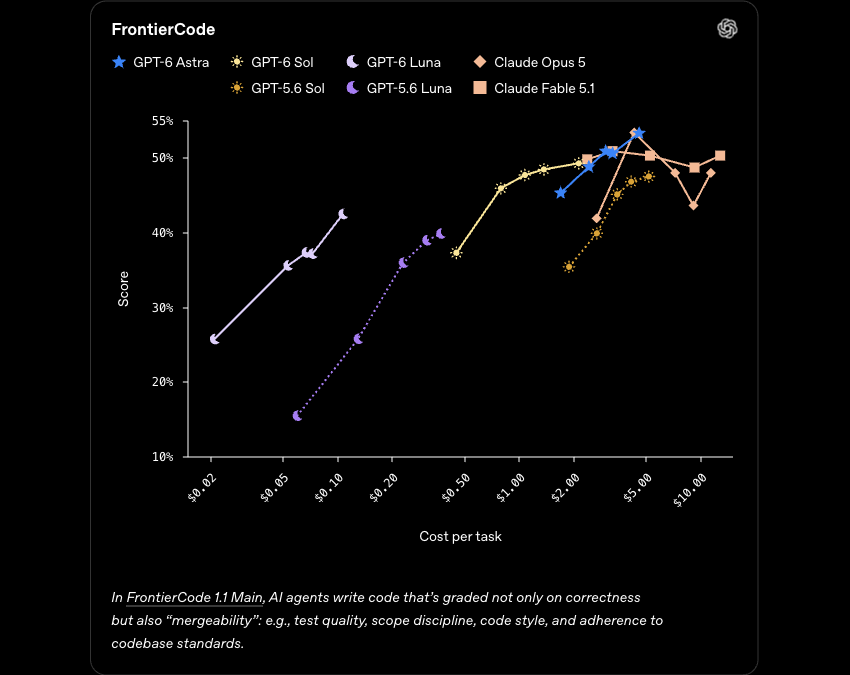
Esta prueba de referencia abarca una codificación agéntica más amplia que nuestra breve indicación para la revisión del código. Su comparador Claude es Opus 5, por lo que sirve como contexto para situar la codificación de Sol, más que como prueba de que Sol supere a Opus 5.5. En nuestra propia tarea, ambas soluciones eran correctas; la distinción relevante fue la precisión del diagnóstico.
Precio y acceso
Precio y accesibilidad: compara la ruta, no solo el modelo
| Ruta | Por qué estás pagando | Cuando tiene sentido |
|---|---|---|
| Claude Opus 5.5 API | Anthropic indica en su página de lanzamiento del 22 de septiembre de 2026 que son $4 por cada millón de tokens de entrada, $20 por cada millón de tokens de salida y $0,20 por cada millón de tokens de lectura de caché. | Estás desarrollando un producto o un proceso automatizado y quieres facturación directa mediante token |
| API de GPT-6 Sol | OpenAI incluye $2 por cada millón de tokens de entrada y $10 por cada millón de tokens de salida, con una reducción de 50% respecto al precio promocional de GPT-5.6 Sol; las lecturas de entrada almacenadas en caché se benefician de un descuento de 90%. | Necesitas un contrato de API con un proveedor directo y quieres reducir el coste por uso para trabajos continuados |
| GlobalGPT | Una suscripción asequible que incluye ambos modelos, además de muchos otros modelos y funciones de IA | ¿Quieres poder gestionar la investigación, la redacción, la programación y el trabajo con imágenes y vídeos desde un único panel de control? |
Estas cifras corresponden a las tarifas de los tokens API, no a los precios de las suscripciones. OpenAI posiciona a GPT-6 Sol como la opción más económica de la familia GPT-6 para el trabajo profesional, la veracidad de la información, la programación, el uso de ordenadores y la colaboración, mientras que Anthropic posiciona a Claude Opus 5.5 en torno a la programación, el uso de ordenadores, el trabajo intelectual, la seguridad y la comunicación. GlobalGPT mantiene ambos modelos y el resto de la cadena de herramientas disponibles a través de una única suscripción asequible, mientras que su CLI conecta ese acceso a un terminal, al flujo de trabajo de desarrollo y a las herramientas de producción existentes.
Fuentes primarias: Página de la versión Claude Opus 5.5 de Anthropic y Página de lanzamiento de Sol y Luna de GPT-6 de OpenAI.
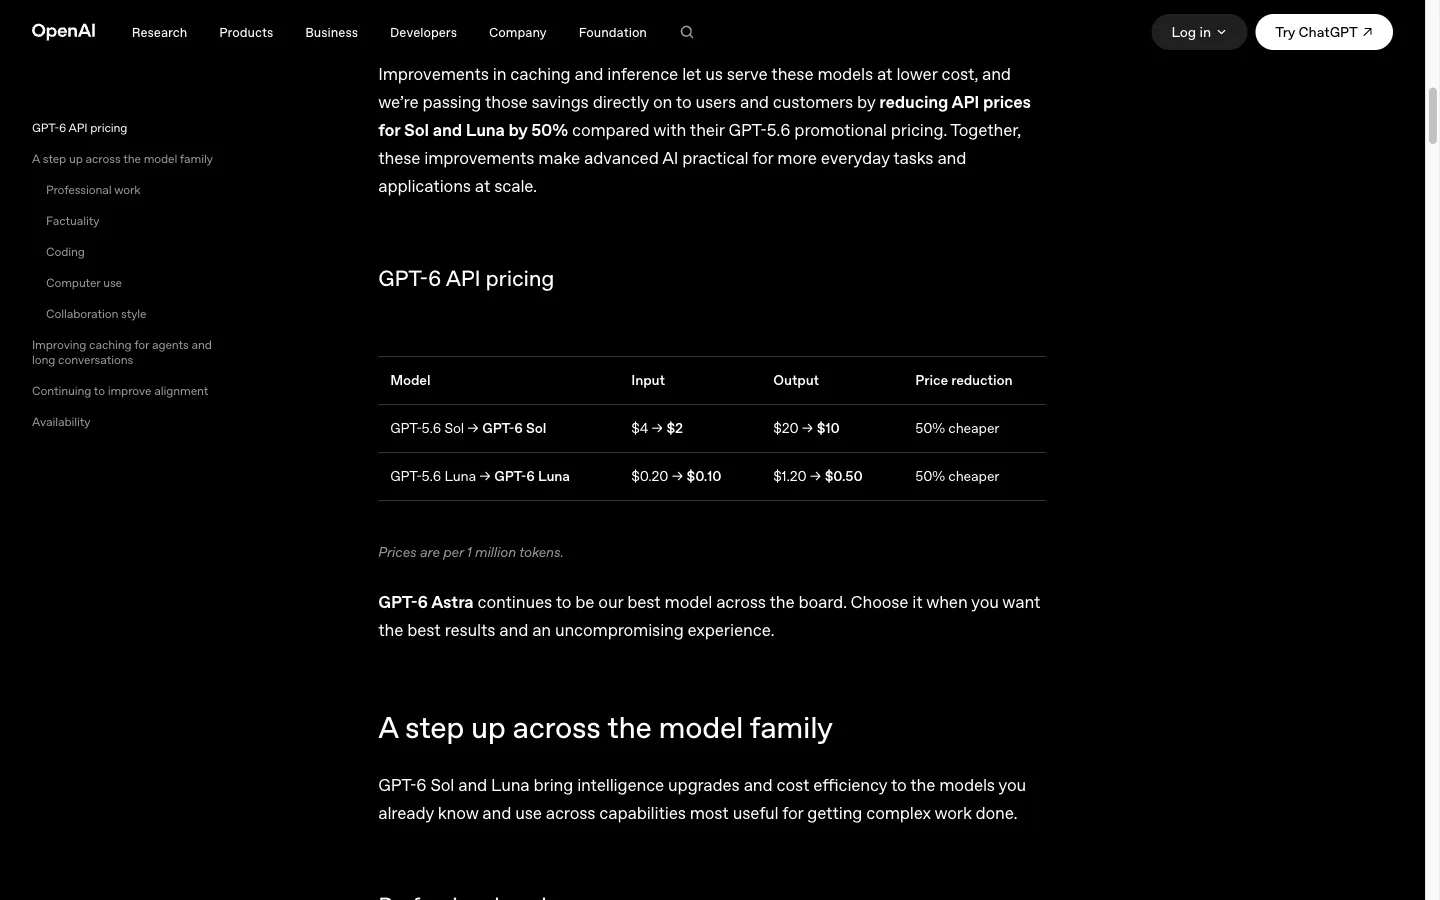
Estas tarifas se aplican a los tokens de API. No corresponden a una suscripción mensual para consumidores ni al plan GlobalGPT.
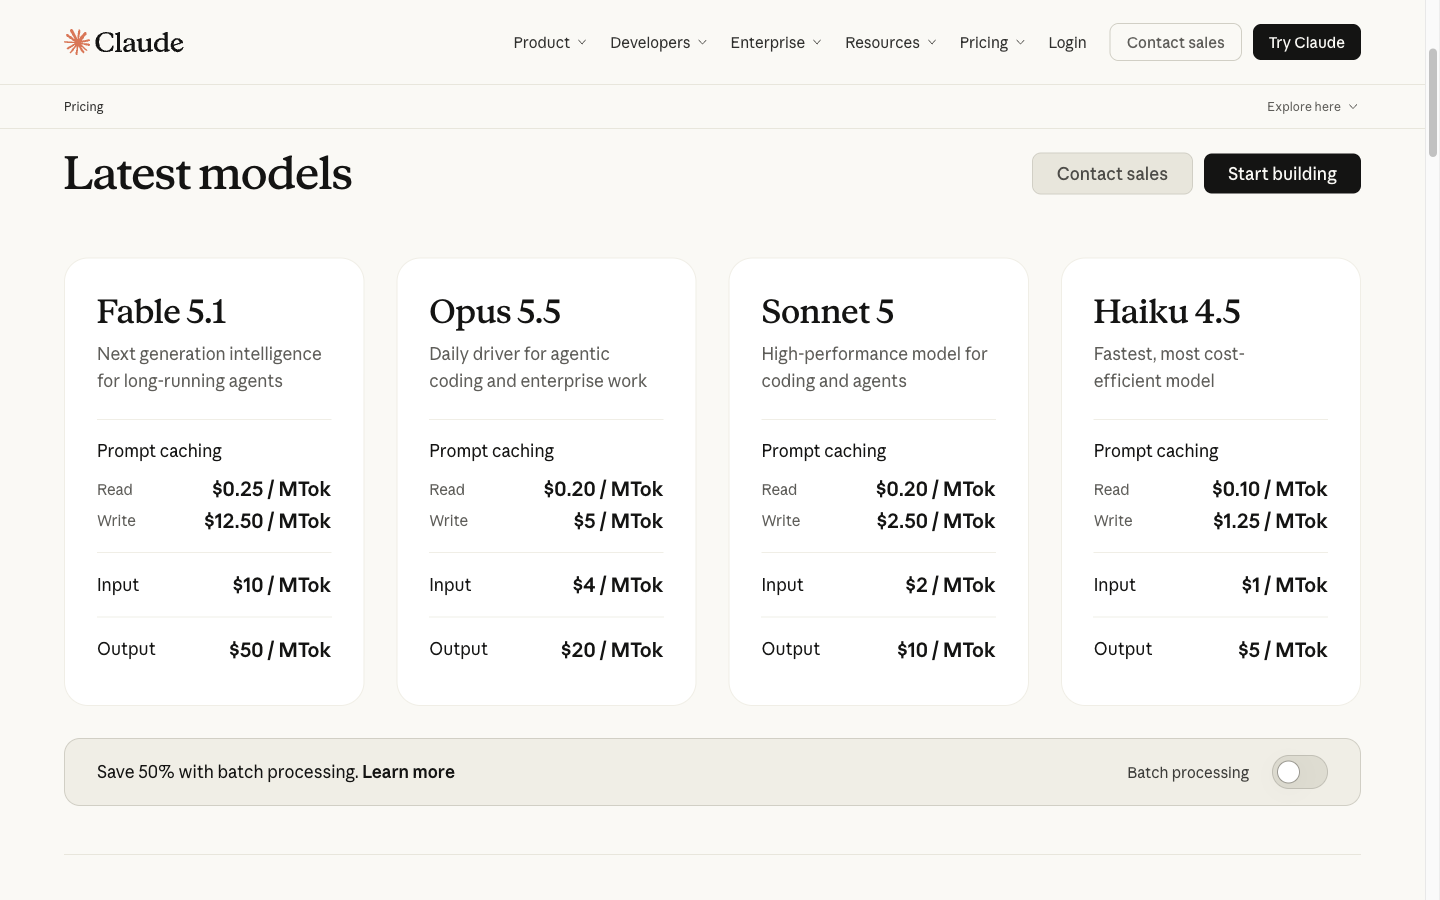
Las tasas de entrada y salida estándar de Opus 5.5 son el doble que las de Sol, mientras que ambas tasas de lectura en caché publicadas son de $0,20/M. Por lo tanto, un flujo de trabajo con un uso intensivo de la caché puede presentar una diferencia de coste distinta a la de uno sin caché; compara la misma combinación de tokens antes de decidirte por el precio.
Qué implica la diferencia de velocidad para la misma carga de trabajo
Ejemplo de cálculo: 1 millón de tokens de entrada no almacenados en caché + 100 000 tokens de salida, tarifas estándar de la API. El color verde azulado representa el coste de los insumos; el color óxido, el coste de la producción.
Sol cuesta la mitad por esta misma combinación de tokens. Se trata de un cálculo basado en la tarifa, no de una afirmación de que cada tarea completada cueste la mitad: los reintentos, la longitud de la salida, los aciertos en la caché, los costes de las herramientas y los ajustes de razonamiento pueden modificar el importe de la factura.
Fuentes: Precios de la API Anthropic y Precios de lanzamiento de OpenAI, consultado el 25 de septiembre de 2026.Calcular el coste directo de la API
Calculadora de costes de la API
Introduce los tokens que esperas enviar y recibir. La estimación utiliza las tarifas de la API verificadas anteriormente: Claude Opus 5,5 con una entrada de $4/M y una salida de $20/M; GPT-6 Sol con una entrada de $2/M y una salida de $10/M.
| Modelo | Tasa de entrada | Tasa de producción | Coste estimado |
|---|---|---|---|
| Claude Opus 5,5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
Se trata de un presupuesto de facturación por tokens para el uso directo de la API. No incluye el precio de una suscripción de consumidor ni del plan GlobalGPT, y excluye los descuentos por caché, las herramientas, los impuestos y otros cargos específicos del proveedor.
¿Quién debería elegir qué modelo?
¿Qué modelo deberías elegir?
| Tu prioridad | Elige primero | Por qué |
|---|---|---|
| Un memorándum extenso y bien redactado con numerosas limitaciones | GPT-6 Sol | La tarea de formato extenso revisada alcanzó la regla de decisión solicitada en un solo resultado |
| Diagnóstico del código, JSON estricto y riesgos explícitos | Claude Opus 5,5 | La tarea de codificación permitió obtener un diagnóstico y una evaluación de riesgos más precisos. |
| Notas de investigación que deben conciliarse | O bien | La prueba de síntesis de fuentes controladas terminó en empate |
| Un flujo de trabajo semanal mixto | GlobalGPT con ambos | Mantén la elección del modelo, la redacción, la programación, las imágenes y los vídeos en un único panel de control; utiliza la interfaz de línea de comandos (CLI) cuando el trabajo se traslade a una terminal. |
Utiliza ambos modelos en un único flujo de trabajo completo
Un flujo de trabajo práctico para GlobalGPT
- Empieza con un resumen de investigación y pide a un modelo que exponga sus supuestos.
- Pasa el borrador revisado a la otra plantilla para su redacción o para obtener una segunda opinión.
- Utiliza el método de codificación más sólido para la implementación, la revisión y la generación de resultados estructurados.
- Guarda el trabajo resultante en el mismo panel de control y, a continuación, utiliza el Flujo de trabajo de la CLI de GlobalGPT cuando tenga que incorporarse a un terminal o a una herramienta de producción.
Ese flujo de trabajo es la principal ventaja de poder acceder a ambos modelos: te permite distribuir la tarea, en lugar de tener que reestructurar tu proceso en función de un solo modelo.

Cómo se llevó a cabo la comparación
Ambos modelos recibieron el mismo mensaje del sistema, las mismas entradas de tareas y el mismo material de partida, y no se utilizaron herramientas ni se realizó ninguna búsqueda. Cada resultado conserva la primera salida devuelta, incluido el truncamiento por límite de salida. Se trata de una comparación práctica para elegir un flujo de trabajo, no de una clasificación universal de todas las capacidades.
Método de comparación
Cómo se llevó a cabo esta comparación
| Estado | Regla de comparación |
|---|---|
| Modelos | Claude Opus 5.5 y GPT-6 Sol; se han confirmado los ID exactos en el directorio de modelos activos |
| Paridad de comandos | El mismo mensaje del sistema, la misma solicitud de tarea, el mismo material de referencia; sin herramientas ni navegación |
| Tareas | Comprobación de límites T01, comparación explícita en formato extenso T01R, síntesis de código fuente T02, código/JSON T03 |
| Reintentos | Solo se tienen en cuenta los fallos de transporte, capacidad o sobre vacío; se conserva la salida débil válida |
| Puntuación | 10 puntos por cada tarea superada: contrato objetivo 4, trazabilidad 3, utilidad 2, formato 1 |
La primera prueba comprueba si un modelo es capaz de adivinar cuando falta contexto clave, por lo que se mantiene separada del cálculo del ganador. La comparación directa incluye ambos modelos y les proporciona el mismo resumen. No se utilizaron repeticiones de estabilidad.
¿Por qué no se eligió un ganador en la primera convocatoria?
Gestión del contexto
¿Por qué no se eligió un ganador en la primera convocatoria?
Ambos modelos se negaron a inventar identidades de modelos porque la indicación original no los mencionaba. Esa es la respuesta correcta ante la falta de contexto, pero no nos permite saber qué modelo es mejor en la tarea en sí.
Claude Opus 5,5 · entrada completa
Estás comparando dos modelos de IA para una guía práctica para compradores. Utilizando únicamente el paquete de datos que aparece a continuación, redacta un texto de entre 700 y 900 palabras con exactamente estos apartados: Decisión, Evidencia, Advertencias y Próximo paso. Mantén estos datos tal y como aparecen: el Proyecto North tiene un plazo de 12 semanas; el presupuesto para la migración es de $48.000; la revisión de seguridad no está programada. Si algún dato no está claro, indícalo explícitamente. No inventes precios, valores de referencia ni prestaciones de los productos.

PAQUETE DE REFERENCIA:
El Proyecto North es una migración de 12 semanas para un equipo de 40 personas. El presupuesto aprobado para la migración es de $48 000. Aún no se ha fijado la fecha para la revisión de seguridad. El equipo desea una recomendación modelo para la investigación, la redacción y la revisión del código. Una nota de una de las partes interesadas indica que el borrador actual es demasiado largo, pero no especifica el recuento de palabras.

Envía únicamente la guía.
Claude Opus 5,5 · potencia máxima
Decisión ##

A partir del paquete de información facilitado, no es posible realizar ninguna recomendación entre los dos modelos. El paquete no menciona ninguno de los modelos ni proporciona precios, resultados de pruebas comparativas ni prestaciones de los productos. Elegir ahora un modelo en lugar del otro significaría inventar las pruebas en las que se supone que debe basarse esta guía.

La decisión práctica es aplazar la selección del modelo. Tratar la siguiente fase como una evaluación estructurada regida por tres restricciones fijas:

- El Proyecto Norte tiene un plazo de 12 semanas.
- El presupuesto para la migración es de $48 000.
- La revisión de seguridad aún no está programada.

Cualquier modelo que se elija deberá ajustarse al plazo de 12 semanas y al presupuesto de migración de $48 000. También debe superar una revisión de seguridad, y dicha revisión aún no figura en el calendario. Hasta que no se identifiquen los dos modelos y se evalúen en función de los tres usos establecidos por el equipo (investigación, redacción y revisión de código), la selección seguirá sin resolverse. Esta guía lo expone con claridad, en lugar de ofrecer una preferencia que las pruebas no puedan respaldar.

## Evidencia

El paquete de fuentes contiene los siguientes datos, y solo estos datos sirven de base para esta guía:

- **Alcance y plazos:** El Proyecto Norte es una migración de 12 semanas.
- **Tamaño del equipo:** La migración da servicio a un equipo de 40 personas.
- **Presupuesto:** El presupuesto aprobado para la migración es de $48 000.
- **Seguridad:** No se ha programado el calendario para la revisión de seguridad.
- **Casos de uso:** El equipo desea una recomendación de modelo para investigación, redacción y revisión de código.
- **Comentarios de las partes interesadas:** Una nota de una de las partes interesadas indica que el borrador actual es demasiado largo, pero no especifica el recuento de palabras.

El paquete no contiene varios elementos en los que normalmente se basaría una comparación. No identifica los dos modelos que se están comparando. Tampoco indica los precios por puesto, por token o por suscripción para ninguna de las dos opciones. No proporciona puntuaciones de referencia ni resultados de pruebas internas. No describe lo que cada modelo puede o no puede hacer en materia de investigación, redacción o revisión de código. No dice nada sobre las condiciones de tratamiento de datos, las opciones de implementación o los requisitos de integración.

Dado que ninguno de estos elementos aparece en el paquete, esta guía no ofrece estimaciones al respecto. Se desconoce si alguno de los modelos se ajusta al presupuesto de $48 000 para un equipo de 40 personas. Tampoco se sabe si alguno de los modelos ofrece un mejor rendimiento en investigación, redacción o revisión de código. Cualquier cifra o afirmación sobre capacidades que se añadiera aquí sería inventada.

## Advertencias

Varias cuestiones sin resolver afectan a la forma en que debe interpretarse esta decisión.

**La identidad de los modelos no está clara.** La comparación se refiere a dos modelos de IA, pero el paquete no especifica cuáles son. Toda valoración posterior depende de que se resuelva primero esta cuestión.

**El alcance del presupuesto no está claro.** El documento se refiere a la cifra de $48 000 como el "presupuesto de migración aprobado". No aclara si esa cantidad está destinada a cubrir las licencias de los modelos o las tarifas de uso. En cambio, podría cubrir únicamente el trabajo de migración, como el tiempo del personal, las herramientas o los servicios. Si los costes de los modelos deben sufragarse con esos mismos $48.000, el margen de maniobra para cualquiera de los dos modelos es más reducido de lo que sugiere la cifra principal. Esto debe confirmarse.

**El calendario de la revisión de seguridad sigue sin estar claro y supone un riesgo para el calendario general.** La revisión de seguridad no está programada. Con un plazo de 12 semanas, una revisión sin programar supone un riesgo real para el calendario. El dossier no indica cuánto tiempo lleva una revisión ni si una revisión fallida obligaría a cambiar al otro modelo. Ambos resultados podrían consumir una parte significativa de las 12 semanas. Ningún modelo debe considerarse aprobado hasta que se haya completado la revisión.

**La ponderación de los casos de uso sigue sin estar clara.** El equipo ha señalado tres usos: investigación, redacción y revisión de código. El documento no especifica si todos tienen la misma importancia o si alguno predomina. Un modelo más sólido en un área podría ser más débil en otra, y sin una ponderación no hay base para equilibrar estas ventajas e inconvenientes.

**El volumen de uso sigue sin estar definido.** El equipo cuenta con 40 personas, pero el documento no indica cuántas utilizarán el modelo ni con qué intensidad. El volumen de uso podría afectar considerablemente al coste en determinadas estructuras de precios. Esto no puede evaluarse sin datos sobre precios y estimaciones de uso.

**La instrucción sobre la duración con
GPT-6 Sol · entrada completa
Estás comparando dos modelos de IA para una guía práctica para compradores. Utilizando únicamente el paquete de datos que aparece a continuación, redacta un texto de entre 700 y 900 palabras con exactamente estos apartados: Decisión, Evidencia, Advertencias y Próximo paso. Mantén estos datos tal y como aparecen: el Proyecto North tiene un plazo de 12 semanas; el presupuesto para la migración es de $48.000; la revisión de seguridad no está programada. Si algún dato no está claro, indícalo explícitamente. No inventes precios, valores de referencia ni prestaciones de los productos.

PAQUETE DE REFERENCIA:
El Proyecto North es una migración de 12 semanas para un equipo de 40 personas. El presupuesto aprobado para la migración es de $48 000. Aún no se ha fijado la fecha para la revisión de seguridad. El equipo desea una recomendación modelo para la investigación, la redacción y la revisión del código. Una nota de una de las partes interesadas indica que el borrador actual es demasiado largo, pero no especifica el recuento de palabras.

Envía únicamente la guía.
GPT-6 Sol · salida completa
## Decisión

No se debe designar todavía un modelo ganador. El paquete de origen solicita una recomendación entre dos modelos de IA, pero no identifica ninguno de los dos ni proporciona resultados para investigación, redacción o revisión de código. Por lo tanto, afirmar que uno es mejor carecería de fundamento. La recomendación práctica es comparar los dos candidatos con el propio trabajo del equipo antes de tomar una decisión.

El Proyecto North tiene un plazo de 12 semanas. El presupuesto para la migración es de $48 000. La revisión de seguridad no está programada. Estos hechos hacen que la decisión sea urgente, pero no justifican que se tome a ciegas. Una elección acertada debe tener en cuenta si un modelo ayuda al equipo de 40 personas a completar sus tareas reales, cómo encaja su uso dentro del presupuesto aprobado y qué aspectos siguen siendo inciertos hasta que se conozca la fecha de la revisión de seguridad.

Considera la recomendación como condicional: elige el modelo que ofrezca un mejor rendimiento en tareas representativas, que pueda utilizarse dentro del presupuesto de migración aprobado y que supere cualquier revisión necesaria para su uso previsto. Si ninguno de los candidatos cumple esas condiciones, la guía debería indicar que, por el momento, no se puede recomendar ninguno. El material disponible no permite determinar que se haya cumplido ninguna de las condiciones.

## Evidencia

El equipo desea una recomendación de modelo para tres tipos de trabajo: investigación, redacción y revisión de código. Estas son las categorías de comparación adecuadas, ya que se derivan de la necesidad expresada, no de supuestos puntos fuertes del producto. El dossier no contiene ejemplos de los resultados de ninguno de los dos modelos, ni resultados de evaluación, ni una descripción de lo que ofrecen los dos candidatos. Tampoco contiene precios ni puntos de referencia. En consecuencia, no existe una base probatoria para clasificar los modelos en función de la precisión, la velocidad, la calidad, el coste o la idoneidad.

El contexto del proyecto sí proporciona criterios de decisión útiles. El Proyecto Norte consiste en la migración de un equipo de 40 personas, por lo que la comparación debería reflejar las tareas que los miembros de ese equipo realizarían realmente. El presupuesto aprobado para la migración es de $48 000; cualquier propuesta de uso de un modelo debe evaluarse en función de esa cantidad, en lugar de una asignación inventada para herramientas de IA. No hay programada una revisión de seguridad, lo que deja sin resolver el momento en que se llevará a cabo dicha revisión —y su efecto en la adopción—.

Una parte interesada ha señalado que el borrador actual es demasiado extenso, pero no ha facilitado un recuento de palabras. Esto es indicativo de una preferencia por la concisión, no de un límite cuantificable para el resultado del modelo. Al comparar muestras de redacción, los evaluadores pueden valorar si cada candidato cumple con la petición de ser conciso y conserva los hechos esenciales. No deben afirmar que ninguno de los modelos cumple un límite de palabras especificado por las partes interesadas, ya que no se ha indicado ninguno.

En cuanto a la investigación, sería útil comprobar si cada candidato distingue los hechos proporcionados de las cuestiones abiertas y evita conclusiones sin fundamento. En cuanto a la redacción, sería si cada uno elabora un borrador claro y adecuadamente breve sin omitir las restricciones. Para la revisión de código, sería si cada uno identifica problemas en un ejemplo proporcionado y los explica de forma que un revisor pueda verificarlos. Se trata de pruebas propuestas, no de conclusiones sobre ninguno de los modelos.

## Advertencias

La principal advertencia es que los propios candidatos aún no están definidos: el expediente no los nombra. Tampoco indica cómo accedería el equipo a ellos, cuánto costarían ni si alguno de ellos está disponible para el trabajo previsto. No debe inferirse ninguna capacidad del producto a partir de la expresión “modelos de IA”. Ni siquiera una comparación bien diseñada puede dar lugar a una recomendación de producto hasta que se conozcan los candidatos y las pruebas de evaluación.

El presupuesto de migración está aprobado, pero el expediente no destina ninguna parte del mismo al uso o las pruebas de los modelos. No se debe considerar $48 000 como un presupuesto de adquisición de IA. Del mismo modo, un plazo de 12 semanas no establece una fecha en la que se llevará a cabo la revisión de seguridad. Dado que la revisión de seguridad no está programada, sigue sin estar claro si un candidato podría utilizarse según los requisitos del equipo ni cuándo podría hacerlo.

Los tres usos solicitados también pueden dar lugar a resultados diferentes. Un candidato podría ser preferible para una tarea y no para otra; el paquete no ofrece ninguna base para suponer que haya un único ganador en investigación, redacción y revisión de código. Una recomendación debería hacer visible cualquier compensación de este tipo, en lugar de ocultarla bajo una etiqueta general. Si el equipo decide que una categoría es más importante que las demás, esa prioridad debería provenir de las partes interesadas, no de esta guía.

Por último, la observación sobre la excesiva extensión del borrador no debe confundirse con una prueba del rendimiento del modelo. Describe comentarios sobre un borrador actual, sin identificar a su autor ni indicar una extensión objetivo. Puede servir de referencia para la presentación de la recomendación final, pero no puede zanjar la comparación.

## Siguiente paso

Identifica a los dos candidatos y pide al equipo tareas representativas de investigación, redacción y revisión de código. Proporcione a cada modelo los mismos materiales e instrucciones para cada tarea, incluidas las indicaciones para señalar la incertidumbre y evitar añadir datos. Pida a los revisores que anoten qué acierta cada respuesta, qué omite y qué afirmaciones requieren verificación. Mantenga separadas las observaciones específicas de cada tarea, de modo que una buena muestra de redacción no sustituya a las pruebas relativas a la revisión de código.

Antes de elegir, confirma el coste del uso previsto en relación con el presupuesto de migración de $48 000 y establece cuándo puede realizarse la revisión de seguridad. Ninguna de las respuestas se encuentra en el dossier. Si esas cuestiones no pueden resolverse a tiempo para tomar una decisión, informa claramente de esa limitación en lugar de presentar una preferencia provisional como una elección aprobada.

La recomendación final al comprador puede ser entonces breve y verificable: nombra a los candidatos, expón las pruebas para cada uno de los tres usos, explica las posibles compensaciones e identifica las cuestiones pendientes en materia de aprobación o presupuesto. Hasta que se disponga de esa información, la respuesta honesta para el Proyecto North no es “Modelo A” ni “Modelo B”. Es que la comparación aún no se ha respaldado con pruebas.
Considera esto como una comprobación del contexto, no como una clasificación de calidad.
Redacción de textos largos
Finalización con el mismo límite de producción de 2.400 tokens
El mismo resumen requería cinco secciones. Ambos modelos tenían un límite de salida de 2.400 tokens; los metadatos devueltos explican la diferencia visible.
Claude alcanzó el límite máximo de salida configurado antes de la regla de decisión. Sol completó el resumen dentro de ese límite. Esto respalda una recomendación para esta ejecución con restricciones, no una clasificación general de la capacidad máxima de redacción o la velocidad. A continuación se conserva el texto completo devuelto, incluida la respuesta truncada.
Tarea extensa
Redacción de textos extensos: GPT-6 Sol completó el encargo
Esta es la primera tarea de comparación directa. La indicación mencionaba explícitamente Claude Opus 5,5 y GPT-6 Sol, entregó a ambos el mismo dossier informativo sobre el Proyecto Norte y les pidió un memorándum de decisión condicional.
| Medida | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Longitud visible | 648 palabras; motivo_de_finalización=longitud | 1.065 palabras; motivo_de_finalización=parada |
| Campos obligatorios | 4 de 5; Falta la regla de decisión tras el truncamiento | 5 de 5 |
| Cuadro de resultados de cuatro filas | Presente y simétrico | Presente y simétrico |
| Comprobaciones del piloto / condición de parada | Se inició, pero se interrumpió antes de completarse | Tres comprobaciones y una condición de parada |
| Puntuación | 7.0 / 10 | 10.0 / 10 |
Para llevar: Con el mismo límite de salida de 2.400 tokens, GPT-6 Sol devolvió las cinco secciones, mientras que Claude Opus 5.5 alcanzó el límite antes de la regla «Decision». Esto demuestra que se completó la tarea con esta configuración; no establece la capacidad máxima de redacción ni la velocidad general de ninguno de los dos modelos.
Entrada completa compartida
Estás redactando un memorándum de decisión para un equipo que debe elegir entre Claude Opus 5.5 y GPT-6 Sol. Los nombres de los modelos son fijos y deben aparecer exactamente tal y como se han escrito. Utilizando únicamente el paquete de pruebas que figura a continuación, redacta un texto de entre 900 y 1100 palabras que incluya exactamente las siguientes secciones: Recomendación ejecutiva; Lo que respaldan las pruebas; Dónde faltan pruebas; Prueba piloto de 30 días; Regla de decisión.

Requisitos: (1) compara el Claude Opus 5.5 y el GPT-6 Sol de forma simétrica; (2) distingue entre pruebas observadas, suposiciones e incógnitas; (3) mantén las fechas exactas, el presupuesto, el tamaño del equipo y el estado de seguridad sin resolver; (4) incluye un cuadro de mando compacto de cuatro filas que abarque la síntesis de la investigación, la redacción extensa, la revisión del código y el JSON estructurado; (5) ofrece una recomendación condicional en lugar de inventar un ganador; (6) enumerar tres comprobaciones piloto cuantificables y una condición de parada; (7) no inventar precios, puntos de referencia, límites de contexto ni capacidades del producto.

PAQUETE DE PRUEBAS
- El Proyecto North es una migración de 12 semanas para un equipo de 40 personas.
- El presupuesto aprobado para la migración es de $48 000. El paquete no especifica si el uso del modelo está incluido en ese presupuesto.
- No se ha programado el calendario para la revisión de seguridad.
- El equipo necesita síntesis de investigación, redacción de textos extensos, revisión de código y extracción estructurada de JSON.
- Una de las partes interesadas afirma que el borrador actual es demasiado largo, pero no se ha aprobado ningún recuento de palabras objetivo.
- Aún no se han facilitado resultados controlados de Claude Opus 5.5 ni de GPT-6 Sol.
- El equipo quiere una opción auditable y puede llevar a cabo una prueba piloto de 30 días con indicaciones idénticas y revisión humana.

Envía únicamente el memorándum. No afirmes que el paquete de pruebas demuestre que alguno de los modelos es mejor.
Claude Opus 5,5 · salida completa devuelta
## Recomendación ejecutiva

No selecciones todavía Claude Opus 5.5 ni GPT-6 Sol. El paquete de pruebas no contiene resultados controlados de ninguno de los dos modelos. Por lo tanto, no hay una base empírica para declarar que uno es mejor que el otro en ninguna de las cuatro cargas de trabajo requeridas.

La recomendación es condicional. Realice una prueba piloto de 30 días en la que se proporcionen a ambos modelos indicaciones idénticas y se aplique la misma revisión humana. A continuación, seleccione el modelo que cumpla los umbrales acordados antes de que comience la prueba piloto, siempre y cuando se resuelvan primero las cuestiones de seguridad y presupuesto que se indican a continuación. Hay tres resultados posibles:

- **Un modelo supera los umbrales:** elija ese modelo.
- **Ambos los superan:** aplique los criterios de desempate de la regla de decisión.
- **Ninguno los supera:** no adopte ninguno.

Este enfoque ofrece al equipo la opción auditable que ha solicitado.

Los datos fijos del proyecto son:

- El Proyecto Norte es una migración de 12 semanas para un equipo de 40 personas.
- El presupuesto aprobado para la migración es de $48.000. El expediente no indica si el uso del modelo está incluido en ese presupuesto.
- No hay un calendario previsto para la revisión de seguridad.
- El expediente no proporciona fechas concretas (ni fecha de inicio del proyecto, ni fecha de finalización, ni ventana para la fase piloto), por lo que este memorándum no asigna ninguna.

## Lo que respaldan las pruebas

**Pruebas observadas.** Estos son los hechos que se indican directamente en el expediente:

- El Proyecto Norte es una migración de 12 semanas para un equipo de 40 personas.
- El presupuesto aprobado para la migración es de $48 000, y no se especifica si incluye el uso del modelo.
- No se ha programado el calendario para la revisión de seguridad.
- Las cargas de trabajo requeridas son la síntesis de investigaciones, la redacción de textos extensos, la revisión de código y la extracción estructurada de JSON.
- Una de las partes interesadas afirma que el borrador actual es demasiado largo, pero no se ha aprobado ningún número objetivo de palabras.
- No se han facilitado resultados controlados de Claude Opus 5.5 ni de GPT-6 Sol.
- El equipo desea una opción auditable y puede llevar a cabo una prueba piloto de 30 días con indicaciones idénticas y revisión humana.

**Qué respalda esto.** La evidencia define qué se debe evaluar y cómo, pero no qué modelo resulta ganador. Justifica una prueba piloto estructurada y comparativa. No justifica ninguna afirmación sobre la calidad, la velocidad, el coste, el manejo del contexto o la disponibilidad de funciones de ninguno de los dos modelos.

**Cuadro de mando (estado actual de las pruebas)**

| Carga de trabajo | Claude Opus 5.5 | GPT-6 Sol | Medida de la prueba piloto |
|---|---|---|---|
| Síntesis de investigación | No se ha facilitado ningún resultado controlado | No se ha facilitado ningún resultado controlado | Puntuación de la rúbrica del revisor ciego |
| Redacción de texto extenso | No se ha facilitado ningún resultado controlado | No se ha facilitado ningún resultado controlado | Puntuación de la rúbrica más cumplimiento de un objetivo de extensión aprobado |
| Revisión de código | No se ha facilitado ningún resultado controlado | No se ha facilitado ningún resultado controlado | Porcentaje de problemas conocidos identificados |
| JSON estructurado | No se ha facilitado ningún resultado controlado | No se ha facilitado ningún resultado controlado | Tasa de superación de la validación del esquema |

Todas las celdas de ambos modelos son idénticas porque el paquete los trata de la misma manera. Actualmente, ninguna fila favorece a ninguno de los dos modelos.

## Donde faltan pruebas

**Incógnitas.** El paquete no se pronuncia sobre ninguno de estos aspectos:

- Si los costes de uso de los modelos se incluyen en el presupuesto de migración de $48 000 o requieren financiación independiente.
- Cuándo se llevará a cabo la revisión de seguridad, qué abarcará y si alguno de los modelos es aceptable en el marco de la misma. El estado de seguridad sigue sin resolverse para ambos modelos.
- Fechas concretas para la migración de 12 semanas y la prueba piloto de 30 días.
- Un recuento de palabras objetivo aprobado para la redacción de textos extensos. Sin él, no se puede evaluar el comentario de las partes interesadas de que el texto es "demasiado largo".
- Precios, resultados de pruebas comparativas, límites de contexto y capacidades del producto para Claude Opus 5.5 y GPT-6 Sol. No se facilita ninguna información al respecto, y este memorándum no da nada por sentado.
- Quiénes son los revisores humanos, cuántos hay y cómo se resolverán los desacuerdos entre ellos.
- Qué datos podrá utilizar la prueba piloto antes de que se complete la revisión de seguridad.

**Supuestos.** Se trata de propuestas formuladas en este memorándum, no de datos del expediente, y cada una de ellas requiere la aprobación del equipo:

- El programa piloto puede utilizar material no sensible o sintético hasta que la revisión de seguridad autorice el uso de datos reales.
- Se puede ocultar a los revisores qué modelo ha generado cada resultado.
- El equipo puede elaborar un conjunto fijo de indicaciones para cada carga de trabajo que represente las tareas reales del Proyecto North.
- Los umbrales de aprobación que se proponen a continuación son puntos de partida que el equipo puede modificar antes de que comience el programa piloto, pero no durante el mismo.

## Programa piloto de 30 días

**Diseño**

1.
GPT-6 Sol · salida completa devuelta
## Recomendación ejecutiva

No elijas todavía Claude Opus 5.5 ni GPT-6 Sol. El Proyecto North consiste en una migración de 12 semanas para un equipo de 40 personas, y el paquete no proporciona resultados controlados de ninguno de los dos modelos. Por lo tanto, sirve de base para un plan de comparación, no para un veredicto sobre el rendimiento. Ejecute la prueba piloto de 30 días disponible con indicaciones idénticas y revisión humana; a continuación, tome una decisión auditable basándose en los criterios acordados antes de examinar los resultados. Elija cualquiera de los modelos solo si su trabajo revisado satisface las necesidades del equipo, su uso se ajusta al acuerdo financiero aprobado y la revisión de seguridad pendiente permite su adopción. Si no se cumplen esas condiciones, aplace la selección en lugar de considerar una comparación incompleta como un éxito.

El presupuesto de migración aprobado es de $48 000. El expediente no indica si el uso del modelo entra dentro de ese presupuesto. No hay una fecha prevista para la revisión de seguridad. Esas son limitaciones a la hora de tomar una decisión tanto para Claude Opus 5.5 como para GPT-6 Sol, no argumentos para favorecer a uno sobre el otro.

## Lo que respaldan las pruebas

**Observado:** El equipo necesita síntesis de investigación, redacción de textos extensos, revisión de código y extracción estructurada de JSON. Desea una opción auditable y puede llevar a cabo una prueba piloto de 30 días utilizando indicaciones idénticas y revisión humana. Una de las partes interesadas afirma que el borrador actual es demasiado largo, pero no se ha aprobado ningún número objetivo de palabras. Esa observación identifica un problema que hay que comprobar en los resultados escritos; no establece un modelo preferido ni una longitud aceptable.

La tabla de puntuación actual, organizada por tareas, no incluye deliberadamente una clasificación:

| Línea de trabajo | Claude Opus 5,5 | GPT-6 Sol | Evidencia del programa piloto que se debe recopilar |
|---|---|---|---|
| Síntesis de investigación | Aún no probada | Aún no probada | Precisión, cobertura y trazabilidad valoradas por los revisores |
| Redacción extensa | Aún no probada | Aún no probada | Utilidad, claridad y concisión valoradas por los revisores |
| Revisión de código | Aún no probada | Aún no probada | Hallazgos verificados por los revisores y afirmaciones sin fundamento |
| JSON estructurado | Aún no probada | Aún no probada | Resultados válidos y extracción correcta de campos |

**Supuesto para la planificación, no un resultado observado:** Unas muestras de trabajo comparables y una rúbrica de revisión común pueden revelar diferencias relevantes para el Proyecto North. La prueba piloto debería comprobar ese supuesto. Las instrucciones idénticas por sí solas no harán que la elección sea auditable: el equipo también debe conservar las entradas, ambas salidas, los criterios de revisión, los juicios de los revisores y los motivos de cualquier exclusión o repetición. La revisión humana debe aplicar el mismo estándar a cada modelo.

En el caso de los textos extensos, los evaluadores deben distinguir entre “demasiado largo” y “no útil”. Una respuesta más breve podría omitir información necesaria; una respuesta más larga podría seguir siendo clara y útil. Dado que no se ha aprobado un número de palabras objetivo, el proyecto piloto puede registrar la extensión y los juicios de los evaluadores, pero no debe declarar retroactivamente un número arbitrario de palabras como criterio de aceptación. La misma disciplina se aplica al resto de tareas: registrar lo que los revisores observaron, en lugar de convertir las preferencias en afirmaciones sobre la capacidad general del modelo.

## Donde faltan pruebas

**Desconocido:** El paquete no contiene resultados controlados de Claude Opus 5.5 ni de GPT-6 Sol. No establece ninguna calidad relativa, fiabilidad o idoneidad para ninguna de las cuatro líneas de trabajo. Tampoco proporciona precios, límites de contexto, puntos de referencia ni información sobre la capacidad del producto. Por consiguiente, este memorándum no puede estimar el coste de uso ni deducir qué modelo funcionaría mejor con el material del Proyecto North.

Es necesario aclarar los límites presupuestarios antes de tomar una decisión de compra. El $48 000 es el presupuesto aprobado para la *migración*; no se especifica si el uso del modelo debe pagarse con cargo a dicho presupuesto. Considerarlo como incluido o como un gasto adicional crearía una hipótesis financiera que el paquete no respalda. El equipo debe documentar la respuesta y la vía de aprobación aplicable antes de comprometerse a un uso continuado.

La seguridad tampoco está resuelta para ninguno de los dos candidatos. No se ha programado el calendario de la revisión de seguridad y el expediente no ofrece ningún resultado en materia de seguridad. Un resultado sólido de la fase piloto no resolvería esa situación. El equipo debería identificar quién puede programar y decidir la revisión, qué información necesita el revisor y si la propia actividad piloto está permitida según las normas aplicables; el expediente no responde a esas preguntas. No se facilitan fechas de inicio ni de finalización para la migración, la prueba piloto ni la revisión de seguridad, por lo que el equipo no debe dar a entender que se tomará una decisión sobre seguridad dentro del plazo de los 30 días de la prueba piloto o de las 12 semanas de la migración.

## Prueba piloto de 30 días

Antes de la primera comparación, el equipo debe seleccionar indicaciones representativas para las cuatro líneas de trabajo, definir el formato esperado de cada respuesta y acordar una rúbrica para la revisión humana. Ambos modelos deben recibir indicaciones idénticas y las mismas instrucciones de revisión. Los revisores deben basar sus valoraciones en el trabajo en sí, y no en la reputación del modelo. Conserven la indicación, el resultado, la revisión y cualquier corrección solicitada, de modo que un lector posterior pueda reconstruir cada valoración. Registren las desviaciones respecto al proceso habitual, en lugar de descartar en silencio los casos difíciles.

Utilicen tres criterios de evaluación cuantificables:

1. **Calidad de la tarea revisada:** Para la síntesis de investigaciones, la redacción de textos extensos y la revisión de código, contabiliza la proporción de resultados que los revisores aceptan para la tarea indicada. Anota también por separado los motivos de rechazo —por ejemplo, cobertura insuficiente, redacción poco clara o un hallazgo no verificado en la revisión de código—. Presenta los resultados por línea de trabajo y modelo, no solo como una puntuación global.
2. **Fiabilidad del JSON estructurado:** Cuenta los resultados que coinciden con la estructura acordada y aquellos cuyos campos extraídos un revisor verifique como correctos. Informa de ambas tasas para Claude Opus 5.5 y GPT-6 Sol; una respuesta estructuralmente válida no debe contarse como precisa únicamente porque se analice sintácticamente.
3. **Esfuerzo de revisión y trazabilidad:** Registra el tiempo dedicado por el revisor a comprobar y, cuando sea necesario, corregir cada resultado. Cuenta los casos en los que no se haya conservado suficiente evidencia para explicar la decisión del revisor. Compara estas medidas en el mismo conjunto de indicaciones, incluyendo los casos en los que ninguno de los resultados sea aceptable.

Acordad los criterios de aceptación y cómo se gestionarán los empates antes de examinar los resultados de la prueba piloto; el paquete no proporciona ningún punto de referencia a partir del cual derivar umbrales numéricos. Al cabo de 30 días, publicad la rúbrica, los recuentos, los motivos de los revisores y las cuestiones sin resolver. **Condición de parada:** suspender la adopción si no se pueden cumplir los requisitos de seguridad para la prueba piloto o el uso posterior, o si el equipo no puede establecer un presupuesto válido y una vía de aprobación. No sustituir ninguna de estas autorizaciones por puntuaciones de calidad favorables.

## Regla de decisión

Selecciona Claude Opus 5.5 si los resultados de su prueba piloto cumplen los estándares acordados previamente, son sustancialmente más sólidos en las líneas de trabajo que el equipo prioriza y se han resuelto sus condiciones de seguridad y financieras. Aplica exactamente la misma regla a GPT-6 Sol. Si ambos cumplen los estándares sin diferencias sustanciales ni relevantes, decide basándote en las prioridades documentadas del proyecto y en las limitaciones resueltas, en lugar de proclamar un ganador en cuanto al rendimiento. Si ninguno cumple los requisitos —o si el límite presupuestario o el estado de seguridad siguen sin resolverse—, no realices aún la selección del modelo. Ese resultado preserva una decisión auditable para el equipo de 40 personas sin afirmar más de lo que las pruebas pueden respaldar.
Metadatos: Claude — HTTP 200 · 25,98 s · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27,763 s · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
Síntesis de fuentes
Tarea de investigación
Síntesis de fuentes: empate
Ambos modelos resolvieron el conflicto de fechas fijándolo en el 15 de octubre, mantuvieron el presupuesto acordado de $12 000 y consideraron que la afirmación de que “siempre es exacto” era una afirmación del responsable sin fundamento. El resultado es un empate en esta tarea.
| Medida | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Puntuación | 9.5 / 10 | 9.5 / 10 |
| Gestión de conflictos | S2 controla el plazo | S2 controla el plazo |
| Afirmación sin fundamento | Marcado como «sin soporte» | Marcado como «sin soporte» |
| Diferencia práctica | Explicación más detallada de los riesgos | Una recomendación más concisa |
Entrada completa compartida
Concilia las notas de origen que figuran a continuación. Entrega (1) una tabla en formato Markdown con las columnas “Afirmación”, «Fuente de referencia», «Estado» y «Motivo», y (2) una recomendación de unas 250 palabras. Utiliza como fuente de referencia la nota normativa de fecha más reciente únicamente en lo que respecta al conflicto de plazos. Marca las afirmaciones sin fundamento como «sin fundamento». No añadas datos.

[S1 01/09/2026] El programa piloto finaliza el 30 de septiembre. El presupuesto es de $12 000.
[S2 03/09/2026] El programa piloto finaliza el 15 de octubre. El presupuesto sigue siendo de $12.000.
[S3 02/09/2026] El departamento jurídico no ha aprobado el intercambio de datos externos.
[S4 04/09/2026] Un responsable afirma que el modelo es «siempre preciso»; no se adjunta ninguna prueba de validación.
[S5 04/09/2026] El equipo del proyecto piloto cuenta con 8 miembros.
[S6 05/09/2026] El memorándum de decisión debe enumerar los riesgos pendientes.

Envía únicamente la tabla y la recomendación.
Claude Opus 5,5 · salida completa
| Afirmación | Fuente de referencia | Estado | Motivo |
|---|---|---|---|
| El programa piloto finaliza el 30 de septiembre | S2 (03/09/2026) | Derogada | Entra en conflicto con S2. La nota con fecha posterior prevalece en el conflicto de plazos. |
| El programa piloto finaliza el 15 de octubre | S2 (03/09/2026) | Respetada (prevalente) | Se trata de la nota con fecha más reciente sobre el conflicto de plazos, por lo que prevalece sobre S1. |
| El presupuesto es de $12 000 | S1 y S2 | Respaldado | Ambas fuentes coinciden, y S2 afirma que el presupuesto "sigue siendo" de $12 000. No hay conflicto. |
| El departamento jurídico no ha aprobado el intercambio de datos externos | S3 | Respaldado | Se afirma directamente y no se contradice con ninguna otra fuente. |
| El modelo es "siempre preciso" | S4 | No respaldado | Se trata de una afirmación de un directivo sin pruebas que la respalden. |
| El equipo piloto cuenta con 8 miembros | S5 | Justificado | Se afirma directamente y no se contradice. Procede de una única fuente. |
| El memorándum de decisión debe enumerar los riesgos pendientes | S6 | Justificado | Se trata de un requisito establecido para el memorándum y no se contradice. |

**Recomendación**

El memorándum de decisión debería utilizar el 15 de octubre como fecha de finalización de la fase piloto. S2 es la nota de fecha más reciente y resuelve el conflicto de plazos, por lo que prevalece sobre la fecha del 30 de septiembre que figura en S1. La regla de la fecha más reciente se aplica únicamente a este conflicto. Las demás afirmaciones se han evaluado en función de sus propios fundamentos.

El presupuesto debe registrarse como $12 000. S1 y S2 coinciden en esta cifra, por lo que no es necesaria ninguna conciliación. También puede incluirse el tamaño del equipo, de ocho miembros. Se basa únicamente en S5, pero ninguna fuente lo contradice.

El documento S6 exige que el memorándum enumere los riesgos no resueltos, y las notas respaldan al menos dos de ellos.

- **Intercambio de datos externos:** El departamento jurídico no lo ha aprobado (S3). El memorándum debe indicarlo claramente. No debe dar a entender que el intercambio de datos externos está permitido durante la fase piloto.
- **Precisión del modelo:** La afirmación de que el modelo es "siempre preciso" carece de fundamento. S4 señala que no se adjunta ninguna prueba de las pruebas realizadas y registra la afirmación únicamente como una declaración del responsable. El memorándum no debería presentarla como una conclusión ni basarse en ella para justificar decisiones. Debería indicar que la precisión del modelo no ha sido verificada hasta que se aporten pruebas que la respalden.

Por último, el memorándum debería señalar brevemente que la fecha de finalización del proyecto piloto cambió entre S1 y S2. Es posible que los lectores encuentren en otros lugares la fecha anterior, el 30 de septiembre, y esta nota explicaría por qué se utiliza el 15 de octubre. El memorándum no debería añadir explicaciones sobre el cambio, resultados de pruebas ni actualizaciones sobre la situación jurídica, ya que nada de ello aparece en las notas originales.
GPT-6 Sol · salida completa
| Afirmación | Fuente de referencia | Estado | Motivo |
|---|---|---|---|
| El programa piloto finaliza el 30 de septiembre. | S2 (03/09/2026) | Derogado | La nota con fecha posterior resuelve el conflicto de plazos y establece el 15 de octubre. |
| El programa piloto finaliza el 15 de octubre. | S2 (03/09/2026) | Respetada | S2 establece el plazo definitivo. |
| El presupuesto es de $12 000. | S1 y S2 | Respetada | Ambas notas indican la misma cantidad. |
| El departamento jurídico no ha aprobado el intercambio de datos externos. | S3 | Respalda | S3 lo afirma directamente; ninguna nota posterior aborda dicha aprobación. |
| El modelo es “siempre preciso”. | S4 | No respalda | Un responsable hace esta afirmación, pero no se adjunta ninguna prueba que la respalde. |
| El equipo piloto cuenta con 8 miembros. | S5 | Justificado | S5 indica el tamaño del equipo. |
| El memorándum de decisión debe enumerar los riesgos pendientes. | S6 | Justificado | S6 establece este requisito. |

**Recomendación:** Utilizar el 15 de octubre como fecha de finalización de la fase piloto en el memorándum de decisión. S2 es posterior a S1 y resuelve el conflicto entre sus plazos. Mantener el presupuesto en $12 000: las notas coinciden en esa cantidad, por lo que el cambio de plazo no ofrece motivos para modificarlo. Anote el tamaño del equipo del proyecto piloto como 8 miembros, tal y como se indica en S5.

Enumere explícitamente los riesgos pendientes, tal y como exige S6. El memorándum debe indicar que el departamento jurídico no ha aprobado el intercambio de datos externos, sin dar a entender que dicha aprobación se haya concedido desde entonces ni que el intercambio esté permitido. También debe distinguir entre la afirmación del responsable sobre la precisión y una conclusión contrastada. El S4 recoge la afirmación de que el modelo es “siempre preciso”, pero no aporta pruebas de las pruebas realizadas. No se debe presentar esa afirmación como un resultado verificado.

Limitar la conciliación. El S2 resuelve las fechas de finalización contradictorias; no sustituye a las notas independientes sobre el departamento jurídico, la precisión, el tamaño del equipo o los requisitos del memorándum. Cuando las notas no establezcan un resultado, déjelo sin resolver en lugar de aportar una suposición. En particular, el registro no respalda ni la afirmación de que se haya aprobado el intercambio de datos externos ni la de que se haya demostrado la exactitud del modelo.

Por lo tanto, el memorándum resultante puede utilizar el plazo del 15 de octubre y el presupuesto de $12 000, al tiempo que identifica las dos lagunas de evidencia evidentes en estas notas: la aprobación legal pendiente para el intercambio de datos externos y la ausencia de pruebas que respalden la afirmación sobre la precisión.
Metadatos: Claude — HTTP 200 · 12,846 s · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12,322 s · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
Codificación y salida estructurada
La diferencia en la codificación radicaba en la explicación
Condición de filtrado original: si t
Un elemento «None» se considera falso, por lo que este filtro ya lo omite.
Ambos modelos devolvieron un JSON válido con las cuatro claves solicitadas y el mismo parche mínimo. Claude describió correctamente el filtro existente; GPT-6 Sol afirmó erróneamente que un elemento «None» provocaría un error. Ese error de diagnóstico concreto es relevante a la hora de que un revisor decida si un parche soluciona el fallo real.
Claude proporcionó una lista de riesgos y Sol proporcionó una breve cadena de riesgos. Las instrucciones no exigían un tipo concreto para ese campo, por lo que esta diferencia no supone un incumplimiento del contrato. La puntuación de la tarea de Sol es de 9,0/10 tras corregir la deducción anterior de medio punto, que carecía de fundamento; se mantiene la deducción por inexactitud factual.
Tarea de codificación
Codificación y resultado estructurado: Claude Opus 5.5 fue más preciso
Ambos modelos devolvieron un JSON válido con las claves solicitadas y el mismo parche mínimo. Claude explicó correctamente que el filtro original ya omite un Ninguno elemento. GPT-6 Sol afirmó erróneamente que un Ninguno ese elemento provocaría un error. La indicación no exigía un tipo concreto para el campo «riesgos».
| Medida | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Puntuación | 10.0 / 10 | 9.0 / 10 |
| Parche | Correcto y conciso | Correcto y conciso |
| Diagnóstico | Aísla correctamente ambos defectos | Exagera el fallo del elemento «None» |
| Contrato JSON solicitado | JSON válido; las cuatro claves están presentes | JSON válido; las cuatro claves están presentes |
Entrada completa compartida
Devuelve únicamente un JSON estricto con las claves 'diagnosis', 'patch' y 'tests, risks'. Analiza y aplica los cambios mínimos necesarios a esta función de Python para que los tres casos se superen. El parche debe mantener la firma de la función.

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

Casos:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

No ejecutes código ni incluyas bloques de Markdown ni texto fuera del JSON.
Claude Opus 5,5 · salida completa
{"diagnosis":"Dos errores, detectados al leer el código (sin ejecutarlo). (a) Caso 2: cuando `tags` es `None`, el generador itera sobre `None` y lanza un `TypeError` en lugar de devolver `''`. (b) Caso 3: el filtro `if t` se ejecuta antes de la eliminación de espacios en blanco. La etiqueta que solo contiene espacios en blanco ' ' se considera verdadera, por lo que pasa y se convierte en ''. El resultado es sorted(['', 'seo']), que se une a ',seo' en lugar de a 'seo'. El elemento None del caso 3 ya se descarta mediante 'if t'. El caso 1 ya funciona: 'AI', 'ai' y 'Code' se normalizan a {'ai', 'code'}, lo que da como resultado 'ai,code'.','patch":"def normalize_tags(tags):\n return ",".join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))','tests":["assert normalize_tags([" AI ", 'ai', 'Code']) == 'ai,code' # rastreado: {'ai','code'} -> 'ai,code'','assert normalize_tags(None) == "" # rastreado: (None or []) -> [] -> ''','assert normalize_tags([" ", None, 'SEO']) == 'seo' # rastreado: ' ' falla en t.strip(), None falla en t, 'SEO' -> 'seo''],'riesgos":["Los elementos que no sean cadenas, como 123, provocarán un AttributeError en .strip(). Esto no ha cambiado con respecto al comportamiento original.",""tags o []" trata cualquier entrada que devuelva falso (por ejemplo, '' o una tupla vacía) como vacía. Esto es coherente con el comportamiento requerido de None -> ''.','Si se pasa una sola cadena en lugar de un iterable de etiquetas, se itera carácter por carácter. Esto no ha cambiado con respecto al comportamiento original.","Los espacios en blanco internos no se fusionan, por lo que "machine learning" y 'machine learning' siguen siendo etiquetas distintas.','Las pruebas se obtuvieron únicamente mediante el seguimiento manual y no se ejecutaron, tal y como se indicó."]}GPT-6 Sol · salida completa
{"diagnosis":"La función genera un error cuando `tags` es `None` o contiene `None`, y conserva las entradas que quedan vacías tras la eliminación de espacios.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI", "ai", "Code"],"expected":"ai,code"},{"input":null,"expected":""},{"input":[" ", null, "SEO"],"expected":"seo"}],"risks":"No se ha ejecutado. Se supone que las entradas que no son None son cadenas."}Metadatos: Claude — HTTP 200 · 10,832 s · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7,71 s · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
Veredicto final
Una opción práctica
¿Qué modelo se adapta mejor a tu trabajo?
GPT-6 Sol encabeza este pequeño conjunto de resultados iniciales porque completó el contrato de formato largo modificado, mientras que Claude Opus 5.5 alcanzó el límite compartido de 2.400 tokens por salida. Claude Opus 5.5 lidera la tarea de código/JSON en cuanto a precisión diagnóstica. En síntesis de código hay un empate.
Elija GPT-6 Sol cuando la prioridad inmediata sea completar de una sola vez un documento de decisión extenso y con múltiples restricciones. Elige Claude Opus 5,5 cuando la revisión de código o de salida estructurada se beneficia de un diagnóstico más explícito y de un inventario de riesgos. Si tu trabajo combina ambos aspectos, asigna cada tarea al modelo que mejor se adapte a ella, en lugar de imponer un único modelo universal.
GlobalGPT te ofrece una forma práctica de mantener tanto los modelos como el resto de tu flujo de trabajo de IA en un único panel de control. La investigación, la redacción, la programación, las imágenes, los vídeos y el trabajo de producción conectado a la interfaz de línea de comandos pueden permanecer en el mismo entorno de trabajo.
Preguntas frecuentes
¿Qué modelo salió ganador en la comparativa?
GPT-6 Sol lideró el pequeño conjunto de resultados iniciales por 28,5 a 26,5 tras excluir la tarea de límites original y corregir la deducción del contrato JSON. Esa ventaja se debió a la finalización del contrato revisado en formato extenso bajo el mismo límite de salida de 2.400 tokens; Claude Opus 5.5 lideró la tarea de código y salida estructurada, mientras que en la síntesis de código fuente hubo un empate.
¿Por qué se excluyó la primera prueba de formato extenso?
La pregunta original no mencionaba a ninguno de los dos modelos. Ambos modelos se negaron correctamente a adivinar las identidades que faltaban, por lo que esa respuesta comprueba si un modelo solicita el contexto que le falta en lugar de fingir que lo sabe.
¿Es el Claude Opus 5.5 mejor para la codificación?
En esta tarea de codificación y JSON, el Claude Opus 5.5 proporcionó un diagnóstico más preciso y una lista de riesgos estructurada. Una sola tarea no basta para establecer una clasificación universal de codificación.
¿Es GPT-6 Sol mejor para escribir?
GPT-6 Sol completó el memorándum extenso revisado dentro del alcance solicitado en la primera respuesta. El resultado respalda esa recomendación de flujo de trabajo para esta prueba, no una afirmación general sobre todas las tareas de redacción.
¿Puedo probar ambos modelos sin tener que cambiar de plataforma?
GlobalGPT está concebido como una suscripción de IA multimodelo que reúne múltiples funciones de IA en un único panel de control. Resulta útil para ejecutar el mismo paquete de indicaciones de investigación, redacción y programación en distintos modelos y mantener el flujo de trabajo en un solo lugar.
GlobalGPT te permite mantener tanto los modelos como el resto de tu flujo de trabajo de IA en un solo lugar. Empieza con el modelo que mejor se adapte a la tarea inmediata y, a continuación, avanza en el proceso a través de las fases de investigación, redacción, programación, imágenes, vídeo o producción conectada a la interfaz de línea de comandos (CLI), sin necesidad de abrir un servicio independiente para cada parte.









