
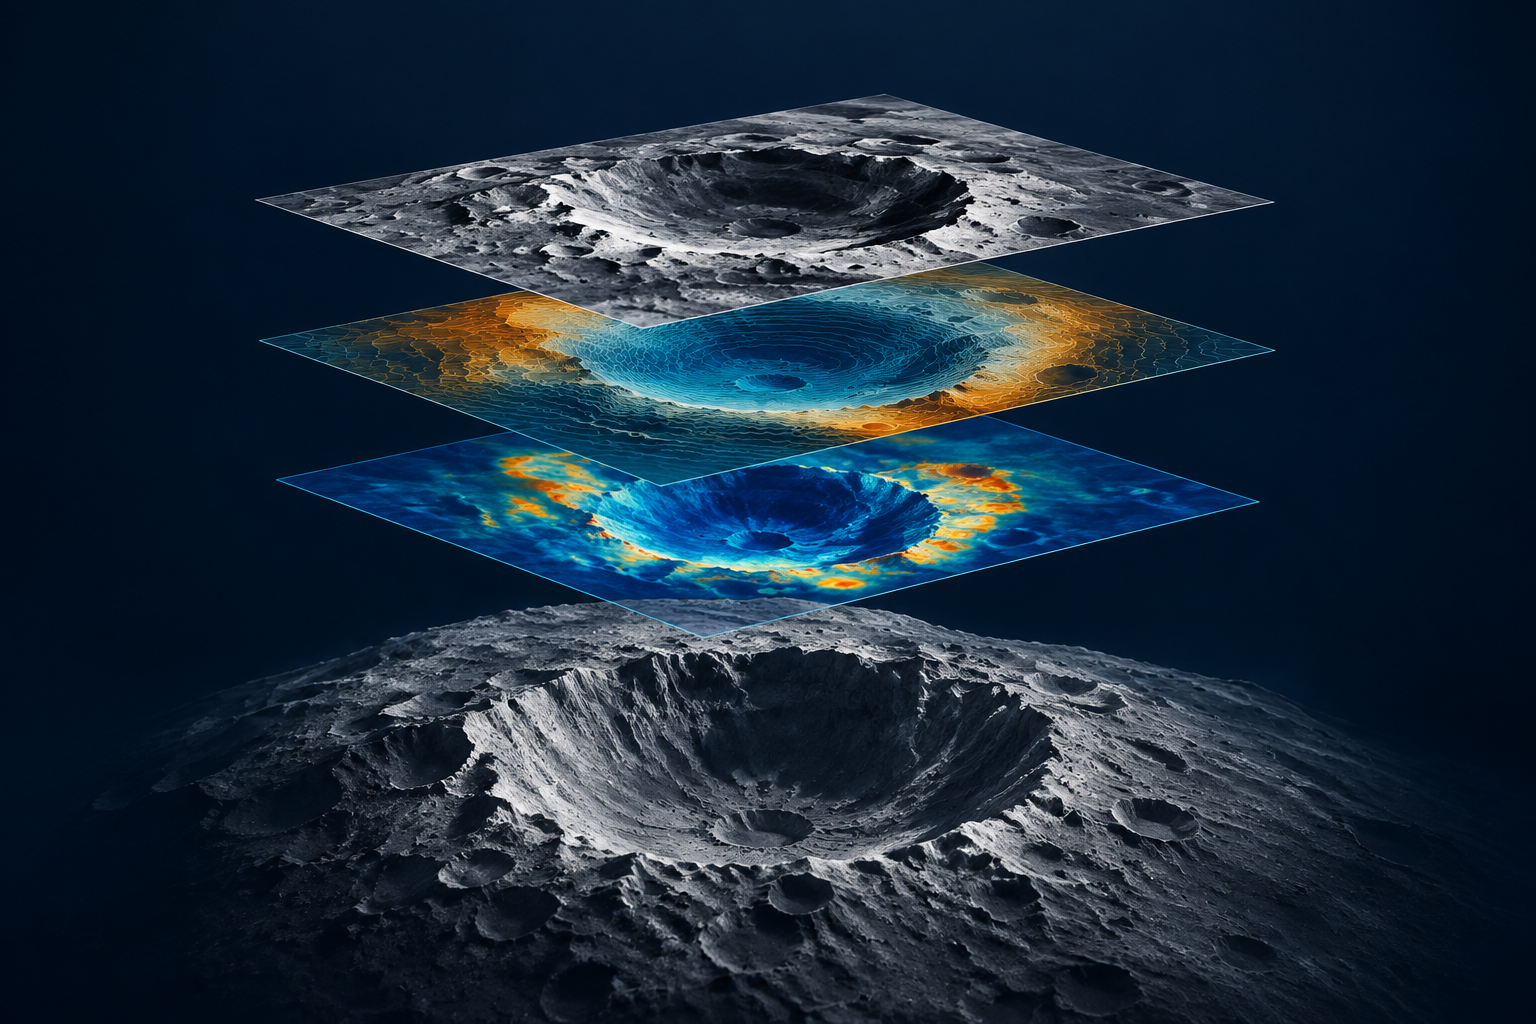
El modelo «Lunar Foundation Model» de la NASA e IBM es un modelo de inteligencia artificial de código abierto destinado al análisis de observaciones lunares. Anunciado el 10 de septiembre de 2026, puede adaptarse para detectar cráteres, delinear formaciones volcánicas y predecir patrones en un mapa de prospectividad de hielo. Las ventajas que se le atribuyen se refieren a parámetros de referencia específicos de la investigación: el resultado principal en relación con el hielo es un menor error de predicción, no el descubrimiento de 22% más agua en la Luna.
Para los estudiantes e investigadores, los puntos de partida más útiles son los ficha oficial del modelo, el informe técnico y el código publicado. En conjunto, explican qué ha aprendido el modelo, qué tareas se han evaluado y qué se necesitaría para crear tu propio experimento.
Si lo primero que tienes que hacer es comprender el estudio, GlobalGPT Reúne la búsqueda de fuentes, el análisis de documentos, el razonamiento y la redacción en un único espacio de trabajo multimodelo. Ofrece una forma asequible de pasar de términos científicos desconocidos a un resumen de investigación claro mediante una única suscripción.

¿Qué es el Modelo de Base Lunar de la NASA e IBM?
El comunicado de la NASA presenta el proyecto como un modelo base para la ciencia lunar, desarrollado en colaboración con IBM. Un modelo base aprende patrones reutilizables a partir de una amplia recopilación de datos; a continuación, los investigadores adaptan esos patrones a una tarea más específica. En este caso, el material son datos de teledetección lunar, en lugar del lenguaje cotidiano.
El LFM de la NASA e IBM utiliza un codificador y un decodificador de tipo «vision transformer», con una arquitectura ViT-B. Entre sus entradas se incluyen imágenes y otros productos de observación con diferentes resoluciones espaciales. Un científico puede adaptar la representación resultante para la detección, la segmentación o la regresión: tres formas de localizar objetos, delimitar regiones y predecir valores numéricos.
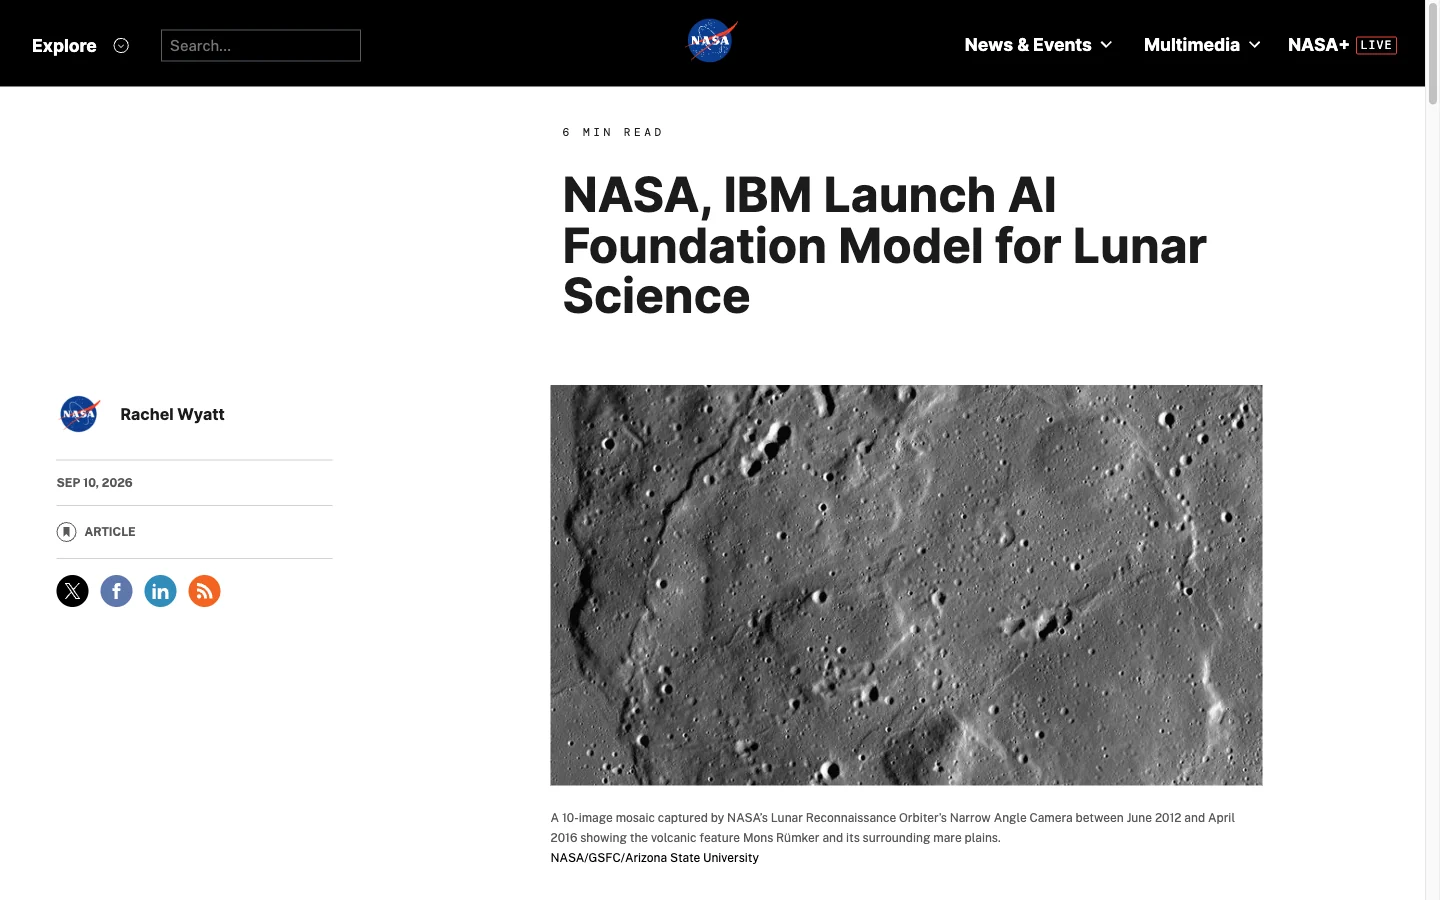
Esto hace que esta versión resulte útil para los equipos que trabajan con mapas lunares y para los estudiantes que se dedican al aprendizaje automático planetario. También merece la pena consultar el proyecto para cualquiera que quiera comprender cómo se evalúa un modelo científico de IA. Sin embargo, el uso de su punto de control forma parte de un flujo de trabajo de investigación informática, más que de una conversación por chat.
¿De qué datos aprende?
En ficha del modelo describe los datos de entrenamiento de SomBench: 963.609 conjuntos de mosaicos de cámara de gran angular (WAC) y 1.000.113 conjuntos de cámara de ángulo estrecho (NAC). La escala de la WAC es de unos 100 metros por píxel; la de la NAC, de aproximadamente 1 metro por píxel. Esto proporciona al modelo tanto un contexto del terreno más amplio como detalles de la superficie mucho más precisos, a través de unos dos millones de conjuntos de mosaicos.
IBM describe el recurso de datos en su conjunto que consta de más de 30 capas alineadas procedentes de nueve instrumentos de cuatro misiones. La ficha del modelo especifica 11 modalidades de entrada. Estas figuras describen las diferentes etapas del proceso de tratamiento de datos: capas de origen, ejemplos de entrenamiento empaquetados y tipos de entrada que codifica el modelo.
Un proyecto, tres unidades de medida diferentes
IBM describe un conjunto de datos recopilados a partir de nueve instrumentos de cuatro misiones diferentes.
Los 963.609 paquetes WAC y los 1.000.113 paquetes NAC ofrecen dos niveles de material formativo.
El modelo codifica diferentes tipos de observaciones, entre las que se incluyen imágenes y productos topográficos.
Las capas de origen, los paquetes de mosaicos y las modalidades de entrada se cuentan de forma diferente. Fuentes: Descripción del conjunto de datos de IBM y el ficha oficial del modelo.
La iluminación también forma parte del diseño. El modelo recibe la geometría de observación, incluidos los ángulos de iluminación, como contexto explícito. Esto ayuda a distinguir el aspecto que tiene una superficie bajo una iluminación concreta de los patrones del terreno subyacentes que está aprendiendo.
Un píxel que representa aproximadamente 100 metros de terreno no puede revelar los mismos detalles que un píxel que representa aproximadamente 1 metro. Por eso, los resultados de los cráteres obtenidos con WAC y NAC merecen una atención especial. Una mejora en las imágenes a gran escala no implica la misma mejora en los pequeños accidentes del relieve.
El proyecto sigue el enfoque de preentrenamiento de TerraMind, pero se entrena a partir de datos lunares desde cero. Por lo tanto, debe entenderse como un modelo creado para observaciones lunares, y no como un punto de referencia de observación de la Tierra con un nuevo nombre. La cuestión relevante es cómo la representación que ha aprendido contribuye a una tarea lunar concreta.
Tres tareas que puede realizar
Las evaluaciones publicadas abarcan tres grupos de tareas. Cada uno de ellos genera un tipo diferente de respuesta, por lo que el significado de “mejor” varía en función de la tarea.
| Tarea | Salida | Lo que el resultado puede respaldar |
|---|---|---|
| Detección de cráteres | Cajas delimitadoras alrededor de los cráteres en imágenes WAC o NAC | Comparación de la eficacia de un detector a la hora de detectar y localizar cráteres marcados. |
| Segmentación irregular de la mancha de la yegua | Un esquema a nivel de píxel de las características de la superficie volcánica | Analizar en qué medida las regiones predichas coinciden con los límites de las características etiquetadas. |
| Regresión de la prospectividad de los hielos polares | Una predicción continua de un mapa de prospectividad basado en el conocimiento | Análisis de la concordancia con un objetivo modelizado para posibles condiciones relacionadas con el hielo. |
La detección de cráteres y la segmentación de características volcánicas pueden ayudar a los investigadores a organizar y analizar las imágenes. Su utilidad depende de las etiquetas, la escala y el área de evaluación. Un modelo que funcione bien en un conjunto de prueba definido aún debe someterse a una evaluación con los datos y la cuestión científica de un nuevo proyecto.
La prospectividad del hielo requiere una interpretación muy cuidadosa. El objetivo es elaborar un mapa basado en los conocimientos que indique dónde podría haber hielo, no realizar una medición directa de los depósitos de hielo. Una mayor concordancia con ese mapa puede servir de apoyo a la investigación sobre patrones y regiones candidatas. No nos indica que se haya encontrado una cantidad adicional de agua.
Qué significan los resultados de las pruebas de rendimiento
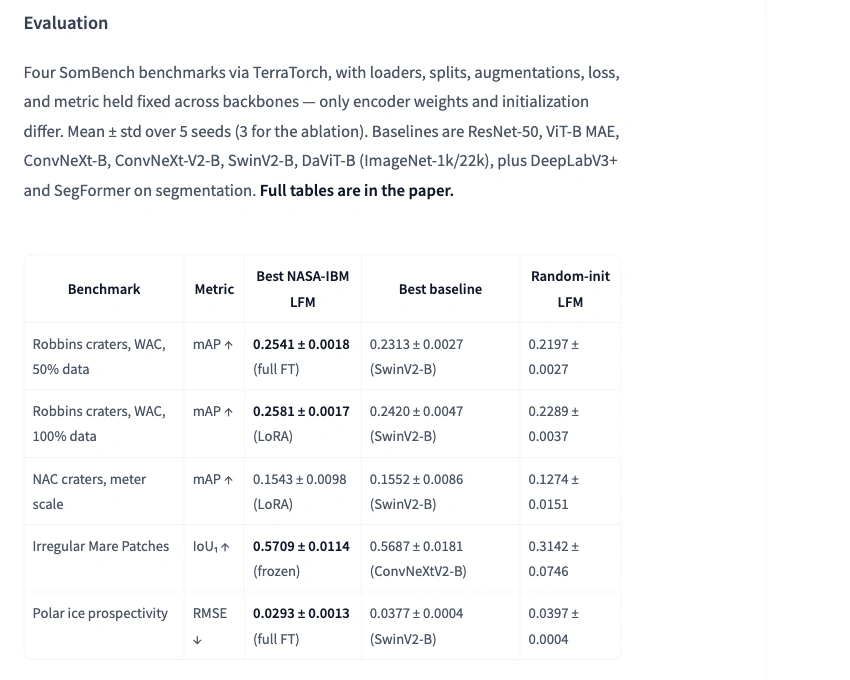
En informe técnico ofrece las medias y las desviaciones estándar obtenidas con cinco semillas aleatorias. Sus resultados comparan configuraciones adaptadas del modelo lunar con modelos de visión de referencia específicos. Hemos comprobado las tablas publicadas; no hemos reproducido los experimentos del modelo lunar.
Las métricas responden a diferentes preguntas. La precisión media (mAP) evalúa la detección de objetos; la intersección sobre la unión (IoU) mide el solapamiento entre las regiones predichas y las etiquetadas; el error cuadrático medio (RMSE) mide el error numérico de predicción. Cuanto más altos sean los valores de mAP e IoU, mejor, mientras que cuanto más bajo sea el RMSE, mejor. No deben combinarse en una única puntuación de precisión.
Error de prospectividad del hielo: la mejora más evidente de las registradas
El RMSE descendió desde De 0,0377 a 0,0293 contra SwinV2-B, un 22,31 TP40T: reducción relativa. Un RMSE más bajo indica una mayor concordancia con el mapa de prospectividad glaciar de referencia.
RMSE: cuanto menor, mejor. Las barras comienzan en cero. Media ± desviación estándar de cinco semillas. El objetivo es un mapa de prospectividad modelizado, no una medición del hielo.
| Tarea y datos | Sistema métrico ↑ | Modelo lunar | Una base sólida |
|---|---|---|---|
| Cráteres WAC · Datos de entrenamiento 50% | mAP | 0,2541 ± 0,0018 ajuste completo | 0,2313 ± 0,0027 SwinV2-B |
| Cráteres WAC · Datos de entrenamiento 100% | mAP | 0,2581 ± 0,0017 LoRA | 0,2420 ± 0,0047 SwinV2-B |
| Cráteres del NAC · Datos de entrenamiento 100% | mAP | 0,1543 ± 0,0098 LoRA | 0,1552 ± 0,0086 SwinV2-B |
| Manchas irregulares en la yegua | IoU1 | 0,5709 ± 0,0114 codificador bloqueado | 0,5687 ± 0,0181 ConvNeXtV2-B |
Los autores describen los resultados relativos a los cráteres y las formaciones volcánicas a escala métrica como comparables a unas referencias sólidas. Sus pequeñas diferencias deben interpretarse teniendo en cuenta la variación entre series de mediciones.
Fuente: Informe técnico de la NASA e IBM, Tablas 4 a 7, páginas 16 y 18. Se trata de los resultados de los autores, no de una reproducción independiente.
El resultado del 22% en «ice» supone una reducción del error
En cuanto al potencial de hielo, la configuración lunar más sólida de las registradas presenta un RMSE de 0,0293, frente al 0,0377 de SwinV2-B. El cálculo es el siguiente: (0,0377 − 0,0293) ÷ 0,0377 × 100 = 22,3%. El RMSE mide el error de predicción con respecto al mapa de referencia; cuanto menor sea, mejor. Este porcentaje no es ni una puntuación de precisión ni un cambio en la cantidad de hielo lunar.
Los resultados de Crater dependen de la métrica y de la escala de datos
Con 50% de los datos de entrenamiento del WAC, el modelo lunar registra un mAP de 0,2541 frente al 0,2313 de SwinV2-B. Ese mismo resultado del modelo lunar también supera el 0,2420 de la línea de base con 100% de datos de entrenamiento. La primera comparación utiliza fracciones de datos iguales; la segunda es una prueba de la eficiencia de las etiquetas en este experimento concreto.
La mejora de aproximadamente 19% de IBM en el cráter puede conciliarse con los valores de AP@75 del informe con datos de entrenamiento de 50%: 0,2213 frente a 0,1862, lo que supone un aumento relativo de 18,9%. AP@75 evalúa las detecciones con un umbral de solapamiento concreto. No debe reinterpretarse como un aumento de 19% en la métrica mAP de la tabla.
En la escala NAC más detallada, el mAP del modelo lunar es de 0,1543 y el del modelo de referencia, de 0,1552. En el caso de «Irregular Mare Patches», los valores de IoU en primer plano comunicados son 0,5709 y 0,5687 frente a ConvNeXtV2-B. Los autores describen estas tareas como comparables a modelos de referencia sólidos. Las pequeñas diferencias, junto con la variación comunicada entre ejecuciones, no respaldan la afirmación de que el modelo lunar supere al resto en todos los aspectos.
Dónde conseguirlo y cuánto cuesta el acceso
Empieza por los recursos oficiales que se indican a continuación. Los pesos del modelo y el código están sujetos a una licencia Apache-2.0, y el punto de control está disponible públicamente. El repositorio describe específicamente un Versión de ajuste fino e inferencia; excluye explícitamente el código de preentrenamiento.
Elige el recurso para tu próximo paso
Empieza por los usos previstos, los datos de entrada, las licencias y las limitaciones.
La pestaña «Archivos» contiene el punto de control publicado y los archivos asociados.
Utiliza el archivo README y las configuraciones de tareas de TerraTorch para planificar un experimento.
Sigue la colección oficial para acceder a los modelos y conjuntos de datos relacionados.
Las tablas 4 a 7 recogen los resultados de las tareas, los parámetros y la variación entre las ejecuciones.
Echa un vistazo a la versión de demostración del proyecto. En esta revisión no hemos llevado a cabo ninguna generación.
Al consultar la ficha del modelo el 28 de septiembre de 2026, no figuraba ningún proveedor de inferencia de Hugging Face implementado. El punto de control descargable y la página de demostración son vías de acceso independientes.
Si deseas adaptar el modelo, selecciona la tarea posterior antes de configurar el experimento. El repositorio proporciona componentes y configuraciones compatibles con TerraTorch que conectan el punto de control, la tarea y los datos. TerraTorch es el marco de software que se utiliza para organizar ese flujo de trabajo de entrenamiento y evaluación.
- Lee la ficha del modelo y el archivo README; a continuación, elige entre detección, segmentación o regresión en función de la cuestión científica.
- Consigue los datos correspondientes y el punto de control oficial, y revisa la configuración de las tareas y las instrucciones sobre el entorno del repositorio.
- Prepara los datos para esa configuración y ejecuta el flujo de trabajo de ajuste fino o de inferencia correspondiente.
- Evalúa los resultados comparándolos con un valor de referencia adecuado y conserva la división de datos, la configuración y los resultados para poder comprobar el resultado.
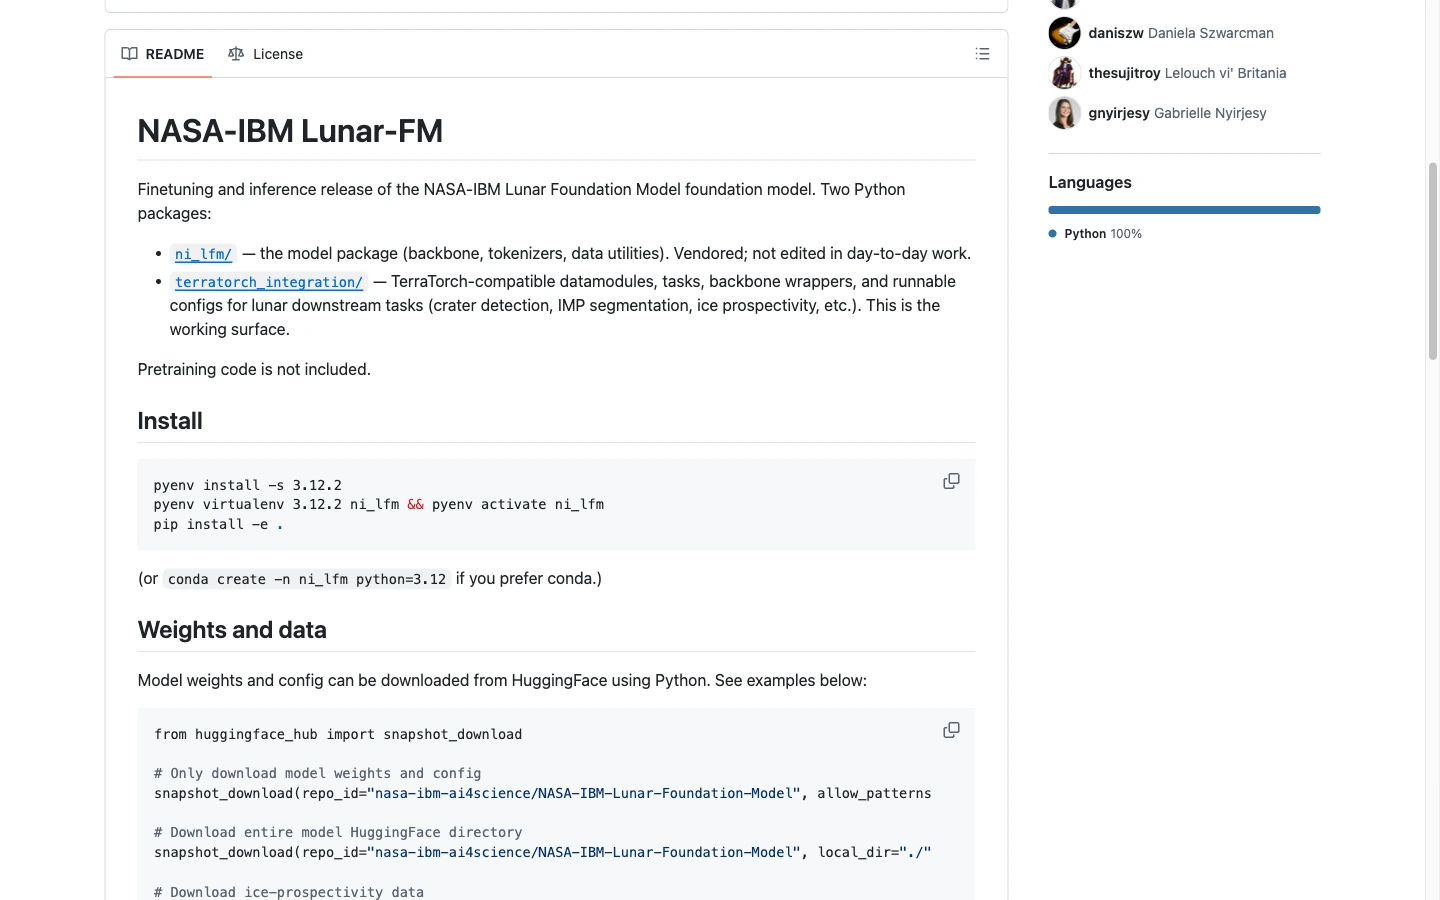
El acceso abierto elimina la compra de una licencia del modelo en la fase inicial del proceso, pero la ejecución de un experimento sigue conllevando costes. Se necesita potencia de cálculo, almacenamiento, preparación de datos y tiempo para la evaluación. Un punto de control publicado no incluye automáticamente una API alojada ni tiempo de GPU gratuito, y los códigos fuente no establecen una GPU mínima universal para todas las tareas posteriores.
| Tu objetivo | Recurso o gasto que hay que tener en cuenta |
|---|---|
| Lee y evalúa el comunicado | Anuncios públicos, ficha del modelo, informe y repositorio. |
| Ejecutar o adaptar el modelo científico | Recursos informáticos y de almacenamiento adecuados, datos pertinentes, configuración del entorno y tareas de evaluación. |
| Comprender los artículos y redactar un resumen de investigación | Un espacio de trabajo para asistentes de investigación, como GlobalGPT, que incluye acceso a modelos y herramientas de gestión de documentos en una sola suscripción. |
Utiliza la IA para comprender la investigación
Una primera pregunta constructiva debe ser concreta: “¿Qué mide realmente la mejora indicada de 22%?”. Para responderla se necesita un objetivo, un indicador, un valor de referencia y un cálculo. Solicitar esos cuatro elementos resulta más útil que preguntarle a un asistente si el modelo es impresionante.
GlobalGPT te permite llevar a cabo ese trabajo de lectura —desde la búsqueda de fuentes hasta la explicación de documentos y la redacción— sin tener que cambiar de herramienta en cada paso. Para un método repetible, elaborar un informe de investigación con referencias contrastadas con una breve lista de fuentes y preguntas concretas antes de solicitar un resumen bien elaborado.
De las fuentes oficiales a un informe informativo útil
- Recoge el material primario. Empieza por el comunicado de la NASA y, a continuación, añade la ficha del modelo, el informe técnico y el archivo README. Puedes investigación con Perplexity sobre GlobalGPT para localizar fuentes que lo respalden.
- Haz preguntas concretas. Pide a un asistente que te explique por separado los conceptos de mAP, IoU y RMSE; a continuación, enumera el objetivo, la referencia y el contexto de evaluación que subyace a cada afirmación.
- Comprueba y escribe. Vuelve a abrir la tabla mencionada, comprueba cada cifra y convierte las notas revisadas en un informe que respete los límites científicos.
Probamos una versión reducida de este flujo de trabajo con GPT-5.6 Sol. El sistema recibió un paquete de información extraída de las cuatro fuentes oficiales y tuvo que elaborar un breve informe, clasificar seis afirmaciones, calcular la reducción del RMSE y sugerir los siguientes pasos prácticos. La tarea utilizó texto proporcionado; no buscó nuevas pruebas.
Una prueba de información basada en fuentes
Le proporcionamos a GPT-5.6 Sol un breve resumen extraído del comunicado de la NASA, la ficha técnica oficial, el informe técnico y el archivo README de GitHub. Tenía que redactar un informe, verificar seis afirmaciones y explicar el cálculo del RMSE.
- Espacio de trabajo y fecha
- GlobalGPT · 28 de septiembre de 2026
- Aplicar la política
- Una tarea; una única respuesta completa; sin segundas oportunidades
- Entrada
- Paquete de fuentes de 355 palabras con cuatro identificadores de fuente
- Alcance
- Lectura y síntesis; sin búsqueda en tiempo real ni ejecución del modelo lunar
- Configuración de respuestas
- Límite de tokens de salida: 4.096; el resto de controles de muestreo se mantienen en los valores predeterminados del servicio
- Uso y coste
- Se han declarado un total de 2.154 tokens; la respuesta no incluía ningún cargo monetario
La primera respuesta se ciñó al ámbito de las afirmaciones científicas
La respuesta consistió en un informe de 112 palabras, en el que se rechazaba la afirmación de que el modelo hubiera descubierto 22% más hielo real y se mantenían las restricciones relativas a la certificación de los lugares de aterrizaje y al acceso al código de entrenamiento previo. Sus tres pasos siguientes remitían a la ficha oficial del modelo, al punto de control y a los recursos de TerraTorch.
Se trataba de una tarea de lectura basada en el material facilitado. En el paquete de fuentes ya se indicaban las limitaciones principales. El resultado no permite evaluar el rendimiento en materia de investigación autónoma ni de inferencia mediante teledetección lunar.
Ver el mensaje exacto y el paquete de origen
SISTEMA
Eres un editor de investigación meticuloso que escribe para un estudiante universitario. Utiliza únicamente el paquete de fuentes facilitado. No busques información adicional. Distingue entre las mediciones de referencia comunicadas y las mediciones científicas del mundo real. Cita los identificadores de las fuentes entre corchetes. Si una afirmación no está respaldada, indícalo claramente. No inventes citas, precios, requisitos de hardware ni resultados experimentales. Proporciona la respuesta solicitada, no un razonamiento oculto.

USUARIO
Convierte el paquete de fuentes en una nota de investigación práctica. Entrega: (1) un resumen en lenguaje sencillo de entre 100 y 130 palabras; (2) una tabla de verificación de afirmaciones de seis filas en la que utilices exactamente «Respaldada» o «No respaldada», un identificador de fuente y una explicación de una sola frase para cada afirmación proporcionada; (3) la reducción relativa del RMSE calculada de 0,0377 a 0,0293, redondeada a un decimal, con una fórmula y una frase que explique lo que no mide; (4) tres pasos prácticos a seguir para un estudiante que desee examinar o adaptar el modelo publicado. La respuesta completa debe tener menos de 500 palabras.

Afirmaciones que hay que comprobar:
1. La NASA e IBM anunciaron públicamente el modelo el 10 de septiembre de 2026.
2. El RMSE de la prospectividad de hielo pasó de 0,0377 para SwinV2-B a 0,0293 para el modelo lunar completamente ajustado.
3. El modelo descubrió 22% más hielo de agua real en la Luna.
4. La NASA ha validado este modelo para la certificación de lugares de aterrizaje y la evaluación de riesgos.
5. La publicación en GitHub incluye el código de preentrenamiento.
6. Un punto de control abierto garantiza que el cálculo en GPU y la inferencia alojada sean gratuitos.

Paquete de fuentes:
[S1] Comunicado de la NASA, 10 de septiembre de 2026.
Título: La NASA e IBM lanzan un modelo base de IA para la ciencia lunar.
URL: https://science.nasa.gov/science-research/artificial-intelligence-lunar-foundation-model/
La NASA ha anunciado un modelo base para la ciencia lunar desarrollado junto con IBM. Está alojado públicamente en Hugging Face, y el código se encuentra en GitHub. Puede adaptarse para la cartografía de cráteres, la identificación de características volcánicas y la investigación del hielo polar.

[S2] Ficha oficial del modelo y informe técnico de la NASA e IBM, consultados el 28 de septiembre de 2026.
URL de la ficha del modelo: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
URL del informe técnico: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model/blob/main/NI_LFM_Technical_Report.pdf
La tabla 7 del informe (página 18) ofrece el error cuadrático medio (RMSE) del conjunto de prueba para la regresión de prospectividad de hielo. Cuanto menor sea, mejor. Media más o menos la desviación estándar en cinco semillas aleatorias: NASA-IBM LFM con ajuste fino completo, 0,0293 ± 0,0013; SwinV2-B preentrenado con ImageNet, 0,0377 ± 0,0004. El objetivo es un mapa de prospectividad de hielo basado en el conocimiento. Se trata de resultados de referencia comunicados por los autores, no de una réplica independiente ni de una medición directa de hielo de agua.
Tabla 4 (página 16), cráteres del WAC con datos de entrenamiento 50%: el mAP del cuadro delimitador es de 0,2541 ± 0,0018 para LFM totalmente ajustado y de 0,2313 ± 0,0027 para SwinV2-B. En las mismas filas, el AP@75 es de 0,2213 ± 0,0028 y 0,1862 ± 0,0041, respectivamente. Estas métricas no deben intercambiarse.

[S3] Ficha técnica oficial del modelo, uso previsto / fuera del ámbito de aplicación / limitaciones.
URL: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
El uso previsto es la teledetección lunar mediante ajuste fino o adaptación LoRA para la detección, la segmentación y la regresión densa. El modelo no está validado para la certificación de lugares de aterrizaje ni para la evaluación de riesgos. Los resultados sobre el potencial de hielo se basan en un mapa basado en el conocimiento, no en mediciones del hielo. Los campos generados son sondeos cualitativos, no predicciones científicas calibradas. El modelo no mantiene un marco de referencia geodésico absoluto. No se ha evaluado más allá de la Luna. La licencia indicada es Apache-2.0. La página no indica ninguna implementación de Inference Provider. Este paquete no ofrece ninguna garantía de computación gratuita en GPU ni de inferencia alojada gratuita, ni especifica requisitos mínimos de hardware ni el precio de la API alojada.

[S4] Archivo README oficial de GitHub, consultado el 28 de septiembre de 2026.
URL: https://github.com/NASA-IMPACT/NASA-IBM-Lunar-Foundation-Model
El repositorio describe una versión de ajuste fino e inferencia. No se incluye código de preentrenamiento. Los pesos y la configuración se pueden descargar del repositorio oficial de modelos de Hugging Face. Se proporcionan módulos de datos, tareas, envoltorios de backbone y configuraciones de tareas compatibles con TerraTorch. El ajuste fino y las pruebas requieren los datos, el punto de control y la configuración de tareas pertinentes. El archivo README indica una licencia Apache 2.0.
Ver la primera respuesta completa
## 1. Resumen

La NASA e IBM anunciaron el Lunar Foundation Model el 10 de septiembre de 2026. La versión pública ofrece los pesos en Hugging Face y el código de ajuste fino e inferencia en GitHub, y está orientada a tareas de teledetección lunar como la cartografía de cráteres, la identificación de características volcánicas y la investigación del hielo polar. Según se informa, su prueba de rendimiento en la prospección de hielo mejora el RMSE con respecto a un SwinV2-B preentrenado en ImageNet, pero el objetivo es un mapa basado en el conocimiento, no en mediciones directas del hielo lunar. El resultado, según informan los autores, se ha obtenido con cinco semillas aleatorias y no se trata de una réplica independiente. El modelo está pensado para su adaptación mediante un ajuste fino completo o LoRA, pero no está validado para la certificación de lugares de aterrizaje ni para la evaluación de riesgos. No se incluye el código de preentrenamiento, y la publicación no promete ni recursos de GPU gratuitos ni inferencia alojada. [S1][S2][S3][S4]

## 2. Tabla de verificación de afirmaciones

| Afirmación | Veredicto | Fuente | Explicación |
|---|---|---|---|
| 1 | Confirmada | [S1] | El anuncio de la NASA data del 10 de septiembre de 2026 e identifica el modelo como un proyecto de la NASA e IBM. |
| 2 | Respaldada | [S2] | La tabla 7 recoge valores de RMSE de 0,0377 para SwinV2-B y de 0,0293 para el modelo lunar totalmente ajustado. |
| 3 | No respaldado | [S2] | Las cifras son errores de referencia respecto a un mapa de prospectividad basado en el conocimiento, no mediciones de hielo de agua lunar real. |
| 4 | No respaldado | [S3] | La ficha del modelo indica explícitamente que el modelo no está validado para la certificación de lugares de aterrizaje ni para la evaluación de riesgos. |
| 5 | No compatible | [S4] | El repositorio de GitHub proporciona recursos de ajuste fino e inferencia, pero excluye el código de preentrenamiento. |
| 6 | No compatible | [S3] | El paquete no promete computación gratuita en GPU ni inferencia alojada, y no indica ningún despliegue de un proveedor de inferencia. |

## 3. Reducción relativa del RMSE

\[
\frac{0,0377-0,0293}{0,0377}\times 100 = 22,3\%
\]

Se trata de una **reducción relativa del 22,3% en el RMSE de referencia comunicado por los autores**; no mide el hielo de agua real adicional descubierto ni el rendimiento científico validado de forma independiente. [S2]

## 4. Próximos pasos prácticos

1. Lee los usos previstos, las limitaciones y la licencia Apache-2.0 de la ficha del modelo antes de seleccionar una tarea de detección, segmentación o regresión. [S3]
2. Descarga el punto de control oficial y la configuración de Hugging Face; a continuación, revisa los envoltorios de backbone de GitHub y las configuraciones de las tareas. [S4]
3. Obtén el conjunto de datos lunar pertinente y utiliza los componentes compatibles con TerraTorch que se proporcionan para realizar el ajuste fino y las pruebas, documentando que no se dispone de código de preentrenamiento y que los resultados de las pruebas comparativas requieren una evaluación independiente. [S2][S4]
El resultado útil fue la conservación de las distinciones: error de referencia frente a hielo detectado, uso con fines de investigación frente a certificación de aterrizaje, y código de adaptación publicado frente a código de preentrenamiento ausente. Dado que esos límites ya figuraban en el paquete de origen, esto constituye una prueba del éxito de la tarea de lectura y síntesis, pero no una prueba de que un asistente pudiera descubrir por sí mismo todas las salvedades.
En el caso de un proyecto de mayor envergadura, planificar una sesión de investigación más exhaustiva con ayuda de la IA en torno a cuestiones concretas sobre los datos, los métodos, la evaluación y las limitaciones. Mantén la tabla original junto al borrador y vuelve a comprobar cada cifra tras la edición. Ese hábito es más importante que la fluidez con la que suene el primer resumen.
Límites que importan en la práctica
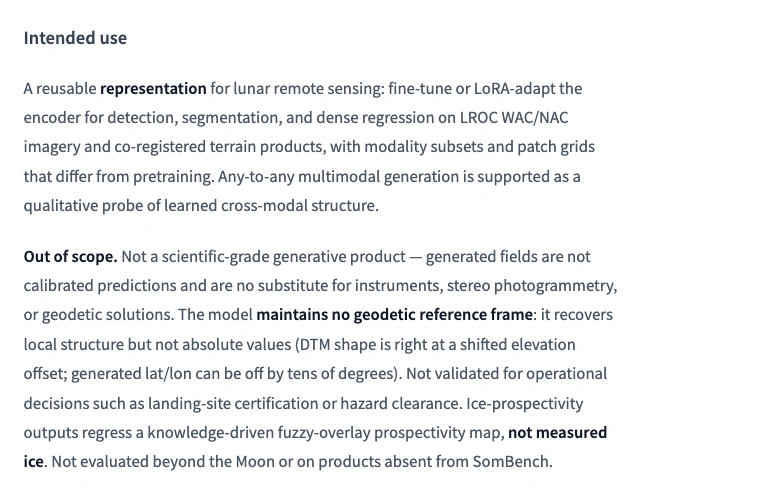
La ficha del modelo indica que el modelo lunar no ha sido validado para la toma de decisiones operativas, como la certificación de lugares de aterrizaje o la evaluación de riesgos. Un modelo científico puede ayudar a analizar las observaciones sin que se pueda certificar que una nave espacial pueda aterrizar con seguridad en un lugar determinado. Esos usos requieren un nivel de validación diferente.
Los campos generados también requieren precaución. El modelo no mantiene un sistema de referencia geodésico absoluto, y los valores generados pueden desviarse de los valores físicos. Los autores describen la generación como una exploración cualitativa más que como una predicción científica calibrada. Un mapa de terreno o de observación que parezca plausible no debe interpretarse como un producto medido.
El punto de control no se ha evaluado más allá de la Luna. Incluso dentro de la investigación lunar, el balance es desigual: se han obtenido avances claros en algunas tareas y resultados comparables en otras. La conclusión que cabe extraer es que hay que evaluar el modelo en función del objetivo, la escala, los datos y la línea de base que se ajusten a tu experimento.
Preguntas frecuentes
¿Se puede utilizar gratuitamente el Modelo Lunar de la Fundación NASA-IBM?
La ficha oficial del modelo y el repositorio de código indican que se rige por una licencia Apache-2.0, y el punto de control está disponible públicamente. La realización de experimentos sigue requiriendo recursos informáticos adecuados, la preparación de datos y una evaluación específica para cada tarea. El acceso abierto al modelo no garantiza el uso gratuito de recursos de computación en GPU ni la inferencia alojada.
¿Es el «Lunar Foundation Model» de la NASA e IBM un chatbot?
Se trata de un modelo base para la teledetección lunar, diseñado para trabajar con imágenes, productos topográficos y datos de observación relacionados. Los investigadores lo adaptan para tareas de detección, segmentación y regresión. Un asistente de chat puede ayudar a explicar la documentación, pero interactuar con un chatbot es un flujo de trabajo distinto al de ejecutar este modelo.
¿Ha descubierto el modelo más hielo de agua en la Luna?
El resultado sobre el hielo que se presenta mide en qué medida las predicciones se ajustan a un mapa de prospectividad de hielo basado en el conocimiento. El mejor RMSE registrado desciende de 0,0377 a 0,0293 con respecto a la referencia citada, lo que supone una reducción relativa de aproximadamente 22%. Se trata de una mejora en el punto de referencia; no es una medida del hielo adicional descubierto.
¿Puedo explorar el proyecto sin escribir código?
Puedes leer el comunicado de la NASA, examinar la ficha del modelo, consultar las tablas de referencia publicadas y visitar la página oficial de demostración sin necesidad de crear un flujo de trabajo de entrenamiento. Para adaptar el punto de control publicado a una tarea científica, se utilizan el código, los datos y las configuraciones de TerraTorch del repositorio, a lo que sigue una validación específica para cada tarea.
¿Qué relación tiene el modelo lunar con Prithvi y Surya?
Forman parte de la colaboración más amplia entre la NASA e IBM sobre modelos base para la ciencia. La NASA describe los modelos «Prithvi» para observaciones de la Tierra y aplicaciones meteorológicas, «Surya» para la heliofísica y el modelo lunar para observaciones de la Luna. Sus ámbitos de aplicación y tareas previstas difieren; el modelo lunar no se ha evaluado más allá de la Luna.
El Modelo Lunar de la NASA e IBM ofrece un punto de partida reutilizable para la investigación en teledetección lunar. Utiliza las tablas oficiales para comprender sus puntos fuertes, la ficha del modelo para definir sus límites y los recursos publicados para planificar un experimento específico para una tarea concreta. Si tu objetivo inmediato es aprender o escribir, empieza por convertir esas fuentes en un resumen contrastado.
Convierte un artículo técnico en un resumen que te resulte útil
Trae tus fuentes oficiales a GlobalGPT, analiza conceptos que no te resulten familiares y plasma los resultados revisados en notas claras o en un borrador definitivo, todo ello en un único espacio de trabajo multimodelo.
Explora la investigación con GlobalGPT








