نعم — يُعد Grok 4.6 نموذجًا رسميًا من xAI، تم إطلاقه في 12 أغسطس 2026، وهو يستحق اهتمامًا جادًّا إذا كان عملك يتضمن حزم بحثية طويلة، أو البرمجة، أو التحليل متعدد الخطوات، أو المهام القائمة على الصور. تمنحه نافذة السياق التي تضم 500 ألف توكن وقدراته الاستدلالية القابلة للتكوين القدرة على التعامل مع المشاريع الصعبة، على الرغم من أنه ليس بالضرورة الخيار الأسرع أو الأفضل تلقائيًا لكل موجه. لم يعد السؤال الحقيقي هو ما إذا كان Grok 4.6 موجودًا أم لا، بل ما إذا كانت نقاط قوته تتناسب مع العمل الذي تحتاج فعليًّا إلى إنجازه.
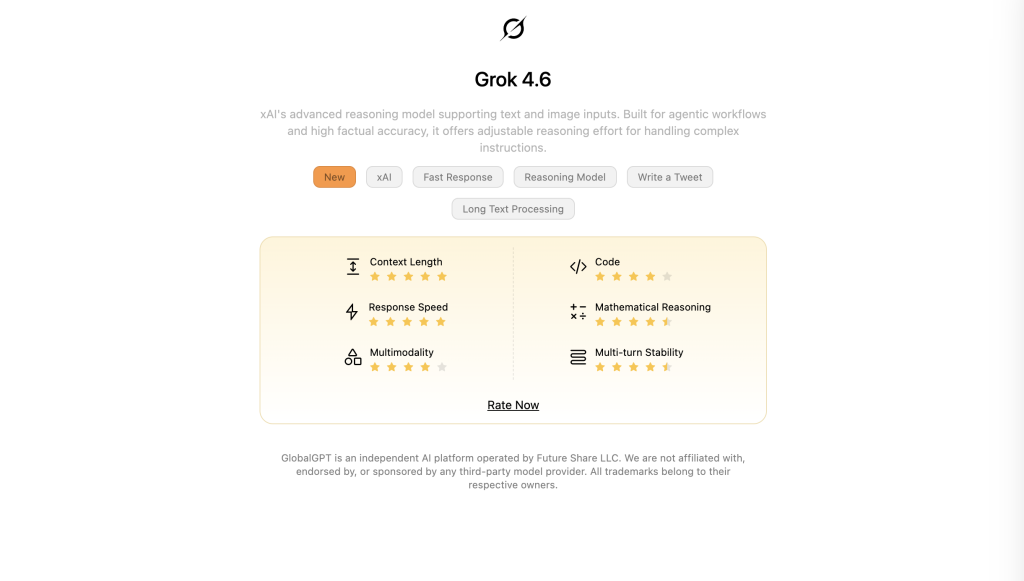
إذا كنت ترغب في الإجابة على هذا السؤال دون ربط سير عملك بالكامل بمزود واحد،, يُعد GlobalGPT نقطة انطلاق ممتازة. تتيح لك مساحة عمل المتصفح استخدام Grok 4.6 جنبًا إلى جنب مع النماذج الرائدة الأخرى، وتشغيل نفس المطالبات المتعلقة بالبحث أو الكتابة أو التحليل أو البرمجة، ومقارنة النتائج في مكان واحد. إنها طريقة عملية وبسيطة بشكل مبهج لمعرفة المجالات التي يبرز فيها Grok 4.6 حقًّا — والمجالات التي يناسب فيها نموذج آخر مهمتك بشكل أفضل — قبل اختيار الإعداد أو الاشتراك الذي يناسبك.
ما هو Grok 4.6 بالضبط؟
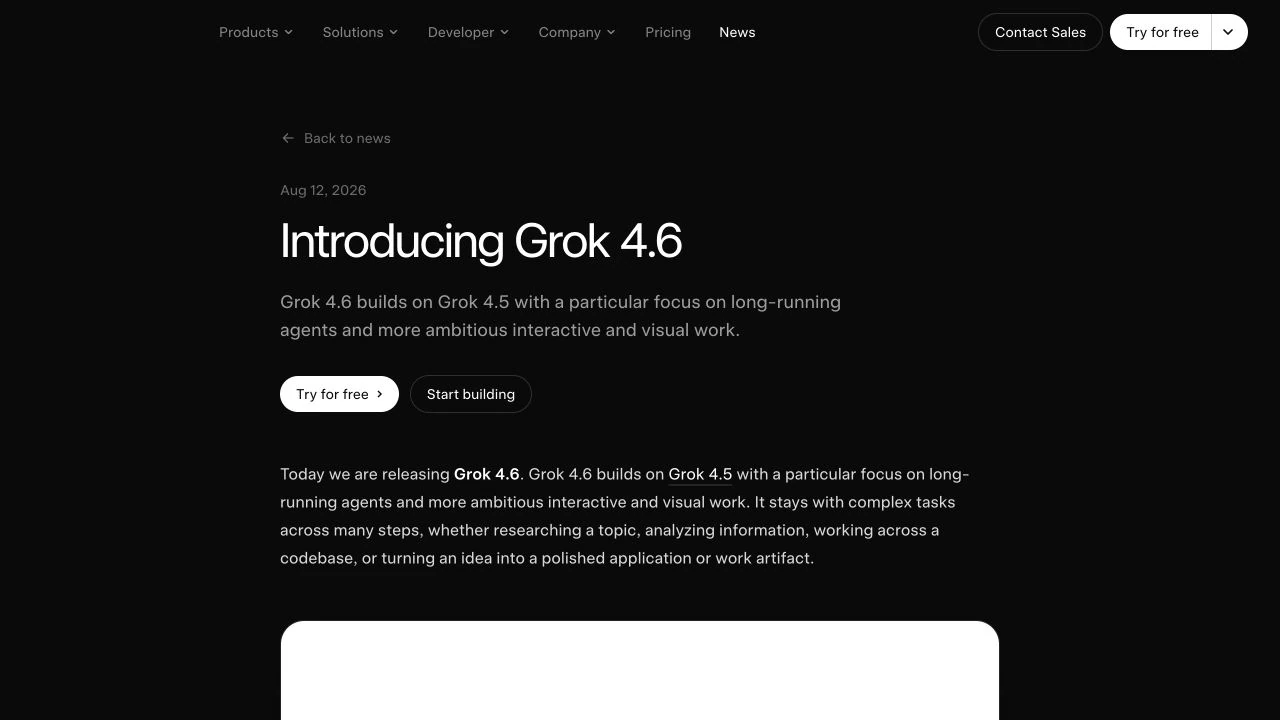
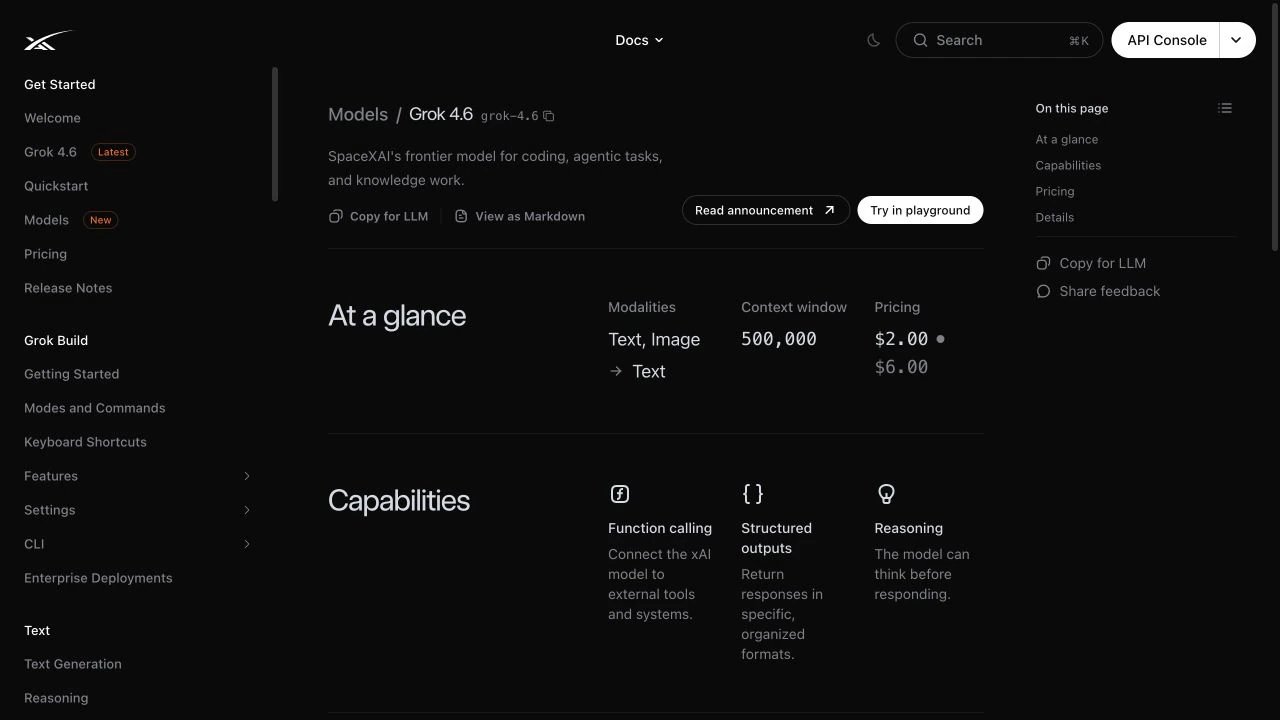
يُعد طراز Grok 4.6 الطراز الرائد لشركة xAI لعام 2026 ضمن سلسلة Grok. تصف الصفحة الرسمية للطراز إمكانية إدخال النصوص والصور، وإخراج النصوص، والقدرة على الاستدلال القابلة للتكوين، ونافذة سياق تبلغ 500 ألف توكن. معرّف واجهة برمجة التطبيقات (API) هو grok-4.6; ؛ هذه هي القيمة التي يجب على المطورين استخدامها في الطلب.
لغة الإصدار الخاصة بشركة xAI محددة: يركز الإصدار Grok 4.6 على الوكلاء ذوو الخبرة الطويلة وأعمال تفاعلية ومرئية أكثر طموحًا. وتُبرز الوثائق الرسمية استخداماته في البرمجة والمهام التي تتطلب قدرة على التصرف والأعمال المعرفية، مع إمكانية استدعاء الدوال والمخرجات المنظمة لسير العمل الذي يحتاج إلى أدوات أو تنسيقات استجابة يمكن التنبؤ بها.
تشير بطاقة النموذج إلى موعد نهائي للتدريب المسبق في يناير 2026. وهذا التمييز مهم. تتيح لك نافذة السياق التي تبلغ 500 ألف حزمة تقديم حزمة مصدر كبيرة جدًّا، لكنها لا تجعل النموذج تلقائيًّا محرك بحث فعال. بالنسبة للأسعار الحالية أو الأخبار أو سياسات المنتجات المتغيرة، يجب عليك الرجوع إلى مصادر موثوقة والتحقق من صحة الإجابة.
ما هي المواصفات الرسمية لطراز Grok 4.6؟
| المواصفات | القيمة الموثقة رسميًا | ما أهمية ذلك |
|---|---|---|
| تاريخ الإصدار | 12 أغسطس 2026 | يؤكد أن هذا إصدار رسمي من xAI. |
| معرف نموذج واجهة برمجة التطبيقات | grok-4.6 | استخدم هذا الاسم المختصر بالضبط في طلبات واجهة برمجة التطبيقات. |
| نافذة السياق | 500 ألف توكن | مفيد في حالة الملخصات الطويلة وقواعد البيانات البرمجية والأبحاث التي تعتمد بشكل كبير على النصوص المصدرية. |
| الإدخال / الإخراج | إدخال النص والصورة؛ إخراج النص | يدعم المطالبات متعددة الوسائط، لكنه لا يدعم إنشاء الصور. |
| التفكير المنطقي | قابل للتكوين | يتيح هذا سير العمل المفاضلة بين السرعة والتحليل الأعمق. |
| استدعاء الدالة | مدعوم | يربط النموذج بالأدوات والأنظمة الخارجية. |
| المخرجات المنظمة | مدعوم | مفيد في التعامل مع JSON، وعمليات الاستخراج، ومسارات المعالجة التي يمكن التنبؤ بها. |
| حد الفصل قبل التدريب | كانون الثاني/يناير 2026 | لا تعتبر النموذج الأساسي محدثًا تلقائيًا. |
المصدر: إعلان xAI، ووثائق النموذج، وبطاقة النموذج Grok 4.6. تختلف المواصفات الرسمية عن نتائج الأداء المستقلة.
ما هي إمكانيات طراز Grok 4.6؟
التفكير المنطقي والتحليل المنظم
إن قدرة الاستدلال القابلة للتكوين تجعل Grok 4.6 مناسبًا للمهام التي تستفيد من إجابة مدروسة: مثل مقارنة الأدلة، أو إنشاء جداول القرار، أو التخطيط للتنفيذ، أو التحقق من صحة حساب خاضع لقيود. ولا يعني المزيد من الاستدلال بالضرورة أنه أفضل تلقائيًّا لكل طلب، لذا ينبغي استخدام الإعداد المناسب عند إجراء عمليات الاستخراج وإعادة الكتابة الروتينية.
الأبحاث والأعمال التي تعتمد بشكل كبير على المصادر
توفر نافذة السياق بسعة 500 ألف نافذة مساحة كافية للنموذج لاستيعاب التقارير الضخمة، والنصوص الكاملة، ووثائق السياسات، وحزم المصادر. ويُعد أفضل مسار عمل هو الاسترجاع باستخدام محددات المواقع الصريحة وقواعد الاقتباس، يليه فتح المصدر الأصلي للتحقق منه.
الترميز وتصحيح الأخطاء
تدعم التقييمات المنشورة في مجال هندسة البرمجيات واختبارات التصحيح المحدودة التي أجريناها استخدام هذا الأسلوب في مراجعة الكود وإصلاح الأخطاء ومهام الوكلاء المنظمة. ومع ذلك، ينبغي على المطورين إجراء الاختبارات محليًّا ومراجعة التصحيحات قبل النشر.
فهم الصورة
تقوم xAI بتوثيق المدخلات النصية والصورية مع إخراج نصي. ويدعم ذلك تفسير لقطات الشاشة، وتحليل صور المستندات، والإجابة على الأسئلة البصرية، ولكن لا ينبغي الخلط بينه وبين إنشاء الصور.
الوكلاء الذين يعملون لفترات طويلة واستخدام الأدوات
هذه هي القدرة الأكثر ارتباطًا بموقع xAI عند الإطلاق. تتيح ميزة استدعاء الوظائف لـ Grok 4.6 الاتصال بالأدوات الخارجية، بينما تسهّل المخرجات المنظمة تمرير النتيجة إلى خطوة أخرى. يناسب هذا المزيج الوكلاء الذين يجمعون السياق، ويعملون على قاعدة الكود، ويستدعون أداة ما، ويتحققون من النتيجة، ويعيدون ناتجًا نهائيًّا. لا يزال النموذج بحاجة إلى بيئة تشغيل خارجية، وأذونات، وفحوصات للأهداف؛ فمصطلح “الوكيلية” لا يعني أن النموذج الأساسي يعمل بشكل مستقل.
عمل تفاعلي ومرئي
كما تسلط xAI الضوء على الأعمال التفاعلية والمرئية الأكثر طموحًا. ومن الأمثلة العملية على ذلك موجز المنتج الذي يحتوي على عدد كبير من لقطات الشاشة أو التقرير المدعوم بالرسوم البيانية، حيث يتعين على النموذج ربط الأدلة المرئية بالتوصية المكتوبة. لذا، يجب التحقق من التسميات والمحاور والوحدات والتفاصيل التي تم حذفها قبل اعتبار النتيجة نهائية.
ما الذي تغير في طراز Grok 4.6 مقارنةً بالطرازات السابقة من Grok؟
يركز نهج xAI على تعزيز قدرات الاستدلال، والعمل مع الوكلاء البرمجيين، والأداء في السياقات الطويلة. ولا تتمثل الترقية العملية في ميزة واحدة لافتة للنظر، بل هي مزيج من مساحة عمل أوسع، وقدرات استدلال قابلة للتعديل، ونموذج مُحسَّن لأداء المهام المعقدة متعددة الخطوات.
لا يزال هذا الأمر يحتاج إلى اختبار سير العمل. فقد يحقق نموذج ما نتائج جيدة في اختبار أداء قياسي، لكنه قد لا يتناسب مع أسلوبك في الكتابة أو متطلبات الاستشهادات أو قاعدة الكود الخاصة بك. إن أفضل طريقة لتقييم Grok 4.6 هي من خلال المهام التي تكررها أسبوعيًا، وليس من خلال رقم واحد في قائمة المتصدرين.
كيف يقارن أداء معالج Grok 4.6 في اختبارات الأداء الموثوقة؟
يُفصل الجدول أدناه بين نتائج بطاقة النموذج الخاصة بشركة xAI والقياسات المستقلة. وهذا أمر ضروري لأن رقمي «Terminal-Bench» هما نسختان مختلفتان، ولا يجب تقديمهما على أنهما نتيجة مقارنة مباشرة بينهما.
| المُقيِّم | المهمة / المؤشر | النتيجة المُعلنة | فئة الأدلة ومدة التقادم |
|---|---|---|---|
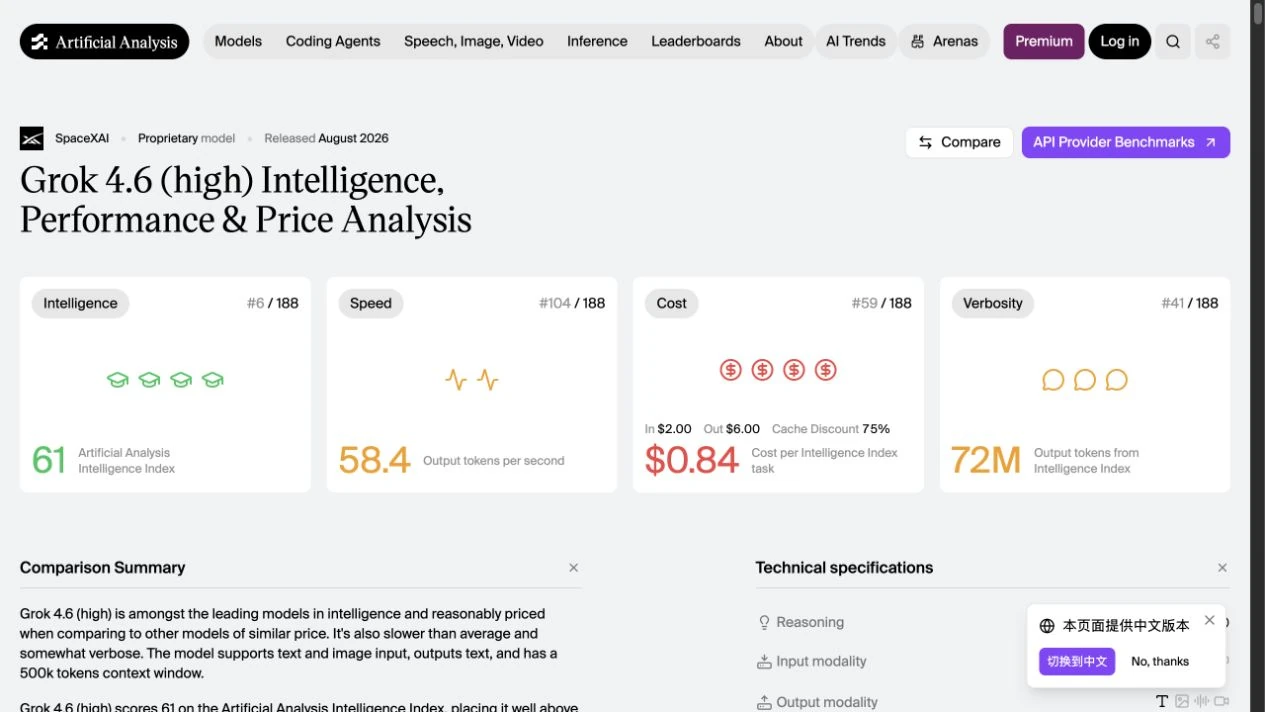
| التحليل الاصطناعي | مؤشر الذكاء | 61 (#6 / 188 عند التقاط الصورة) | تقرير مركب مستقل؛ استخدم منهجية وكالة التصنيف الائتماني «AA» وتاريخها. |
| التحليل الاصطناعي | سرعة الإخراج | 58.4 توكن في الثانية | قياس سرعة مستقل؛ يؤثر المسار والأجهزة على زمن الاستجابة. |
| التحليل الاصطناعي | التكلفة لكل مهمة استخباراتية | $0.84 | تقدير من شركة AA استنادًا إلى مجموعة المهام الخاصة بها؛ وليس فاتورة من xAI. |
| التحليل الاصطناعي | GDPval-AA الإصدار 2 | 1753 | التقييم المستقل لنتائج العمل. |
| التحليل الاصطناعي | AA-حقيبة عمل | 1577 | تقييم مستقل لأسلوب العمل المعرفي. |
| التحليل الاصطناعي | Terminal-Bench الإصدار 2.1 | 88.4% | نتيجة الإصدار 2.1 من برنامج «Independent»؛ لا يمكن مقارنتها بنتائج برنامج «Terminal-Bench 3.0». |
| بطاقة نموذج xAI | Terminal-Bench 3.0 | 26% | النتيجة الرسمية لبطاقة النموذج في إصدار مختلف. |
| ميركور APEX-SWE | هندسة البرمجيات | 56.4% ± 6.2% | 200 مهمة؛ يجب الاحتفاظ بفاصل عدم اليقين. |
| وكلاء Mercor APEX | مهام الوكيل | 57.5% ± 3.5% | 33 عالماً / 480 مهمة؛ تقييم محدد للوكيل. |
| بطاقة نموذج xAI | DeepSearchQA | 81.6% | حالة ضمان جودة الأبحاث وفقًا لتقارير المورد. |
| بطاقة نموذج xAI | معدل الهلوسة الواقعية | 1.7% | شروط اختبار بطاقة النموذج، وليست معدل خطأ عام. |
المصادر: Artificial Analysis، وقوائم تصنيف Mercor APEX، وبطاقة نموذج xAI. يرجى عدم دمج النتائج عبر مجموعات البيانات المختلفة، أو الإصدارات، أو إعدادات الجهد، أو المقيمين.
هل طراز Grok 4.6 أفضل من طراز Grok 4.5؟
تقدم بطاقة الطراز الرسمية إجابة مختلطة بدلاً من إجابة بسيطة بنعم. فقد سجلت بطاقة Grok 4.6 نتيجة أعلى بكثير في اختبار DeepSearchQA، في حين أظهرت البطاقة نفسها معدلًا أعلى من “الهلوسة الواقعية” مقارنةً ببطاقة Grok 4.5. لا ينبغي أن تحول المراجعة الجادة معيارًا قويًّا واحدًا إلى ادعاء بالموثوقية الشاملة.
| التقييم الرسمي | Grok 4.6 | Grok 4.5 | كيفية تفسير ذلك |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | تم الإبلاغ عن تحسن كبير في نتائج هذا التقييم المرتكز على البحث. |
| معدل الهلوسة الواقعية | 1.7% | 0.98% | كلما كان الرقم أقل، كان ذلك أفضل؛ ويُعتبر الرقم Grok 4.5 هو الأفضل في ظل الظروف المذكورة. |
المصدر: بطاقة نموذج xAI Grok 4.6. تجيب هذه التقييمات على أسئلة مختلفة ولا تحدد فائزًا واحدًا بشكل قاطع.
ما مدى سرعة وموثوقية وكفاءة طراز Grok 4.6 في الاستخدام العملي؟
تشير الأدلة المنشورة إلى نموذج ذي قدرات عالية، لكن “الأداء” يتألف من عدة عناصر: جودة الإجابة، وزمن الاستجابة، والاحتفاظ بالسياق، واتباع التعليمات، والتعافي من الأعطال. في المسار المباشر الذي اتبعناه، أعاد اختبار الاستعداد رمز HTTP 200 و جاهز. تم إرجاع النتائج الصحيحة الأولى للمهام الأخرى بنجاح، في حين تسبب طلب تحرير مقيد واحد في حدوث عطل في البنية التحتية من جانب العميل.
يضيف «التحليل الاصطناعي» معيارًا واقعيًا مفيدًا يتجاوز قدرات العناوين الرئيسية: فالصفحة التي تم التقاطها تُظهر مؤشر ذكاء يبلغ 61، وسرعة إخراج تبلغ 58.4 رمزًا في الثانية، وتكلفة تقديرية تبلغ $0.84 لكل مهمة ذكاء. يشير هذا المزيج إلى نموذج قادر ولكنه ليس فائق السرعة — وهو أكثر ملاءمةً للأعمال ذات المغزى من الردود المقتضبة المكونة من سطر واحد.
هذه النتيجة المختلطة مفيدة. قد يُظهر Grok 4.6 أداءً قويًّا في الأعمال المنظمة، لكن يجب على مستخدمي بيئة الإنتاج الحفاظ على قواعد إعادة المحاولة، وفترات الانتظار، ونموذج احتياطي، بدلاً من افتراض أن كل مسار سيتصرف بنفس الطريقة.
في أي مجال يبدو طراز Grok 4.6 أكثر فائدة؟
أعمال البرمجة وتطوير المنتجات طويلة الأمد
يمتد نطاق مثال الإطلاق الخاص بـ xAI ليشمل البحث في موضوع ما، وتحليل المعلومات، والعمل على قاعدة كود برمجية، وتحويل فكرة ما إلى تطبيق أو منتج نهائي متقن. وهذا يجعل العمل الذي يبلغ حجمه «ميزة» (feature) مقياسًا أفضل للتقييم مقارنةً بموجه تجريبي بسيط يقتصر على وظيفة واحدة. قم بتزويد النموذج بهدف محدد، وملفات ذات صلة، واختبارات، وتعريفًا لـ «الإنجاز».
توليف الأبحاث والعمل المعرفي
إن نافذة الـ500 ألف، والمخرجات المنظمة، والنتائج القوية لـDeepSearchQA، تجعل من Grok 4.6 خيارًا طبيعيًّا لتحويل حزمة المصدر إلى ملخص، أو تحديد نقاط الاختلاف، أو استخراج جدول قرارات. ويدعم اختبار التحقق من المصدر هذا الاستخدام عندما تكون قواعد الاقتباس واضحة.
التقارير الكبيرة وتحليل الوثائق المتعددة
استخدم نافذة السياق للاطلاع على التقارير السنوية، وكشوف الدرجات، وحزم السياسات، وسجلات المشاريع التي كانت ستتطلب، لولا ذلك، تقسيمًا مكثفًا. اطلب تحديد مواقع الصفحات أو الأقسام، ثم تحقق من الأرقام ذات الأثر الكبير في الوثائق الأصلية.
التحليل القائم على الصور
يُعد إدخال النص والصور مفيدًا في حالات لقطات الشاشة والرسوم البيانية والمخططات. وتزداد أهمية ذلك عندما يكون العنصر المرئي جزءًا من مهمة استدلالية أوسع نطاقًا، مثل مراجعة لوحة المعلومات جنبًا إلى جنب مع السياق التجاري المكتوب.
مسارات عمل قائمة على المبادرة ذات أهداف نهائية واضحة
يدعم استدعاء الوظائف والمخرجات المنظمة سير العمل مثل التحقيق في مشكلة ما، أو استدعاء أداة ما، أو تحديث خطة ما، وإرجاع نتيجة قابلة للقراءة آليًّا. وتُعد المهمة التي تتمتع بأذونات محدودة، وشرط توقف واضح، وأداة فحص موضوعية، هي نقطة البداية الأكثر أمانًا.
| سير العمل | لماذا يُعد طراز Grok 4.6 مناسبًا؟ | أفضل مهمة للبدء بها |
|---|---|---|
| الترميز | تحديد موقع xAI بالإضافة إلى أدلة APEX-SWE وCursorBench | تغيير حقيقي يُعد خطأً أو ميزةً مصحوبة باختبارات |
| الأبحاث | سياق 500 ألف، والناتج المنظم، و DeepSearchQA | موجز مدعوم بمصادر مع مؤشرات للصفحات |
| المستندات الطويلة | نافذة سياق رسمية كبيرة | تقرير سنوي أو مجموعة وثائق سياساتية متعددة |
| التحليل البصري | إدخال الصور بالإضافة إلى تحديد موضع العمل البصري باستخدام xAI | تقرير يحتوي على الكثير من الرسوم البيانية مع سياق مكتوب |
| الوكلاء | استدعاء الدوال والمخرجات المنظمة | تحقيق محدود مع مدقق واضح |
هل يمكن لـ Grok 4.6 إجراء البحوث والتحقق من صحة المعلومات؟
طلب اختبار حزمة المصدر من Grok 4.6 تصنيف ستة ادعاءات، والاستشهاد فقط بعناوين URL المعتمدة، ورفض استنتاجين مغريين.
(1) مؤكد — تاريخ إعلان xAI هو 12 أغسطس 2026، ويشير إلى إطلاق الإصدار Grok 4.6 في ذلك اليوم.
(2) مؤكد — تذكر الوثائق الرسمية لنموذج xAI أن معرّف النموذج هو grok-4.6.
(3) مدعوم — تشير الوثائق الرسمية إلى نافذة سياق سعة 500 ألف.
(5) متناقض — هذه إصدارات مختلفة من Terminal-Bench ولا تستخدم نفس المقياس.
(6) متناقض — لا تعرض الصفحة سوى إدخالًا لمساحة العمل، ولا تشير إلى تضمينه في كل خطة.
عرض الناتج الكامل لـ Grok 4.6
| الادعاء | الحكم | الإجابة في جملة واحدة | رابط (روابط) المصدر | القيود الدقيقة |
|---|---|---|---|---|
| (1) أعلنت xAI عن إصدار Grok 4.6 في 12 أغسطس 2026 | مدعوم | يعود تاريخ إعلان xAI إلى 12 أغسطس 2026، ويذكر فيه أنها ستطلق الإصدار Grok 4.6 في ذلك اليوم. | https://x.ai/news/grok-4-6 | لا يقتبس الحزمة سوى التاريخ وسطر الإعلان عن الإصدار، وليس المنشور الكامل. |
| (2) معرّف نموذج واجهة برمجة التطبيقات (API) الرسمي هو grok-4.6 | مدعوم | تذكر الوثائق الرسمية لنماذج xAI أن معرّف النموذج هو grok-4.6. | https://docs.x.ai/developers/models/grok-4.6 | لا يذكر ملخص Packet الأسماء المستعارة أو المعرفات الأخرى. |
| (3) نافذة السياق الرسمية هي 500 ألف توكن | مدعوم | تشير الوثائق الرسمية إلى نافذة سياق تبلغ 500 ألف توكن. | https://docs.x.ai/developers/models/grok-4.6 | تشير الحزمة إلى “سياق 500 ألف”، دون ذكر صريح لكلمة “token” بين علامتي اقتباس. |
| (4) قامت «Artificial Analysis» بقياس مؤشر الذكاء بشكل مستقل عند 61 | مدعوم | تنشر «AA» مؤشر ذكاء يبلغ 61 لـ Grok 4.6. | https://artificialanalysis.ai/models/grok-4-6 | تذكر Packet نتيجة AA، وليس تدقيقاً منفصلاً لمنهجية AA. |
| (5) Terminal-Bench 3.0 26% و v2.1 88.4% قابلان للمقارنة مباشرة | متناقض | هذان إصداران مختلفان من Terminal-Bench ولا يستخدمان نفس المقياس. | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | تقدم Packet كلا النتيجتين دون أي تعادل أو مقارنة. |
| (6) تثبت صفحة GlobalGPT Grok 4.6 أن كل خطة تتضمن النموذج | متناقض | لا تُظهر الصفحة سوى إدخال في مساحة العمل، وليس تضمينه في كل خطة. | https://www.glbgpt.com/home/grok-4-6 | يذكر Packet نفسه أن هذا إدخال واجهة، وليس كل خطة. |
استنتاج المراجعة: كان النموذج يتبع حدود الأدلة بشكل جيد عندما يكون شكل الحزمة المصدر وشكل الإجابة واضحين. وهذا أمر مفيد في سير عمل الأبحاث، لكن إجابة النموذج تظل أداة مساعدة في البحث — وليست الدليل الخارجي نفسه.
اعرض نص السؤال بالضبط
استخدم حزمة المصادر المرفقة فقط. بالنسبة لكل ادعاء من الادعاءات الستة، قم بتقديم إجابة مكونة من جملة واحدة تشير إلى ما إذا كان الادعاء مدعومًا أو متناقضًا أو غير مثبت، مع ذكر عناوين URL للمصادر والنطاق الدقيق للادعاء.
هل يُعد طراز Grok 4.6 مناسبًا للبرمجة وتصحيح الأخطاء؟
تطلبت مهمة جافا سكريبت إجراء مقارنة بسيطة، والترتيب العددي، والتعامل الصحيح مع الوسيط الفردي/الزوجي، وعدم القابلية للتغيير، وحالتين محددتين للخطأ.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}عرض التفسير الذي أرجعته Grok 4.6
قامت الدالة الأصلية بتحويل معلمتها واستخدمت الترتيب المعجمي الافتراضي (sort())، لذا يتم أخذ نسخة منها باستخدام slice() وترتيبها رقميًّا عبر (a, b) => a - b. بعد استبعاد العناصر غير المصفوفية باستخدام TypeError والمصفوفات الفارغة باستخدام Error("إدخال فارغ")، تكون النتيجة ذات الطول الفردي هي العنصر الأوسط الوحيد، بينما تكون النتيجة ذات الطول الزوجي هي متوسط القيمتين المركزيتين، وهو ما يُعرف بالوسيط التقليدي.أفضل استخدام: تصحيح الأخطاء في المشاريع الصغيرة إلى المتوسطة، وكتابة الاختبارات، ومراجعة الكود، وشرح وظيفة غير مألوفة. أما بالنسبة للمستودعات الكبيرة، فقم بدمج النموذج مع أداة تشغيل الاختبارات الخاصة بك، وراجع الفروق قبل الدمج.
عرض نطاق الاختبار
إصلاح القيمة الوسيطة (القيم) دون تغيير توقيعها. لا يتم تغيير قيمة المدخلات؛ وإلقاء استثناء TypeError في حالة المدخلات غير المصفوفية، واستثناء Error("مدخلات فارغة") في حالة المصفوفات الفارغة؛ وإرجاع فرق موحد أدنى.هل تساعد نافذة السياق التي تبلغ سعتها 500 ألف حرف في التعامل مع المستندات الطويلة؟
تطلبت عملية استرجاع أكثر من 220 ألف رمز تحديد سبعة حقول، ومحددات موقع القسم/الصفحة، وشرحًا لنسختَي «Terminal-Bench».
{
  "release_date": {"value": "12 أغسطس 2026", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "context_window": {"value": "500 ألف توكن"، "locator": "p.2"},
  "long_context_input_price": {"value": "$4 لكل مليون توكن (المطالبات التي تتجاوز 200 ألف توكن)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88.4%"]
}عرض النص الكامل لـ Grok 4.6 بتنسيق JSON
{
  "release_date": {"value": "12 أغسطس 2026", "section": "إصدار xAI", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "نموذج واجهة برمجة التطبيقات", "locator": "p.2"},
  "window_context": {"value": "500 ألف توكن"، "section": "نموذج API"، "locator": "p.2"},
  "long_context_input_price": {"value": "$4 لكل مليون توكن (المطالبات التي تزيد عن 200 ألف توكن)", "section": "التسعير", "locator": "p.3"},
  "terminal_bench_version": [{"value": "3.0", "section": "بطاقة المعايير"، "locator": "p.4"},{"value": "v2.1"، "section": "معيار مستقل"، "locator": "p.5"}],
  "terminal_bench_score": [{"value": "26%", "section": "بطاقة المقارنة المعيارية", "locator": "p.4"},{"value": "88.4%", "section": "المعيار المستقل", "locator": "p.5"}],
  "evidence_limits": {"value": "لا يمكن مقارنة نتيجتي اختبار Terminal-Bench لأنهما من إصدارين مختلفين من الاختبار. لم يتم ذكر مدى توفره في الوقت الفعلي.", "section": "اختبار أداء مستقل", "locator": "p.5"}
}
ما يثبت ذلك هو: يمكن للنموذج استخراج المعلومات وتنظيمها من حزمة كبيرة ومشوشة وفقًا لمخطط صارم. ما لا يثبته ذلك: أن كل طلب يتضمن 500 ألف توكن سيكون بنفس السرعة أو التكلفة المنخفضة أو الدقة، بغض النظر عن المستند المقدم من العميل.
هل يستطيع الطراز Grok 4.6 اتباع التعليمات بدقة والتفكير بطريقة شفافة؟
بالنسبة لمشكلة التخصيص المقيد، فقد أظهرت الحل الوحيد: 7 ساعات للبحث، و9 ساعات للبرمجة، و8 ساعات لضمان الجودة.
{"R":7,"C":9,"Q":8,"total":24,"check":"القيم تستوفي المعادلة R+C+Q=24، حيث C=R+2 و Q=R+1."}اعرض النص الدقيق للموجه
قسّم 24 ساعة بين البحث (R) والبرمجة (C) وضمان الجودة (Q). أرجع ملف JSON فقط يحتوي على مفاتيح عددية هي R و C و Q و total، بالإضافة إلى جملة واحدة للتحقق. القيد: R + C + Q = 24؛ C = R + 2؛ Q = R + 1. لا تذكر سلسلة التفكير الخفية.
لم تُرجع مهمة إعادة الكتابة المقيدة المنفصلة أي استجابة من واجهة برمجة التطبيقات (API) في محاولتين قام بهما العميل. وقد سُجل ذلك على أنه خلل في البنية التحتية، وليس كدرجة جودة. والدرس العملي المستفاد هو ضرورة الاحتفاظ بمسار بديل لعملية الإنتاج التحريري.
كم يبلغ سعر Grok 4.6؟
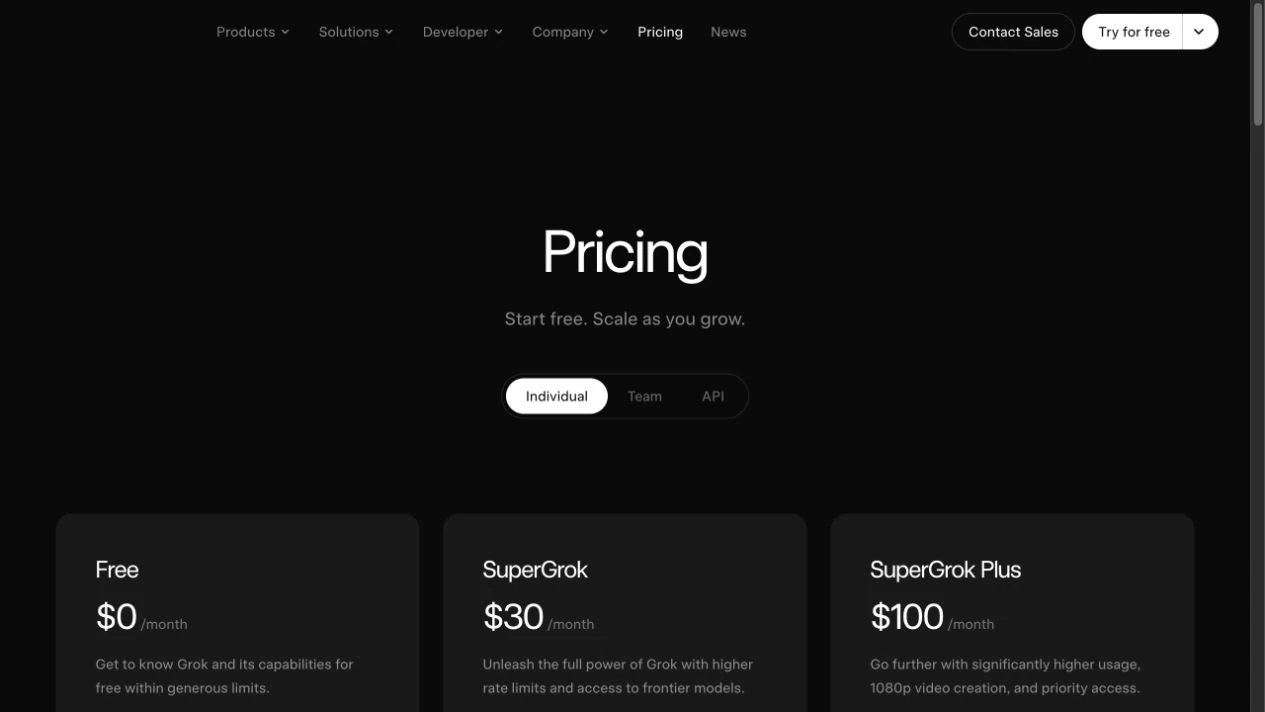
| الخيار | السعر الحالي المعلن | الأفضل لـ | حد مهم |
|---|---|---|---|
| xAI للمستهلكين - مجاني | $0/شهر | تجربة تجربة المستخدم الأصلية. | قد تتغير شروط الوصول إلى نموذج الخدمة المجانية والقيود المفروضة عليه. |
| سوبر جروك | $30/شهر | الاستخدام العادي من قبل المستهلك؛ تضم الصفحة الحالية الموديل Grok 4.6. | تحقق من الاستحقاق الحالي قبل النشر. |
| SuperGrok Plus | $100/شهر | استخدام مكثف من قبل المستهلكين؛ تضم الصفحة الحالية Grok 4.6. | لا تفترض إمكانية الوصول بالنسبة للخطط الأخرى. |
| المستوى الأساسي لواجهة برمجة تطبيقات xAI | مدخل $2/M؛ مخرج $6/M؛ مدخل مخزّن مؤقتًا $0.50/M | المطورون الذين يعملون على إنشاء تكاملات قائمة على الاستخدام. | يتم احتساب تكلفة الأدوات بشكل منفصل، حيثما ينطبق ذلك. |
| فئة السياق الطويل لواجهة برمجة تطبيقات xAI | فوق 200 ألف: مدخلات $4/M؛ مخزنة مؤقتًا $1/M؛ مخرجات $12/M | الموجهات والوثائق ذات الحجم الكبير جدًّا. | لا تستخدم السعر الأساسي لطلب يتجاوز 200 ألف. |
| جلوبال جي بي تي تي | اطلع على خطط GlobalGPT الحالية | مقارنة طراز Grok مع العديد من الطرازات الرائدة في مساحة عمل واحدة. | لا تفترض أن كل خطة تتضمن Grok 4.6؛ تحقق من صفحة الخطة. |
كم ستكون تكلفة طلب Grok 4.6 API؟
| مثال على طلب | الحساب | التكلفة التقديرية للرمز النموذجي |
|---|---|---|
| 50 ألف مدخلات + 5 آلاف مخرجات | 50 ألف × $2/M + 5 آلاف × $6/M | $0.13 |
| 100 ألف مدخل + 10 آلاف مخرج | 100 ألف × $2/M + 10 آلاف × $6/M | $0.26 |
| 250 ألف مدخل + 10 آلاف مخرج | 250 ألف × $4/M + 10 آلاف × $12/M | $1.12 |
| 400 ألف مدخلات + 20 ألف مخرجات | 400 ألف × $4/M + 20 ألف × $12/M | $1.84 |
أمثلة حسابية تستخدم الأسعار المعلنة من xAI. ولا تشمل هذه الأسعار خصومات المدخلات المخزنة مؤقتًا، والضرائب، ورسوم استدعاء الأدوات، وهامش ربح مزودي الخدمات الخارجيين.
يُعد GlobalGPT الخيار الأمثل عندما يكون سؤالك هو “ما النموذج الأنسب لهذه المهمة؟” بدلاً من “كيف يمكنني تخصيص واجهة برمجة تطبيقات واحدة لكل مهمة؟”. يمكنك مقارنة توجيهات الكتابة والبحث والبرمجة والتحليل في مساحة عمل واحدة، ثم استخدام صفحة أسعار GlobalGPT لاختيار الاشتراك الذي يتناسب مع استخدامك. هذه توصية باشتراك متعدد النماذج، وليست تحويلاً لرصيد GlobalGPT إلى أسعار توكنات xAI.
كيف يمكنك الوصول إلى Grok 4.6؟
يمكن للمستهلكين البدء بخيارات الاشتراك الحالية التي تقدمها xAI، وهي Grok. وينبغي على المطورين الرجوع إلى الوثائق الرسمية لواجهة برمجة تطبيقات xAI (API) ومعرف النموذج الدقيق grok-4.6. يمكن للقراء الذين يرغبون في مقارنة النماذج دون إنشاء حسابات API متعددة استخدام الإدخال المُثبت الخاص بمساحة العمل Grok 4.6 في جلوبال جي بي تي تي; ؛ ولا ينبغي الخلط بين إمكانية الوصول إلى واجهة مستخدم المنصة وبين كل ميزة أصلية في xAI.
ما هي أوجه القصور الرئيسية في طراز Grok 4.6؟
- المعلومات الحالية لا تزال بحاجة إلى أدلة: موعد 2026 يناير المحدد لبدء التدريب لا يُعد ضمانًا لاكتساب المعرفة العملية.
- قد تكون عناوين الأخبار المعيارية مضللة: يجب أن تظل النسخة، والمُقيِّم، والجهد البديهي، ومجموعة البيانات مرفقة بكل نتيجة.
- السياق الطويل يكلف أكثر: تستخدم المطالبات التي يتجاوز عدد الرموز فيها 200 ألف رمز المستوى الأعلى من واجهة برمجة التطبيقات (API) المخصصة للسياق الطويل.
- تختلف موثوقية المسار: واجه طلب التحرير المقيد الذي قدمناه عطلًا في البنية التحتية، على الرغم من نجاح المهام الأخرى.
- الوصول إلى المنصات يختلف من منصة إلى أخرى: لا يعني إدخال مساحة العمل GlobalGPT توفر كل ميزة أصلية في xAI أو كل حق اشتراك.
هل يجب أن تختار نموذج Grok 4.6 أم نموذجًا آخر للذكاء الاصطناعي؟
اختر نموذج Grok 4.6 عندما يكون السياق المطول والترميز والاستدلال المنظم عناصر أساسية في العمل. اختر نموذجًا مختلفًا عندما تكون أولويتك الرئيسية هي نظام بيئي محدد للأدوات، أو تكلفة أقل يمكن التنبؤ بها، أو ناتج متعدد الوسائط معين، أو سير عمل يدعمه فريقك جيدًا بالفعل. المقارنة الأكثر عدلاً هي استخدام نفس المطالبة، ونفس حزمة المصدر، ونفس أداة التدقيق عبر النماذج المختلفة — وهو أمر يسهل تنظيمه باستخدام GlobalGPT.
من ينبغي أن يستخدم Grok 4.6؟
- الباحثون والمحللون: حزم المستندات الأصلية، وجداول الأدلة، والمذكرات المطولة.
- المطورون: تصحيح الأخطاء، ومراجعة الكود، وخطط التنفيذ المنظمة.
- المؤلفون والمحررون: صياغة النصوص الطويلة عندما تقدم توجيهات واضحة ودليلًا للأسلوب.
- الفرق التي تقارن النماذج: تقييمات متكررة باستخدام نفس المطالبة في مساحة عمل واحدة.
ما هي الأسئلة التي يطرحها القراء عادةً بشأن Grok 4.6؟
هل تم الإصدار الرسمي لـ Grok 4.6؟
نعم. تاريخ إعلان xAI عن إطلاق المنتج هو 12 أغسطس 2026.
ما هو معرّف نموذج واجهة برمجة التطبيقات (API) الرسمي؟
grok-4.6.
ما هي نافذة السياق؟
تقوم xAI بتوثيق نافذة سياق تضم 500 ألف توكن.
هل يدعم الطراز Grok 4.6 الصور؟
نعم. تذكر الوثائق الرسمية للنموذج أن المدخلات عبارة عن صور والمخرجات عبارة عن نصوص.
كم يساوي Grok 4.6؟
تعرض صفحة المستهلك الحالية باقة «Free» بسعر $0 شهريًّا، وباقة «SuperGrok» بسعر $30 شهريًّا، وباقة «SuperGrok Plus» بسعر $100 شهريًّا. يعتمد تسعير واجهة برمجة التطبيقات (API) على الاستخدام، ويوجد مستوى تسعير منفصل للاستخدامات طويلة المدى التي تتجاوز 200 ألف توكن.
هل طراز Grok 4.6 أفضل من طراز Grok 4.5؟
إنه أحدث ويحقق أداءً قويًّا في العديد من التقييمات المذكورة، لكن المهام وإصدارات المعايير المقارنة تختلف. اختبر سير العمل المتكرر الخاص بك.
هل يمكنني استخدام Grok 4.6 في GlobalGPT؟
يحتوي GlobalGPT على إدخال مساحة عمل Grok 4.6 تم عرضه. يرجى التأكد من استحقاق الخطة الحالي في صفحة الأسعار.
هل يُعد Grok 4.6 مصدرًا موثوقًا به للأبحاث؟
وقد حقق أداءً جيدًا في اختبار حزم البيانات المحدودة المصدر، لكن ينبغي دائمًا التحقق من صحة الادعاءات المهمة بالرجوع إلى المصدر المذكور.
هل يستحق طراز Grok 4.6 الاستخدام في عام 2026؟
يُعد Grok 4.6 نموذجًا موثوقًا تم إصداره رسميًا، ويتميز بنافذة سياق مفيدة تبلغ 500 ألف، وقدرة استدلال قابلة للتكوين، وأدلة قوية من اختبارات الأداء المنشورة، ونتائج جيدة في الجولة الأولى في مهام البحث المنظم والمستندات الطويلة. وتتمثل نقاط ضعفه في جوانب عملية أيضًا: حيث تتطلب أرقام اختبارات الأداء تحديد إصدارات دقيقة، ولا تزال الحقائق الحية بحاجة إلى مصادر، وقد تتفاوت موثوقية المسار.
للوصول المباشر للمستهلكين أو لتطوير واجهة برمجة التطبيقات (API)، ابدأ بالاطلاع على الوثائق الحالية الخاصة بـ xAI. وللحصول على سير عمل قائم على المقارنة،, جرب Grok 4.6 في GlobalGPT إلى جانب نماذج رائدة أخرى، اختر الخطة التي تناسب حجم عملك في الكتابة أو البحث أو التحليل أو البرمجة.
المصادر الأولية: إصدار xAI, وثائق نموذج xAI, أسعار واجهة برمجة تطبيقات xAI, أسعار xAI للمستهلكين, التحليل الاصطناعي, ميركور APEX-SWE و بطاقة نموذج xAI.