
إجابة سريعة: أكمل «GPT-6 Sol» الملخص المكون من خمسة أقسام الذي خضع للاختبار في إطار حد أقصى للإخراج يبلغ 2,400 توكن؛ أما «Claude Opus 5.5» فقد قدم تشخيصًا أكثر دقة في مهمة مراجعة الكود القصيرة التي أجريناها. ولا تُثبت أي من هاتين النتيجتين وجود فائز عام نهائي.
المقارنة المفيدة تتجاوز مجرد النتيجة. يختلف كل من Claude Opus 5.5 وGPT-6 Sol في طريقة تعاملهما مع الكتابة، وتوليف الأبحاث، ومراجعة الأكواد البرمجية، والاستجابات المنظمة، ومسارات الوصول، وسير العمل اليومي. وتُظهر نتائج المهام الواردة أدناه المجالات التي تبرز فيها أهمية هذه الاختلافات.
جلوبال جي بي تي تي يوفر لك كلا النموذجين ضمن اشتراك واحد متعدد النماذج وبسعر مناسب، إلى جانب نماذج أخرى وقدرات الذكاء الاصطناعي. يمكن لوحدة التحكم الواحدة أن تدير مشروعًا بدءًا من البحث والكتابة وصولًا إلى البرمجة والصور والفيديو، بينما تربط واجهة سطر الأوامر (CLI) الخاصة بها نفس سياق العمل بأدوات المحطة الطرفية وأدوات الإنتاج.
إجابة سريعة
اختر GPT-6 Sol أولاً، فيما يتعلق بسير عمل الكتابة المقيدة الذي تم اختباره هنا؛ فقد أكمل جميع الأقسام الخمسة في حدود السعة القصوى المشتركة للإخراج البالغة 2,400 رمز. اختر Claude Opus 5.5 عندما يكون التشخيص، والتحليل الصريح للمخاطر، واتباع معايير JSON الصارمة أمورًا أكثر أهمية. استخدم كلاهما عندما يتغير شكل العمل خلال اليوم.
ما الذي يتفوق فيه كل طراز
Claude Opus 5.5 يناسب العمل المدروس: مراجعة تغيير في الكود، وتفكيك متطلبات معقدة، وتحديد المخاطر، والحفاظ على اتفاقية مخرجات صارمة. يركز نهج «Anthropic» على البرمجة، واستخدام الكمبيوتر، والعمل المعرفي، والسلامة، والتواصل الأكثر طبيعية خلال الجلسات الطويلة. انظر مراجعة Claude Opus 5.5 للحصول على عرض منفصل يركز على النموذج. ويُعد هذا خيارًا طبيعيًّا عندما تكون المراجعة الثانية الدقيقة أكثر قيمة من الإجابة الأولى الموجزة.
GPT-6 Sol يتناسب مع حجم الإنتاج في ظل القيود: تقرير مطول، أو مذكرة قرار، أو خطة منظمة، أو مسودة يجب أن تتضمن العديد من الأقسام المطلوبة. يصفه OpenAI بأنه نموذج GPT-6 أكثر تكلفة معقولة للأعمال المهنية، والتحقق من صحة المعلومات، والبرمجة، واستخدام الكمبيوتر، والتعاون. الـ مراجعة GPT-6 Sol يغطي النموذج بحد ذاته؛ ففي المهمة المطولة هنا، أكمل النموذج العقد في الناتج الأول، وهو أمر مفيد عندما تكون تكلفة فقدان جزء ما مرتفعة.
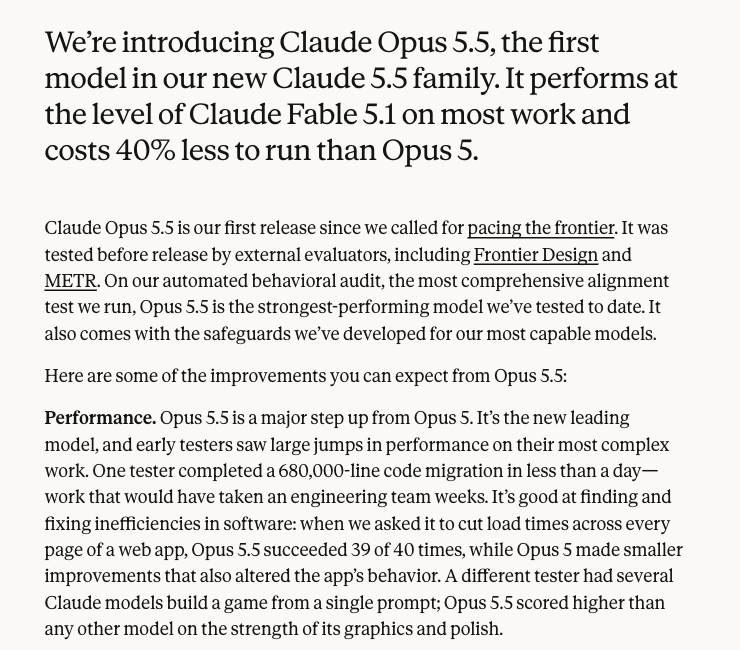
هذا هو تقرير Anthropic الخاص عن الإصدار، بما في ذلك أمثلة من المختبرين الأوائل. وهو يدعم التوجه المقصود للمنتج؛ ولا يقدم نتيجة مقارنة مباشرة مع GPT-6 Sol. تتناول المطالبات المتطابقة الواردة أدناه السؤال الأضيق المتعلق بما قدمه كل نموذج في هذه الجولة.
مقارنة الميزات والقدرات
Claude Opus 5.5 مقابل GPT-6 Sol: خريطة القدرات
| مجال اتخاذ القرار | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| الكتابة الطويلة | يتميز بقدرة قوية على الصياغة الدقيقة والمتنوعة، وبإدراج التحفظات الصريحة | يتميز بقدرته على إنجاز مهمة طويلة تتضمن قيودًا متعددة في محاولة واحدة |
| توليف البحوث | التسوية التفصيلية وشرح المخاطر | ملخص موجز مع توصية واضحة |
| البرمجة والمراجعة | التشخيص الدقيق والإبلاغ المنظم عن المخاطر | تصحيحات بسيطة ومفيدة؛ التحقق من صحة تفسيرات الحالات الاستثنائية |
| المخرجات المنظمة | صيغة JSON دقيقة وموثوقة في المهمة التي خضعت للاختبار | ملف JSON صالح يحتوي على جميع المفاتيح المطلوبة في المهمة التي تم اختبارها |
| الوسائط المتعددة والأدوات | تحقق من المسار وطريقة الوصول الخاصة بالمهمة المحددة | تحقق من المسار وطريقة الوصول الخاصة بالمهمة المحددة |
| أفضل أسلوب عمل | المراجعة المدروسة، والاستدلال المعقد، والعمل الذي يراعي المخاطر | تم إنجاز الملخص المقيد الذي خضع للاختبار في إطار الحد الأقصى المحدد للإنتاج |
كيفية قراءة هذا: هذه اتجاهات تتعلق بسير العمل، وليست قائمة ترتيب عالمية. يعتمد الاختيار الصحيح على ما إذا كنت تفضل المراجعة المتأنية أم إنجاز هذا الملخص المكثف في إطار الحد الأقصى نفسه للإنتاج.
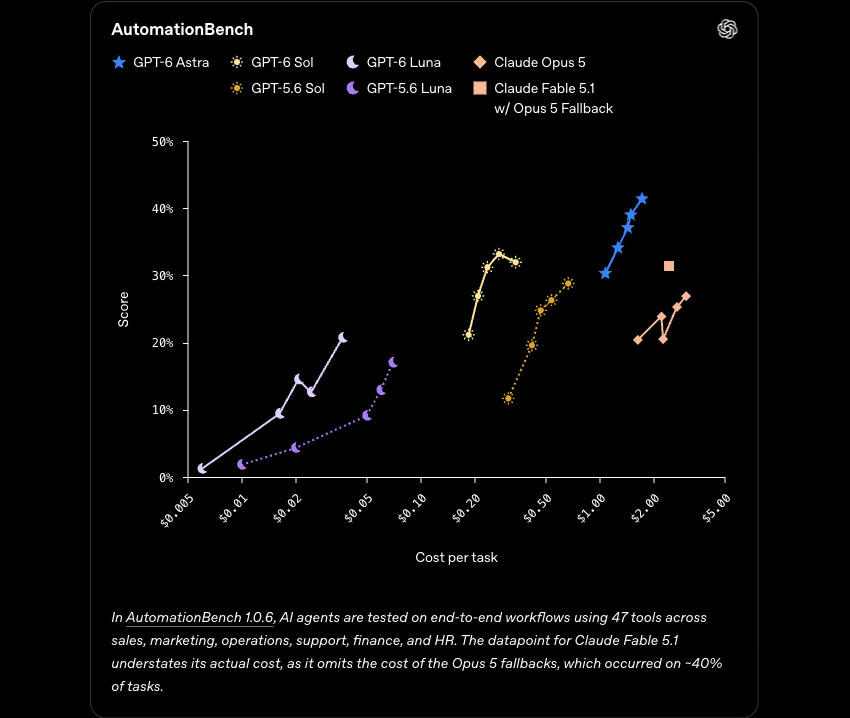
اقرأ كلا المحورين: فالتحرك صعودًا يشير إلى درجة أعلى، بينما يشير التحرك إلى اليسار إلى تكلفة أقل لكل مهمة. سلسلة Claude المذكورة هنا هي Opus 5، وليست Opus 5.5. يساعد هذا الرسم البياني الذي قدمه الناشر في توضيح مكانة Sol من حيث الكفاءة من حيث التكلفة؛ لكنه لا يمكن أن يحسم المقارنة الواردة في هذا المقال. تشير الحاشية أيضًا إلى أن نقطة البيانات الخاصة بلعبة Fable تغفل بعض التكاليف الاحتياطية.
الكتابة، والوثائق الطويلة، وتوليف الأبحاث
فيما يتعلق بالكتابة، يميز هذا الاختبار بين إنجاز المهمة في إطار حد أقصى محدد للنتائج وجودة المراجعة التحريرية. وقد حقق نموذج GPT-6 Sol أداءً أقوى في المهمة الطويلة. أما نموذج Claude Opus 5.5 فقد حقق أداءً أقوى عندما كانت المهمة تتمثل في التشخيص والتقييم والشرح. أما بالنسبة للملاحظات البحثية، فقد توصل كلا النموذجين إلى نفس النتيجة العملية، لذا تظل جودة المادة المصدرية وعملية المراجعة أكثر أهمية من مجرد تحديد الفائز في العنوان.
- استخدم GPT-6 Sol لكتابة مسودة أولية تتضمن العديد من القيود، أو مذكرة قرار، أو خطة محتوى منظمة.
- استخدم Claude Opus 5.5 لتحدي الافتراضات، وكشف المخاطر، وصقل المسودة قبل أن تصل إلى العميل أو نظام الإنتاج.
- عندما تكون الدقة أمرًا مهمًا، قم بتزويد أي من النموذجين بالمواد المصدرية واحرص على الاحتفاظ بخطوة المراجعة البشرية.
البرمجة، والمخرجات المنظمة، والعمل الجاهز للاستخدام مع الأدوات
أرجع كلا النموذجين بيانات JSON صالحة تحتوي على جميع المفاتيح المطلوبة ونفس التصحيح البسيط. وصف Claude المرشح الحالي بشكل صحيح؛ بينما ذكر GPT-6 Sol خطأً أن عنصر «None» سيؤدي إلى ظهور خطأ. وهذا يدعم استخدام Claude للتشخيص في هذه المهمة بالذات. لم يتم تحديد نوع حقل «risk» في المطالبة، لذا فإن سلسلة «risk» التي قدمها Sol لا تشكل انتهاكًا للعقد.
بالنسبة للأعمال الجاهزة للاستخدام مع الأدوات، قم بتقييم مواصفات المخرجات التي تحتاجها فعليًّا: تنسيق JSON صحيح، وحقول مكتملة، وأوامر قابلة للتكرار، وتصحيح يمكن تطبيقه دون الحاجة إلى تفسير. يمكن أن يكون كلا النموذجين جزءًا من مسار العمل هذا، مع إشراك الاختبارات والمراجعة في العملية.
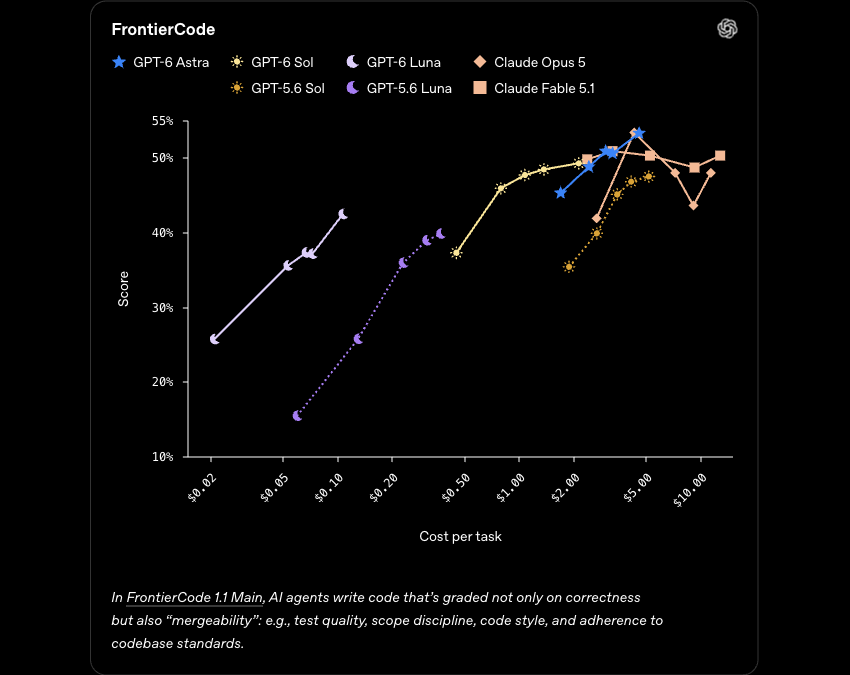
يغطي هذا المعيار الترميز العملي (agentic coding) بشكل أوسع مقارنةً بموجه مراجعة الكود القصير الخاص بنا. إن المقارن في اختبار Claude هو Opus 5، لذا فهو يمثل سياقًا لتقييم أداء الترميز الخاص بـ Sol، وليس دليلًا على أن Sol يتفوق على Opus 5.5. وفي المهمة التي أجريناها، كان كلا التصحيحين صحيحين؛ وكان الفرق المهم هو دقة التشخيص.
السعر وإمكانية الوصول
السعر وإمكانية الوصول: قارن المسار، وليس الطراز فحسب
| المسار | ما الذي تدفع مقابله | عندما يكون ذلك منطقيًّا |
|---|---|---|
| Claude Opus 5.5 API | تُدرج Anthropic في صفحة الإصدار المؤرخة في 22 سبتمبر 2026 القيم التالية: $4 لكل مليون رمز إدخال، و$20 لكل مليون رمز إخراج، و$0.20 لكل مليون رمز قراءة من ذاكرة التخزين المؤقت | أنت تعمل على تطوير منتج أو مسار عمل آلي وترغب في استخدام نظام الفوترة المباشرة باستخدام الرموز الرقمية |
| واجهة برمجة تطبيقات GPT-6 Sol | يحدد سعر OpenAI $2 لكل مليون رمز إدخال و$10 لكل مليون رمز إخراج، مع خصم قدره 50% مقارنةً بالسعر الترويجي لـ GPT-5.6 Sol؛ كما تحصل عمليات قراءة الإدخال المخزنة مؤقتًا على خصم قدره 90% | تحتاج إلى عقد API مع مزود مباشر وترغب في تكلفة أقل على أساس الاستهلاك للعمليات المستمرة |
| جلوبال جي بي تي تي | اشتراك واحد بأسعار معقولة يشمل كلا الطرازين بالإضافة إلى العديد من الطرازات الأخرى ووظائف الذكاء الاصطناعي | هل تريد دمج أعمال البحث والكتابة والبرمجة ومعالجة الصور والفيديو في لوحة تحكم واحدة؟ |
هذه الأرقام تمثل أسعار رموز API، وليست أسعار الاشتراكات. يضع OpenAI نموذج GPT-6 Sol في موقع العضو الأقل تكلفة في عائلة GPT-6 للأعمال المهنية، والتحقق من صحة المعلومات، والبرمجة، واستخدام الكمبيوتر، والتعاون، بينما يضع Anthropic نموذج Claude Opus 5.5 في مجال البرمجة، واستخدام الكمبيوتر، والأعمال المعرفية، والسلامة، والتواصل. يُتيح GlobalGPT كلا النموذجين وبقية سلسلة الأدوات من خلال اشتراك واحد ميسور التكلفة، بينما تربط واجهة سطر الأوامر (CLI) الخاصة به هذا الوصول بمحطة طرفية وسير عمل التطوير وأدوات الإنتاج الحالية.
المصادر الأولية: صفحة الإصدار Claude Opus 5.5 من Anthropic و صفحة إصدار «Sol» و«Luna» من GPT-6 على موقع OpenAI.
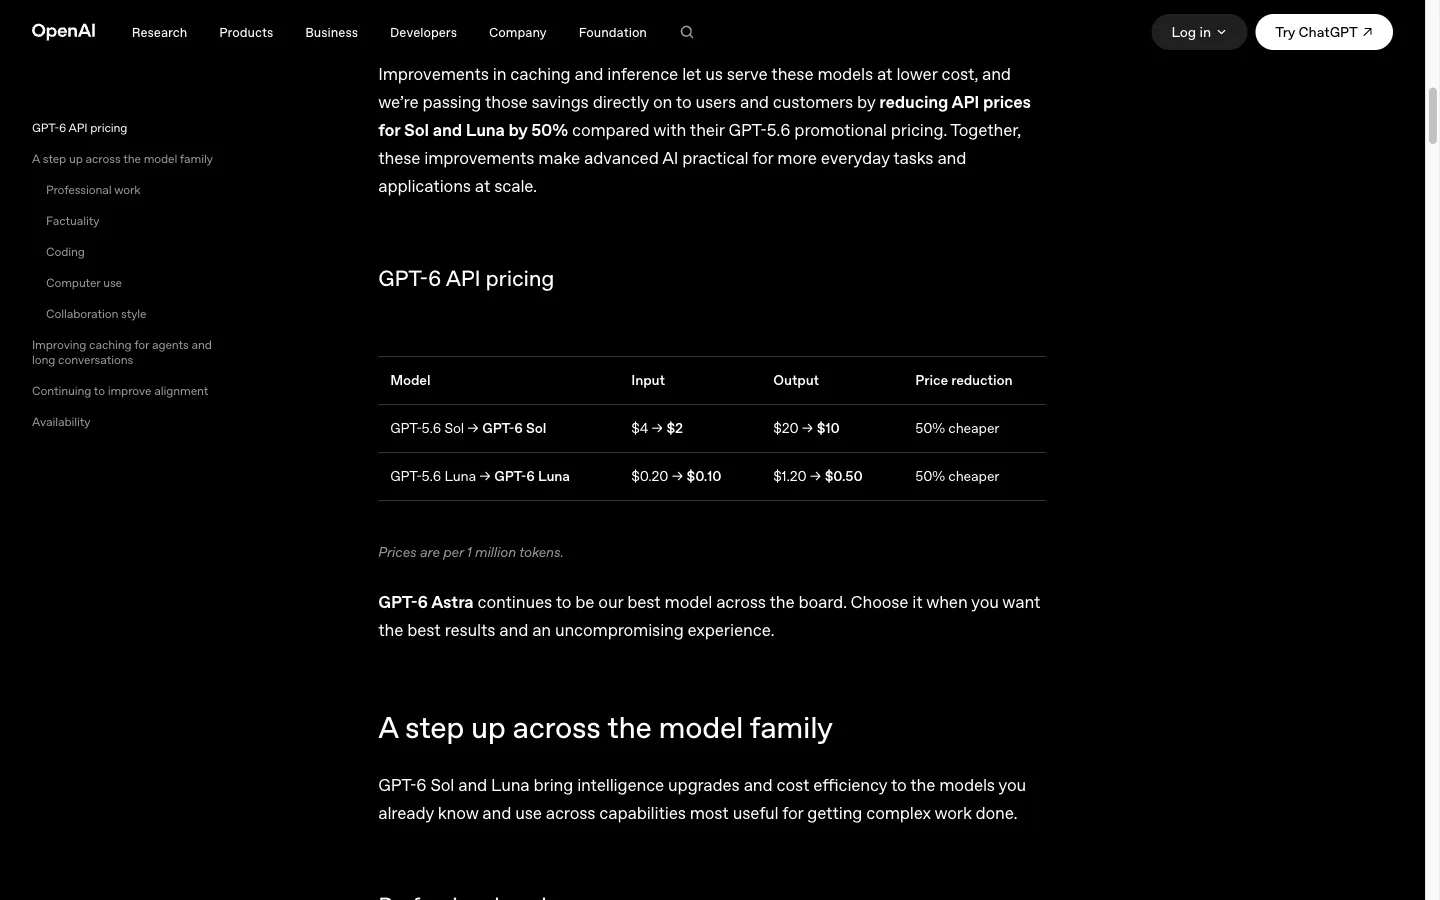
تنطبق هذه الأسعار على رموز API. وهي لا تشمل الاشتراك الشهري للمستهلكين أو خطة GlobalGPT.
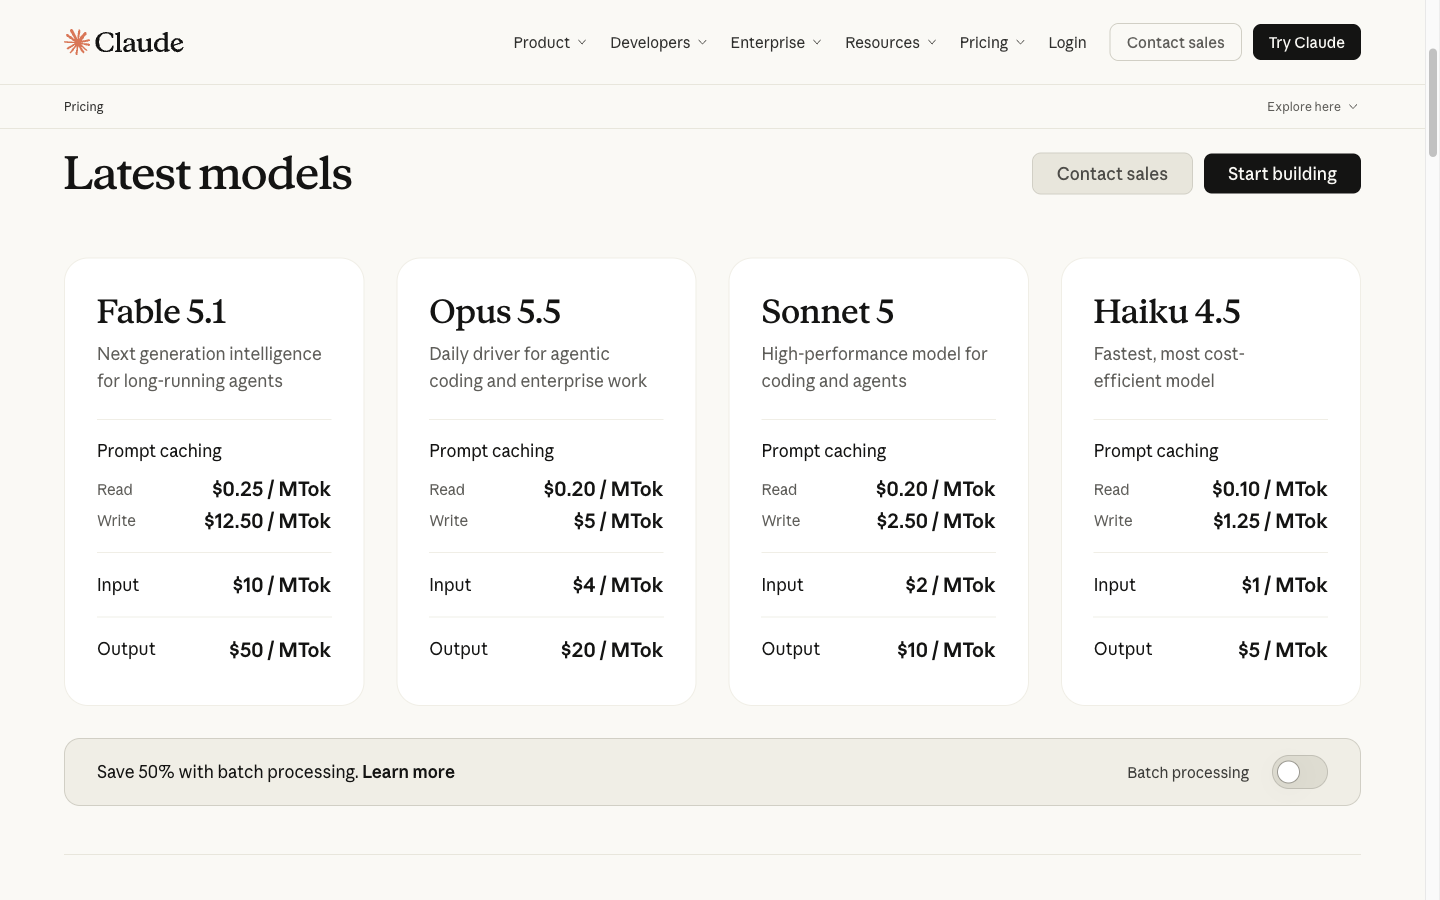
تبلغ معدلات الإدخال والإخراج القياسية لـ Opus 5.5 ضعف معدلات Sol، في حين أن معدلات القراءة من ذاكرة التخزين المؤقت المنشورة لكل منهما تبلغ $0.20/M. وبالتالي، قد تختلف الفجوة في التكلفة بين سير العمل الذي يعتمد بشكل مكثف على ذاكرة التخزين المؤقت وسير العمل الذي لا يعتمد عليها؛ لذا، قم بمقارنة نفس مزيج الرموز قبل اتخاذ القرار بناءً على السعر.
ماذا يعني فارق السرعة بالنسبة لنفس حجم العمل
مثال حسابي: مليون رمز إدخال غير مخزّن في ذاكرة التخزين المؤقت + 100,000 رمز إخراج, ، أسعار واجهة برمجة التطبيقات (API) القياسية. اللون الأزرق المخضر يمثل تكلفة المدخلات؛ واللون البني يمثل تكلفة المخرجات.
تكلفة «Sol» تبلغ نصف تكلفة هذا المزيج المطابق من الرموز. وهذا حساب يستند إلى قائمة الأسعار، وليس ادعاءً بأن تكلفة كل مهمة مكتملة تبلغ نصف التكلفة: فقد تؤدي عمليات إعادة المحاولة، وطول المخرجات، وعدد مرات الوصول إلى ذاكرة التخزين المؤقت، ورسوم الأدوات، وإعدادات الاستدلال إلى تغيير الفاتورة.
المصادر: أسعار واجهة برمجة التطبيقات (API) لـ Anthropic و أسعار الإصدار OpenAI, ، تم التحقق منه في 25 سبتمبر 2026.تقدير التكلفة المباشرة لواجهة برمجة التطبيقات (API)
حاسبة تكلفة واجهة برمجة التطبيقات (API)
أدخل الرموز التي تتوقع إرسالها واستلامها. يستخدم التقدير أسعار واجهة برمجة التطبيقات (API) التي تم التحقق منها أعلاه: Claude Opus 5.5 عند إدخال $4/M وإخراج $20/M؛ و GPT-6 Sol عند إدخال $2/M وإخراج $10/M.
| نموذج | معدل الإدخال | معدل الإنتاج | التكلفة التقديرية |
|---|---|---|---|
| Claude Opus 5.5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
هذا تقدير للفوترة بالوحدات الاستهلاكية لاستخدام واجهة برمجة التطبيقات (API) بشكل مباشر. ولا يشمل هذا التقدير سعر اشتراك المستخدم أو خطة GlobalGPT، كما يستثني خصومات ذاكرة التخزين المؤقت والأدوات والضرائب والرسوم الأخرى الخاصة بالمزود.
من الذي يجب أن يختار أي طراز؟
أي طراز يجب أن تختار؟
| أولويتك | اختر أولاً | لماذا |
|---|---|---|
| مذكرة طويلة ومحكمة الصياغة تتضمن العديد من القيود | GPT-6 Sol | وصلت المهمة المطولة المنقحة إلى قاعدة القرار المطلوبة في نتيجة واحدة |
| تشخيص الأكواد، والالتزام الصارم بمعايير JSON، والمخاطر الصريحة | Claude Opus 5.5 | أسفرت مهمة الترميز عن تشخيص أكثر دقة وقائمة أكثر دقة بالمخاطر |
| ملاحظات بحثية تحتاج إلى مطابقة | أو | انتهت مهمة «التوليف من مصدر خاضع للرقابة» بالتعادل |
| سير عمل أسبوعي متنوع | GlobalGPT مع كليهما | احتفظ باختيار النموذج، والكتابة، والبرمجة، والصور، والفيديو في لوحة تحكم واحدة؛ واستخدم واجهة سطر الأوامر (CLI) عندما ينتقل العمل إلى محطة طرفية |
استخدم كلا النموذجين في مسار عمل واحد متكامل
مسار عمل عملي لنظام GlobalGPT
- ابدأ بموجز بحثي واطلب من أحد النماذج أن يكشف عن الافتراضات.
- انقل الملخص الذي تم تنقيحه إلى العارض الآخر من أجل صياغته أو للحصول على رأي ثانٍ.
- استخدم أسلوب البرمجة الأكثر قوة في التنفيذ والمراجعة وإخراج النتائج المنظمة.
- احتفظ بالعمل الناتج في نفس لوحة التحكم، ثم استخدم مسار عمل واجهة المستخدم النصية (CLI) لـ GlobalGPT عندما يتعين إدخالها في جهاز طرفي أو أداة إنتاج.
يُعد هذا المسار العملي القيمة الرئيسية للوصول إلى كلا النموذجين: حيث يمكنك توجيه المهمة، بدلاً من إعادة صياغة عمليتك لتتناسب مع نموذج واحد.

كيف تم إجراء المقارنة
تلقى كلا النموذجين نفس رسالة النظام، ومدخلات المهام، والمواد المصدرية، ولم يتم استخدام أي أدوات أو تصفح. تحتفظ كل نتيجة بأول ناتج تم إرجاعه، بما في ذلك الاقتطاع الناتج عن حد الناتج. هذه مقارنة عملية لاختيار مسار العمل، وليست تصنيفًا شاملاً لكل القدرات.
طريقة المقارنة
كيف تم إجراء هذه المقارنة
| الحالة | قاعدة المقارنة |
|---|---|
| نماذج | Claude Opus 5.5 و GPT-6 Sol، تم تأكيد المعرّفات الدقيقة في دليل النماذج الحية |
| التكافؤ الفوري | نفس رسالة النظام، وموجه المهمة، والمواد المصدرية، دون استخدام أي أدوات أو تصفح |
| المهام | فحص حدود T01، مقارنة صريحة طويلة الشكل T01R، توليف المصدر T02، الكود/JSON T03 |
| محاولات إعادة | يقتصر الأمر على حالات الفشل المتعلقة بالنقل/السعة/المغلف الفارغ؛ ويتم الاحتفاظ بالمخرجات الضعيفة الصالحة |
| التسجيل | 10 نقاط لكل مهمة تم إنجازها: العقد الموضوعي 4، قابلية التتبع 3، الفائدة 2، التنسيق 1 |
تتولى المهمة الأولى التحقق مما إذا كان النموذج سيقوم بالتخمين في حالة فقدان السياق الرئيسي، لذا يتم فصلها عن عملية حساب النموذج الفائز. وتقوم المقارنة المباشرة بتسمية كلا النموذجين وتزويدهما بنفس التعليمات. ولم يتم استخدام أي عمليات إعادة تشغيل للتحقق من الاستقرار.
لماذا لم تختر المهمة الأولى فائزًا؟
معالجة السياق
لماذا لم تختر المهمة الأولى فائزًا؟
رفض كلا النموذجين ابتكار هويات للعارضات لأن الموجه الأصلي لم يذكر أسماءهن. وهذا هو الرد الصحيح في حالة عدم توفر السياق، لكنه لا يمكن أن يخبرنا أي النموذجين أفضل في أداء المهمة نفسها.
Claude Opus 5.5 · مدخلات كاملة
أنت تقوم بمقارنة نموذجين للذكاء الاصطناعي من أجل إعداد دليل عملي للمشترين. باستخدام الحزمة المصدرية الواردة أدناه فقط، اكتب ما بين 700 و900 كلمة مع استخدام العناوين التالية بالضبط: «القرار»، «الأدلة»، «المحاذير»، «الخطوة التالية». احرص على الحفاظ على هذه الحقائق بالضبط: مشروع «نورث» له موعد نهائي مدته 12 أسبوعًا؛ وميزانية الترحيل هي $48,000؛ ولم يتم تحديد موعد للمراجعة الأمنية. إذا كانت هناك حقيقة لم يتم البت فيها، فاذكر ذلك صراحةً. لا تختلق أسعارًا أو معايير قياس أو قدرات منتجات.

حزمة المصادر:
مشروع «نورث» هو عملية ترحيل مدتها 12 أسبوعًا لفريق مكون من 40 شخصًا. تبلغ ميزانية الترحيل المعتمدة $48,000. لم يتم تحديد موعد للمراجعة الأمنية. يريد الفريق توصية نموذجية بشأن البحث والكتابة ومراجعة الكود. تشير ملاحظة من أحد أصحاب المصلحة إلى أن المسودة الحالية طويلة جدًّا، لكنها لا تذكر عدد الكلمات.

يرجى إعادة الدليل فقط.
Claude Opus 5.5 · الإخراج الكامل
## القرار

لا يمكن تقديم أي توصية بين النموذجين استنادًا إلى حزمة البيانات المصدرية المتوفرة. فالحزمة لا تحدد اسم أي من النموذجين ولا تذكر أي أسعار أو نتائج اختبارات الأداء أو قدرات المنتج. واختيار أحد النموذجين على الآخر في هذه المرحلة يعني اختلاق الأدلة التي من المفترض أن يعتمد عليها هذا الدليل.

القرار العملي هو تأجيل اختيار النموذج. تعامل مع المرحلة التالية على أنها تقييم منظم تخضع لثلاثة قيود ثابتة:

- الموعد النهائي لمشروع "نورث" هو 12 أسبوعًا.
- تبلغ ميزانية الترحيل $48,000.
- لم يتم تحديد موعد للمراجعة الأمنية.

يجب أن يتناسب أي نموذج يتم المضي قدمًا في اعتماده مع الموعد النهائي البالغ 12 أسبوعًا وميزانية الترحيل البالغة $48,000. كما يجب أن يجتاز مراجعة أمنية، وهذه المراجعة لم تُحدد بعد في الجدول الزمني. إلى أن يتم تحديد النموذجين وتقييمهما وفقًا للاستخدامات الثلاثة المعلنة للفريق (البحث، والكتابة، ومراجعة الكود)، يظل الاختيار معلّقًا. يوضح هذا الدليل ذلك بوضوح بدلاً من تقديم تفضيل لا تدعمه الأدلة.

## الأدلة

تحتوي حزمة المصادر على الحقائق التالية، وهذه الحقائق وحدها هي التي تستند إليها هذه الإرشادات:

- **النطاق والتوقيت:** مشروع «نورث» هو عملية ترحيل مدتها 12 أسبوعًا.
- **حجم الفريق:** تخدم عملية الترحيل فريقًا مكونًا من 40 شخصًا.
- **الميزانية:** تبلغ ميزانية عملية الترحيل المعتمدة $48,000.
- **الأمن:** لم يتم تحديد موعد لمراجعة الأمان.
- **حالات الاستخدام:** يرغب الفريق في الحصول على توصية بنموذج مخصص للبحث والكتابة ومراجعة الكود.
- **ملاحظات أصحاب المصلحة:** تشير ملاحظة من أحد أصحاب المصلحة إلى أن المسودة الحالية طويلة جدًّا، لكنها لا تذكر عدد الكلمات.

لا تحتوي الحزمة على العديد من العناصر التي عادةً ما تستند إليها المقارنة. فهي لا تحدد النموذجين قيد المقارنة. كما أنها لا تحدد أسعار كل مقعد، أو كل رمز، أو أسعار الاشتراك لأي من الخيارين. ولا تقدم أي درجات قياسية ولا نتائج من الاختبارات الداخلية. ولا تصف ما يمكن أو لا يمكن لأي من النموذجين القيام به في مجال البحث والكتابة ومراجعة الكود. ولا تتطرق إلى شروط معالجة البيانات، أو خيارات النشر، أو متطلبات التكامل.

ونظرًا لعدم ظهور أي من هذه العناصر في الحزمة، فإن هذا الدليل لا يقدم تقديرات بشأنها. ومن غير المعروف ما إذا كان أي من النموذجين يتناسب مع ميزانية $48,000 لفريق مكون من 40 شخصًا. كما أنه من غير المعروف ما إذا كان أي من النموذجين يقدم أداءً أفضل في مجال البحث أو الكتابة أو مراجعة الكود. وأي رقم أو ادعاء بقدرات يُضاف هنا سيكون ملفقًا.

## التحفظات

هناك عدة أسئلة لم يتم حلها تؤثر على كيفية تفسير هذا القرار.

**هوية النموذجين لم يتم تحديدها.** تتعلق المقارنة بنموذجين للذكاء الاصطناعي، لكن الحزمة لا تحدد أيهما. يعتمد كل حكم لاحق على الإجابة عن هذا السؤال أولاً.

**نطاق الميزانية لم يتم تحديده بعد.** تصف الوثيقة الرقم $48,000 بأنه «ميزانية الترحيل المعتمدة». ولا تذكر ما إذا كان هذا المبلغ مخصصًا لتغطية رسوم ترخيص النماذج أو رسوم الاستخدام. وبدلاً من ذلك، قد يغطي فقط أعمال الترحيل مثل وقت الموظفين، أو الأدوات، أو الخدمات. إذا كان لا بد أن تُغطى تكاليف النموذج من نفس المبلغ $48,000، فإن الهامش المالي المتاح لأي من النموذجين يكون أضيق مما يوحي به الرقم الإجمالي. وهذا الأمر يحتاج إلى تأكيد.

**توقيت المراجعة الأمنية لم يتم تحديده بعد، وهو ما يشكل خطرًا على الجدول الزمني.** لم يتم تحديد موعد للمراجعة الأمنية. مع وجود مهلة مدتها 12 أسبوعًا، يمثل الاستعراض غير المجدول خطرًا حقيقيًّا على الجدول الزمني. لا تذكر الحزمة المدة التي يستغرقها الاستعراض أو ما إذا كان الفشل في الاستعراض سيجبر على التحول إلى النموذج الآخر. قد تستهلك كلتا النتيجتين جزءًا كبيرًا من الـ 12 أسبوعًا. لا ينبغي اعتبار أي نموذج معتمدًا حتى اكتمال الاستعراض.

**لم يتم تحديد ترجيح حالات الاستخدام بعد.** حدد الفريق ثلاث حالات استخدام: البحث، والكتابة، ومراجعة الكود. لا يوضح الملف ما إذا كانت هذه الحالات متساوية في الأهمية أم أن إحداها تهيمن على الباقي. قد يكون النموذج الأقوى في مجال ما أضعف في مجال آخر، وبدون ترجيح لا يوجد أساس للموازنة بين هذه الجوانب.

**حجم الاستخدام لم يتم حسمه بعد.** يضم الفريق 40 شخصًا، لكن الحزمة لا تذكر عدد الذين سيستخدمون النموذج أو مدى كثافة استخدامهم له. قد يؤثر حجم الاستخدام تأثيرًا قويًّا على التكلفة في ظل بعض هياكل التسعير. ولا يمكن تقييم ذلك دون بيانات التسعير وتقديرات الاستخدام.

**تعليمات المدة...**
GPT-6 Sol · المدخلات الكاملة
أنت تقوم بمقارنة نموذجين للذكاء الاصطناعي من أجل إعداد دليل عملي للمشترين. باستخدام الحزمة المصدرية الواردة أدناه فقط، اكتب ما بين 700 و900 كلمة مع استخدام العناوين التالية بالضبط: «القرار»، «الأدلة»، «المحاذير»، «الخطوة التالية». احرص على الحفاظ على هذه الحقائق بالضبط: مشروع «نورث» له موعد نهائي مدته 12 أسبوعًا؛ وميزانية الترحيل هي $48,000؛ ولم يتم تحديد موعد للمراجعة الأمنية. إذا كانت هناك حقيقة لم يتم البت فيها، فاذكر ذلك صراحةً. لا تختلق أسعارًا أو معايير قياس أو قدرات منتجات.

حزمة المصادر:
مشروع «نورث» هو عملية ترحيل مدتها 12 أسبوعًا لفريق مكون من 40 شخصًا. تبلغ ميزانية الترحيل المعتمدة $48,000. لم يتم تحديد موعد للمراجعة الأمنية. يريد الفريق توصية نموذجية بشأن البحث والكتابة ومراجعة الكود. تشير ملاحظة من أحد أصحاب المصلحة إلى أن المسودة الحالية طويلة جدًّا، لكنها لا تذكر عدد الكلمات.

يرجى إعادة الدليل فقط.
GPT-6 Sol · النص الكامل
## القرار

لا تحدد النموذج الفائز في الوقت الحالي. تطلب الحزمة المصدرية توصية بين نموذجين للذكاء الاصطناعي، لكنها لا تحدد أيًّا من النموذجين ولا تقدم نتائج للبحث أو الكتابة أو مراجعة الكود. ولذلك، فإن الادعاء بأن أحدهما أفضل من الآخر سيكون غير مدعوم بأدلة. التوصية العملية هي مقارنة النموذجين المرشحين بعمل الفريق نفسه قبل اتخاذ القرار.

الموعد النهائي لمشروع “نورث” هو 12 أسبوعًا. ميزانية عملية الترحيل تبلغ $48,000. لم يتم تحديد موعد للمراجعة الأمنية. هذه الحقائق تجعل اتخاذ القرار مسألة حساسة من حيث الوقت، لكنها لا تبرر الاعتماد على التخمين. يجب أن يأخذ الاختيار المفيد في الاعتبار ما إذا كان النموذج يساعد الفريق المكون من 40 شخصًا على إنجاز مهامه الفعلية، وكيف يتناسب استخدامه مع الميزانية المعتمدة، وما الذي يظل غير مؤكد حتى يتم تحديد موعد المراجعة الأمنية.

تعامل مع التوصية على أنها مشروطة: اختر النموذج الذي يحقق أداءً أفضل في الأعمال التمثيلية، ويمكن استخدامه في حدود ميزانية الترحيل المعتمدة، ويجتاز أي مراجعة مطلوبة لاستخدامه المقصود. إذا لم يستوف أي من المرشحين هذه الشروط، فيجب أن يذكر الدليل أنه لا يمكن التوصية بأي منهما بعد. لا تثبت المواد المتاحة استيفاء أي من هذين الشرطين.

## الأدلة

يريد الفريق توصية بنموذج لثلاثة أنواع من العمل: البحث، والكتابة، ومراجعة الكود. هذه هي فئات المقارنة المناسبة لأنها تنبع من الحاجة المعلنة، وليس من نقاط القوة المفترضة للمنتج. لا تحتوي الحزمة على أمثلة لمخرجات أي من النموذجين، ولا نتائج تقييم، ولا وصف لما يقدمه المرشحان. كما أنها لا تحتوي على أسعار أو معايير مرجعية. ونتيجة لذلك، لا يوجد أساس إثباتي لترتيب النماذج من حيث الدقة أو السرعة أو الجودة أو التكلفة أو الملاءمة.

يوفر سياق المشروع معايير قرار مفيدة. يُعد “مشروع نورث” عملية ترحيل لفريق مكون من 40 شخصًا، لذا يجب أن تعكس المقارنة المهام التي سيؤديها أفراد ذلك الفريق فعليًّا. تبلغ ميزانية الترحيل المعتمدة $48,000؛ ويجب تقييم أي استخدام مقترح لأحد النموذجين مقارنةً بهذا المبلغ، وليس مقابل مخصصات مختلقة لأدوات الذكاء الاصطناعي. لم يتم تحديد موعد للمراجعة الأمنية، مما يترك توقيت المراجعة — وتأثيرها على اعتماد النموذج — دون حسم.

وقد ذكر أحد أصحاب المصلحة أن المسودة الحالية طويلة جدًّا، لكنه لم يذكر عدد الكلمات. وهذا دليل على تفضيل الإيجاز، وليس حدًّا قابلًا للقياس لمخرجات النموذج. عند مقارنة عينات الكتابة، يمكن للمراجعين تقييم ما إذا كان كل مرشح يلتزم بطلب الإيجاز ويحافظ على الحقائق الأساسية. ولا ينبغي لهم الادعاء بأن أيًا من النموذجين يفي بحد أقصى لعدد الكلمات حدده أصحاب المصلحة، لأنه لم يتم تحديد أي حد من هذا القبيل.

بالنسبة للبحث، سيكون الدليل المفيد هو ما إذا كان كل مرشح يميز بين الحقائق المقدمة والأسئلة المفتوحة ويتجنب الاستنتاجات غير المدعومة. بالنسبة للكتابة، سيكون الدليل هو ما إذا كان كل نموذج ينتج مسودة واضحة وموجزة بشكل مناسب دون التخلي عن القيود. بالنسبة لمراجعة الكود، سيكون الدليل هو ما إذا كان كل نموذج يحدد المشكلات في المثال المقدم ويشرحها بطريقة يمكن للمراجع التحقق منها. هذه اختبارات مقترحة، وليست نتائج حول أي من النموذجين.

## التحفظات

أكبر تحفظ هو أن المرشحين أنفسهم لم يتم تحديدهم بعد: فالحزمة لا تذكر أسماءهم. كما أنها لا توضح كيف سيتمكن الفريق من الوصول إليهم، أو تكلفتهم، أو ما إذا كان أي منهما متاحًا للعمل المقصود. لا ينبغي استنتاج أي قدرات منتج من عبارة “نماذج الذكاء الاصطناعي”. حتى المقارنة المصممة جيدًا لا يمكن أن تسفر عن توصية بمنتج ما لم تُعرف النماذج المرشحة وأدلة التقييم.

تمت الموافقة على ميزانية الترحيل، لكن الحزمة لا تخصص أي جزء منها لاستخدام النماذج أو اختبارها. لا تعامل مبلغ $48,000 على أنه ميزانية شراء للذكاء الاصطناعي. وبالمثل، فإن الموعد النهائي البالغ 12 أسبوعًا لا يحدد تاريخًا لإجراء المراجعة الأمنية. ونظرًا لعدم تحديد موعد للمراجعة الأمنية، فإن مسألة ما إذا كان يمكن استخدام أحد المرشحين وفقًا لمتطلبات الفريق ومتى يمكن ذلك تظل غير محسومة.

قد تؤدي الاستخدامات الثلاثة المطلوبة أيضًا إلى نتائج مختلفة. قد يكون أحد المرشحين مفضلاً لمهمة ما وليس لمهمة أخرى؛ ولا توفر الحزمة أي أساس لافتراض وجود فائز واحد في مجالات البحث والكتابة ومراجعة الكود. ينبغي أن تبرز التوصية أي مقايضة من هذا القبيل بدلاً من إخفائها تحت تصنيف عام. إذا قرر الفريق أن فئة معينة لها أهمية أكبر من الفئات الأخرى، فيجب أن تأتي هذه الأولوية من أصحاب المصلحة، وليس من هذا الدليل.

أخيرًا، لا ينبغي الخلط بين الملاحظة المتعلقة بطول المسودة والدليل على أداء النموذج. فهي تصف التعليقات الواردة على مسودة حالية، دون تحديد مؤلفها أو ذكر طول مستهدف. ويمكن أن تُسترشد بها في كيفية عرض التوصية النهائية، لكنها لا يمكن أن تحسم المقارنة.

## الخطوة التالية

حدد المرشحين واطلب من الفريق مهام تمثيلية في مجالات البحث والكتابة ومراجعة الكود. قدم لكل نموذج نفس المواد والتعليمات لكل مهمة، بما في ذلك توجيهات لتمييز حالات عدم اليقين وتجنب إضافة حقائق. اطلب من المراجعين تسجيل ما أصاب فيه كل إجابة، وما أغفلته، وأي الادعاءات تتطلب التحقق. احرص على فصل الملاحظات الخاصة بكل مهمة على حدة حتى لا تحل عينة كتابة قوية محل الدليل المتعلق بمراجعة الكود.

قبل الاختيار، تأكد من تكلفة الاستخدام المقصود مقارنةً بميزانية الترحيل البالغة $48,000 وحدد موعد إجراء المراجعة الأمنية. لا توجد إجابة عن أي من هذين السؤالين في الحزمة. إذا تعذر حل هذين السؤالين في الوقت المناسب لاتخاذ القرار، فقم بالإبلاغ عن هذا القيد بوضوح بدلاً من تقديم تفضيل مؤقت على أنه خيار معتمد.

وبذلك يمكن أن تكون التوصية النهائية للمشتري موجزة وقابلة للتدقيق: اذكر المرشحين، ووضح الأدلة الخاصة بكل استخدام من الاستخدامات الثلاثة، وشرح أي مقايضات، وحدد المسائل المعلقة المتعلقة بالموافقة أو الميزانية. وإلى أن تتوفر تلك المعلومات، فإن الإجابة الصادقة بالنسبة لمشروع «نورث» ليست «الطراز أ» أو «الطراز ب»، بل هي أن المقارنة لم تُدعم بعد بأدلة.
اعتبر هذا تقييمًا لمدى ملاءمة السياق، وليس تصنيفًا للجودة.
الكتابة الطويلة
الإنجاز في إطار سقف الإنتاج نفسه البالغ 2,400 توكن
تضمنت المهمة نفسها خمسة أقسام. وكان الحد الأقصى لعدد الرموز المسموح به في كلا النموذجين هو 2,400 رمز؛ وتوضح البيانات الوصفية التي تم إرجاعها سبب الاختلاف الملحوظ.
وصل Claude إلى الحد الأقصى المحدد للإخراج قبل قاعدة «القرار». وأكمل «سول» الملخص في حدود ذلك الحد الأقصى. ويدعم هذا توصية تتعلق بهذه التجربة المقيدة، وليس تصنيفًا عامًا لأقصى قدرة على الكتابة أو السرعة. ويرد أدناه النص الكامل الذي تم إرجاعه، بما في ذلك الرد المقتطع.
مهمة مطولة
الكتابة المطولة: أنجزت GPT-6 Sol المهمة المحددة
هذه هي أول مهمة مقارنة مباشرة. وقد ذكرت المطالبة صراحةً Claude Opus 5.5 و GPT-6 Sol, ، وقدّم لكليهما نفس حزمة المعلومات الخاصة بمشروع «نورث»، وطلب مذكرة قرار مشروطة.
| القياس | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| الطول المرئي | 648 كلمة؛ سبب_الإنهاء=الطول | 1,065 كلمة؛ finish_reason=stop |
| الحقول الإلزامية | 4 من 5؛ قاعدة القرار مفقودة بعد الاقتطاع | 5 من 5 |
| بطاقة تقييم ذات أربعة أعمدة | حالي ومتماثل | حالي ومتماثل |
| فحوصات الطيار / شروط التوقف | بدأت ولكنها توقفت قبل اكتمالها | ثلاثة فحوصات وشرط توقف |
| النتيجة | 7.0 / 10 | 10.0 / 10 |
خلاصة القول: مع نفس الحد الأقصى للإخراج البالغ 2,400 توكن، تمكن نموذج GPT-6 Sol من إرجاع الأقسام الخمسة جميعها، في حين وصل نموذج Claude Opus 5.5 إلى الحد الأقصى قبل الوصول إلى قاعدة «Decision». ويُظهر ذلك اكتمال المهمة في ظل هذا التكوين؛ لكنه لا يحدد القدرة القصوى على الكتابة لأي من النموذجين ولا سرعتهما العامة.
المدخلات الكاملة المشتركة
أنت تُعد مذكرة قرار لفريق يختار بين نموذجي Claude Opus 5.5 و GPT-6 Sol. أسماء النماذج ثابتة ويجب أن تظهر بالضبط كما هي مكتوبة. باستخدام حزمة الأدلة الواردة أدناه فقط، اكتب ما بين 900 و 1100 كلمة تتضمن الأقسام التالية بالضبط: التوصية التنفيذية؛ ما تدعمه الأدلة؛ النقاط التي تفتقر إلى الأدلة؛ برنامج تجريبي مدته 30 يومًا؛ قاعدة اتخاذ القرار.

المتطلبات: (1) قم بمقارنة Claude Opus 5.5 و GPT-6 Sol بشكل متماثل؛ (2) افصل بين الأدلة الملاحظة والافتراضات والمجهولات؛ (3) الحفاظ على التواريخ الدقيقة والميزانية وحجم الفريق وحالة الأمان غير المحسومة؛ (4) تضمين بطاقة أداء موجزة من أربعة صفوف تغطي توليف الأبحاث، والكتابة المطولة، ومراجعة الكود، وملف JSON المنظم؛ (5) تقديم توصية مشروطة بدلاً من اختلاق فائز؛ (6) سرد ثلاثة اختبارات تجريبية قابلة للقياس وشرط إيقاف؛ (7) عدم اختلاق الأسعار أو المعايير المرجعية أو حدود السياق أو قدرات المنتج.

حزمة الأدلة
- مشروع «نورث» هو عملية ترحيل مدتها 12 أسبوعًا لفريق مكون من 40 شخصًا.
- تبلغ ميزانية عملية الترحيل المعتمدة $48,000. ولا تذكر حزمة الأدلة ما إذا كان استخدام النموذج مشمولاً في تلك الميزانية أم لا.
- لم يتم تحديد موعد لمراجعة الأمان.
- يحتاج الفريق إلى توليف الأبحاث، والكتابة المطولة، ومراجعة الكود، واستخراج JSON المنظم.
- يقول أحد أصحاب المصلحة إن المسودة الحالية طويلة جدًا، ولكن لم تتم الموافقة على عدد كلمات مستهدف.
- لم يتم توفير أي مخرجات خاضعة للرقابة من Claude Opus 5.5 أو GPT-6 Sol حتى الآن.
- يرغب الفريق في خيار قابل للتدقيق ويمكنه إجراء تجربة تجريبية لمدة 30 يومًا باستخدام مطالبات متطابقة ومراجعة بشرية.

أعد المذكرة فقط. لا تدّعِ أن حزمة الأدلة تثبت أن أيًا من النموذجين أفضل.
Claude Opus 5.5 · إخراج كامل مُعاد
## توصية تنفيذية

لا تختر Claude Opus 5.5 أو GPT-6 Sol في الوقت الحالي. لا تحتوي حزمة الأدلة على أي مخرجات خاضعة للرقابة من أي من النموذجين. وبالتالي، لا يوجد أساس ملموس لإعلان أن أحدهما أفضل من الآخر في أي من أحمال العمل الأربعة المطلوبة.

هذه التوصية مشروطة. قم بتشغيل تجربة تجريبية مدتها 30 يومًا تقدم لكلا النموذجين مطالبات متطابقة وتطبق نفس المراجعة البشرية. ثم اختر النموذج الذي يفي بالحدود الدنيا المتفق عليها قبل بدء التجربة، شريطة حل المسائل المتعلقة بالأمن والميزانية الواردة أدناه أولاً. هناك ثلاث نتائج محتملة:

- **تجاوز أحد النموذجين الحدود الدنيا:** اختر ذلك النموذج.
- **تجاوز كلاهما:** طبق معايير الفصل في حالة التعادل الواردة في قاعدة اتخاذ القرار.
- **لم يتجاوز أي منهما:** لا تعتمد أيًا منهما.

يمنح هذا النهج الفريق الخيار القابل للتدقيق الذي طلبه.

حقائق المشروع الثابتة هي:

- مشروع "نورث" هو عملية ترحيل مدتها 12 أسبوعًا لفريق مكون من 40 شخصًا.
- ميزانية الترحيل المعتمدة هي $48,000. لا تذكر الحزمة ما إذا كان استخدام النموذج مشمولًا في تلك الميزانية أم لا.
- لم يتم تحديد موعد للمراجعة الأمنية.
- لا تتضمن حزمة الوثائق أي تواريخ تقويمية (لا تاريخ لبدء المشروع، ولا تاريخ انتهاء، ولا فترة تجريبية)، لذا لا تحدد هذه المذكرة أيًا منها.

## ما تدعمه الأدلة

**الأدلة الملاحظة.** هذه هي الحقائق المذكورة مباشرةً في حزمة الوثائق:

- مشروع «نورث» هو عملية ترحيل مدتها 12 أسبوعًا لفريق مكون من 40 شخصًا.
- تبلغ ميزانية الترحيل المعتمدة $48,000، ولم يُذكر ما إذا كانت تشمل استخدام النموذج أم لا.
- لم يتم تحديد موعد لإجراء المراجعة الأمنية.
- أعباء العمل المطلوبة هي توليف الأبحاث، والكتابة المطولة، ومراجعة الكود، واستخراج JSON المنظم.
- يقول أحد أصحاب المصلحة إن المسودة الحالية طويلة جدًا، لكن لم تتم الموافقة على عدد كلمات مستهدف.
- لم يتم توفير أي مخرجات خاضعة للرقابة من Claude Opus 5.5 أو GPT-6 Sol.
- يرغب الفريق في خيار قابل للتدقيق ويمكنه إجراء تجربة تجريبية مدتها 30 يومًا باستخدام مطالبات متطابقة ومراجعة بشرية.

**ما يدعمه هذا.** تحدد الأدلة ما يجب تقييمه وكيفية تقييمه، ولكنها لا تحدد أي نموذج سيفوز. وهي تبرر إجراء تجربة تجريبية منظمة ومقارنة جنبًا إلى جنب. ولا تبرر أي ادعاء بشأن الجودة أو السرعة أو التكلفة أو التعامل مع السياق أو توفر الميزات لأي من النموذجين.

**بطاقة التقييم (الحالة الحالية للأدلة)**

| عبء العمل | Claude Opus 5.5 | GPT-6 Sol | مقياس التجربة |
|---|---|---|---|
| توليف الأبحاث | لم يتم توفير مخرجات خاضعة للرقابة | لم يتم توفير مخرجات خاضعة للرقابة | درجة المراجعين المجهولين وفقًا لمعايير التقييم |
| الكتابة المطولة | لم يتم توفير مخرجات خاضعة للرقابة | لم يتم توفير مخرجات خاضعة للرقابة | درجة المراجعة وفقًا لمعايير التقييم بالإضافة إلى الالتزام بطول مستهدف معتمد |
| مراجعة الكود | لم يتم توفير ناتج خاضع للرقابة | لم يتم توفير ناتج خاضع للرقابة | نسبة المشكلات المعروفة التي تم تحديدها |
| JSON المنظم | لم يتم توفير ناتج خاضع للرقابة | لم يتم توفير ناتج خاضع للرقابة | معدل النجاح في التحقق من صحة المخطط |

كل خلية في كلا النموذجين متطابقة لأن الحزمة تعاملهما بشكل متماثل. لا يوجد صف يفضل أيًا من النموذجين حاليًا.

## حيث توجد أدلة ناقصة

**أمور مجهولة.** لا تتطرق الحزمة إلى أي من النقاط التالية:

- ما إذا كانت تكاليف استخدام النموذج تقع ضمن ميزانية الترحيل البالغة $48,000 أم أنها تتطلب تمويلًا منفصلاً.
- متى ستجرى المراجعة الأمنية، وما الذي ستغطيه، وما إذا كان أي من النموذجين مقبولًا في إطارها. الحالة الأمنية لم تُحسم بعد بالنسبة لكلا النموذجين.
- التواريخ المحددة للانتقال الذي يستغرق 12 أسبوعًا والبرنامج التجريبي الذي يستغرق 30 يومًا.
- العدد المستهدف المعتمد للكلمات في النصوص الطويلة. لا يمكن تقييم تعليق «طويل جدًّا» الذي أبداه أحد أصحاب المصلحة دون تحديد هذا العدد.
- الأسعار، ونتائج الاختبارات المعيارية، وحدود السياق، وقدرات المنتج لكل من Claude Opus 5.5 و GPT-6 Sol. لم يتم توفير أي منها، ولا تفترض هذه المذكرة أيًا منها.
- من هم المراجعون البشريون، وكم عددهم، وكيف سيتم حل الخلافات بينهم.
- ما هي البيانات التي قد يستخدمها البرنامج التجريبي قبل اكتمال المراجعة الأمنية.

**الافتراضات.** هذه مقترحات وردت في هذه المذكرة، وليست حقائق مأخوذة من حزمة الوثائق، وكل منها يتطلب موافقة الفريق:

- يمكن للمشروع التجريبي استخدام مواد غير حساسة أو اصطناعية إلى أن تسمح المراجعة الأمنية باستخدام البيانات الحقيقية.
- يمكن إخفاء هوية النموذج الذي أنتج كل ناتج عن المراجعين.
- يمكن للفريق تجميع مجموعة محددة من المطالبات لكل حمل عمل تمثل المهام الحقيقية لمشروع «نورث».
- عتبات النجاح المقترحة أدناه هي نقاط انطلاق يمكن للفريق تغييرها قبل بدء التجربة، ولكن ليس أثناءها.

## تجربة مدتها 30 يومًا

**التصميم**

1.
GPT-6 Sol · النص الكامل للمخرجات
## توصية إدارية

لا تختر Claude Opus 5.5 أو GPT-6 Sol في الوقت الحالي. مشروع North هو عملية ترحيل مدتها 12 أسبوعًا لفريق مكون من 40 شخصًا، ولا توفر الحزمة أي مخرجات خاضعة للرقابة من أي من النموذجين. ولذلك فهي تدعم خطة مقارنة، وليس حكمًا على الأداء. قم بتشغيل النسخة التجريبية المتاحة لمدة 30 يومًا باستخدام مطالبات متطابقة ومراجعة بشرية، ثم اتخذ قرارًا قابلًا للتدقيق وفقًا للمعايير المتفق عليها قبل فحص النتائج. اختر أيًا من النموذجين فقط إذا كان عمله الذي خضع للمراجعة يلبي احتياجات الفريق، وكان استخدامه يتوافق مع الترتيب المالي المعتمد، وسمحت المراجعة الأمنية التي لم يتم البت فيها بعد باعتماده. إذا لم يتم استيفاء هذه الشروط، فقم بتأجيل الاختيار بدلاً من اعتبار المقارنة غير المكتملة نجاحًا.

ميزانية الترحيل المعتمدة هي $48,000. لا يذكر الملف ما إذا كان استخدام النموذج يقع ضمن تلك الميزانية. لم يتم تحديد موعد للمراجعة الأمنية. هذه قيود على اتخاذ القرار بالنسبة لكل من Claude Opus 5.5 وGPT-6 Sol على حد سواء، وليست أدلة تفضل أحدهما على الآخر.

## ما تدعمه الأدلة

**الملاحظ:** يحتاج الفريق إلى توليف الأبحاث، والكتابة المطولة، ومراجعة الكود، واستخراج JSON المنظم. ويرغب في خيار قابل للتدقيق ويمكنه إجراء تجربة تجريبية لمدة 30 يومًا باستخدام مطالبات متطابقة ومراجعة بشرية. يقول أحد أصحاب المصلحة إن المسودة الحالية طويلة جدًّا، لكن لم تتم الموافقة على عدد كلمات مستهدف. تحدد هذه الملاحظة مشكلة يجب اختبارها في مخرجات الكتابة؛ وهي لا تحدد نموذجًا مفضَّلًا أو طولًا مقبولًا.

بطاقة التقييم الحالية لكل مهمة على حدة غير مصنَّفة عمدًا:

| مسار العمل | Claude Opus 5.5 | GPT-6 Sol | أدلة تجريبية يجب جمعها |
|---|---|---|---|
| توليف الأبحاث | لم يتم اختباره بعد | لم يتم اختباره بعد | الدقة والتغطية وقابلية التتبع وفقًا لتقييم المراجعين |
| الكتابة المطولة | لم تُختبر بعد | لم تُختبر بعد | الفائدة والوضوح والإيجاز وفق تقييم المراجعين |
| مراجعة الكود | لم تُختبر بعد | لم تُختبر بعد | النتائج التي تم التحقق منها من قبل المراجعين والادعاءات غير المدعومة |
| JSON المنظم | لم تُختبر بعد | لم تُختبر بعد | المخرجات الصحيحة واستخراج الحقول بشكل صحيح |

**افتراض للتخطيط، وليس نتيجة ملاحظة:** يمكن أن تكشف عينات العمل القابلة للمقارنة ومعيار التقييم المشترك عن اختلافات ذات صلة بمشروع “نورث”. وينبغي أن يختبر المشروع التجريبي هذا الافتراض. لن تجعل المطالبات المتطابقة وحدها الاختيار قابلاً للتدقيق: يجب على الفريق أيضًا الاحتفاظ بالمدخلات، وكلا الناتجين، ومعايير المراجعة، وأحكام المراجعين، وأسباب أي استبعاد أو إعادة تشغيل. يجب أن تطبق المراجعة البشرية نفس المعيار على كل نموذج.

بالنسبة للكتابة الطويلة، يجب على المراجعين التمييز بين “طويلة جدًا” و«غير مفيدة». قد تحذف الإجابة الأقصر معلومات ضرورية؛ في حين أن الإجابة الأطول قد تظل واضحة وقابلة للاستخدام. ونظرًا لعدم اعتماد عدد كلمات مستهدف، يمكن للمشروع التجريبي تسجيل الطول وأحكام المراجعين، ولكن لا ينبغي أن يعلن بأثر رجعي أن عدد كلمات تعسفي هو معيار القبول. ينطبق نفس النهج على المهام الأخرى: تسجيل ما لاحظه المراجعون، بدلاً من تحويل التفضيلات إلى ادعاءات حول القدرة العامة للنموذج.

## في حالة عدم توفر الأدلة

**غير معروف:** لا تحتوي الحزمة على مخرجات خاضعة للرقابة من Claude Opus 5.5 أو GPT-6 Sol. ولا تحدد أي جودة نسبية أو موثوقية أو ملاءمة لأي من مسارات العمل الأربعة. كما أنها لا تقدم أي أسعار أو حدود سياقية أو معايير قياس أو معلومات عن قدرات المنتج. وبالتالي، لا يمكن لهذه المذكرة تقدير تكلفة الاستخدام أو استنتاج أي نموذج سيحقق أداءً أفضل مع مواد مشروع نورث.

يلزم توضيح حدود الميزانية قبل اتخاذ قرار الشراء. يُعد مبلغ $48,000 الميزانية المعتمدة *للانتقال*؛ ولم يُذكر ما إذا كان يجب دفع تكاليف استخدام النموذج من هذه الميزانية أم لا. إن اعتبارها إما مشمولة أو إضافية سيؤدي إلى افتراض مالي لا تدعمه الحزمة. يجب على الفريق توثيق الإجابة ومسار الموافقة المعمول به قبل الالتزام بالاستخدام المستمر.

كما أن مسألة الأمان لم تُحل بعد بالنسبة لكلا المرشحين. لم يتم تحديد موعد لمراجعة الأمان، ولا تقدم الحزمة أي نتائج تتعلق بالأمان. ولن تؤدي نتيجة تجريبية قوية إلى حل هذه المسألة. يجب على الفريق تحديد من يمكنه تحديد موعد المراجعة واتخاذ قرار بشأنها، وما هي المعلومات التي يحتاجها المراجع، وما إذا كان النشاط التجريبي نفسه مسموحًا به بموجب القواعد المعمول بها؛ حيث لا تجيب الحزمة على هذه الأسئلة. لم يتم توفير تواريخ بدء أو انتهاء محددة للانتقال، أو التجربة التجريبية، أو المراجعة الأمنية، لذا يجب ألا يوحي الفريق بأن قرارًا أمنيًا سيصدر خلال فترة التجربة التجريبية التي تبلغ 30 يومًا أو فترة الانتقال التي تبلغ 12 أسبوعًا.

## التجربة التي تستغرق 30 يومًا

قبل المقارنة الأولى، يجب على الفريق اختيار مطالبات تمثيلية لجميع مسارات العمل الأربعة، وتحديد الشكل المتوقع لكل استجابة، والاتفاق على معايير المراجعة البشرية. يجب أن يتلقى كلا النموذجين مطالبات متطابقة ونفس تعليمات المراجعة. يجب على المراجعين تسجيل أحكامهم بناءً على العمل نفسه وليس بناءً على سمعة النموذج. يجب الاحتفاظ بالمطالبة، والنتيجة، والمراجعة، وأي تصحيح مطلوب حتى يتمكن القارئ لاحقًا من إعادة بناء كل حكم. يجب تسجيل الانحرافات عن العملية المعتادة بدلاً من تجاهل الحالات الصعبة بصمت.

استخدم ثلاثة معايير قابلة للقياس:

1. **جودة المهمة التي تمت مراجعتها:** بالنسبة لتوليف الأبحاث، والكتابة المطولة، ومراجعة الكود، احسب نسبة المخرجات التي يقبلها المراجعون للمهمة المحددة. سجل أيضًا أسباب الرفض بشكل منفصل — على سبيل المثال، تغطية ناقصة، أو كتابة غير واضحة، أو نتيجة مراجعة كود غير متحقق منها. أبلغ عن النتائج حسب مسار العمل والنموذج، وليس مجرد درجة مجمعة واحدة.
2. **موثوقية JSON المنظمة:** احسب النتائج التي تتطابق مع البنية المتفق عليها، والنتائج التي يتحقق المراجع من صحة الحقول المستخرجة منها. قم بالإبلاغ عن كلا المعدلين لكل من Claude Opus 5.5 و GPT-6 Sol؛ فلا ينبغي احتساب الإجابة الصحيحة من الناحية الهيكلية على أنها دقيقة لمجرد أنها قابلة للتحليل.
3. **جهد المراجعة وإمكانية التتبع:** سجل الوقت البشري المطلوب لفحص كل ناتج وتصحيحه عند الحاجة. احسب الحالات التي تفتقر إلى أدلة محفوظة كافية لتفسير قرار المراجع. قارن هذه المقاييس على نفس مجموعة المطالبات، بما في ذلك الحالات التي لا يكون فيها أي من الناتجين مقبولًا.

الاتفاق على معايير القبول وكيفية التعامل مع حالات التعادل قبل الاطلاع على نتائج المرحلة التجريبية؛ حيث لا توفر الحزمة أي معيار مرجعي يمكن الاستناد إليه لاستنباط عتبات رقمية. في نهاية 30 يومًا، نشر معايير التقييم، والأعداد، وأسباب المراجعين، والأسئلة التي لم يتم حلها. **شرط الإيقاف:** أوقف عملية التبني مؤقتًا إذا تعذر تلبية متطلبات الأمان الخاصة بالتجربة أو الاستخدام اللاحق، أو إذا تعذر على الفريق وضع ميزانية صالحة ومسار موافقة. لا تستبدل درجات الجودة الإيجابية بأي من هذين الشرطين.

## قاعدة القرار

اختر Claude Opus 5.5 إذا كانت أدلة التجربة التمهيدية الخاصة به تفي بالمعايير المتفق عليها مسبقًا، وكانت أقوى بشكل جوهري في مسارات العمل التي يعطيها الفريق الأولوية، وتم حل شروطه الأمنية والمالية. طبق القاعدة نفسها تمامًا على GPT-6 Sol. إذا استوفى كلاهما المعايير دون وجود فرق جوهري ذي صلة، فاتخذ القرار باستخدام أولويات المشروع الموثقة والقيود التي تم حلها بدلاً من تحديد الفائز من حيث الأداء. إذا لم يستوف أي منهما الشروط — أو إذا ظل الحد الأقصى للميزانية أو الحالة الأمنية دون حل — فلا تقم باختيار النموذج بعد. يحافظ هذا النتيجة على قرار قابل للتدقيق لفريق مكون من 40 شخصًا دون تأكيد أكثر مما تدعمه الأدلة.
البيانات الوصفية: Claude — HTTP 200 · 25.98 ثانية · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27.763 ثانية · سبب_الإنهاء=إيقاف · عدد_رموز_الموجهة=386 · عدد_رموز_الإكمال=1695
التوليف من المصادر
مهمة بحثية
توليف المصادر: تعادل
حلّ كلا النموذجين تعارض التاريخ ليصبح 15 أكتوبر، واحتفظا بالميزانية المتفق عليها البالغة $12,000، واعتبرا عبارة “دائمًا دقيقة” ادعاءً غير مدعوم من جانب المدير. ونتيجة ذلك هي تعادل في هذه المهمة.
| القياس | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| النتيجة | 9.5 / 10 | 9.5 / 10 |
| معالجة النزاعات | تحدد S2 الموعد النهائي | تحدد S2 الموعد النهائي |
| ادعاء غير مدعوم بالأدلة | تم وضع علامة "غير مدعوم" | تم وضع علامة "غير مدعوم" |
| الفرق العملي | شرح أكثر تفصيلاً للمخاطر | توصية أكثر إيجازًا |
المدخلات الكاملة المشتركة
قم بمطابقة الملاحظات المرجعية الواردة أدناه. قدم (1) جدولاً بتنسيق ماركداون يتضمن الأعمدة التالية: “الادعاء”، و«المصدر المرجعي»، و«الحالة»، و«السبب»، و(2) توصيةً من حوالي 250 كلمة. استخدم المذكرة السياساتية الأحدث تاريخًا كمصدر مرجعي فقط فيما يتعلق بتعارض المواعيد النهائية. ضع علامة «غير مدعوم» على الادعاءات غير المدعومة. لا تضف أي حقائق.

[S1 2026-09-01] تنتهي المرحلة التجريبية في 30 سبتمبر. الميزانية هي $12,000.
[S2 2026-09-03] تنتهي المرحلة التجريبية في 15 أكتوبر. تظل الميزانية $12,000.
[S3 2026-09-02] لم يوافق القسم القانوني على مشاركة البيانات الخارجية.
[S4 2026-09-04] يقول أحد المديرين إن النموذج «دائمًا دقيق»؛ ولم يتم إرفاق أي دليل اختباري.
[S5 2026-09-04] يتألف فريق المشروع التجريبي من 8 أعضاء.
[S6 2026-09-05] يجب أن تتضمن مذكرة القرار قائمة بالمخاطر التي لم يتم حلها.

يرجى إعادة الجدول والتوصية فقط.
Claude Opus 5.5 · الإخراج الكامل
| الادعاء | المصدر المرجعي | الحالة | السبب |
|---|---|---|---|
| تنتهي المرحلة التجريبية في 30 سبتمبر | S2 (2026-09-03) | تم استبدالها | تتعارض مع S2. الملاحظة الأحدث تاريخًا هي المرجع المرجعي في حالة تعارض المواعيد النهائية. |
| تنتهي المرحلة التجريبية في 15 أكتوبر | S2 (2026-09-03) | مدعومة (محددة) | هذه هي الملاحظة الأحدث تاريخًا بشأن تعارض الموعد النهائي، لذا فهي تلغي S1. |
| الميزانية هي $12,000 | S1 و S2 | مدعومة | يتفق المصدران، وتشير S2 إلى أن الميزانية "تظل" $12,000. لا يوجد تعارض. |
| لم يوافق القسم القانوني على مشاركة البيانات الخارجية | S3 | مدعوم | تم ذكره بشكل مباشر ولم يتعارض مع أي مصدر آخر. |
| النموذج "دائمًا دقيق" | S4 | غير مدعوم | هذا تأكيد من أحد المديرين دون إرفاق أي دليل اختباري. |
| يتألف فريق المشروع التجريبي من 8 أعضاء | S5 | مدعوم | تم ذكره بشكل مباشر ولم يتم نفيه. وهو مستمد من مصدر واحد. |
| يجب أن تتضمن مذكرة القرار قائمة بالمخاطر التي لم يتم حلها | S6 | مدعوم | هذا مطلب محدد للمذكرة ولم يتم نفيه. |

**التوصية**

يجب أن تستخدم مذكرة القرار تاريخ 15 أكتوبر كموعد انتهاء المرحلة التجريبية. S2 هي المذكرة الأحدث تاريخًا وتحسم تعارض المواعيد النهائية، مما يلغي تاريخ 30 سبتمبر الوارد في S1. تنطبق قاعدة "التاريخ الأحدث" على هذا التعارض فقط. أما الادعاءات الأخرى فقد تم تقييمها بناءً على الأدلة الداعمة الخاصة بها.

يجب تسجيل الميزانية على أنها $12,000. تتفق المذكرة S1 والمذكرة S2 على هذا الرقم، لذا لا حاجة إلى تسوية. يمكن أيضًا تضمين حجم الفريق المكون من ثمانية أعضاء. ويستند ذلك إلى المذكرة S5 وحدها، ولكن لا يوجد مصدر يتعارض معها.

تتطلب S6 أن تسرد المذكرة المخاطر التي لم يتم حلها، وتدعم الملاحظات وجود اثنين منها على الأقل.

- **مشاركة البيانات الخارجية:** لم يوافق القسم القانوني على ذلك (S3). يجب أن تذكر المذكرة هذا الأمر بوضوح. ولا ينبغي أن توحي بأن مشاركة البيانات الخارجية مسموح بها خلال المرحلة التجريبية.
- **دقة النموذج:** الادعاء بأن النموذج «دائمًا دقيق» غير مدعوم بأدلة. تشير S4 إلى عدم إرفاق أي دليل اختباري، وتسجل هذا الادعاء فقط باعتباره تصريحًا من أحد المديرين. يجب ألا تقدم المذكرة هذا الادعاء على أنه نتيجة أو تعتمد عليه لتبرير القرارات. يجب أن تُدرج دقة النموذج على أنها غير مُثبتة حتى يتم تقديم أدلة داعمة.

وأخيرًا، يجب أن تشير المذكرة بإيجاز إلى أن تاريخ انتهاء المرحلة التجريبية قد تغير بين S1 و S2. فقد يصادف القراء تاريخ 30 سبتمبر السابق في مكان آخر، وستوضح هذه الملاحظة سبب استخدام تاريخ 15 أكتوبر. ولا ينبغي أن تضيف المذكرة أي تفسيرات للتغيير أو نتائج الاختبارات أو تحديثات الوضع القانوني، لأن أياً منها لا يظهر في الملاحظات المصدرية.
GPT-6 Sol · النص الكامل
| الادعاء | المصدر المرجعي | الحالة | السبب |
|---|---|---|---|
| تنتهي المرحلة التجريبية في 30 سبتمبر. | S2 (2026-09-03) | تم استبداله | الملاحظة الأحدث تاريخًا هي المرجع المرجعي في حالة تعارض المواعيد النهائية، وتحدد 15 أكتوبر. |
| تنتهي المرحلة التجريبية في 15 أكتوبر. | S2 (2026-09-03) | مدعومة | تحدد الملاحظة S2 الموعد النهائي المرجعي. |
| تبلغ الميزانية $12,000. | S1 و S2 | مدعومة | تحدد كلتا الملاحظتين نفس المبلغ. |
| لم توافق الإدارة القانونية على مشاركة البيانات الخارجية. | S3 | مدعومة | تذكر S3 ذلك صراحةً؛ ولا تتناول أي مذكرة لاحقة مسألة تلك الموافقة. |
| النموذج “دائمًا دقيق”. | S4 | غير مدعومة | يدعي أحد المديرين ذلك، لكن لم يتم إرفاق أي دليل اختباري. |
| يتألف فريق المشروع التجريبي من 8 أعضاء. | S5 | مدعوم | تحدد S5 حجم الفريق. |
| يجب أن تدرج مذكرة القرار المخاطر التي لم يتم حلها. | S6 | مدعوم | تنص S6 على هذا المطلب. |

**التوصية:** استخدم 15 أكتوبر كموعد انتهاء المرحلة التجريبية في مذكرة القرار. S2 يأتي بعد S1 ويحل تعارض الموعد النهائي بينهما. حافظ على الميزانية عند $12,000: فالملاحظات متفق عليها بشأن هذا المبلغ، لذا فإن تغيير الموعد النهائي لا يوفر أي أساس لتغييره. سجل حجم فريق المشروع التجريبي بـ 8 أعضاء، كما هو مذكور في S5.

اذكر المخاطر التي لم يتم حلها بشكل صريح، كما يتطلب S6. يجب أن يذكر المذكرة أن القسم القانوني لم يوافق على مشاركة البيانات الخارجية، دون الإيحاء بأن الموافقة قد مُنحت منذ ذلك الحين أو أن المشاركة مسموحة. كما يجب أن تميز بين تصريح المدير بشأن الدقة وبين النتيجة المؤكدة. تسجل S4 التصريح بأن النموذج “دائمًا دقيق”، لكنها لا تقدم أي دليل اختباري. لا تُقدّم هذا التصريح كنتيجة تم التحقق منها.

اجعل عملية التسوية محدودة النطاق. تتناول S2 التواريخ النهائية المتضاربة؛ وهي لا تحل محل الملاحظات المنفصلة المتعلقة بالقسم القانوني، أو الدقة، أو حجم الفريق، أو متطلبات المذكرة. عندما لا تثبت الملاحظات نتيجة ما، اترك الأمر دون حل بدلاً من تقديم افتراض. وعلى وجه الخصوص، لا يدعم السجل ادعاءً بأن مشاركة البيانات الخارجية قد تمت الموافقة عليها، ولا ادعاءً بأن دقة النموذج قد تم إثباتها.

وبالتالي، يمكن للمذكرة الناتجة أن تستخدم الموعد النهائي في 15 أكتوبر وميزانية $12,000 مع تحديد فجوتين في الأدلة تظهران بوضوح في هذه الملاحظات: الموافقة القانونية المعلقة على مشاركة البيانات الخارجية، وغياب أدلة الاختبار التي تدعم ادعاء الدقة.
البيانات الوصفية: Claude — HTTP 200 · 12.846 ثانية · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12.322 ثانية · سبب_الانتهاء=إيقاف · عدد_رموز_الموجهة=230 · عدد_رموز_الإكمال=714
البرمجة والمخرجات المنظمة
كان الاختلاف في الترميز يكمن في الشرح
شرط التصفية الأصلي: إذا كان t
يُعتبر العنصر «None» قيمة كاذبة، لذا فإن هذا المرشح يتخطاه بالفعل.
أرجع كلا النموذجين بيانات JSON صالحة تحتوي على المفاتيح الأربعة المطلوبة ونفس التصحيح البسيط. وقد وصف نموذج Claude المرشح الحالي بشكل صحيح؛ بينما أخطأ نموذج GPT-6 Sol عندما ذكر أن عنصر «None» سيؤدي إلى حدوث خطأ. ويُعد هذا الخطأ التشخيصي المحدد مهمًا عندما يقرر المراجع ما إذا كان التصحيح يعالج الخلل الفعلي أم لا.
قدمت Claude قائمة بالمخاطر، بينما قدمت Sol سلسلة قصيرة تتعلق بالمخاطر. لم تشترط المطالبة نوعًا معينًا لهذا الحقل، لذا فإن هذا الاختلاف لا يُعد انتهاكًا للعقد. تبلغ درجة مهمة Sol 9.0/10 بعد تصحيح الخصم السابق غير المبرر بنصف نقطة؛ بينما لا يزال الخصم المتعلق بدقة المعلومات ساريًا.
مهمة الترميز
الترميز والإخراج المنظم: كان Claude Opus 5.5 أكثر دقة
أرجع كلا النموذجين بيانات JSON صالحة تحتوي على المفاتيح المطلوبة ونفس التصحيح البسيط. وقد أوضح النموذج Claude بشكل صحيح أن المرشح الأصلي يتخطى بالفعل لا يوجد عنصر. ذكر GPT-6 Sol خطأً أن «أ» لا يوجد سيؤدي هذا العنصر إلى حدوث خطأ. لم تتطلب المطالبة نوعًا معينًا لحقل "المخاطر".
| القياس | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| النتيجة | 10.0 / 10 | 9.0 / 10 |
| تصحيح | صحيح ومقتضب | صحيح ومقتضب |
| التشخيص | يعزل كلا العيبين بشكل صحيح | يبالغ في وصف فشل العنصر «None» |
| عقد JSON المطلوب | JSON صالح؛ جميع المفاتيح الأربعة موجودة | JSON صالح؛ جميع المفاتيح الأربعة موجودة |
المدخلات الكاملة المشتركة
أعد JSON صارمًا يحتوي فقط على المفاتيح التالية: diagnosis، patch، tests، risks. قم بتشخيص هذه الدالة في بايثون وتصحيحها بالحد الأدنى حتى تنجح الحالات الثلاث جميعها. يجب أن يحافظ التصحيح على توقيع الدالة.

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

الحالات:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

لا تقم بتنفيذ أي كود ولا تقم بتضمين علامات Markdown أو نصوص خارج JSON.
Claude Opus 5.5 · الإخراج الكامل
{"diagnosis":"تم الكشف عن عيبين من خلال قراءة الكود (دون تنفيذه). (أ) الحالة 2: عندما تكون قيمة tags هي None، يقوم المُولِّد بالتكرار على None ويثير استثناء TypeError بدلاً من إرجاع ''. (ب) الحالة 3: يتم تنفيذ عامل التصفية 'if t' قبل عملية إزالة المسافات. العلامة التي تحتوي على مسافة بيضاء فقط ' ' تُعتبر صحيحة، لذا يتم تمريرها وتصبح ''. والنتيجة هي sorted(['', 'seo'])، والتي يتم ضمها إلى ',seo' بدلاً من 'seo'. يتم بالفعل استبعاد العنصر None في الحالة 3 بواسطة 'if t'. الحالة 1 تعمل بالفعل: يتم تطبيع ' AI ' و'ai' و'Code' إلى {'ai', 'code'}، مما يعطي 'ai,code'.','patch":"def normalize_tags(tags):\n return ",".join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))','tests":["assert normalize_tags([" AI ", 'ai', 'Code']) == 'ai,code' # تم تتبع المسار: {'ai','code'} -> 'ai,code'','assert normalize_tags(None) == "" # traced: (None or []) -> [] -> ''','assert normalize_tags([" ", None, 'SEO']) == 'seo' # traced: ' ' يفشل في t.strip()، وNone يفشل في t، و'SEO' -> 'seo''],'المخاطر':["العناصر غير السلسلية مثل 123 ستثير استثناء AttributeError عند .strip(). وهذا لم يتغير عن السلوك الأصلي.",""tags أو []" تعامل أي مدخلات ذات قيمة كاذبة (مثل "' أو توبول فارغ) على أنها فارغة. وهذا يتوافق مع السلوك المطلوب None -> ''.','إذا تم تمرير سلسلة واحدة بدلاً من مجموعة قابلة للتكرار من العلامات، يتم تكرارها حرفًا حرفًا. وهذا لم يتغير عن السلوك الأصلي.',"لا يتم دمج المسافات الداخلية، لذا تظل "machine learning" و'machine learning" علامتين منفصلتين.','تم استنباط الاختبارات عن طريق التتبع اليدوي فقط ولم يتم تنفيذها، وفقًا للتعليمات.']}GPT-6 Sol · النص الكامل
{"diagnosis":"تُحدث الدالة خطأً عندما تكون قيمة "tags" هي "None" أو تحتوي على 'None'، وتحتفظ بالمدخلات التي تصبح فارغة بعد إزالة الأحرف الزائدة.","patch":"def normalize_tags(tags):\n return ",".join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI ","ai","Code"],"expected":"ai,code"},{"input":null,"expected":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"لم يتم التنفيذ. يُفترض أن المدخلات غير الخالية من القيمة هي سلاسل."}البيانات الوصفية: Claude — HTTP 200 · 10.832 ثانية · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7.71 ثانية · سبب_الإنهاء=إيقاف · عدد_رموز_الموجهة=146 · عدد_رموز_الإكمال=305
الحكم النهائي
الخيار العملي
ما هو النموذج الأنسب لعملك؟
يتصدر GPT-6 Sol هذه المجموعة الصغيرة من النتائج الأولية لأنه أكمل العقد الطويل المعدل، بينما وصل Claude Opus 5.5 إلى الحد الأقصى المشترك للإنتاج البالغ 2,400 توكن. ويتصدر Claude Opus 5.5 مهمة الكود/JSON من حيث دقة التشخيص. أما في مجال توليف المصادر، فقد كان هناك تعادل.
اختر GPT-6 Sol عندما تكون الأولوية الملحة هي إنجاز وثيقة قرار طويلة وتخضع لقيود متعددة في مرحلة واحدة. اختر Claude Opus 5.5 عندما يكون من المفيد، في مراجعة الكود أو المخرجات المنظمة، إجراء تشخيص أكثر وضوحًا وإجراء جرد للمخاطر. إذا كان عملك يجمع بين الاثنين، فقم بتوجيه كل مهمة إلى النموذج الأنسب لها بدلاً من فرض نموذج واحد شامل.
يوفر لك GlobalGPT طريقة عملية لتجميع كل من النماذج وباقي مراحل سير عمل الذكاء الاصطناعي في لوحة تحكم واحدة. وبذلك، يمكن أن تظل عمليات البحث والكتابة والبرمجة والصور والفيديو وأعمال الإنتاج المرتبطة بواجهة سطر الأوامر (CLI) ضمن بيئة عمل واحدة.
الأسئلة الشائعة
أي طراز فاز في المقارنة؟
تصدر GPT-6 Sol المجموعة الصغيرة من النتائج الأولى بنتيجة 28.5 مقابل 26.5 بعد استبعاد مهمة الحدود الأصلية وتصحيح استنتاج عقد JSON. وجاءت هذه الميزة نتيجة إكمال العقد الطويل المنقح في إطار نفس الحد الأقصى للإخراج البالغ 2,400 توكن؛ وتصدر Claude Opus 5.5 مهمة الكود والإخراج المنظم، بينما انتهت مهمة توليف المصدر بالتعادل.
لماذا تم استبعاد الاختبار الطويل الأول؟
لم يذكر السؤال الأصلي اسم أي من النموذجين. وقد رفض كلا النموذجين بشكل صحيح التخمين بشأن الهويات المفقودة، لذا فإن هذا الرد يهدف إلى التحقق مما إذا كان النموذج يطلب السياق المفقود بدلاً من التظاهر بمعرفته.
هل يُعد Claude Opus 5.5 أفضل للبرمجة؟
في مهمة الترميز وملف JSON هذه، قدم نظام Claude Opus 5.5 تشخيصًا أكثر دقة وقائمة مخاطر منظمة. ولا تكفي مهمة واحدة لوضع تصنيف عالمي للترميز.
هل يُعد GPT-6 Sol أفضل في الكتابة؟
أكمل GPT-6 Sol المذكرة المطولة المنقحة ضمن النطاق المطلوب في الناتج الأول. وتدعم هذه النتيجة توصية سير العمل الخاصة بهذا الاختبار، ولا تمثل ادعاءً عامًّا بشأن كل مهمة كتابة.
هل يمكنني اختبار كلا الطرازين دون تغيير المنصة؟
تم تصميم GlobalGPT ليكون اشتراكًا في الذكاء الاصطناعي متعدد النماذج، يضم وظائف متعددة للذكاء الاصطناعي في لوحة تحكم واحدة. وهو مفيد في استخدام حزمة المطالبات نفسها الخاصة بالبحث والكتابة والبرمجة عبر مختلف النماذج، والحفاظ على سير العمل في مكان واحد.
جلوبال جي بي تي تي يتيح لك الاحتفاظ بكل من النماذج وبقية سير عمل الذكاء الاصطناعي الخاص بك في مكان واحد. ابدأ بالنموذج الذي يناسب المهمة الحالية، ثم انتقل بالعمل عبر مراحل البحث، والكتابة، والبرمجة، والصور، والفيديو، أو خطوات الإنتاج المرتبطة بواجهة سطر الأوامر (CLI) دون الحاجة إلى فتح خدمة منفصلة لكل جزء.









