Claude Fable 5.1 هو الطراز الجديد المتاح للجميع من Anthropic والمخصص للبرمجة، والأعمال المعرفية، وحل المشكلات التي تستغرق وقتًا طويلاً، والبحث العلمي. تم إصداره في 1 سبتمبر 2026. التغيير الأبرز لا يتمثل في رفع السعر المعلن لواجهة برمجة التطبيقات (API): حيث ظل سعر الإدخال عند $10 لكل مليون توكن، وظل سعر الإخراج عند $50. بدلاً من ذلك، خفضت Anthropic أسعار قراءة ذاكرة التخزين المؤقت إلى $0.25 لكل مليون توكن، وتُقدّر تكاليف أقل لأحمال العمل التي تعيد استخدام الكثير من السياق.
وهذا يجعل من الضروري النظر بجدية إلى Fable 5.1 عندما يعتمد عملك على المستندات الطويلة، أو السياقات المتكررة، أو التحليلات المقيدة بعناية. فهو لا يجعل كل مسار وصول متطابقًا، ولا يحول معيار الأداء الخاص بأحد الموردين إلى حكم مستقل. والسؤال المفيد أبسط من ذلك: هل يوفر لك المسار الذي تخطط لاستخدامه السياق، وعناصر التحكم، وشروط الخصوصية، وسلوك النموذج التي يحتاجها سير عملك؟
بالنسبة للفرق التي تقارن عدة مجموعات من الطرازات في مكان واحد،, مساحة العمل متعددة النماذج في GlobalGPT يُعد خيارًا عمليًّا إلى جانب المسار الرسمي. وهو مفيد لمقارنة النماذج المتاحة في نفس المهمة؛ لذا تأكد من الدليل الحالي وتغطية الخطة قبل اعتبار أي منصة مسار وصول Fable 5.1 الخاص بك.

ما هو Claude Fable 5.1؟
أطلقت Anthropic منتج Fable 5.1 جنبًا إلى جنب مع Mythos 5.1. وتصف الشركة هذين المنتجين بأنهما يستندان إلى نفس النموذج الأساسي مع اختلاف في إجراءات الحماية وقواعد الوصول: فـ«Fable» متاح للجميع بشكل عام، بينما يُخصص «Mythos» لبرامج الوصول الموثوق به في مجالي الأمن السيبراني وعلوم الحياة. وهذا التمييز مهم. لا ينبغي تفسير إمكانيات Mythos على أنها وصول عادي إلى Fable.
يُركز الإصدار Anthropic على الإصدار Fable 5.1 في مجالات البرمجة، والأعمال المعرفية، وحل المشكلات طويلة الأمد، والبحث العلمي. وهذه مجرد مزايا يُعلن عنها المنتج، وليست وعدًا بأن كل واجهة برمجة تطبيقات (API) ستوفر نفس الأدوات أو القيود.
ما يجعل هذا الإصدار أكثر أهمية من مجرد عملية إعادة تسمية نموذج روتينية هو الجمع بين القدرات، وضوابط الجهد، وفعالية استخدام ذاكرة التخزين المؤقت، وحدود نشر أكثر وضوحًا. بالنسبة للمطور، قد يعني ذلك نموذجًا يسهل تبريره في المهام ذات السياقات المتكررة. أما بالنسبة لفريق البحث، فيعني ذلك فصل إجابة قوية مرتبطة بالمصدر عن سير عمل لا يزال يحتاج إلى الوصول إلى الأدوات، والمراجعة البشرية، وشروط الاحتفاظ الخاصة بالمسار.
- استخدمه من أجل: تشخيص الكود، وتوليف الوثائق، والتحليل الذي ينطوي على قيود كثيرة، وتفسير الصور وتحويلها إلى نص.
- تأكد أولاً من: قيود السياق، وتوافر الأدوات، والاحتفاظ بالبيانات، والمنطقة، والوصول إلى الباقة على المسار الذي اخترته.
- لا تستنتج ما يلي: أن «Mythos Access»، أو مواصفة خاصة بالسحابة، أو معيار أداء رسمي، تُطبق تلقائيًّا على حسابك.
نظرة سريعة على الهوية
أين يمكنك الوصول إلى Claude Fable 5.1؟
تقول Anthropic إن النموذج Fable 5.1 متاح عبر منصاتها، وتذكر AWS وGoogle Cloud وMicrosoft Azure. وفي واجهة برمجة التطبيقات (API) الخاصة بـAnthropic، فإن معرّف النموذج هو كلود-القصص الخيالية-5-1. فيما يتعلق بمسار AWS Bedrock، فإن قواعد السياق والمخرجات والمدخلات والذاكرة المؤقتة والاحتفاظ الموثقة تنتمي إلى وثائق AWS، ولا ينبغي افتراض تطبيقها على أي مسار آخر.
- واجهة برمجة التطبيقات Anthropic: استخدم معرّف النموذج الموثق والحدود الحالية للمنصة.
- AWS Bedrock: تحدد AWS نافذة سياق تضم مليون رمز، وحد أقصى للإخراج يبلغ 128 ألفًا، وإدخالًا للنص والصور، وإخراجًا نصيًّا لمسارها.
- مسارات سحابية أخرى: التأكد من المنطقة والخطة ودعم الأدوات ومعالجة البيانات قبل عملية الترحيل.
طرق الوصول: ما الذي يمكن نقله وما الذي لا يمكن نقله
يجب قراءة كل مواصفات على أنها خاصة بمسار معين. ولا يضمن اسم النموذج وحده وجود نفس الحدود أو المدخلات أو الأدوات أو شروط البيانات.
رقم تعريف الطراز:
كلود-القصص الخيالية-5-1القيود الحالية، والمناطق، وعناصر التحكم المدعومة.
سياق 1M، إخراج 128K، إدخال نص/صورة، إخراج نص.
أهلية المنطقة والحساب.
معرّف النموذج الدقيق، وإخراج JSON منظم، ومدخلات صور بتنسيق PNG.
أدوات نظام الملفات وتشغيل الوكلاء.
ما الغرض من تصميم Fable 5.1؟
يتميز الموقف الرسمي بطابعه العام، لذا من المفيد التمييز بين ما هو موثق وما يمكن إثباته من خلال فحص عملي بسيط. في اختباراتنا ذات المدخلات المغلقة والمخرجات الأولى عبر واجهة برمجة التطبيقات (API) Anywhere، أنتج Fable 5.1 تصحيحًا بسيطًا بلغة جافا سكريبت احتفظ بالقيم الصفرية، وتتبّع تناقضًا في ميزانية مجموعة المستندات دون حله بالتخمين، وحافظ على نتيجة الملاحظة غير السببية، واستخرج قيمًا مصنفة من مخطط PNG. تعد هذه إشارات مفيدة للمهام المقيدة، وليست إعادة إنتاجًا لمعايير أداء الوكيل طويلة المدى الخاصة بـ Anthropic.
لم يوفر مسار واجهة برمجة التطبيقات (API) نفسه أدوات خاصة بنظام الملفات أو أدوات التحقق من الصحة. ولهذا السبب، لم ندّعِ الحصول على نتيجة حقيقية تتعلق بالوكيل المستقل.
خريطة القدرات: المطالبة، والتحقق، والحدود
Claude Fable 5.1 التغييرات في الأسعار والتكاليف
يُدرج Anthropic معدل Fable 5.1 عند $10 لكل مليون رمز مدخلات و$50 لكل مليون رمز مخرجات، وهي نفس معدلات القائمة الخاصة بـ Fable 5. تبلغ قراءات ذاكرة التخزين المؤقت $0.25 لكل مليون رمز. تقدر Anthropic انخفاض التكلفة بنحو 25% لأحمال العمل النموذجية، وبما يصل إلى حوالي 45% للأعمال المعقدة التي تعتمد بشكل كبير على السياق؛ وهذه تقديرات Anthropic تستند إلى افتراضات أحمال العمل المعلنة، وليست خصمًا مضمونًا.
المتغير الرئيسي هو إعادة الاستخدام. فلن تستفيد المطالبة التي تُقدم لمرة واحدة كثيرًا من تسعير القراءة من ذاكرة التخزين المؤقت، في حين أن سير العمل الذي يرسل بشكل متكرر موجزًا كبيرًا أو ملخصًا لقاعدة الكود أو حزمة سياسات يمكنه الاستفادة من ذلك. وللاطلاع على سياق الجيل الأقدم، انظر دليل تسعير Claude Fable 5. إذا كانت المقارنة التي تجريها هي بين اشتراكات منفصلة وليس بين الفوترة باستخدام رموز API،, خطط GlobalGPT توفر مسار اشتراك منفصل متعدد النماذج؛ وهي لا تمثل تحويلًا لأسعار واجهة برمجة التطبيقات (API) الخاصة بـ Anthropic.
أسعار قائمة واجهة برمجة التطبيقات (API) الرسمية
حرك شريط التمرير لتحديد حجم المدخلات الشهرية. يفترض التقدير أن الناتج يساوي 20% من المدخلات، وأن 50% من الرموز المميزة للمدخلات تمثل عمليات قراءة من ذاكرة التخزين المؤقت.
10 ملايين رمز إدخال شهريًّاClaude Fable 5.1 مقابل Fable 5: هل يُعد هذا تحديثًا ذا قيمة؟
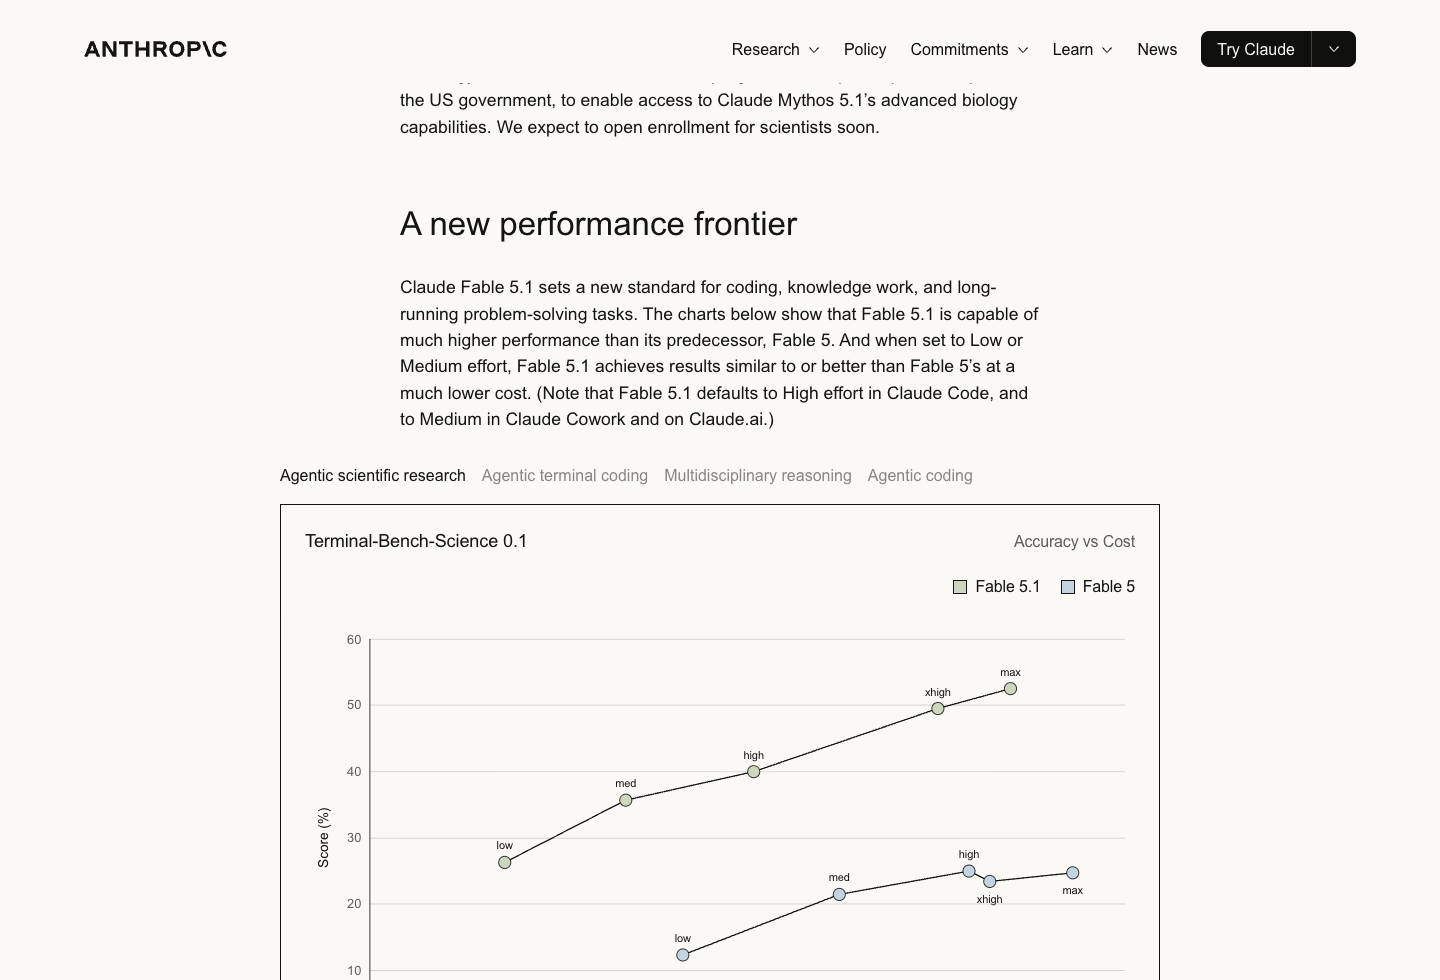
سجل Anthropic درجات أعلى في Fable 5.1 مقارنةً بـ Fable 5 في عدة تقييمات خاصة بالمهام، بما في ذلك 52.6% مقابل 24.7% في اختبار Terminal-Bench-Science، 55.8% مقابل 42.0% في اختبار Terminal-Bench، 31.4% مقابل 17.1% في اختبار AutomationBench، و73.4% مقابل 70.5% في اختبار CursorBench. وبلغت نتيجة GDPval-AA v2 1853 مقابل 1723. هذه أرقام أبلغ عنها Anthropic باستخدام مجموعات اختبار وشروط خاصة بها، لذا فهي تمثل سياقًا مفيدًا وليس تصنيفًا عامًا تم إعادة إنتاجه بشكل مستقل.
لم نقم بإجراء اختبار أساسي مباشر لنظام Fable 5 في نفس المكان. ولذلك، فإن الاستنتاج الصادق بشأن الترقية مشروط: تشير الأدلة الرسمية إلى مكاسب محددة في المهام وتكلفة أقل لقراءة ذاكرة التخزين المؤقت، في حين أن التقييم المستقل الذي يقارن بين Fable 5.1 وFable 5 لا يزال غير مكتمل.
إذا كان اختيارك يتجاوز نطاق هذه الترقية وحدها، فإن مقارنة بين Claude Fable 5 و GPT 5.5 يُعد هذا خيارًا أفضل للقراءة التالية بدلاً من اعتبار صف واحد من نتائج الاختبار المعياري بمثابة تصنيف شامل.
نتائج المهام المبلغ عنها في Anthropic
الاختبارات العملية: ما قمنا بفحصه فعليًّا
استخدمنا مسار واجهة برمجة التطبيقات (API) لـ Anywhere /v1/المحادثة/الإكمال بعد التحقق من معرّف النموذج الذي تم إرجاعه كلود-القصص الخيالية-5-1 ومسبار صغير ذو مخرجات منظمة. كل نتيجة من النتائج الواردة أدناه هي أول مخرجات صالحة من مهمة «مجمدة» ذات مدخلات مغلقة. تم رفض المدخلات بتنسيق SVG قبل وصول T05 إلى النموذج، لذا تم تحويل نفس التجهيز إلى تنسيق PNG وتشغيله مرة واحدة؛ ولم يتم استبدال أي نتيجة صالحة.
أدلة من النوع «الإخراج الأولي»
حددت الإجابة سبب اختفاء القيم الصفرية، واقترحت تعديلاً بسيطاً على الكود، ولم تذكر صراحةً إجراء اختبار.
{
  "root_cause": "تقوم الدالة scores.filter(Boolean) بإزالة جميع القيم التي تُعتبر "falsy"، بما في ذلك الدرجة الرقمية 0، لذا فإن الدالة normalize([0, 4, null, undefined]) تستبعد القيمة 0 وتُرجع [4] بدلاً من [0, 4]. الشرط واسع جدًّا؛ يجب أن يستبعد فقط القيم null و undefined.",
  "unified_diff": "--- a/normalize.js\n+++ b/normalize.js\n@@ -1,3 +1,3 @@\n function normalize(scores) {\n-  return scores.filter(Boolean);\n+  return scores.filter((score) => score != null);\n }",
  "expected_test_results": "من المتوقع أن تُرجع normalize([0, 4, null, undefined]) [0, 4] لأن condition "score != null" تكون كاذبة فقط في حالة null و undefined، لذا يتم الاحتفاظ بـ 0. من المتوقع أن تُرجع normalize([7]) [7]، دون تغيير. هذه توقعات تستند إلى قراءة الكود؛ ولم يتم إجراء أي اختبار.",
  "remaining_risk": "القيم الأخرى التي تُعتبر كاذبة والتي تم تصفية استبعادها سابقًا (NaN، سلسلة فارغة، false) سيتم الاحتفاظ بها الآن، وهو ما يتوافق مع المتطلبات المذكورة (إزالة null/undefined فقط) ولكنه قد يظهر كتغيير في السلوك إذا كان أي مستدعي يعتمد على التصفية القديمة. إذا كان الإدخال غير مصفوفة، فإن الدالة لا تزال تُحدث استثناءً، كما كان الحال من قبل."
}قامت الاستجابة بمطابقة المطالبات المقدمة، واكتشفت التضارب بين $18,000 و$20,000، وتركَت السبب دون حل بدلاً من اختلاق سبب آخر.
{
  "الادعاءات": [{"الادعاء":"بدأ البرنامج التجريبي في 3 مارس بمشاركة 120 طالبًا مسجلاً.","source":"الوثيقة أ","section":"A1","status":"مذكور"},{"claim":"تم تسجيل الحضور أسبوعياً.","source":"الوثيقة أ","section":"A2","status":"مذكور"},{"claim":"عند نقطة التحقق في 31 مارس، كان 96 طالبًا من أصل 120 طالبًا مسجلاً قد حضروا ثلاث جلسات على الأقل.","source":"الوثيقة ب","section":"ب1","status":"مذكور"},{"claim":"بلغت ميزانية البرنامج $18,000.","source":"الوثيقة ب","section":"ب2","status":"متناقضة"},{"claim":"تسرد المذكرة المالية ميزانية برنامجية معتمدة تبلغ $20,000.","source":"الوثيقة C","section":"C1","status":"متناقض"},{"claim":"لا تذكر المذكرة ما إذا كان الفرق في الميزانية يعكس تعديلاً أم خطأً في التسجيل.","source":"الوثيقة C","section":"C2","status":"مذكور"}],
  "التناقضات": [{"الموضوع":"الميزانية البرنامجية","المصادر":[{"المصدر":"الوثيقة ب","القسم":"ب2","القيمة":"$18,000"},{"source":"الوثيقة C","section":"C1","value":"$20,000"}],"description":"تشير الوثيقة ب إلى أن ميزانية البرنامج كانت $18,000، بينما تذكر الوثيقة ج أن ميزانية البرنامج المعتمدة تبلغ $20,000."}],
  "unresolved": [{"issue":"ما إذا كان الفرق البالغ $2,000 بين الميزانية البالغة $18,000 (الوثيقة B، B2) والميزانية المعتمدة البالغة $20,000 (الوثيقة C، C1) يعكس تعديلاً أم خطأً في التسجيل.","source":"الوثيقة C","section":"C2","reason":"تنص الوثيقة C صراحةً على أن الملاحظة لا توضح سبب الفرق، ولا تتناول أي وثيقة أخرى مقدمة هذا الأمر."}]
}لم تتضمن نقطة نهاية الدردشة التي تم التحقق منها أي أدوات لكتابة الملفات أو أدوات التحقق من الصحة. ولذلك، لم يتم إرسال المهمة كاختبار لجودة النموذج، ولا يُدّعى وجود أي ناتج أو درجة.
وقد حسبت الإجابة الفرق الملحوظ ورفضت الاستنتاج السببي غير المدعوم بالأدلة.
{
  "mean_control": {"value": 10, "units": "نقاط"},
  "mean_treatment": {"value": 14, "units": "points"},
  "difference": {"value": 4, "units": "points", "direction": "treatment minus control"},
  "supported_conclusion": "في مجموعة البيانات هذه، سجلت المجموعة الخاضعة للعلاج متوسط درجات أعلى بـ 4 نقاط من المجموعة الضابطة (14 مقابل 10 نقاط).",
  "الاستنتاج غير المدعوم": "أن المعالجة هي التي تسببت في ارتفاع الدرجة بمقدار 4 نقاط؛ حيث لم يتم توزيع المجموعات عشوائيًّا ولم يتم جمع درجات خط الأساس، لذا قد يعكس الفرق اختلافات موجودة مسبقًا بين المجموعات.",
  "القيود": ["التوزيع غير العشوائي للمجموعات، لذا لا يمكن استبعاد وجود تحيز في الاختيار"، "عدم وجود درجات أساسية، لذا لا يمكن تقييم الاختلافات الموجودة مسبقًا بين المجموعات"، "حجم العينة صغير جدًّا (n=4 لكل مجموعة)"، "لم تُحسب إحصائيات استدلالية؛ ولم يتم اختبار الدلالة الإحصائية للفرق"، "تصميم الدراسة القائم على الملاحظة لا يدعم الادعاءات السببية"]
}أظهرت عملية التشغيل التي أجريت باستخدام برنامج PNG القيم المُصنَّفة لشهر أبريل، وميزت التقديرات البصرية عن القيم المُصنَّفة، وتجنبت الاستقراء غير المدعوم.
{
  "april_alpha": 30,
  "april_beta": 25,
  "trend": "يزداد كل من ألفا وبيتا بشكل مطرد كل شهر من يناير إلى أبريل، مع بقاء ألفا باستمرار أعلى من بيتا بحوالي 5 ساعات (تقدير بصري: يناير ~15/10، فبراير ~20/15، مارس ~25/20، أبريل 30/25 كما هو موضح).",
  "unsupported": ["قيم شهر أبريل موضحة بوضوح على الرسم البياني؛ قيم يناير وفبراير ومارس هي تقديرات بصرية فقط"، "لا تظهر أي بيانات بعد أبريل أو قبل يناير، لذا لا يمكن إصدار أي استنتاجات بشأن الأشهر الأخرى"، "الوحدات محددة على أنها ساعات دراسة، لكن لم يتم ذكر المصدر أو حجم العينة أو تعريف مجموعتي ألفا وبيتا"]
}
السلامة والبيانات وحدود التوافق
يمكن استخدام Fable 5.1 لاكتشاف الثغرات الأمنية في البرامج، لكن Anthropic تنص على أنه غير مخصص لتطوير برامج الاستغلال، وقد تحيل بعض الأعمال ذات الاستخدام المزدوج إلى Opus. تخضع أبحاث علوم الحياة والوصول إلى Mythos لقيود منفصلة. ويختلف الاحتفاظ بالبيانات باختلاف المسار: فعلى سبيل المثال، لا ينبغي تعميم وثائق AWS على كل مسار Claude أو مسار واجهة برمجة تطبيقات (API) تابعة لجهة خارجية.
كما تشير Anthropic إلى وجود ثغرات في نطاق تغطية التوافق الخاص بها فيما يتعلق بالسياقات الطويلة جدًّا، والسيناريوهات متعددة العوامل، والمهام المستحيلة. وهذا سبب يدعو إلى التحقق من صحة النشر ذي المخاطر العالية من خلال مهمة محدودة من اختيارك، وليس سببًا لتجاهل التحسينات الموثقة التي حققها النموذج.
من ينبغي أن يجرب برنامج Claude Fable 5.1؟
جرب هذه الخدمة عندما يستفيد عملك من دعم البرمجة الدقيق، أو التوليف المرتبط بالمصدر، أو فحوصات التناقض في المستندات، أو استخراج النص من الصور. تحقق أولاً إذا كنت بحاجة إلى نشر إقليمي محدد، أو شروط عدم الاحتفاظ بالبيانات، أو وكيل يستخدم أدوات، أو مقارنة مباشرة بنموذج Fable 5. إذا كنت تختار خطة Claude عامة بدلاً من الوصول إلى واجهة برمجة التطبيقات (API)، فإن الخيار المنفصل دليل تسعير كلود للذكاء الاصطناعي يشرح الفرق بين الخطة وواجهة برمجة التطبيقات (API).
Claude Fable 5.1 الأسئلة الشائعة
ما الفرق العملي بين نظامي Claude Fable 5.1 و Mythos 5.1؟
يصف Anthropic هذين النموذجين بأنهما نفس النموذج الأساسي مع اختلاف في إجراءات الحماية وقواعد الوصول. أما Fable 5.1 فهو المسار المتاح للجميع الذي نناقشه هنا. ويُخصص Mythos 5.1 لبرامج الوصول الموثوق بها في مجالي الأمن السيبراني وعلوم الحياة، لذا فإن إمكانيات Mythos لا تشكل وعدًا بشأن حساب Fable قياسي.
هل يمكنني استخدام Claude Fable 5.1 في تطبيق Claude، أم أنه مخصص لواجهة برمجة التطبيقات (API) فقط؟
لا تستنتج إمكانية الوصول إلى تطبيقات المستهلكين من إعلان يتعلق بواجهة برمجة التطبيقات (API) أو الخدمة السحابية. تذكر شركة Anthropic منصاتها الخاصة ومزودي الخدمات السحابية الرئيسيين كمسارات وصول، لكن الخطة والمنطقة والحصة ومجموعة الأدوات تعتمد على المسار المختار. تحقق من نطاق الحساب المحدد الذي تنوي استخدامه قبل تغيير سير العمل المتعلق به.
ما هو الرقم التعريفي الصحيح لطراز Claude Fable 5.1؟
قوائم Anthropic كلود-القصص الخيالية-5-1 بالنسبة لواجهة برمجة التطبيقات (API) الخاصة بها. يمكن لمزودي الخدمات السحابية استخدام معرّفات خاصة بكل مسار، لذا قم بنسخ معرّف النموذج من وثائق المزود الخاصة بنقطة النهاية التي تستدعيها فعليًّا.
هل يتضمن Claude Fable 5.1 نافذة سياق بسعة مليون رمز؟
تحدد AWS نافذة سياق تبلغ 1 مليون رمز (token) وحد أقصى للإخراج يبلغ 128 ألفًا لمسار Bedrock الخاص بها. وهذا مفيد للتخطيط باستخدام Bedrock، ولكن لا ينبغي تعميمه على كل واجهة برمجة تطبيقات (API) من نوع Claude أو مستخدم أو مسار تابع لجهة خارجية دون الرجوع إلى الوثائق الخاصة بكل منها.
هل يقوم Fable 5.1 باستقبال الصور وإنشاء الصور؟
توثق AWS إدخال النصوص والصور مع إخراج نصي لمسار Bedrock. وهذا يعني أن فهم الصور موثق هناك؛ ولا يعني ذلك أن النموذج هو مُولِّد للصور أو أن كل مسار يقبل نفس التنسيقات. وفي اختبار واجهة برمجة التطبيقات (API) المحدود الذي أجريناه، نجح إدخال ملفات PNG بعد أن رفضت طبقة الطلبات ملفات SVG.
متى يكون لانخفاض سعر قراءة ذاكرة التخزين المؤقت تأثير ملموس؟
يكون الأمر مهمًا عندما يتم إعادة استخدام نفس السياق الكبير عبر الطلبات: على سبيل المثال، موجز قاعدة كود ثابت، أو مجموعة سياسات، أو حزمة بحثية طويلة. أما بالنسبة للمطالبات القصيرة المنفصلة، فإن حجم المدخلات والمخرجات العادي هو الذي يشكل الجزء الأكبر من التكلفة. استخدم الآلة الحاسبة أعلاه كتقدير تخطيطي، ثم قارنها بسلوك التخزين المؤقت الفعلي لمسارك.
هل يمكن لـ Fable 5.1 تشغيل كيان يستخدم الأدوات بمفرده؟
يعتمد ذلك على البيئة المحيطة بالنموذج. يمكن لنقطة نهاية «إكمال الدردشة» أن تُرجع إجابة نصية قوية دون الكشف عن عمليات كتابة الملفات، أو أدوات التحقق من الصحة، أو التصفح، أو بيئة الاختبار الخاصة بالمستودع. ولم تكشف مسار الاختبار الذي أجريناه عن تلك الأدوات، لذا لم يُستخدم لإثبات تنفيذ الوكيل المستقل.
هل نظام Claude Fable 5.1 أفضل بالتأكيد من نظام Fable 5؟
تشير نتائج اختبار Anthropic إلى تحسن في أداء مهام محددة وانخفاض تكلفة قراءة ذاكرة التخزين المؤقت. وهذا سبب قوي لتقييم إمكانية الترقية في الأعمال المشابهة لأعمالك، لكنه لا يُعد حكمًا نهائيًّا ومستقلاً بأن الترقية هي الخيار الأمثل في جميع الحالات. ولم تُجرَ في هذه المقالة مقارنة مرجعية لاختبار Fable 5 في نفس البيئة.
المصادر: إعلان عن إصدار Anthropic; إعلان من AWS; بطاقة نموذج Amazon Bedrock.