

الحالة الحالية، تم التحقق منها في 24 سبتمبر 2026: يُعد الطرازان ChatGPT 5.1 وGrok 4.1 نقاط مقارنة تاريخية، وليسا الخيارين الافتراضيين الحاليين للطرازات. وثائق النموذج الحالي لشركة xAI تُدرج الشركة نموذج Grok 4.6 باعتباره نموذجها العام الرائد، الذي يتميز بسياق يبلغ 500,000 توكن ومعدل استهلاك يبلغ $2 في المدخلات و$6 في المخرجات لكل مليون توكن. أما نموذج OpenAI، فيتميز بـ كتالوج الموديلات الحالية قد تجاوزت GPT-5.1، في حين أن تدرج GlobalGPT حاليًا GPT-6 Astra و Grok 4.6. تحتفظ الأقسام المرجعية أدناه بنطاقها لعام 2025؛ ولا يجب إعادة استخدام النتائج القديمة أو أرقام زمن الاستجابة أو أسعار الاشتراكات كبيانات حالية عن المنتج.
يعتمد الاختيار بين طرازي ChatGPT 5.1 وGrok 4.1 في النهاية على ما إذا كنت تفضل التأثير العاطفي أم الدقة التقنية. يتميز Grok 4.1 في المهام الإبداعية والمهام التي تعتمد على الشخصية، حيث سجل رقمًا قياسيًا بلغ 1586 نقطة على EQ-Bench، بالإضافة إلى سعره التنافسي للغاية. في المقابل، يظل ChatGPT 5.1 المعيار الذهبي لبيئات المؤسسات، حيث يستفيد من نماذج “التفكير” المتخصصة لتحقيق موثوقية فائقة في اختبارات الأداء المعقدة للبرمجة والاستدلال المنطقي مثل SWE-bench Verified. .
يخلق المشهد الخاص بالذكاء الاصطناعي لعام 2025 فجوة حادة بين “العوامل الإبداعية” و“المتخصصين في الشركات”، مما يجبر المستخدمين على الاختيار بين الشخصية غير المُصقولة والأمان على مستوى المؤسسات. ويؤدي هذا التشرذم إلى انقسام الكثيرين بين الأصالة الخام والموثوقية المثبتة.
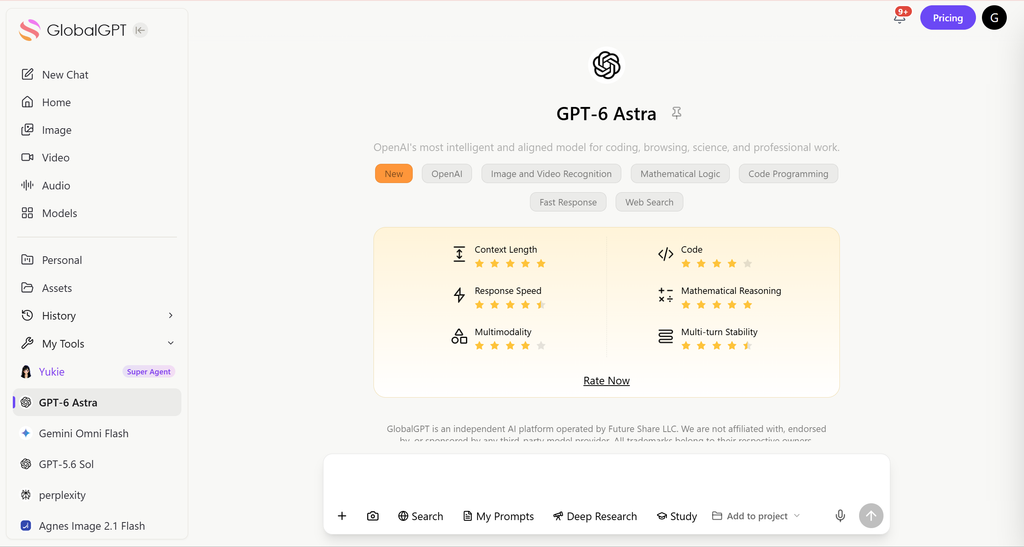
لحسن الحظ،, يتيح GlobalGPT الوصول إلى كلا نظامي الذكاء الاصطناعي الرائدين وفي الوقت نفسه، يُلغي ذلك الحاجة إلى التنازل عن ذكاء طراز Grok ودقة طراز ChatGPT. ومن خلال دمج نماذج مثل GPT-6 Astra،, Grok 4.1، Claude 4.5،, سورا 2, Veo 3.1, ، Unikorn و Kling في منصة واحدة، يمكن للمستخدمين نشر الأداة المثالية لكل مهمة محددة دون الحاجة إلى إدارة اشتراكات متعددة.
التحول الجوهري في الفلسفة: “السلامة المؤسسية” مقابل “الشخصية الحقيقية”
يكمن الاختلاف الأساسي بين هذين النموذجين في فلسفة تصميمهما: تضع OpenAI الأولوية على الفائدة المتوقعة على مستوى المؤسسات، بينما تعمل xAI على تحسين المشاركة والأصالة الخام.

- دردشةGPT 5.1 – “المهني القادر على التكيف”: صُمم هذا الطراز لتوفير الاستقرار، ويستخدم نظام توجيه ديناميكيًا يقوم بالتبديل تلقائيًّا بين المسارات “الفورية” للمهام البسيطة والمسارات العميقة “نماذج ”التفكير» للمنطق المعقد. وهي مصممة لتقليل المسؤولية إلى الحد الأدنى، مع الالتزام بإرشادات السلامة الصارمة التي تمنعها من الانخراط في فيما يتعلق بالمواضيع الحساسة أو “غير الآمنة”،, مما يجعله الخيار المفضل للبيئات المؤسسية.
- Grok 4.1 – “العميل المتمرد”: قامت xAI بتصميم Grok ليكون بمثابة وكيل يتمتع بـ“الفضول الأقصى”، يعمل بنشاط على مقاومة الرقابة “الواعية” أو الردود المُعقمة. ويستفيد هذا الوكيل من بنية سربية متوازية ضخمة لمناقشة الفرضيات داخليًّا، مما ينتج عنه ردود تبدو أكثر إنسانية وذكية، وأحيانًا مثيرة للجدل، وتستهدف بشكل خاص المستخدمين الذين يشعرون بأنهم مقيدون بضوابط الذكاء الاصطناعي القياسية.
- نهاية عصر “النموذج الواحد الذي يناسب الجميع”: في عام 2025، انقسم السوق إلى أجزاء متعددة؛ فلم يعد المستخدمون يبحثون عن ذكاء اصطناعي واحد يُعتبر “الأذكى”، بل أصبحوا يختارون بناءً على “الطابع” والفائدة المحددة المطلوبة للمهمة المطروحة. عليك فعليًّا أن تختار بين موظف مهذب وذو كفاءة عالية (ChatGPT) وشريك إبداعي لامع لكنه غير متزن (Grok).
تفصيل البنية التقنية: تحت الغطاء
تكشف مقارنة المواصفات الفنية مدى اختلاف الأولويات الهندسية بين OpenAI و xAI.
| الميزة | ChatGPT 5.1 (OpenAI) | Grok 4.1 (xAI) |
| استراتيجية نافذة السياق | 128 كيلوبايت ذاكرة نشطة + ذاكرة عميقة (يعطي الأولوية للاسترجاع الدقيق على الطول الخام) | 2 مليون توكن (متدرج) (128k “الاستدلال السريع” + “الاسترجاع البطيء”) |
| الهندسة الأساسية | التوجيه الديناميكي (التبديل بين مسار “الفوري” ومسار “التفكير”) | أسراب الوكلاء المتوازية (ينشئ عدة عوامل داخلية لمناقشة الإجابات) |
| زمن استجابة الصوت/الرد | ~550 مللي ثانية (مُحسّن لسرعة المحادثة) | ~1200 مللي ثانية+ (زمن انتقال أعلى بسبب معالجة السرب) |
| مصدر المعرفة | مدرب مسبقًا + بحث على الويب (يستخدم البحث للتحقق من الحقائق) | بث X (تويتر) في الوقت الفعلي (الوصول الأصلي إلى البيانات الاجتماعية الحية) |
- نافذة السياق حروب النوافذ: Grok 4.1 يفتخر بوجود 2 مليون نافذة سياق الرمز المميز،, باستخدام نظام متدرج حيث تكون أول 128 ألف رمز “ساخنة” (التفكير النشط)، بينما تعمل البقية كذاكرة استرجاع “دافئة”. في المقابل، يعتمد نموذج ChatGPT 5.1 عادةً على طبقة RAG ذات ذاكرة عميقة مع حد أكثر صرامة للسياق النشط (غالبًا ما يتراوح بين 128 ألف و196 ألف)، مما يعطي الأولوية لدقة الاسترجاع على طول السياق الخام.
- هندسة المنطق: يستخدم OpenAI عملية تفكير تُعرف بـ“النظام 2”، حيث يتوقف النموذج لربط الأفكار ببعضها قبل الإجابة، مما يقلل بشكل كبير من معدلات الهلوسة في مهام الرياضيات والبرمجة. يستخدم Grok 4.1 تقنية “أسراب الوكلاء المتوازية”، التي تُنشئ العديد من الوكلاء الداخليين لتقييم الإجابات وصقلها في الوقت الفعلي، وهو ما يُعد فعالاً بشكل خاص في سير العمل المعقد والمتعدد الخطوات الذي يعتمد على الوكلاء.
- الكمون والسرعة: للتفاعلات السريعة، تم تحسين الوضع ’Instant“ في ChatGPT 5.1 لتقديم استجابات في أقل من ثانية، مما يجعله مثاليًّا للاستفسارات السريعة. صُمم نموذج Grok 4.1 Fast لتحقيق التوازن بين السرعة واستخدام الأدوات، لكن اعتماده على البحث عن البيانات في الوقت الفعلي على X (تويتر) قد يؤدي إلى تأخير متغير مقارنةً بقاعدة المعرفة المُدرَّبة مسبقًا في نموذج ChatGPT.

معايير المقارنة المباشرة: ما تقوله البيانات الرسمية
في حين أن الضجة التسويقية كبيرة، فإن النتائج الرسمية للمعايير المرجعية ترسم صورة واضحة عن المجالات التي يتفوق فيها كل طراز بالفعل.
- الذكاء العاطفي (EQ): حقق Grok 4.1 درجة قياسية بلغت 1586 على قائمة EQ-Bench، متفوقًا بشكل كبير على منافسيه من خلال فهمه للفروق الدقيقة والسخرية والمعاني الضمنية(). هذا الذكاء العاطفي العالي يجعله متفوقًا في المهام التي تتطلب التعاطف، مثل صياغة رسائل البريد الإلكتروني الصعبة أو سرد القصص الإبداعية، حيث تبدو الردود الآلية غريبة.

- التفكير العلمي: في اختبار GPQA Diamond (أسئلة علمية على مستوى الدكتوراه)، في تحليل عام 2025، تم تقديم Gemini 3 كخيار رائد، لكن GPT-5.1 (Pro/Thinking) يتبعه عن قرب بدرجات تتراوح بين 81 و87%، مما يدل على موثوقية فائقة في مجال البحث الأكاديمي. يقدم Grok 4.1 أداءً رائعًا، لكنه يتخلف عمومًا قليلاً عن النماذج المخصصة لـ“الاستدلال” من حيث الدقة العلمية البحتة.
- الحقيقة والهلوسة: لقد خفض Grok 4.1 معدل الهلوسة إلى حوالي 4.22% من خلال الاستفادة من أدوات التحقق من البحث في الوقت الفعلي. يستخدم ChatGPT 5.1 “وضع ”التفكير» للتحقق من صحة الحقائق, ، بهدف تحقيق انخفاضات مماثلة في معدلات الخطأ، لا سيما في مجالات القدرات “العالية” مثل علم الأحياء والكيمياء.

الترميز والتطوير: الدقة مقابل سير العمل الوكالي
بالنسبة للمطورين، يعتمد الاختيار على ما إذا كنت بحاجة إلى تعديلات جراحية على الكود أو وكيل مستقل كامل المهام.
- للمطورين – GPT-5.1: يتفوق ChatGPT 5.1 في الحفاظ على سلامة المستودع باستخدام
apply_patchأداة تسمح بإجراء تعديلات جراحية على قواعد الكود الحالية دون إعادة كتابة الملفات بالكامل. تحقق هذه الأداة درجة عالية في SWE-bench Verified (حوالي 74.9%)، مما يجعلها الخيار الأكثر أمانًا للاندماج في خطوط الإنتاج المؤسسية الراسخة حيث لا يمكن قبول التغييرات الجذرية.

- للمسؤولين المتكاملين – Grok 4.1: يبرز Grok في سير العمل القائم على الوكلاء من خلال “واجهة برمجة تطبيقات أدوات الوكلاء” (Agent Tools API)، التي تتيح له ربط عدة إجراءات — مثل البحث في الوثائق وكتابة الكود وتنفيذه — في حلقة متكررة. وقد تم تحسينه من أجل “البرمجة الحدسية” (vibe coding)، حيث يصف المطور هدفًا عامًّا، ويقوم Grok بسرعة بإنشاء نموذج أولي لحل عملي باستخدام نافذة السياق الضخمة الخاصة به لفهم نطاق المشروع بأكمله.
- نتائج SWE-bench الموثقة: في حين أن GPT-5.1 يحمل درجة مؤكدة تبلغ ~74.9%، فإن Grok 4.1 يدعي أداءً تنافسيًا في نفس المستوى (79% وفقًا لبعض المقارنات)، مدفوعًا بقدرته على التصحيح الذاتي باستخدام أسراب الوكلاء المتوازية.

إذا كنت ترغب في مقارنة قدرات الترميز هذه جنبًا إلى جنب على قاعدة الترميز الخاصة بك، فإن GlobalGPT يوفر بيئة موحدة لتشغيل كلا النموذجين مقابل نفس الموجه.
“اختبار الانطباع” العملي المكون من 9 جولات: اختبارات قابلية الاستخدام
بالإضافة إلى المعايير المرجعية، كيف تبدو هذه النماذج في الاستخدام اليومي؟ تكشف الاختبارات عن شخصيات مميزة.

- الكتابة الإبداعية: في الاختبارات العمياء، فضّل المستخدمون الناتج الإبداعي لـ Grok 4.1 في 64% من الحالات، لأنه يخلق توتراً، ويستخدم تفاصيل حسية، ويتجنب ’صوت الذكاء الاصطناعي“ المبتذل الشائع في ChatGPT. يُظهر Grok استعدادًا للمخاطرة في السرد، في حين أن ChatGPT 5.1 غالبًا ما يلجأ إلى حلول آمنة على غرار ”ديزني“.

- المنطق والفخاخ: عند طرح أسئلة لغوية خادعة (مثل: “17 خروفًا، ماتت جميعها ما عدا 9”)، يتمكن نموذج Grok 4.1 من تحديد الفخ اللغوي بشكل صحيح وشرحه لماذا إنها خدعة. يحل برنامج ChatGPT 5.1 المسألة الحسابية بشكل صحيح، لكنه غالبًا ما يغفل الفروق الدقيقة في الحوار، حيث يعاملها على أنها مسألة منطقية بحتة.
- الفكاهة والنبرة: يتفوق Grok 4.1 في أسلوب الفكاهة “الساخرة” والكوميديا السوداء، حيث ينتج مقاطع كوميدية من نوع “ستاند-أب” تتسم بالجرأة والإنسانية. أما ChatGPT 5.1 فيواجه صعوبة في هذا المجال، حيث غالبًا ما ينتج «نكات آمنة» أو نكات أبوية تفتقر إلى الحدة المطلوبة للكوميديا الحقيقية، وذلك بسبب التزامه الصارم بمعايير الأمان.
قدرات متعددة الوسائط: الرؤية والصوت والفيديو
القدرة على الرؤية والسمع وإنتاج الوسائط هي ساحة معركة رئيسية.

- إنتاج الفيديو: يتكامل ChatGPT 5.1 بشكل أصلي مع سورا 2, ، مما يتيح للمستخدمين إنتاج فيديو دقيق من الناحية الفيزيائية مقاطع فيديو (تصل مدتها إلى 25 ثانية) مباشرةً داخل واجهة الدردشة. وفي المقارنة التي أُجريت عام 2025، كان نموذج Grok 4.1 يفتقر إلى نموذج أصلي لتوليد الفيديو من هذا العيار، حيث كان يعتمد بدلاً من ذلك على نماذج لتوليد الصور مثل Aurora أو Flux، مما جعله متخلفًا في سير عمل الفيديو.
- زمن انتقال الصوت: بالنسبة للتفاعل الصوتي في الوقت الفعلي، يُعد زمن الاستجابة عاملاً حاسماً. ويبلغ زمن الاستجابة في الوضع الصوتي لـ GPT-5.1 حوالي 550 مللي ثانية، مما يوفر تجربة تفاعلية سريعة تشبه المحادثة الطبيعية. أما معالجة الصوت في Grok 4.1 فهي أبطأ، حيث يتجاوز زمن الاستجابة في كثير من الأحيان 1200 مللي ثانية، مما يجعلها تبدو أشبه بتبادل الاتصالات عبر جهاز اللاسلكي أكثر من كونها محادثة طبيعية.
- تحليل الصور: يتفوق GPT-5.1 (خاصة مع تمكين Thinking) في تحليل الأرقام والرسوم البيانية العلمية، حيث حصل على درجات عالية في معيار CharXiv. يستفيد Grok 4.1 من قدراته البصرية بشكل أساسي لتحليل صور وسائل التواصل الاجتماعي والميمات من X، مما يمنحه ميزة ثقافية ولكن عيبًا علميًا.
السلامة والرقابة ومعدلات الرفض
يُعد الجدل حول مصطلح “Woke” عنصراً أساسياً في التسويق لهذه الموديلات.

- النقاش حول مصطلح “Woke”: يُشجع النموذج Grok 4.1 على اتباع نهج “الفضول الأقصى”، حيث تبلغ نسبة رفضه للمواضيع الحساسة أقل من 1%، مما يجعله مستعدًا لمناقشة القضايا السياسية أو الاجتماعية المثيرة للجدل التي تتجنبها النماذج الأخرى.
- امتثال المؤسسات: يحافظ ChatGPT 5.1 على معدل رفض يبلغ حوالي 4.5% للمستخدمين العاديين، لكنه يوفر “مستويات الثقة” للعملاء من الشركات، مما يضمن أن تظل مخرجات الشركات آمنة للاستخدام في بيئة العمل (مرشحات المحتوى غير الآمن للعمل، والامتثال القانوني)()()()(). وهذا يجعلها الخيار الوحيد القابل للتطبيق لشركات قائمة «فورتشن 500» التي لا يمكنها المخاطرة بكوارث في مجال العلاقات العامة.
- التعامل مع المشورة الطبية/القانونية: على الرغم من صورته “المتمردة”، فإن Grok 4.1 يتسم بموقف محافظ بشكل مدهش فيما يتعلق بالنصائح الطبية، حيث غالبًا ما يلتزم بالرجوع إلى المتخصصين بشكل صارم لتجنب المسؤولية القانونية. أما ChatGPT 5.1، الذي تم تحسينه من خلال تقييم HealthBench، فيحاول أن يكون “شريكًا فكريًّا” مفيدًا مع الاستمرار في التنبيه إلى المخاطر، ويقدم سياقًا طبيًّا أكثر تفصيلًا مقارنةً بـ Grok()()()().
اقتصاد التوكنات: لمحة عن الأسعار لعام 2025 (بيانات تاريخية)
الأسعار هي المجال الذي يوجه فيه Grok 4.1 أكبر ضربة له لمنافسيه.

- واجهة برمجة التطبيقات صدمة الأسعار: قامت xAI بتسعير Grok 4.1 Fast بشكل قوي عند $0.20 لكل مليون رمز إدخال, ، وهو ما يعادل تقريبًا 84% أرخص مقارنةً بـ $1.25 لكل مليون توكن مدخَل في ChatGPT 5.1. وبالنسبة للمطورين الذين يعملون على تطوير تطبيقات ذات أحجام معالجة كبيرة، يُعد هذا الفارق في السعر عاملاً حاسماً.
- “فخ الاشتراك”: للوصول إلى أفضل إصدار من Grok (غير API)، يجب على المستخدمين الاشتراك في X بريميوم+ ($16/شهر). للحصول على أفضل أداء من ChatGPT، تحتاج إلى ChatGPT Plus ($20 في الشهر). وتبلغ تكلفة الاحتفاظ بالاشتراكين معًا أكثر من $400 في السنة، مما يؤدي إلى “إرهاق من الاشتراكات” كبير.”
- مدخرات المطور: بالنسبة لتطبيق يعالج 100 مليون رمز شهريًا، فإن استخدام Grok 4.1 بدلاً من GPT-5.1 يمكن أن يوفر لشركة ناشئة أكثر من $1,000 شهريًا في تكاليف API الأولية ($20 مقابل $125+).
“سير العمل المختلط”: تحقيق أقصى قدر من الكفاءة
بدلاً من اختيار أحدهما، يجمع المستخدمون الأكثر كفاءة في عام 2025 بين كلا النموذجين للاستفادة من نقاط قوتهما الفريدة.

- المرحلة 1: التفكير والبحث (Grok 4.1): ابدأ باستخدام Grok 4.1 لتبادل الأفكار، وصياغة محتوى إبداعي، أو البحث عن الأحداث الإخبارية في الوقت الفعلي باستخدام تكامله مع X. إن معدل الذكاء العاطفي العالي ومعدل الرفض المنخفض يجعله مثاليًا لتوليد مفاهيم أولية غير مفلترة.
- المرحلة 2: الهيكل والترميز (دردشةGPT 5.1): خذ المسودة الأولية أو المفهوم إلى ChatGPT 5.1 لتحسين الهيكل، والتحقق من صحة المعلومات المنطقية، أو تحويل الفكرة إلى كود جاهز للإنتاج باستخدام
apply_patchالأداة. - المرحلة 3: التحقق البصري (جيميني 3): إذا كان المشروع يتضمن بيانات بصرية معقدة أو مخططات علمية، فاستخدم Gemini 3 للتحقق من العناصر البصرية، حيث إنه يتصدر حاليًا معايير قياس الأداء في مجال الاستدلال البصري().
الحل الموحد: الوصول إلى جميع النماذج عبر GlobalGPT
إدارة ثلاثة اشتراكات منفصلة ومفاتيح API أمر غير فعال ومكلف.


- حل مشكلة إرهاق الاشتراك: GlobalGPT يدمج GPT-6 Astra, ، وGrok 4.6، و الجوزاء 3 في واجهة واحدة، مما يتيح للمستخدمين للوصول إلى أكثر من 100 نموذج من الدرجة الأولى بدءًا من بسعر $10.8 شهريًّا عند الدفع سنويًّا. وهذا يغني عن الحاجة إلى دفع $50+ شهريًّا مقابل اشتراكات منفصلة في X Premium+ وChatGPT Plus وGoogle One.

- مقارنة النتائج جنبًا إلى جنب: تتيح المنصة التبديل السلس بين النماذج، مما يتيح للمستخدمين تشغيل نفس الموجه على Grok و GPT-5.1 على الفور لمقارنة النتائج دون الحاجة إلى تبديل علامات التبويب أو تسجيل الدخول إلى حسابات مختلفة.
- كسر أقفال المنطقة: يوفر GlobalGPT إمكانية الوصول إلى النماذج المقيدة حسب المنطقة (مثل Claude 4.5 أو Grok في الاتحاد الأوروبي) دون الحاجة إلى إعدادات VPN معقدة أو التحقق من أرقام الهواتف الأجنبية.
الحكم النهائي: أي طراز يجب أن تختار؟
- اختيار المطور (خط الأساس التاريخي لـ GPT-5.1): إذا كنت بحاجة إلى إنشاء كود موثوق ومنظم وأمان على مستوى المؤسسات، فإن ChatGPT 5.1 هو الخيار الأمثل. إنه
apply_patchالأداة ودرجات SWE-bench العالية تجعلها المعيار الصناعي. - اختيار الخالق (الخط الأساسي التاريخي Grok 4.1): إذا كنت بحاجة إلى شريك في الكتابة يتمتع بشخصية مميزة وروح الدعابة ويفتقر إلى المعايير الأخلاقية، فإن Grok 4.1 هو الخيار الأفضل. إن تكلفته المنخفضة وذكائه العاطفي العالي يجعلانه أفضل أداة لإنشاء المحتوى().
- اختيار الباحث (جيميني 3): بالنسبة للاكتشافات العلمية البحتة وتحليل البيانات المرئية المعقدة، يظل Gemini 3 هو الملك المتخصص، متفوقًا على النماذج العامة في مهام الاستدلال العميق.
بشأن مشروع جديد في عام 2026: استخدم GPT-6 Astra أو مسار OpenAI آخر حالي للأعمال المنظمة، واستخدم Grok 4.6 عندما تحتاج إلى النموذج العام الحالي لـ xAI وأدوات البحث الاختيارية. استخدم المعيار القديم أدناه لفهم المفاضلة الأصلية، وليس كجدول أسعار أو توفر فوري.
الأسئلة المتكررة (FAQ)
- هل يمكن لـ Grok 4.1 تحليل ملفات PDF مثل ChatGPT؟
- نعم، يدعم الإصدار Grok 4.1 الآن تحميل الملفات ويمكنه استرداد المعلومات من المستندات عبر واجهة برمجة تطبيقات «Agent Tools»، على غرار ميزات التحليل المتوفرة في الإصدار ChatGPT.
- هل يدعم GlobalGPT الإصدارات “Pro” من هذه الطرز؟
- نعم، يوفر GlobalGPT إمكانية الوصول إلى نماذج متطورة مثل سورا 2 برو و GPT-5.1, ، والتي عادةً ما تكون محجوبة خلف مستويات باهظة الثمن على المنصات الرسمية.
- هل ChatGPT 5.1 أسرع من Grok 4.1 في الاستعلامات البسيطة؟
- نعم، بفضل الوضع “الفوري” (Instant)، يستجيب نظام ChatGPT 5.1 عادةً للاستعلامات البسيطة في أقل من ثانية (حوالي 550 مللي ثانية)، في حين أن نظام Grok 4.1 قد يستغرق وقتًا أطول بسبب العبء الإضافي الناجم عن المعالجة الجماعية.
ما الذي ينبغي أن أستخدمه في مشروع جديد عام 2026؟
ابدأ باختبار كل من GPT-6 Astra وGrok 4.6 باستخدام نفس المطالبات والملفات والأدوات ومعايير القبول. يُعد GPT-6 Astra مسار التخطيط الحالي GlobalGPT المُدرج للأعمال المنظمة؛ أما Grok 4.6 فهو النموذج العام الرائد الحالي لشركة xAI.
ما هو السعر الحالي لـ Grok 4.6 API؟
تشير الوثائق الحالية لشركة xAI إلى أن معدل Grok 4.6 يبلغ $2 لكل مليون رمز مدخل و$6 لكل مليون رمز مخرج، مع سياق يبلغ 500,000 رمز. ويُذكر أن هذا الأمر منفصل عن أي سعر للاشتراك الاستهلاكي.
هل لا تزال أرقام المعايير القياسية ChatGPT 5.1 وGrok 4.1 سارية؟
لا. فالنتائج وتقديرات زمن الاستجابة وحدود النماذج وأسعار الاشتراكات الواردة في المقارنة الأصلية تنتمي إلى إطار الاختبار الخاص بعام 2025. لذا، يجب التعامل معها على أنها سياق تاريخي وإعادة إجراء الاختبارات باستخدام معرّفات النماذج الحالية قبل اتخاذ أي قرار بشأن الشراء أو التكامل.





