
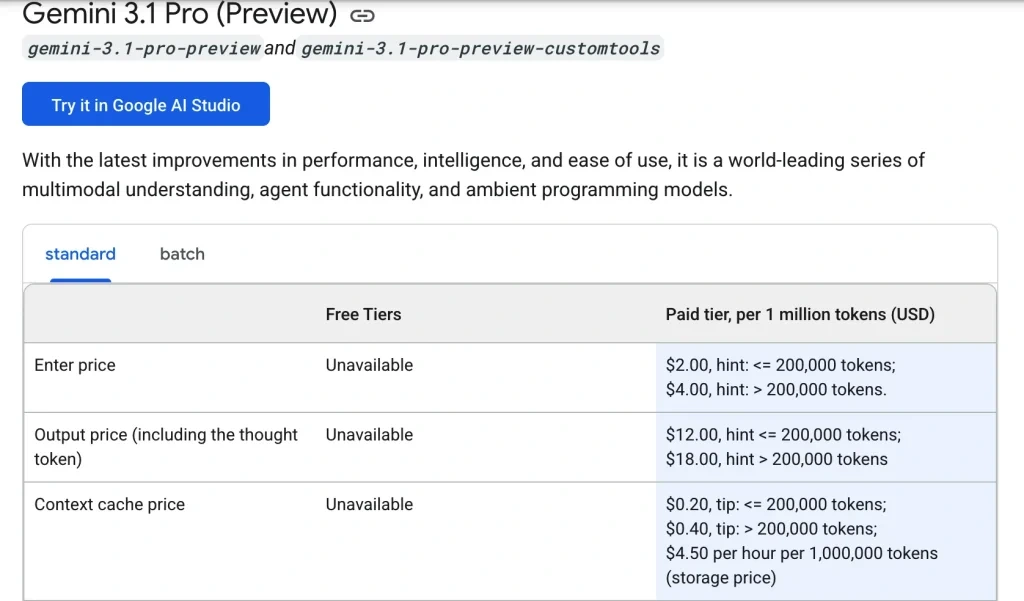
La tarifa actual de la API Gemini 3.1 Pro de Google es de $2 por cada millón de tokens de entrada y de $12 por cada millón de tokens de salida para indicaciones de hasta 200 000 tokens. Por encima del límite de entrada de 200 000, las tarifas publicadas aumentan a $4 por millón de tokens de entrada y a $18 por millón de tokens de salida. La entrada almacenada en caché tiene un precio de $0,20/M o $0,40/M, más $4,50 por millón de tokens almacenados en caché por hora en concepto de almacenamiento.
La página del modelo identifica el punto final como gemini-3.1-pro-vista previa, con un límite de entrada de 1.048.576 tokens y un límite de salida de 65.536 tokens. Admite razonamiento, llamadas a funciones, contextualización de búsquedas, contexto de URL, ejecución de código, la API Batch, Flex y opciones de prioridad. Estas capacidades explican por qué el proyecto de ley necesita más de una cifra destacada.
Si tu trabajo es interactivo —investigar un encargo, comparar modelos, escribir código y, a continuación, entregar el resultado a un agente—GlobalGPT te ofrece un espacio de trabajo por suscripción que abarca distintos modelos y funciones de IA. Los desarrolladores también pueden recurrir a la API, la CLI, el MCP y las rutas del agente Yukie cuando sea necesario trasladar el trabajo de un chat a un flujo de trabajo repetible. El precio de la API que se indica a continuación sigue siendo el precio por uso establecido por Google.
- Qué es Gemini 3.1 Pro y qué significa el límite de contexto
- Precios de la API Gemini 3.1 Pro por millón de tokens
- Ejemplos de costes de la API de Worked Gemini 3.1 Pro
- Cómo el almacenamiento en caché de contexto modifica la factura
- Los planes para consumidores son distintos de la facturación por API
- Cuándo es adecuado utilizar una API, una CLI, un MCP o un espacio de trabajo multimodelo
- Los planes para consumidores y la facturación mediante API sirven para fines distintos
- Convierte la lista de tarifas en un presupuesto real
- Cómo cambia en la práctica un contexto amplio
- Cuando un espacio de trabajo es mejor que un libro mayor simbólico
- PREGUNTAS FRECUENTES
Qué es Gemini 3.1 Pro y qué significa el límite de contexto
La página actual de Google dedicada al modelo describe el «Gemini 3.1 Pro Preview» como un modelo optimizado para un razonamiento más sólido, la ingeniería de software, el uso preciso de herramientas y los flujos de trabajo de agentes de varios pasos. El modelo acepta entradas de texto, imágenes, vídeo, audio y PDF, y devuelve texto.
| Detalles del modelo | Valor publicado | Por qué es importante en cuanto al coste |
|---|---|---|
| ID del modelo | gemini-3.1-pro-vista previa | Utiliza el ID exacto al asociar una factura o una configuración del SDK. |
| Límite de entrada | 1 048 576 tokens | Es posible utilizar un contexto amplio, pero los tokens siguen contando como entrada. |
| Límite de salida | 65 536 tokens | Las salidas largas pueden suponer la mayor parte del coste de una solicitud. |
| Herramientas | Razonamiento, llamada a funciones, fundamentación de búsquedas, contexto de URL, ejecución de código, almacenamiento en caché | El uso de herramientas puede generar solicitudes o un consumo de tokens que vaya más allá de una simple solicitud. |
Precios de la API Gemini 3.1 Pro por millón de tokens
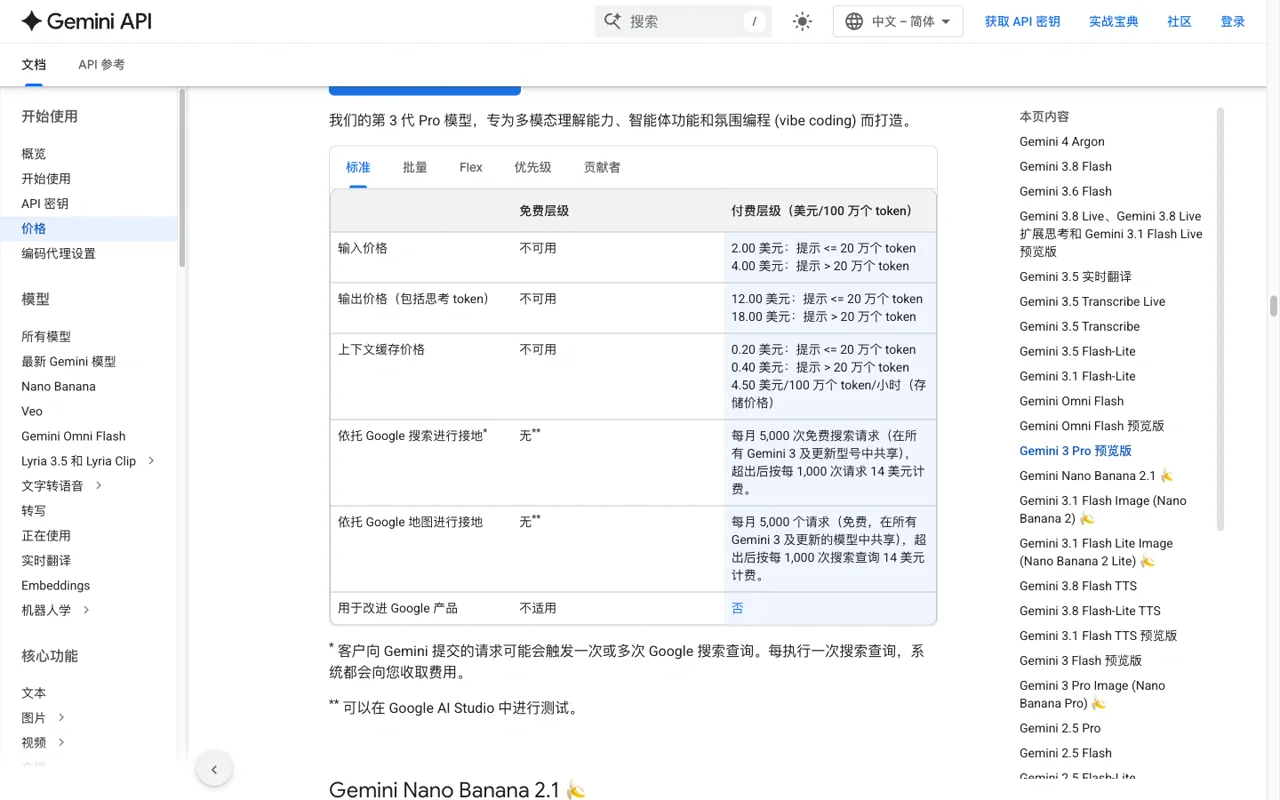
La página de precios de Google distingue entre los modos Estándar, Por lotes, Flex, Prioritario y Colaborador. La tabla siguiente utiliza el nivel de pago estándar actual que se muestra para Gemini 3 Pro Preview, cuyo enlace al modelo identifica gemini-3.1-pro-vista previa.
| Nivel de pago estándar | Texto de entrada ≤ 200 000 tokens | Solicitud > 200 000 tokens |
|---|---|---|
| Tokens de entrada | $2.00 / 1M | $4.00 / 1M |
| Tókenes de salida, incluyendo el razonamiento | $12,00 / 1M | $18,00 / 1M |
| Entrada almacenada en caché | $0.20 / 1M | $0,40 / 1M |
| Almacenamiento en caché | $4,50 / 1 millón de tokens por hora | |
| Búsqueda de Google en tierra | 5.000 solicitudes al mes repartidas entre los modelos Gemini 3 y posteriores; a partir de ahí, $14 por cada 1.000 solicitudes | |
Hay dos detalles que pueden pasar fácilmente desapercibidos. En primer lugar, el “rendimiento” incluye las fichas de pensamiento que figuran en la tabla publicada. En segundo lugar, una solicitud que active la función de búsqueda en Google puede generar gastos de búsqueda una vez agotada la asignación mensual compartida. Una respuesta modelo por sí sola no constituye una factura completa.
Esa límite es lo que convierte una estimación aproximada en una factura diferente. Si una solicitud incluye un código fuente extenso o un contexto repetitivo, calcula el tamaño de la solicitud antes de elegir el modelo o la opción de almacenamiento en caché.
Ejemplos de costes de la API de Worked Gemini 3.1 Pro
Utiliza tokens ÷ 1 000 000 × la tarifa aplicable. Los ejemplos que figuran a continuación no incluyen impuestos, créditos ni cargos específicos de las herramientas.
| Escenario | Entrada | Salida | Coste estimado del token |
|---|---|---|---|
| Venta al descubierto | 50 000 × $2/M = $0,10 | 8.000 × $12/M = $0,096 | $0.196 |
| Consigna de ingeniería extensa | 250 000 × $4/M = $1,00 | 20 000 × $18/M = $0,36 | $1.36 |
| Contexto de 1 millón de tokens, salida de 50 000 | 1 000 000 × $4/M = $4,00 | 50 000 × $18/M = $0,90 | $4.90 |
coste estimado = (tokens de entrada ÷ 1 000 000 × tasa de entrada) + (tokens de salida ÷ 1 000 000 × tasa de salida) + gastos de herramientas o búsquedas aplicables
El ejemplo de 250 000 supera el límite de 200 000, por lo que a la solicitud se le aplican las tarifas más elevadas. Si la aplicación envía un prefijo largo y repetido, el almacenamiento en caché puede modificar la parte de entrada de la factura, pero solo para los tokens que realmente cumplan los requisitos para considerarse entrada almacenada en caché.
Cómo el almacenamiento en caché de contexto modifica la factura
El almacenamiento en caché resulta útil cuando se envían repetidamente las mismas instrucciones largas, el mismo contexto del código fuente o el mismo material de referencia. Para el nivel estándar mostrado anteriormente, la entrada almacenada en caché cuesta $0,20/M por debajo del límite de 200 000 y $0,40/M por encima de él, mientras que los tokens almacenados en caché cuestan $4,50/M tokens por hora.
Se trata de una opción de la tabla de tarifas, no de un descuento garantizado en cada solicitud repetida. Realiza un seguimiento del uso de los tokens almacenados en caché en los datos de facturación del proveedor e incluye el tiempo de almacenamiento en el presupuesto.
Los planes para consumidores son distintos de la facturación por API
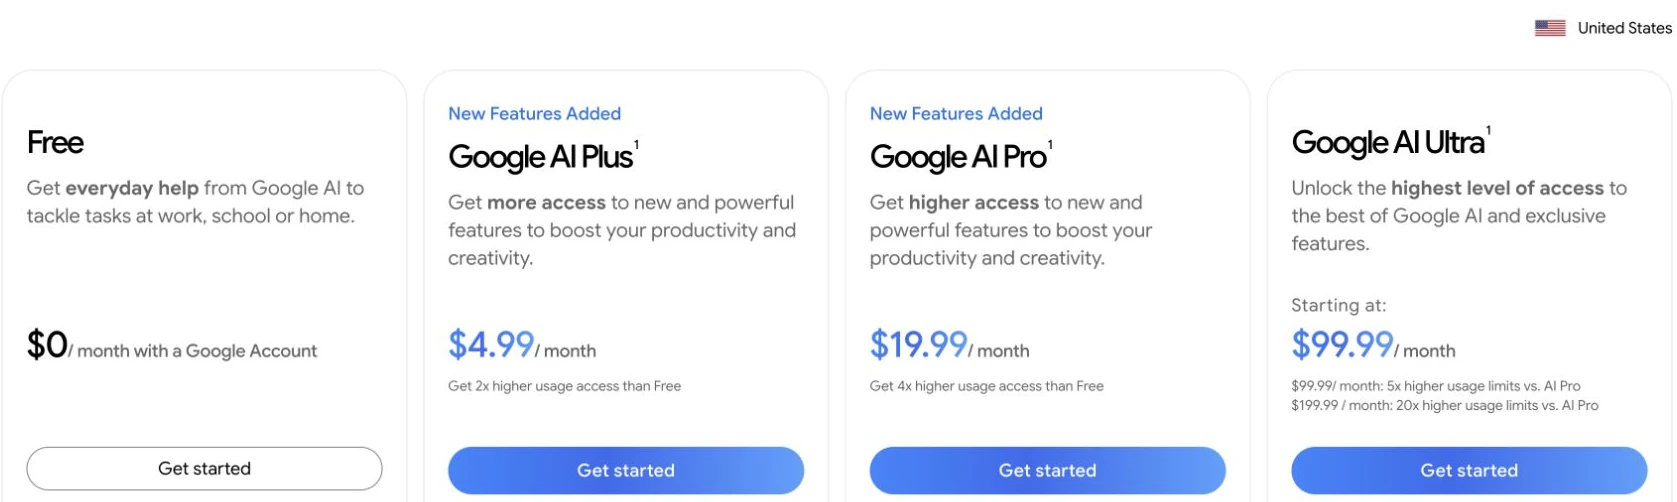
Una suscripción a Google AI Pro o Ultra es un plan para particulares que incluye funciones de la aplicación y normas de acceso. La facturación de la API Gemini se calcula en función de los tokens y las herramientas. Una suscripción para particulares no se convierte automáticamente en crédito de API, y un proyecto de API no incluye automáticamente las ventajas de las aplicaciones para particulares.
Cuándo es adecuado utilizar una API, una CLI, un MCP o un espacio de trabajo multimodelo
Elige la API cuando tu software necesite llamadas predecibles y contadas, una clave de proveedor y una factura que puedas calcular a partir de los registros de tokens. Elige una ruta CLI o MCP cuando el modelo tenga que funcionar junto a un terminal, un repositorio o un servidor de herramientas ya existente. La ruta del agente Yukie resulta útil cuando el trabajo consiste en una tarea de varios pasos que requiere planificación y traspasos, en lugar de una ejecución aislada.
GlobalGPT Se adapta al aspecto interactivo de esa decisión: comparar modelos, elaborar borradores, revisar los resultados y pasar a la programación u otras funciones de IA en un único panel de control. Su precio y las condiciones de los planes constituyen una decisión de producto independiente; la lista de tarifas de Google anterior sigue siendo la fuente de referencia para el coste de la API Gemini.

Los planes para consumidores y la facturación mediante API sirven para fines distintos
Gemini 3.1 Pro puede aparecer tanto en un plan de aplicación para usuarios finales como en un flujo de trabajo de API para desarrolladores, pero no se trata de la misma factura. Un plan para usuarios finales da acceso a una aplicación y a los límites que esta incluye. La API cobra por los tokens, el almacenamiento en caché y cualquier uso de herramientas o recursos en el marco de un proyecto de desarrollador.
| Si necesitas… | Utiliza la ruta que coincida con ella | Presupuesto aproximado de |
|---|---|---|
| Acceso a la aplicación interactiva | Plan para consumidores | Precio del plan, acceso incluido y límites de uso actuales. |
| Una integración de script o de producto | API Géminis | Costes de entrada, salida, entrada almacenada en caché, almacenamiento y herramientas. |
| Trabajar con el repositorio junto a un terminal | CLI o una herramienta conectada a una API | Las llamadas a modelos, además del flujo de trabajo que las invoca. |
| Un proceso de varias etapas, desde la investigación hasta la producción | MCP o un agente de Yukie | El uso del modelo, las herramientas autorizadas y el número de traspasos. |
No describas una suscripción de usuario como «crédito de API» y no utilices las tarifas de los tokens de API para prometer acceso a una función de la aplicación.
Convierte la lista de tarifas en un presupuesto real
Empieza por el tamaño de la solicitud, no por el nombre del modelo. Cuenta los tokens de entrada, comprueba si la solicitud supera el límite de 200 000 tokens, calcula la salida incluyendo los tokens de reflexión cuando la tabla de tarifas los incluya, y añade cualquier cargo por búsqueda o contextualización.
- Solicitud breve: tokens de entrada ÷ 1 000 000 × la tasa de entrada más baja.
- Solicitud larga: aplicar las velocidades de entrada y salida más altas a la solicitud que supere el umbral.
- Contexto repetido: cuenta solo los tokens que cumplen los requisitos para considerarse entrada almacenada en caché e incluye el tiempo de almacenamiento en caché.
- Búsqueda de aterrizamiento: añade el cargo por solicitud publicado tras la asignación compartida, cuando proceda.
- Previsión de producción: añadir reintentos y llamadas a herramientas en lugar de multiplicar únicamente la primera respuesta.
Una calculadora de tokens resulta útil cuando los datos introducidos están a la vista. Mantén el límite, la unidad de facturación y la fecha junto al resultado para que quien lo lea más adelante pueda entender qué significa esa cifra.
Cómo cambia en la práctica un contexto amplio
Un límite de entrada de un millón de tokens no significa que cada solicitud deba incluir todo el repositorio. Las solicitudes de gran volumen aumentan el coste y pueden dificultar la identificación del archivo relevante. Empieza con un índice, envía la parte relevante más pequeña y añade el siguiente archivo solo cuando la primera respuesta indique que es necesario.
- Crea un breve mapa del repositorio antes de enviar los archivos fuente.
- Separar las instrucciones estables del cambio de contexto de la tarea.
- Almacena en caché un prefijo repetido solo cuando el informe de uso confirme una coincidencia.
- Pide los nombres de los archivos y las referencias de línea para poder comprobar el resultado.
- Utiliza una segunda pasada para las pruebas o los casos extremos, en lugar de pedir una reescritura sin límites.
Aquí es donde la API, la CLI y el MCP resultan útiles: el modelo puede funcionar de forma independiente del proyecto, mientras que el flujo de trabajo controla qué contexto se envía y qué herramienta se invoca.
Cuando un espacio de trabajo es mejor que un libro mayor simbólico
Utiliza la API cuando necesites llamadas a la aplicación predecibles y un control de uso a nivel de token. Utiliza la CLI cuando el desarrollo se realice en una terminal. Utiliza MCP cuando la tarea requiera herramientas externas autorizadas. Utiliza un agente de Yukie cuando el trabajo abarque la planificación, el uso de herramientas y los traspasos.
Para el descubrimiento interactivo y las obras de técnica mixta, El espacio de trabajo Gemini 3.1 Pro de GlobalGPT Te ofrece un espacio para comparar modelos, escribir código y continuar con los pasos relacionados con imágenes, vídeo, audio o agentes. La ventaja económica radica en que una única suscripción cubre una mayor parte del flujo de trabajo; la tarifa de la API de Google sigue siendo un cargo independiente del proveedor.
PREGUNTAS FRECUENTES
¿Cuánto cuesta Gemini 3.1 Pro por cada millón de tokens?
Para el nivel de pago estándar, Google indica una entrada de $2/M y una salida de $12/M cuando la solicitud tiene una longitud igual o inferior a 200 000 tokens. Por encima de 200 000, las tasas son de $4/M de entrada y $18/M de salida.
¿Existe un nivel gratuito de la API Gemini 3.1 Pro?
La página de tarifas de Google muestra un nivel gratuito con acceso limitado a modelos concretos. Comprueba la fila correspondiente al modelo antes de dar por hecho que el Gemini 3.1 Pro tiene acceso gratuito a la API.
¿La API cobra por la indexación de Google Search?
La página actual de tarifas indica 5.000 consultas de búsqueda gratuitas al mes, repartidas entre los modelos Gemini 3 y posteriores, y $14 por cada 1.000 consultas. Cada consulta de búsqueda se puede facturar por separado una vez agotada la cuota.
¿La suscripción a Google AI Pro incluye crédito para la API?
No des eso por sentado. Las tarifas de los planes para consumidores y la facturación de los tokens de API son procesos distintos y deben consultarse en sus respectivas páginas oficiales.
¿Cuál es la forma más económica de utilizar el Gemini 3.1 Pro?
En el caso de las llamadas de producción programables, compara la estimación de tokens, el almacenamiento en caché y las opciones de lotes o Flex que realmente puedes utilizar. Para el trabajo interactivo con varios modelos y funciones, compara un plan de espacio de trabajo actual por separado, en lugar de tratarlo como crédito de API.
Utiliza la tarifa como una calculadora, no como un eslogan: Identificar el ID exacto del modelo, comprobar el límite de 200 000, contar los tokens de «thinking» generados y mantener los planes de los consumidores separados del gasto en la API.





