Elige Eleven v4 para una narración completa; elige Eleven v4 Turbo cuando la voz tenga que responder a medida que avanza la conversación. Ambos pertenecen a la familia ’v4» de ElevenLabs. La diferencia relevante radica en el proceso de entrega: un archivo de audio pulido para un vídeo o un audiolibro, frente a una voz transmitida en streaming para un asistente que no puede hacer esperar al oyente.
Para los creadores que producen algo más que audio, GlobalGPT Incorpora la generación de voz en el mismo espacio de trabajo de suscripción que la redacción de guiones, las imágenes y el vídeo. Esto lo convierte en un punto de partida práctico y asequible para una campaña completa. Generamos dos indicaciones iniciales y un guión de seguimiento más claro con cada modelo de GlobalGPT. Los seis archivos de audio que aparecen a continuación muestran tanto un error habitual en las indicaciones como la solución práctica.
Eleven v4 frente a v4 Turbo: resumen rápido
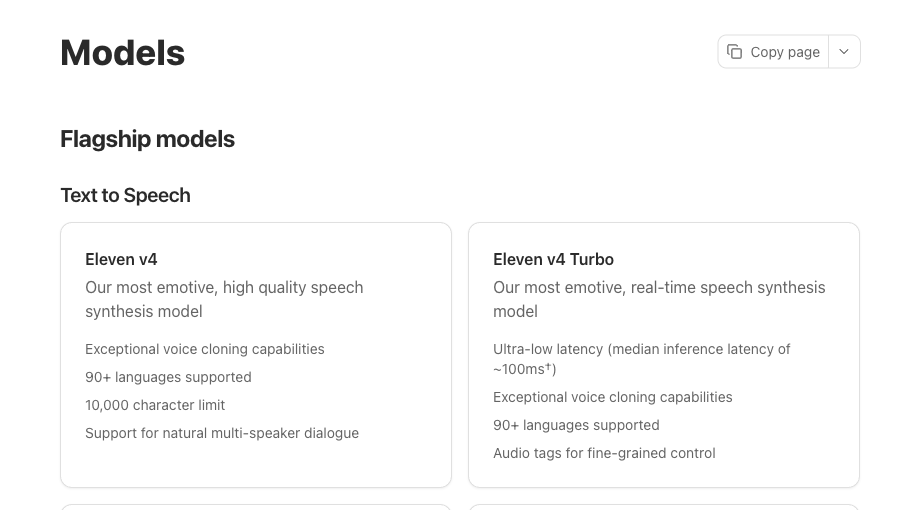
ElevenLabs posiciona la versión 4 en torno a la riqueza emocional y la calidad del contenido final, y la versión 4 Turbo en torno al habla expresiva en tiempo real. Turbo no es simplemente una promesa de que cada archivo MP3 descargado llegará antes. Para aprovechar las ventajas del streaming, la aplicación debe transmitir y reproducir el audio realmente por fragmentos.
| Decisión | Eleven v4 | Eleven v4 Turbo |
|---|---|---|
| Ajuste principal | Narración, audiolibros, contenidos finalizados con interpretación expresiva | Habla conversacional en tiempo real |
| N.º de identificación oficial del modelo | eleven_v4 | eleven_v4_turbo |
| Apoyo lingüístico a las familias | Más de 90 idiomas | Más de 90 idiomas |
| Dirección de entrega | Instrucciones en lenguaje natural y etiquetas expresivas en línea | Entrega expresiva en un flujo de trabajo de streaming |
| Ruta de la API que hay que investigar | REST: De texto a diálogo | WebSocket de texto a diálogo en tiempo real |
| Distinción entre voz y recuento en las instrucciones actuales para el diálogo | Hasta 10 voces distintas en la entrada de diálogo REST | Exactamente una voz registrada en la guía en tiempo real |
| Medida de latencia publicada | No se ha utilizado ninguna cifra comparable en este caso | Tiempo mediano de inferencia de unos 100 ms; tiempo mediano hasta la primera expresión oral de unos 150 ms, según el informe de lanzamiento. |
Documentación oficial e información sobre el lanzamiento consultadas el 13 de octubre de 2026. La compatibilidad con idiomas es una especificación de la familia; el número de voces depende de la ruta de la API.
Calidad de la voz, emoción y compatibilidad lingüística
En el caso de una historia grabada, la voz tiene tiempo para adaptarse a cada frase: las pausas, el énfasis y los cambios emocionales pueden ser más importantes que un breve retraso en la generación. Esa es la función que ElevenLabs asigna a v4. Un agente conversacional tiene una restricción diferente. Incluso una respuesta convincente resulta extraña si empieza demasiado tarde, por lo que Turbo hace hincapié en producir un discurso expresivo con rapidez.
El lanzamiento de la versión 4 introduce instrucciones de interpretación en lenguaje natural y etiquetas en línea para la expresión vocal y los sonidos. Una indicación como “un comienzo tranquilo seguido de una frase final entusiasta” resulta más útil que pedir una voz vagamente «mejor». Mantén separadas las instrucciones del guion hablado y las de interpretación siempre que la interfaz ofrezca campos distintos. De lo contrario, un cuadro de texto sin formato podría convertir una indicación en palabras habladas.
- Para la descripción del producto: Evalúa el nombre del producto, las pausas en torno a las ventajas clave y si la última frase suena natural.
- Para las escenas de personajes: Utiliza una ruta con asignación explícita de voces; el mero hecho de que los nombres de los interlocutores aparezcan en una indicación de texto no garantiza que haya voces distintas.
- Para la localización: Ambos modelos admiten más de 90 idiomas, pero comprueba el idioma concreto, el acento, los nombres y las abreviaturas que aparecen en tu guion.
- En el caso de las voces clonadas: Utiliza una voz que te pertenezca o para la que tengas permiso de reproducción, y confirma la cuenta correspondiente y el acceso a la clonación de voz.
Esta familia incluye funciones de clonación de voz, pero la compatibilidad de un modelo difiere del derecho que otorga una suscripción a una herramienta de clonación concreta. Elige primero la voz y la vía de acceso, y después compara las prestaciones. Si ya utilizas un modelo de narración más antiguo, nuestro Reseña de Eleven Multilingual v2 ofrece otro punto de referencia a la hora de tomar una decisión sobre la migración.
Qué significa “más rápido” para el Turbo v4
La documentación del modelo dice, más o menos: Latencia de inferencia mediana de 100 ms para el v4 Turbo. La publicación de presentación cita, aproximadamente: 150 ms: tiempo mediano hasta la primera expresión oral. Estas opciones describen diferentes partes del proceso de procesamiento del habla, y ninguna de ellas garantiza que se descargue un archivo completo de voz en una fracción de segundo.
Nuestros ejemplos de GlobalGPT midieron el tiempo total de ejecución de la tarea, incluida la espera del archivo generado. No midieron la latencia del primer audio ni una conversación por WebSocket. Los resultados muestran por qué una prueba de generación de archivos por sí sola es una forma poco adecuada de clasificar la capacidad de respuesta conversacional: Turbo no fue el que completó el trabajo más rápido en ninguno de los dos pares originales, pero completó más rápido la tarea de seguimiento con el guion limpio. Esa variación entre tres pares pequeños no constituye una clasificación de velocidad estable.
Seis ejemplos de audio del GlobalGPT: las primeras tomas y una solución práctica
El 13 de octubre de 2026 enviamos dos indicaciones iniciales, una vez a cada modelo, y luego añadimos un par de guiones limpios tras comprobar el texto hablado. Las seis solicitudes devolvieron archivos MP3 reproducibles; ninguna toma se sustituyó por una nueva grabación. Las indicaciones coincidían dentro de cada par, pero no se fijó una identificación de voz común. Comprobamos la duración de los archivos y utilizamos la transcripción automática local para comparar las palabras pronunciadas. Esto permite verificar el contenido, pero no la naturalidad ni la calidad emocional.
Ejemplo 1: Una breve presentación del producto
En la primera indicación se mezclaba una indicación de interpretación con el guion del anuncio. Ambas transcripciones incluyen la instrucción inicial: “Lee esta breve presentación del producto con un comienzo tranquilo y una frase final entusiasta”. Por eso, estas primeras tomas no son adecuadas como anuncios finales. En un campo de texto de diálogo sin formato, escribe las palabras que quieres que se digan; coloca las indicaciones de interpretación en un campo de control o de instrucciones independiente.
Ejemplo 2: Una miniescena dirigida
La segunda indicación incluye instrucciones para los interlocutores y una señal de risa. Ambas transcripciones contienen “Interlocutor uno, con calidez” e “Interlocutor dos, con tranquila confianza”. Escribir esas indicaciones en un texto sin formato no permitió crear una escena con personajes bien definida. Para un diálogo de producción, utiliza una interfaz compatible con asignación explícita de voces y mantén las líneas de diálogo separadas de las acotaciones escénicas.
Ejemplo 3: Conserva solo las palabras que quieras que se pronuncien
Para la siguiente prueba, eliminamos la indicación inicial y enviamos únicamente el guion del anuncio. Ambas transcripciones automáticas coincidían con el texto original en orden, sin la instrucción no deseada. Los archivos resultantes tenían una duración aproximada de 11 segundos. Este es el punto de partida más útil para un vídeo corto sobre el producto.
Una entrada más clara da como resultado un guion hablado útil
Bienvenido a Acorn Studio. Empieza con un plan claro y, a continuación, elabora un primer borrador útil. Hoy en día, tus ideas pueden pasar de una página en blanco a un resultado pulido.
- Generación
- GlobalGPT · 13 de octubre de 2026 · una respuesta por modelo, ajustes de voz predeterminados
- Plazo de ejecución de la tarea
- v4: 15,832 s · Turbo: 9,439 s
- Salida
- Ambos completados; MP3, mono, 44,1 kHz
- Revisión del contenido
- Ambas transcripciones automáticas coinciden con la secuencia de palabras facilitada, sin ninguna indicación de apertura adicional.
- Siguiente paso
- Elige la forma de presentación que prefieras, comprueba la pronunciación escuchándola y sincroniza la grabación con las imágenes.
La mejora consiste en una lección concreta sobre cómo redactar. La naturalidad de la voz y la transmisión emocional siguen requiriendo una escucha atenta; no se trata de una clasificación basada en la calidad de la voz en sí.
Precios: compara todo el flujo de trabajo, no solo el nombre de un modelo
ElevenLabs comercializa suscripciones con saldos de crédito; GlobalGPT ofrece un espacio de trabajo de suscripción multimodelo. Se trata de decisiones de compra diferentes. Un equipo dedicado a la producción de audio puede necesitar las herramientas de voz y las funciones de cuenta de ElevenLabs. Un creador que también necesite recursos de redacción, imágenes y vídeo puede obtener una mayor cobertura de su flujo de trabajo con un único espacio de trabajo de GlobalGPT.
| Plan ElevenLabs | Precio mensual habitual | Créditos mensuales |
|---|---|---|
| Gratis | $0 | 10,000 |
| Entrante | $6 | 30,000 |
| Creador | $22 | 121,000 |
| Pro | $99 | 600,000 |
| Escala | $299 | 1,800,000 |
Fuente: Precios de ElevenLabs, consultado el 13 de octubre de 2026; impuestos no incluidos. Las ofertas del primer mes y los descuentos por facturación anual son independientes de estos precios mensuales habituales. El uso del crédito depende del producto y del modelo.
No conviertas directamente el total de créditos de un plan en una tarifa en dólares de v4 Turbo sin aplicar el multiplicador de créditos correspondiente. En las preguntas frecuentes sobre precios se indica que, para los modelos de mayor calidad, se aplica un carácter por crédito y, a modo de estimación, aproximadamente 1.000 caracteres por minuto. La duración real depende del idioma, el ritmo y el guion. El uso específico de cada modelo y cualquier tarifa de créditos adicionales deben coincidir con el plan seleccionado.
Un presupuesto realista para la locución también debe incluir las revisiones. Para un guion de 1.200 caracteres, tres tomas completas suponen 3.600 caracteres generados antes de realizar cualquier grabación adicional más breve. Mejorar primero el guion puede ahorrar más trabajo que volver a generar repetidamente un borrador deficiente. En GlobalGPT, puedes perfeccionar ese guion con un modelo de escritura y, a continuación, pasar a la producción audiovisual en el mismo espacio de trabajo.
Rutas de la API, recuentos de voz y límites de longitud
Si estás desarrollando una aplicación, empieza por la ruta de entrega. El punto final REST «Text to Dialogue» acepta una matriz de entradas que contiene texto e identificadores de voz, y devuelve audio. El WebSocket «Text to Dialogue» en tiempo real acepta texto entrante y emite fragmentos de audio. El mero hecho de indicar el nombre de un modelo no basta para que una aplicación que no utilice streaming dé la sensación de estar en directo.
- Diálogo completo: La guía REST admite hasta 10 identificadores de voz únicos. En sus recomendaciones sobre los puntos finales se aconseja que el texto de entrada combinado no supere los 2.000 caracteres por solicitud.
- Realtime Turbo: La guía en tiempo real registra exactamente una voz. La generación comienza tras un búfer de texto de unos 40 caracteres y ocho palabras; un mensaje de vaciado puede activar un segmento más corto.
- Versión extensa v4: La tabla del modelo indica un límite de 10 000 caracteres, lo que equivale aproximadamente a diez minutos. Esa cifra a nivel de modelo no debe prevalecer sobre una recomendación inferior para un punto final concreto.
- Interacción en directo: La configuración de la conexión, el recorrido de la red, el almacenamiento en búfer del texto y el reproductor de audio influyen en la latencia percibida.
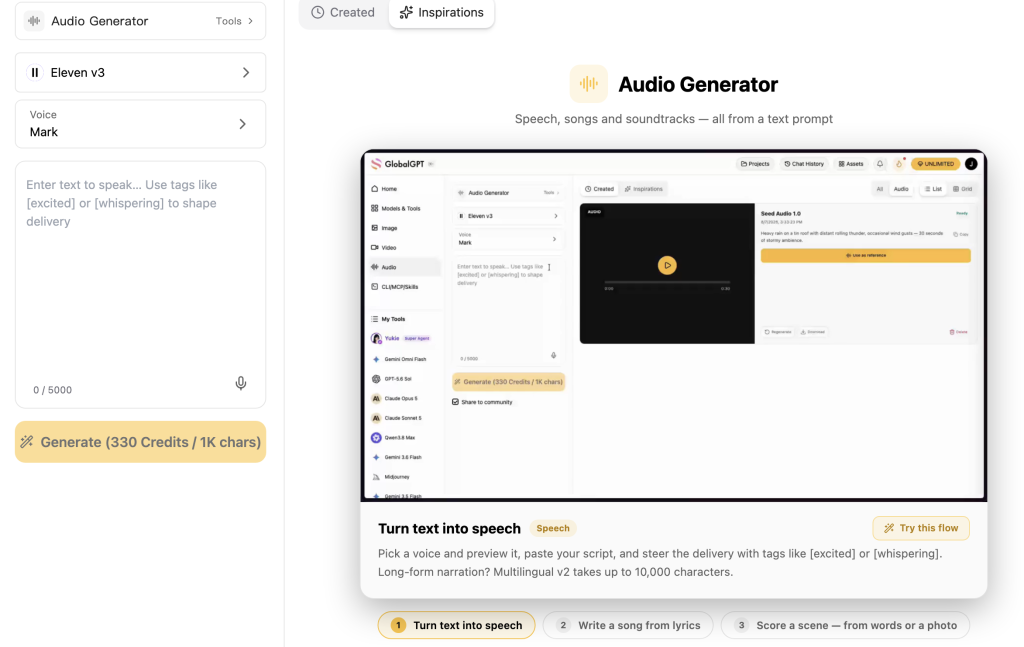
Utilice el Referencia sobre el diálogo REST para obtener un archivo multivocal ya terminado y el Guía de diálogo en tiempo real para la ruta de streaming de Turbo. Adapta la compatibilidad con los modelos y la configuración de voz al punto final antes de escalar un lote. En lo que respecta al trabajo de los creadores, el flujo de trabajo de audio de GlobalGPT te permite concentrarte en el guion y en el recurso final, en lugar de tener que desarrollar un cliente de streaming.
Un flujo de trabajo práctico para la locución en GlobalGPT
Empieza por el resultado final: un anuncio de 15 segundos, un vídeo explicativo de un minuto o un fragmento narrativo. Redacta el texto hablado para que se ajuste a esa duración antes de pedirle al modelo de voz que lo interprete. Un guion conciso es más fácil de comparar, revisar y sincronizar que un primer borrador extenso.
- Redacta el guion en GlobalGPT. Especifica el público destinatario, la duración prevista, las notas de pronunciación y una llamada a la acción clara.
- Elige el modelo de audio y los ajustes de voz disponibles en tu espacio de trabajo. Comprueba el coste de generación que se muestra antes de enviar la solicitud.
- Graba una primera toma breve. Presta atención a las palabras que falten, las indicaciones verbales no deseadas, los nombres, el ritmo y el final.
- Revisa la frase más débil en lugar de cambiar todas las instrucciones a la vez. Guarda la versión aprobada para poder compararla.
- Descarga el audio elegido e intégralo con tus elementos visuales. Si la campaña requiere varios recursos relacionados, Lona GlobalGPT ayuda a organizar el flujo de trabajo creativo en general.
¿Cuál deberías elegir?
Para obtener una locución pulida que puedas revisar y editar, empieza por Eleven v4. Su enfoque oficial se centra en la narración, el desarrollo de los personajes y el contenido final expresivo. Si buscas un asistente que hable a medida que avanza la conversación, empieza por v4 Turbo y pruébalo a través de la vía de transmisión que utilizará realmente tu aplicación.
Para un creador que está elaborando una obra completa, la mejor opción suele ser un flujo de trabajo que permita terminar el guion, la voz y los elementos visuales al mismo tiempo. Prueba el flujo de trabajo de audio en GlobalGPT, empieza con un guion breve y elige la toma definitiva escuchándola en el contexto en el que se va a utilizar.
Preguntas frecuentes
¿Es la versión 4 de Eleven mejor que la versión 4 Turbo?
Eleven v4 es el punto de partida ideal para una narración expresiva y pulida. v4 Turbo da prioridad a una voz receptiva en tiempo real. Elige en función de si necesitas un archivo de audio revisado o una conversación en directo y, a continuación, prueba tu guion y tu voz.
¿A qué velocidad va el Eleven v4 Turbo?
ElevenLabs indica una latencia media de inferencia de unos 100 ms en la documentación de su modelo y un tiempo medio hasta la primera emisión de voz de unos 150 ms en su informe de lanzamiento. Se trata de mediciones diferentes. La red, el almacenamiento en búfer y la reproducción se suman al retraso que experimenta el usuario.
¿Ambos modelos admiten los mismos idiomas?
ElevenLabs indica que la familia v4 es compatible con más de 90 idiomas. Prueba los nombres, los acentos y la pronunciación en el idioma concreto en el que tengas previsto publicar.
¿Puede v4 Turbo generar diálogos con varios interlocutores?
Comprueba la interfaz en lugar de basarte únicamente en la descripción de la familia. La guía «realtime v4 Turbo» registra exactamente una voz, mientras que la referencia de diálogo «REST» admite hasta diez identificadores de voz únicos. Las indicaciones sobre el hablante dentro de una indicación simple no equivalen a una asignación explícita de voz.
¿Hay alguna forma gratuita de probar ElevenLabs?
ElevenLabs ofrece un plan gratuito con 10 000 créditos mensuales. El acceso a los modelos, las normas de uso y los derechos comerciales dependen del plan vigente. Disponer de un saldo de créditos gratuito no garantiza que se incluyan todas las funciones de la versión 4.
¿Puedo utilizar GlobalGPT para todo el proceso de grabación de voz en off de un vídeo?
Sí. GlobalGPT reúne modelos de texto, audio, imagen y vídeo en un único espacio de trabajo con suscripción, lo que te permite desarrollar el guion y los recursos complementarios al mismo tiempo. Revisa la voz en off elegida y tu montaje final antes de publicarlo.